


资讯
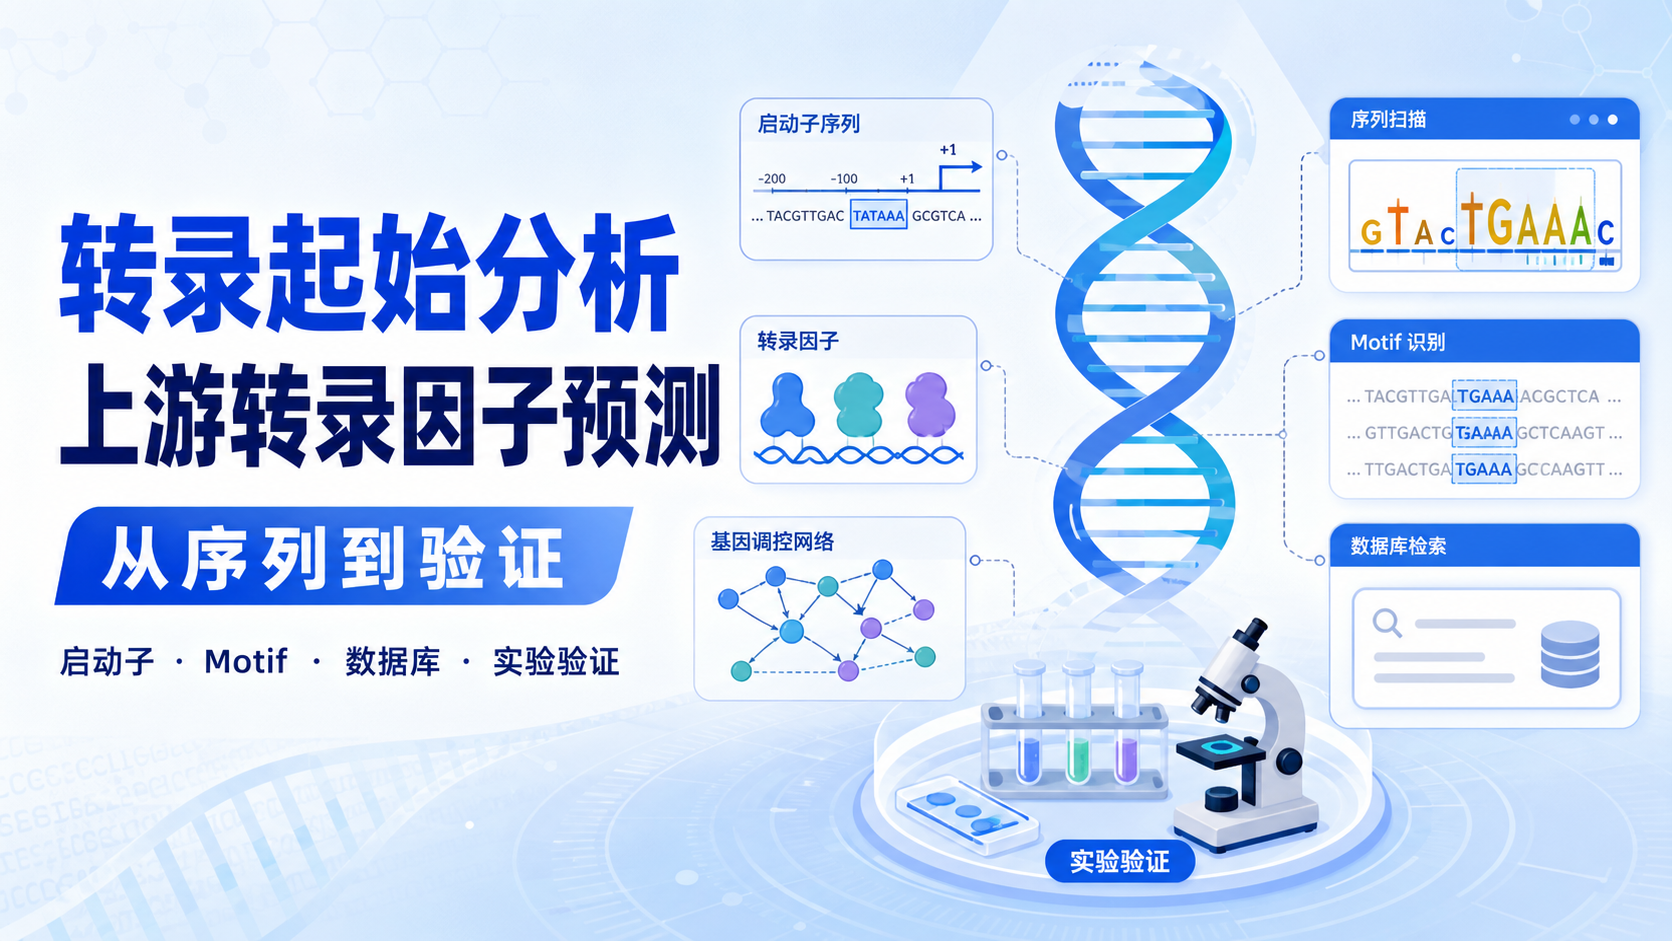 转录起始位点附近,往往藏着决定基因表达的关键信息。对医学生、医生和科研人员来说,真正难点不是“知道有调控”,而是如何从一个分子反推上游转录因子。这一步如果方法不对,很容易得到大量假阳性,浪费实验资源。阅读128 · 点赞0Dr.Sheng 于2026-08-03发布
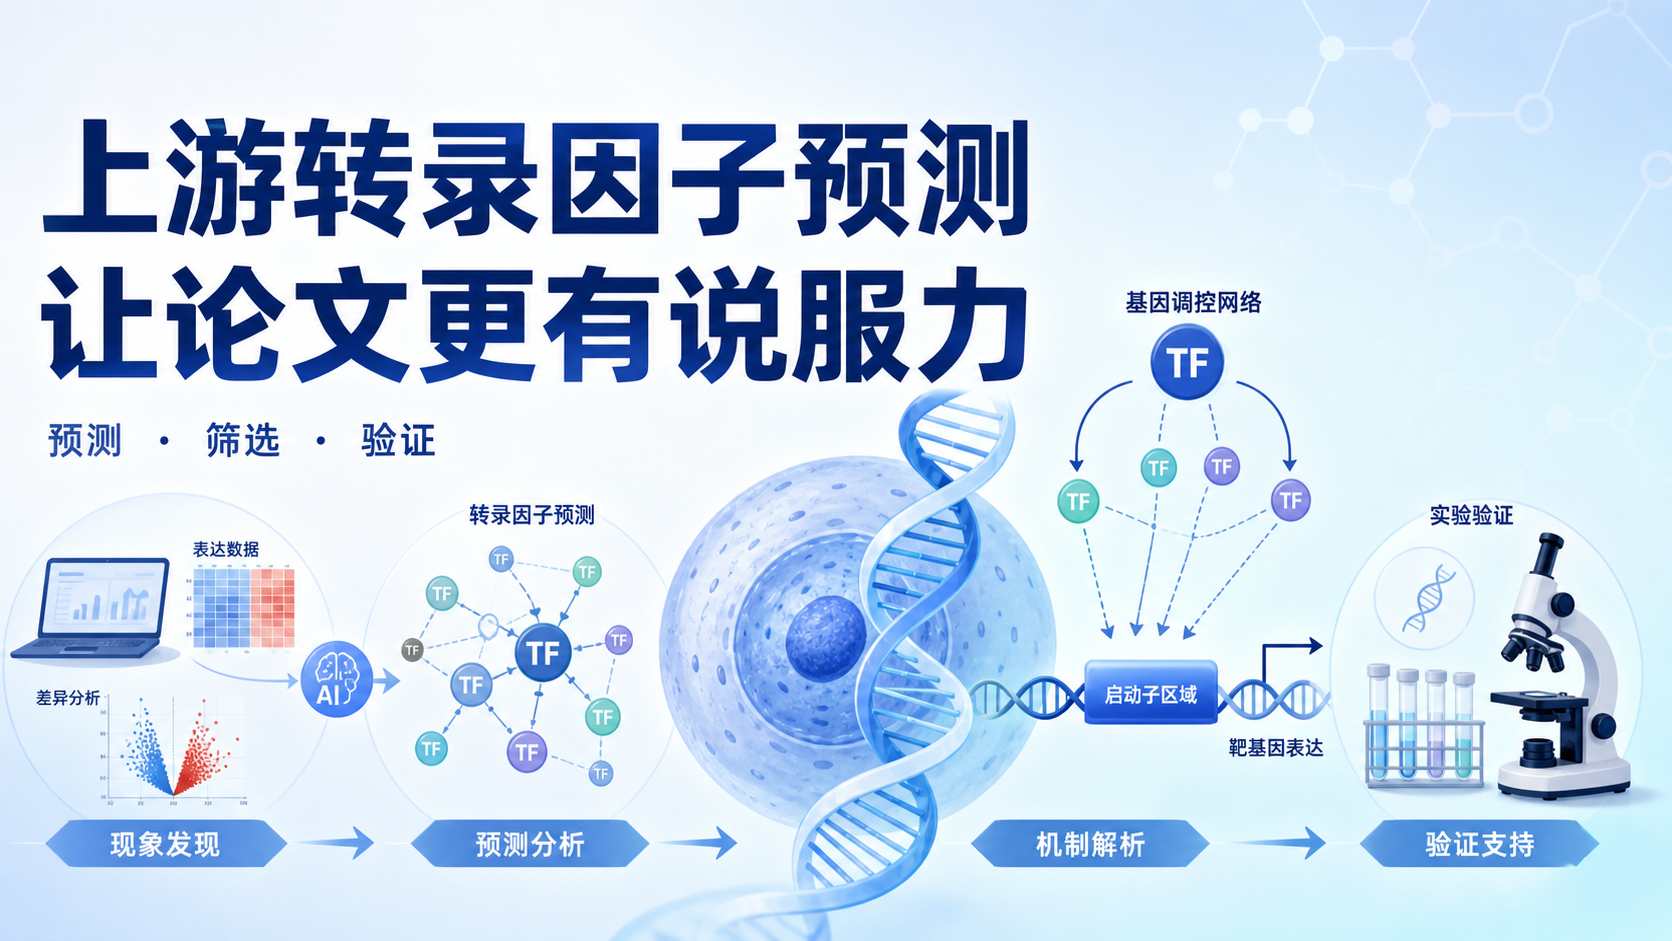 做转录因子研究,最常见的痛点不是“找不到分子”,而是“故事讲不完整”。只有表达差异、只有相关性,论文往往缺少上游驱动证据,审稿人也会追问:这个分子为什么变了,谁在调控它。上游转录因子预测,正是把相关性推进到机制链条的关键一步。阅读62 · 点赞0Dr.Sheng 于2026-08-03发布
 转录调控是机制研究中最常见,也最容易被忽视的起点。很多课题做到表型和通路后,卡在“为什么会这样”。上游因子如果找不准,整篇文章就会缺少逻辑闭环。阅读148 · 点赞0Dr.Sheng 于2026-08-03发布
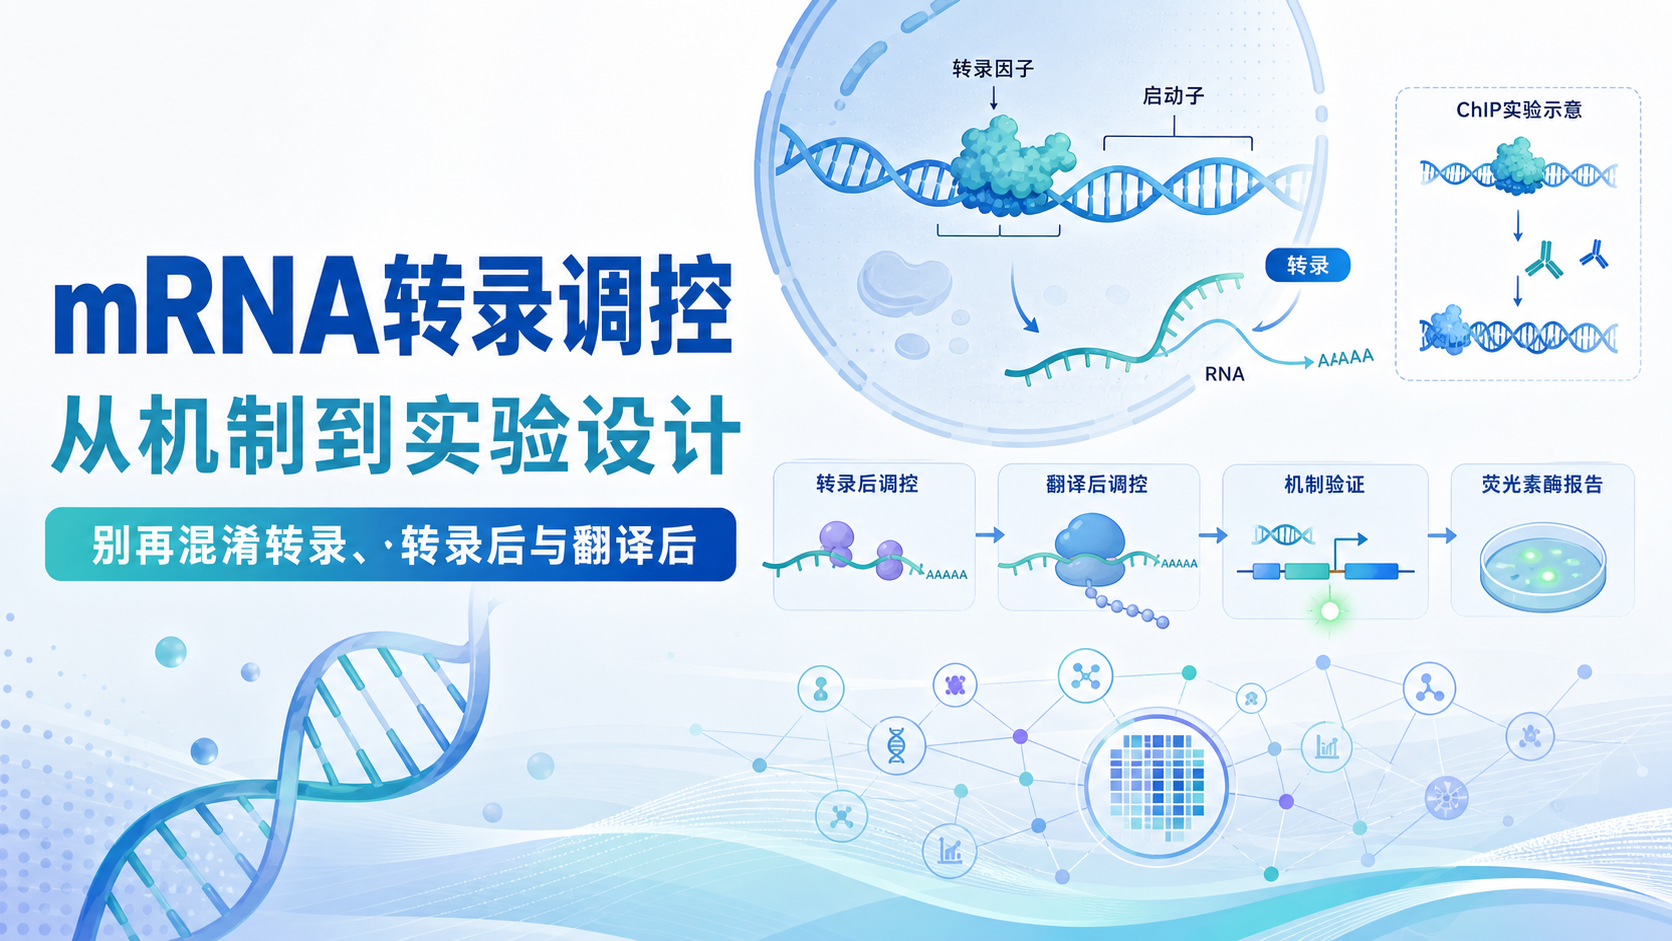 mRNA转录是基因表达的起点,也是许多疾病机制研究的入口。对医学生、医生和科研人员来说,真正的难点不在“知道转录是什么”,而在于如何区分调控发生在DNA、RNA还是蛋白层面,并据此设计可验证的机制链条。阅读128 · 点赞0Dr.Sheng 于2026-08-03发布
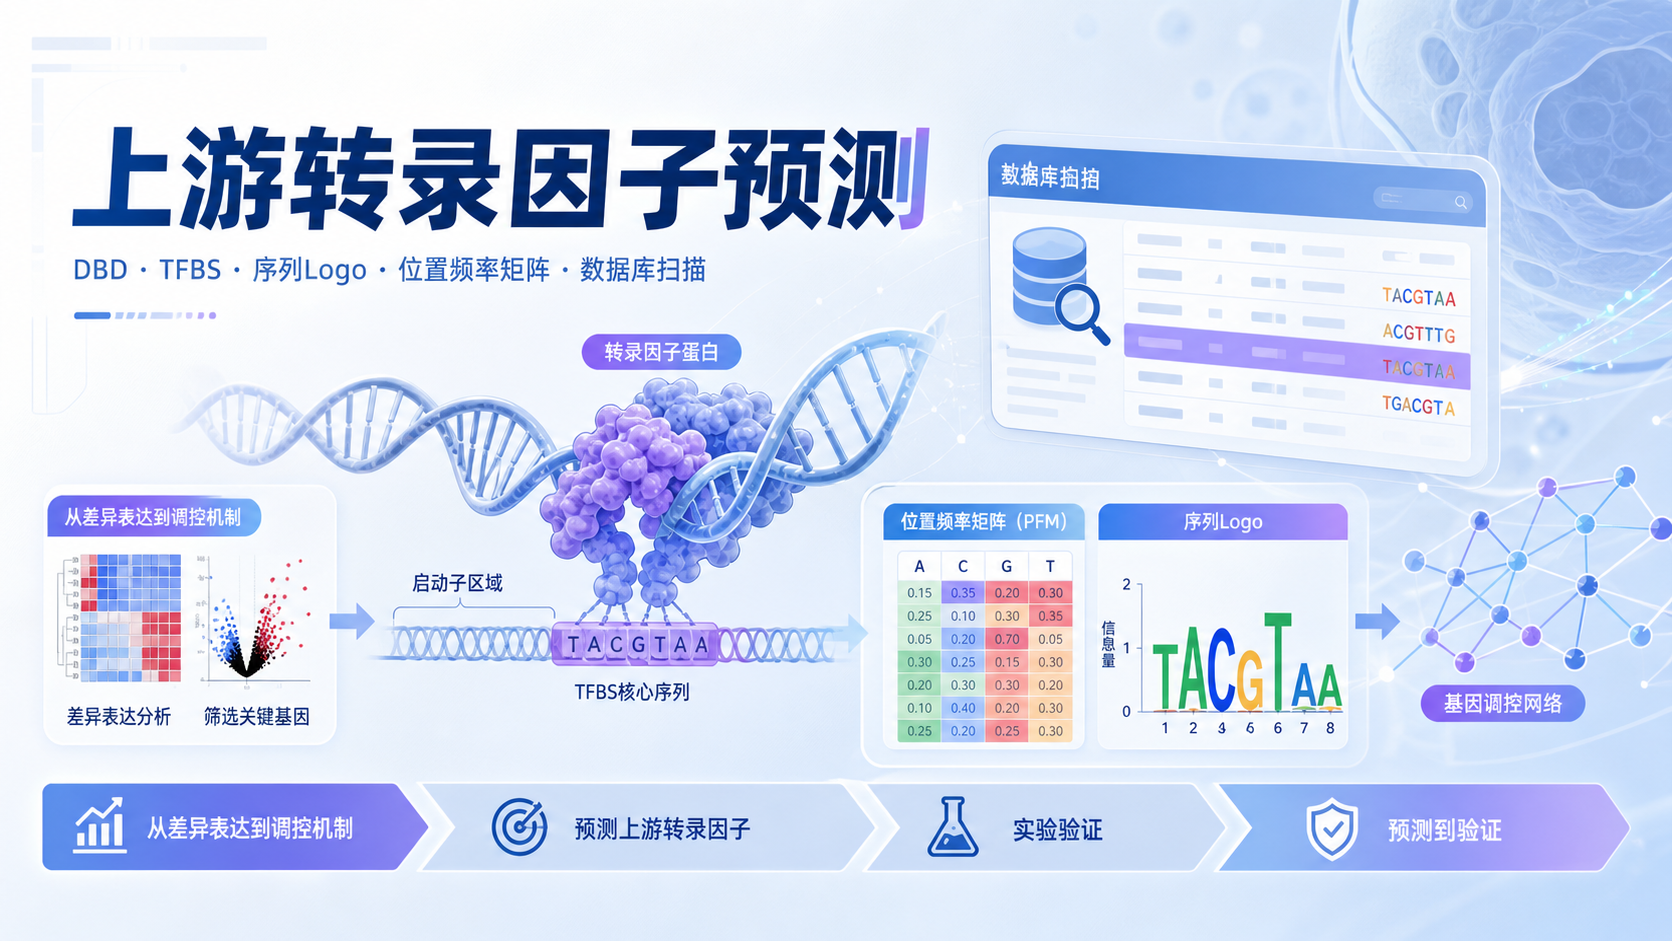 转录组结果出来后,很多人都会问同一个问题。这些差异基因到底是谁在上游调控。只看富集和PPI,往往还不够。上游转录因子预测,才是把“变化”连接到“机制”的关键一步。阅读92 · 点赞0Dr.Sheng 于2026-08-03发布
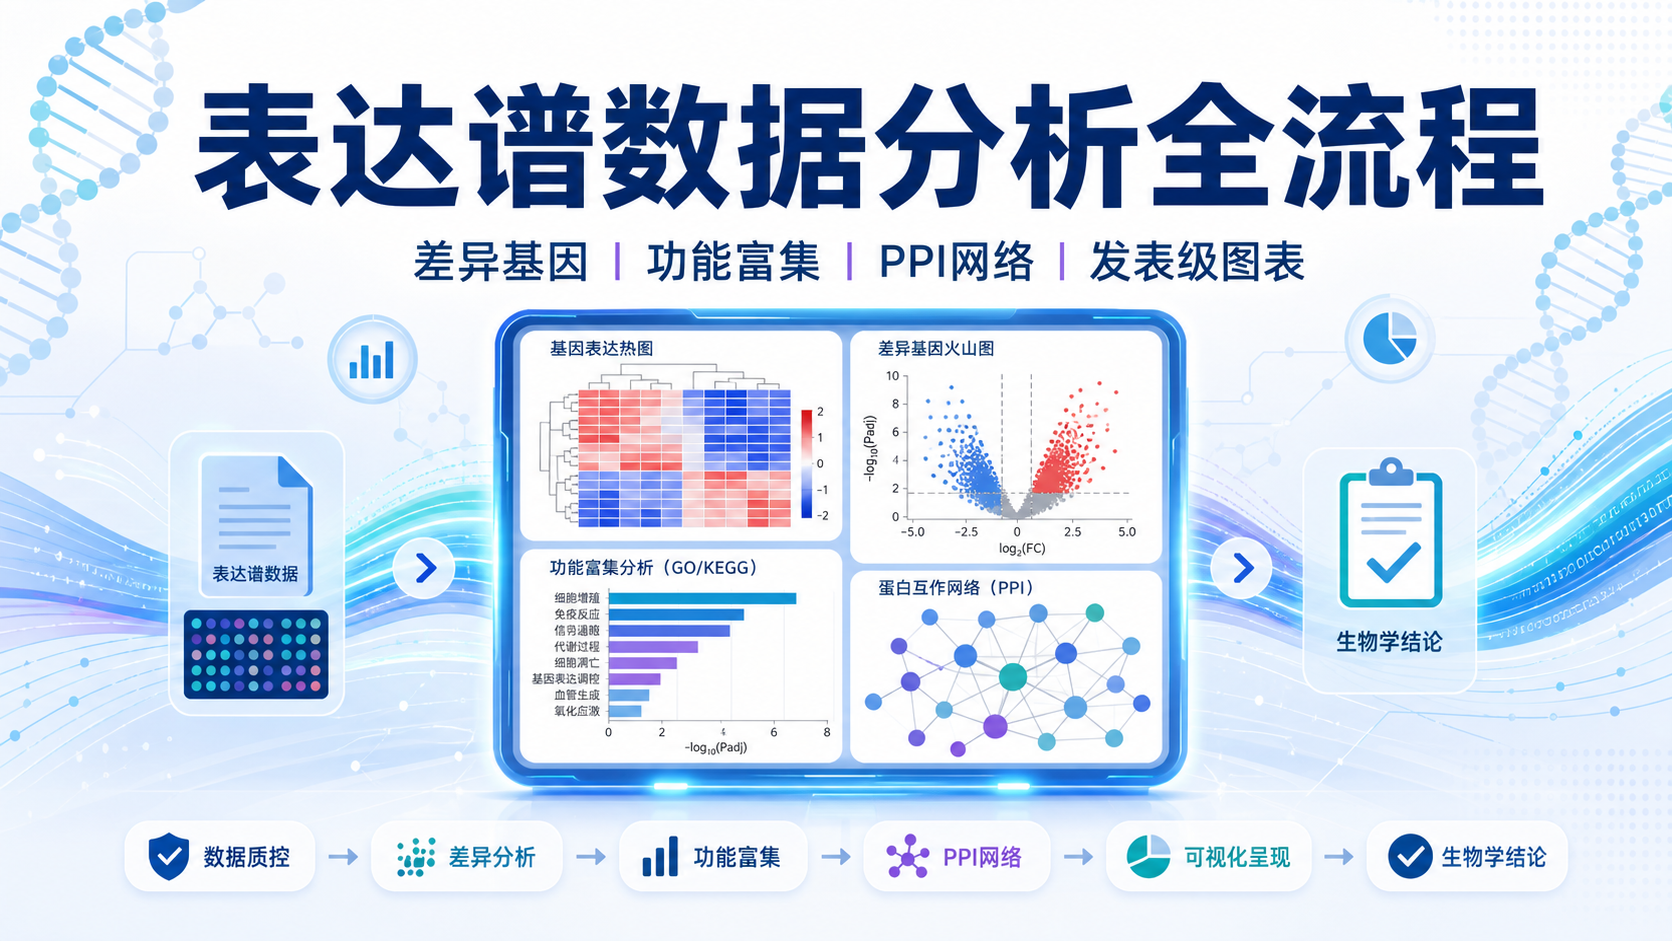 表达谱分析看似只是“下载数据、做差异、画图”,但真正难点在于数据筛选、预处理、结果解释和图表逻辑。很多文章卡在第一步,样本不一致、平台混杂、图表不成体系,最后很难达到发表标准。阅读75 · 点赞0Dr.Sheng 于2026-08-03发布
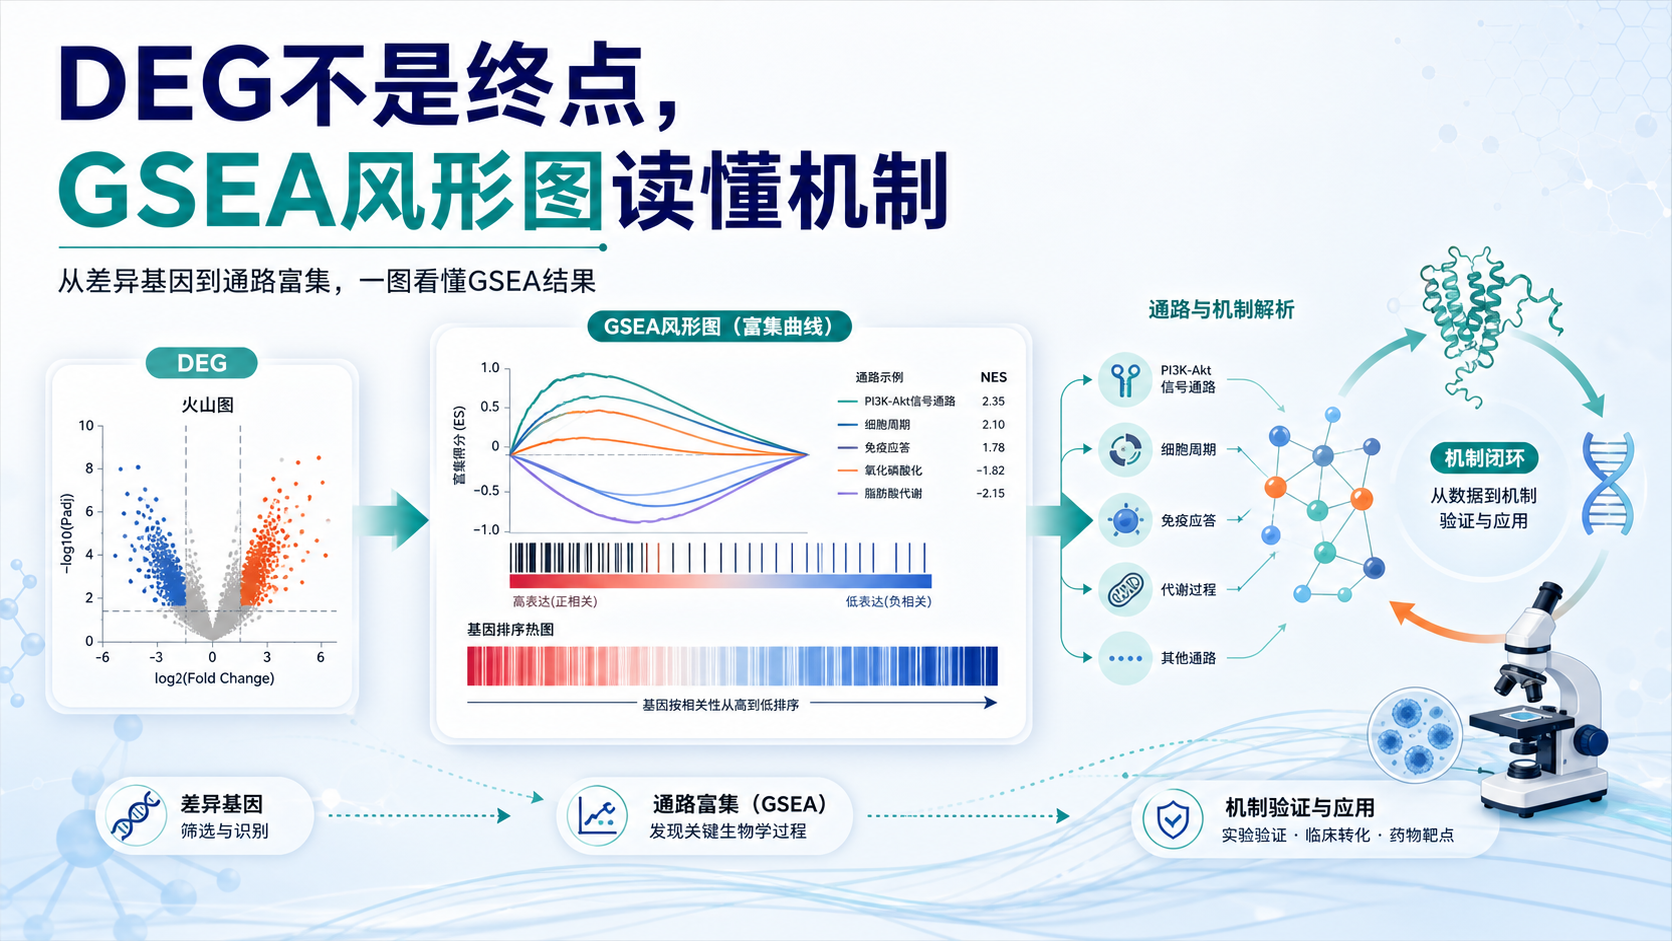 DEG分析后,很多人只看上调和下调基因列表,却忽略了通路层面的整体变化。如果你想把差异基因真正转化为可解释的生物学结论,GSEA风形图是必须掌握的工具。它能告诉你,基因集是在排序前端富集,还是在后端富集。阅读89 · 点赞0Dr.Sheng 于2026-08-03发布
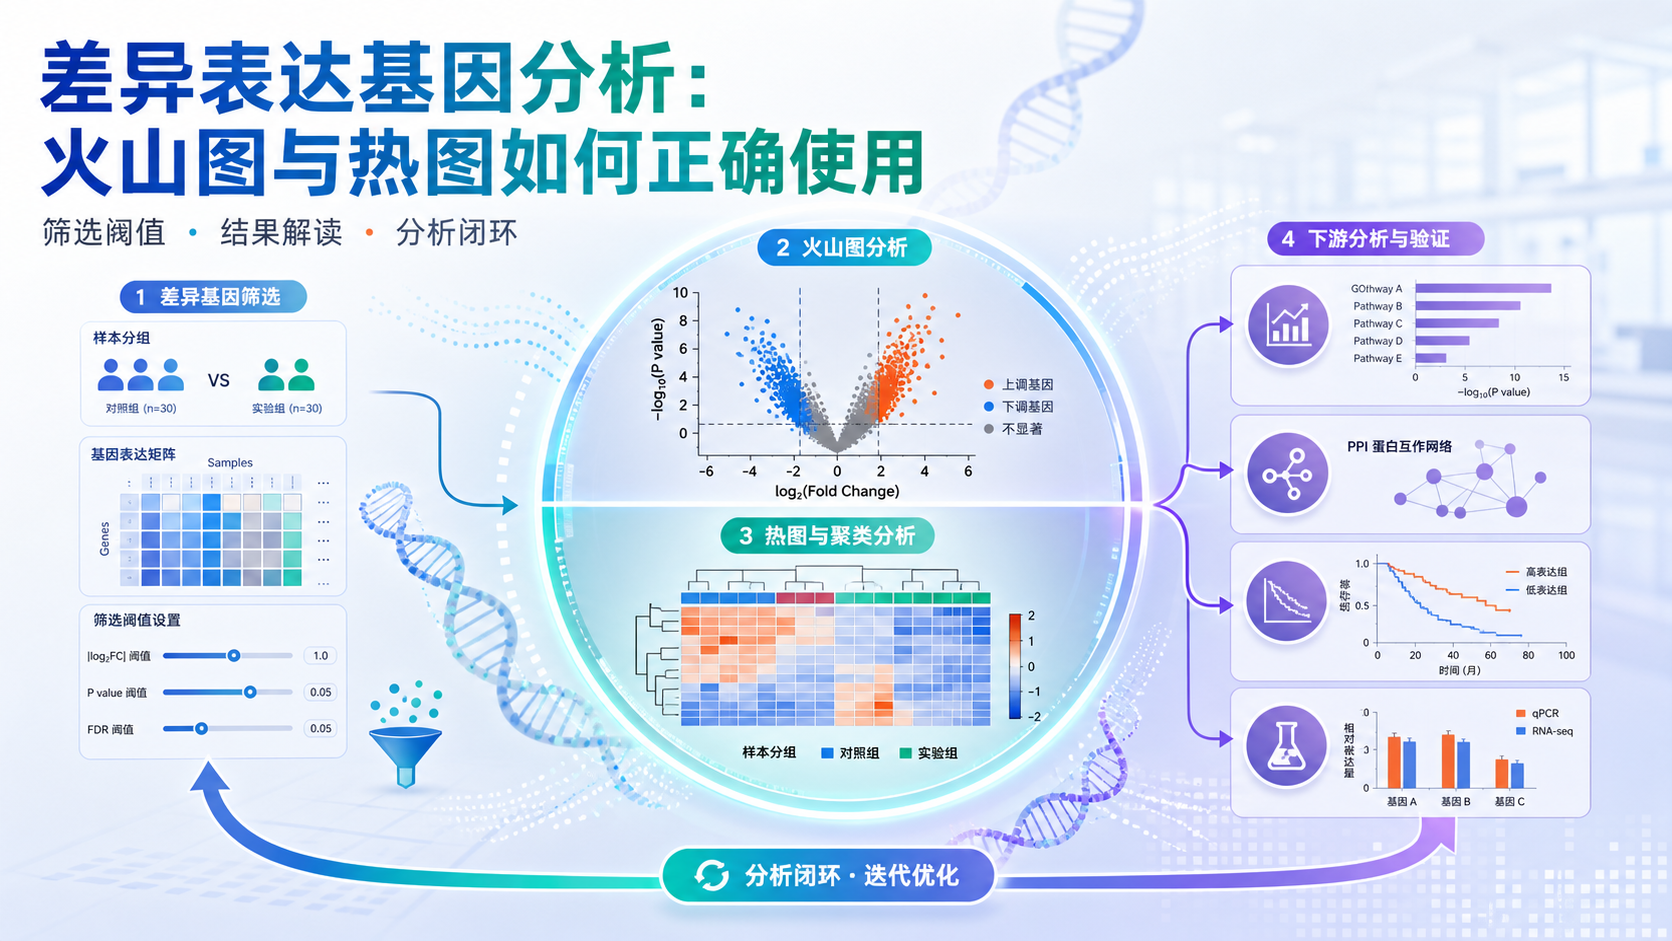 差异表达基因分析看似简单,真正影响结果的往往是阈值选择、基因筛选和可视化顺序。如果差异基因选得不稳,后续热图、富集分析和结论都会被放大误差。阅读142 · 点赞0Dr.Sheng 于2026-08-03发布
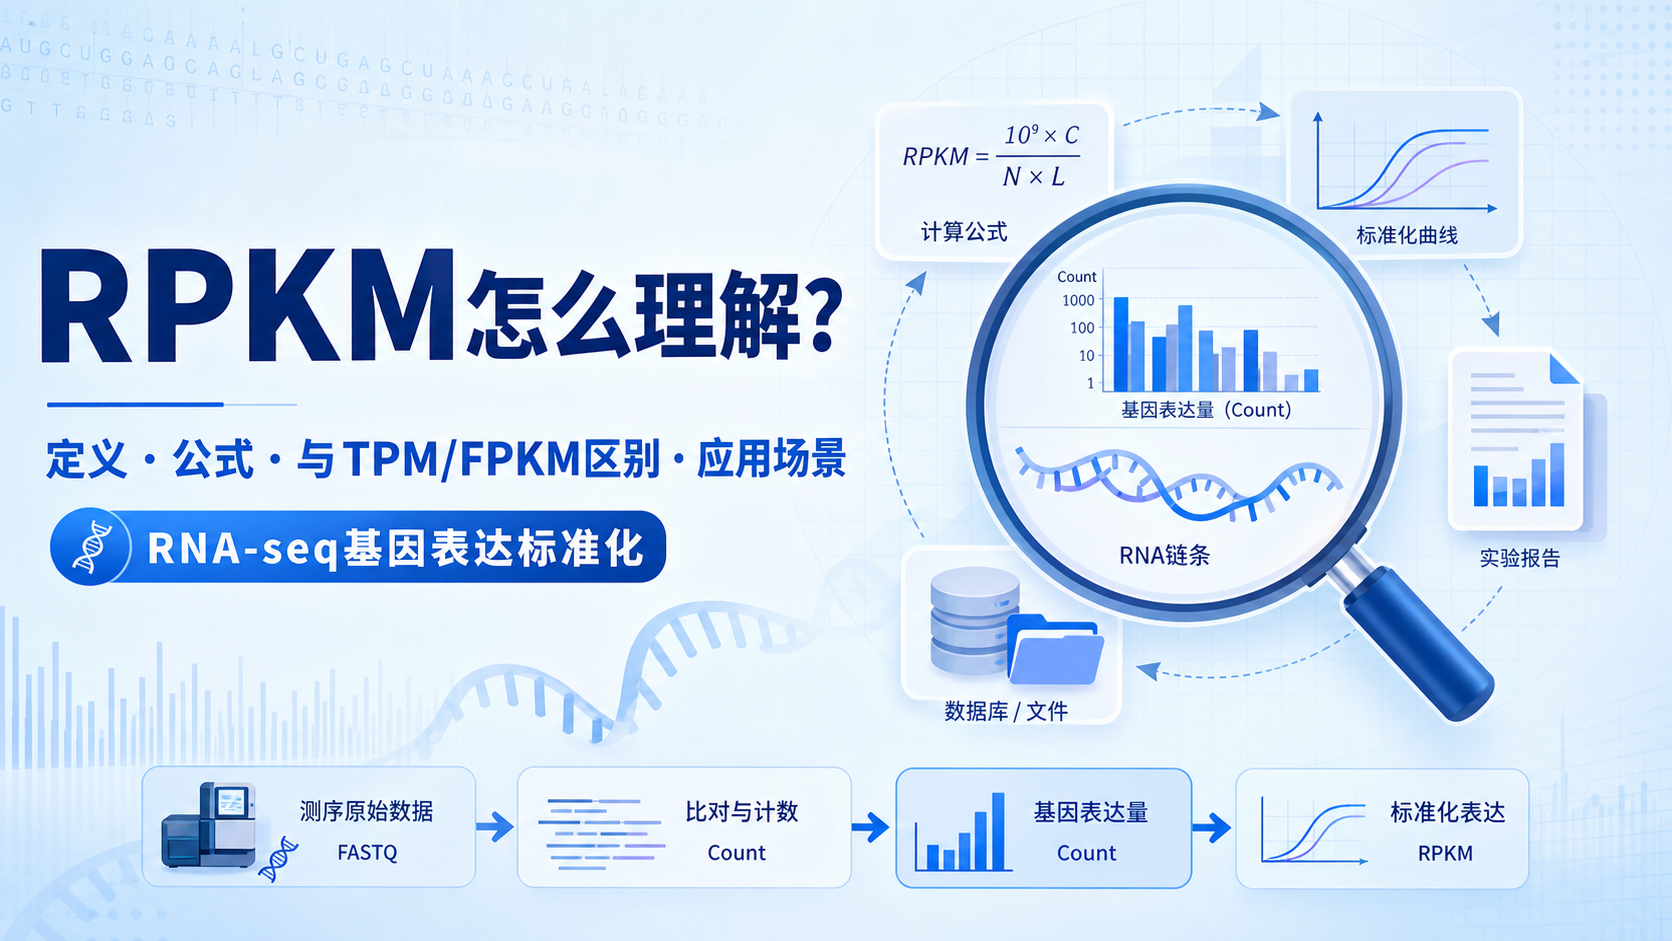 RNA-seq中,原始count不能直接比较。因为它同时受测序深度和基因长度影响。如果不做标准化,长基因更容易“看起来高表达”。这会直接干扰差异分析、样本对比和结果解释。阅读71 · 点赞0Dr.Sheng 于2026-08-03发布
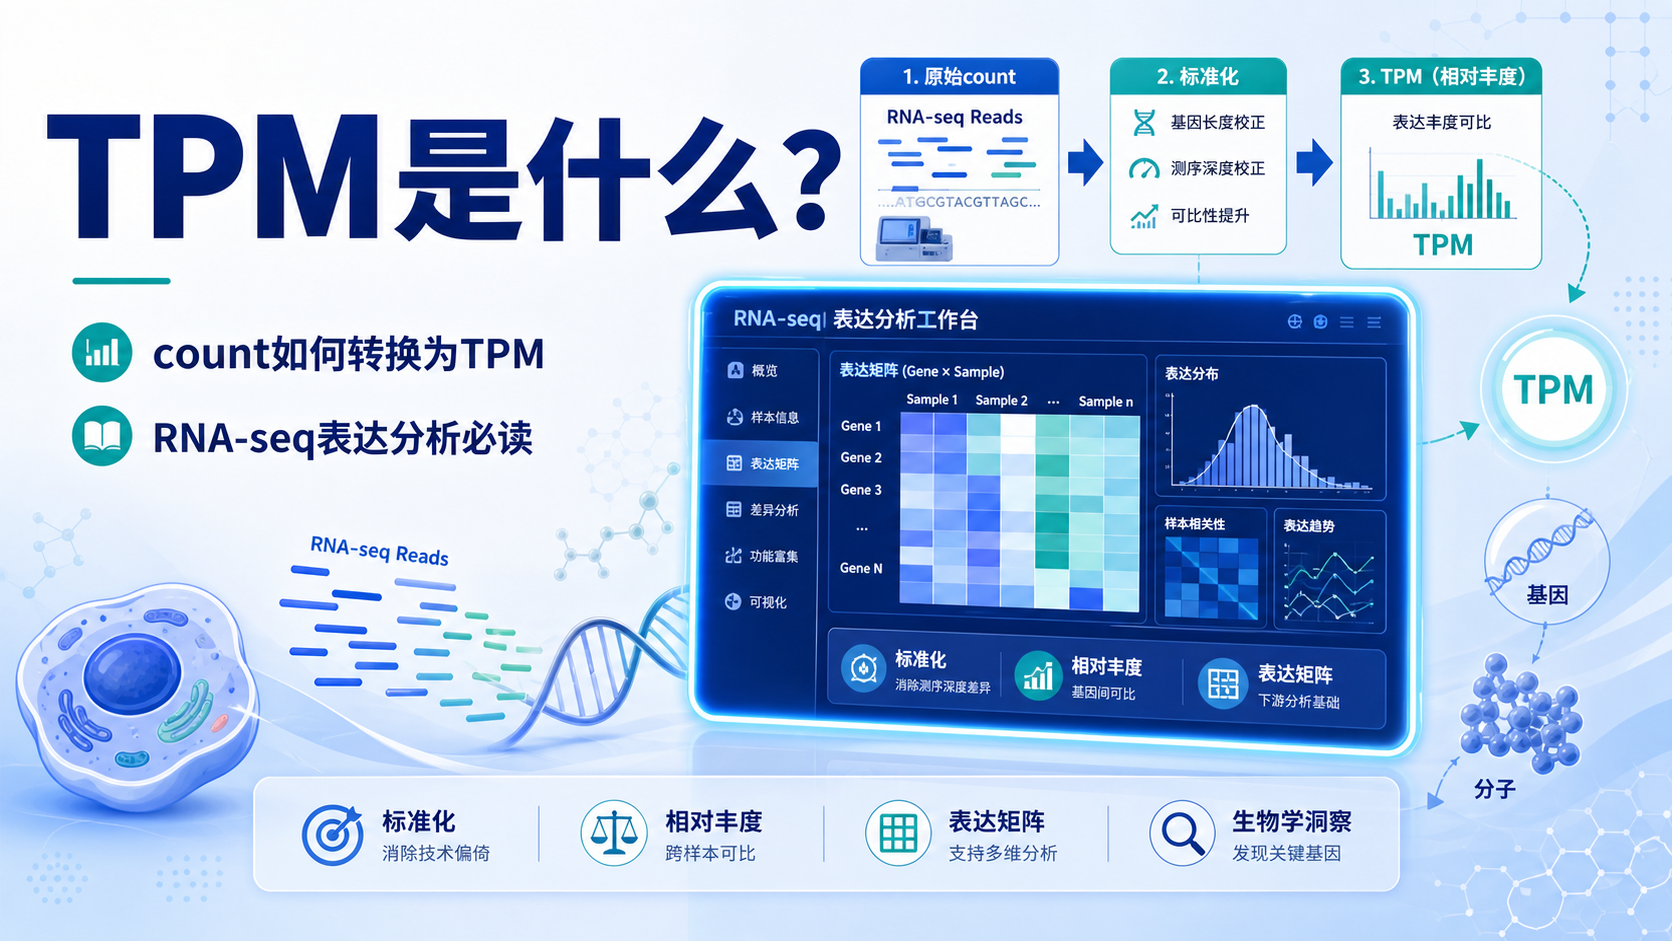 TPM是转录组分析里最常用的表达量单位之一,但很多人仍会把count、RPKM、FPKM和TPM混用。如果不理解TPM的计算逻辑,就很容易在可视化、跨样本比较和结果解读上出错。阅读86 · 点赞0Dr.Sheng 于2026-08-03发布
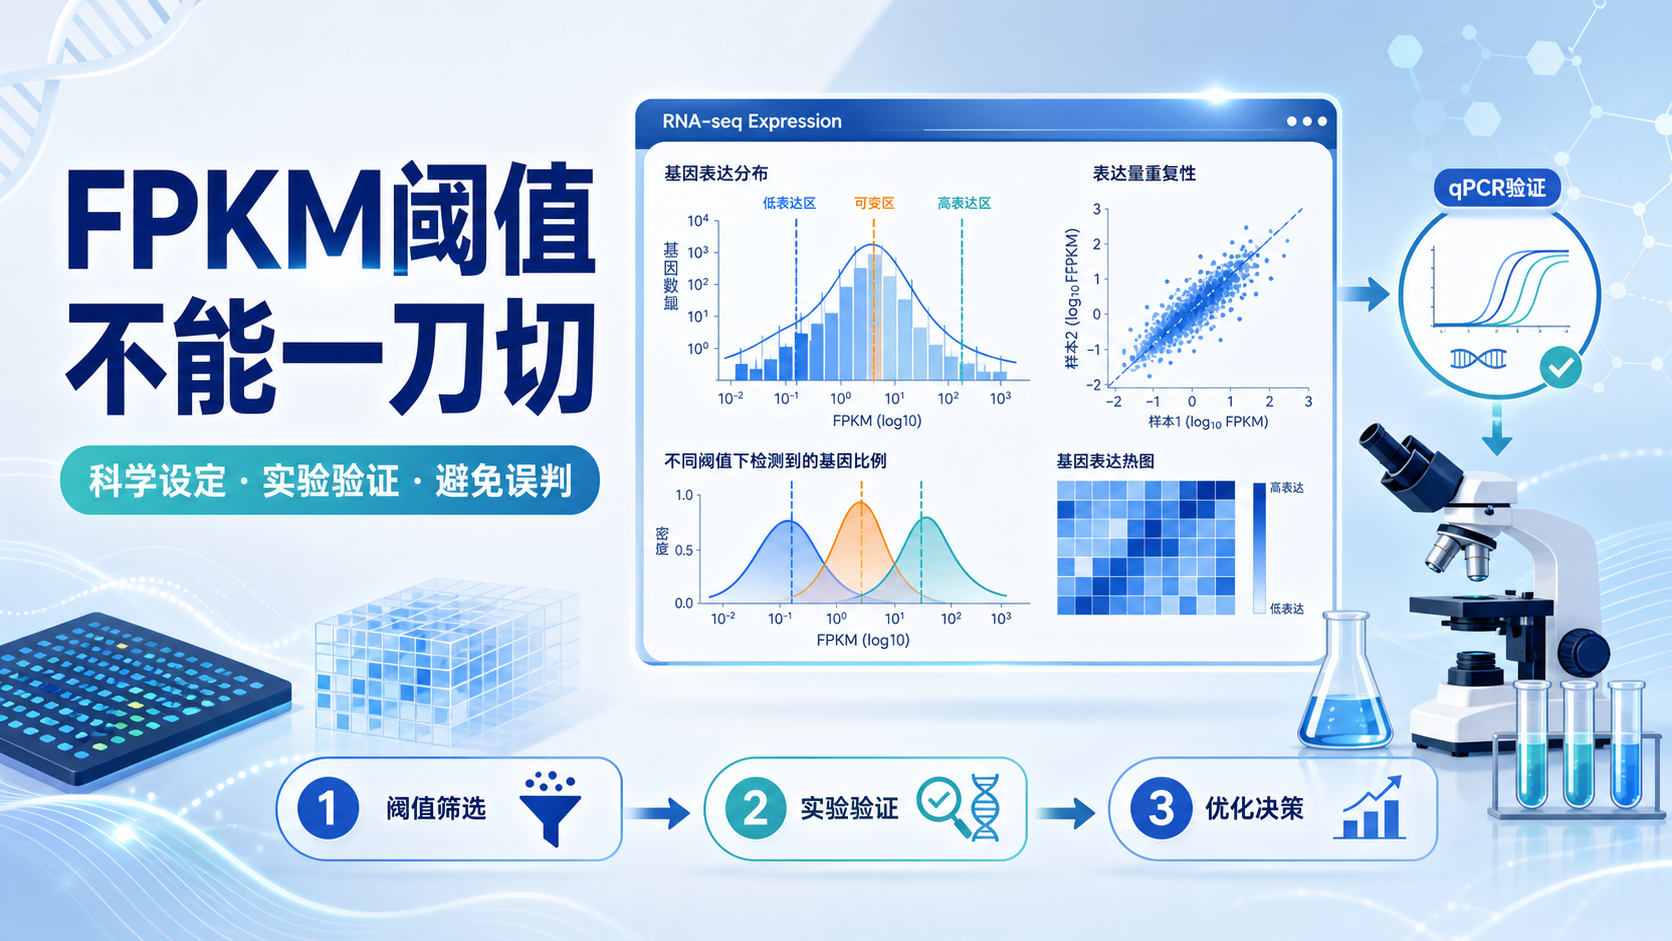 FPKM常被用于RNA-seq表达分析,但“多少算表达”并没有统一答案。阈值设低会引入噪音,设太高又会漏掉真实信号。对于医学生、医生和科研人员来说,真正难点不是算出FPKM,而是如何把阈值设得可解释、可验证、可复现。阅读69 · 点赞0Dr.Sheng 于2026-08-03发布
 基因表达量看似只是一个数值,实际却决定了后续差异分析、分组比较、预后评估能否成立。很多生信项目卡在“会跑流程,不会解读结果”。真正的难点,不是拿到表达矩阵,而是判断它能不能支撑课题。阅读51 · 点赞0Dr.Sheng 于2026-08-03发布
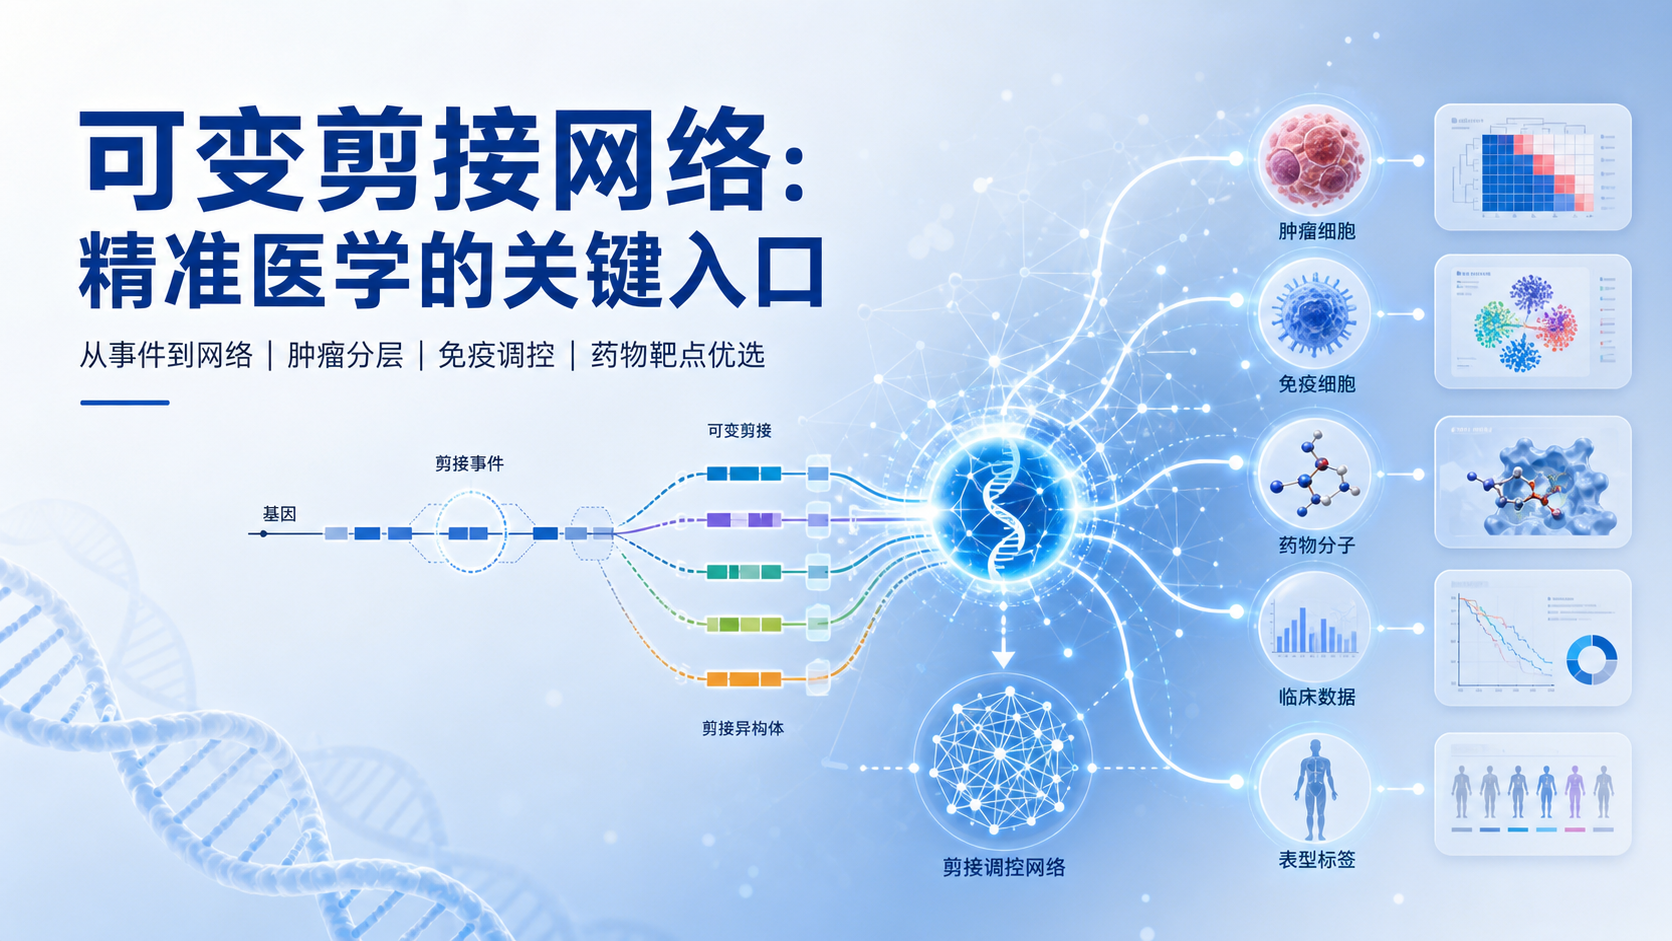
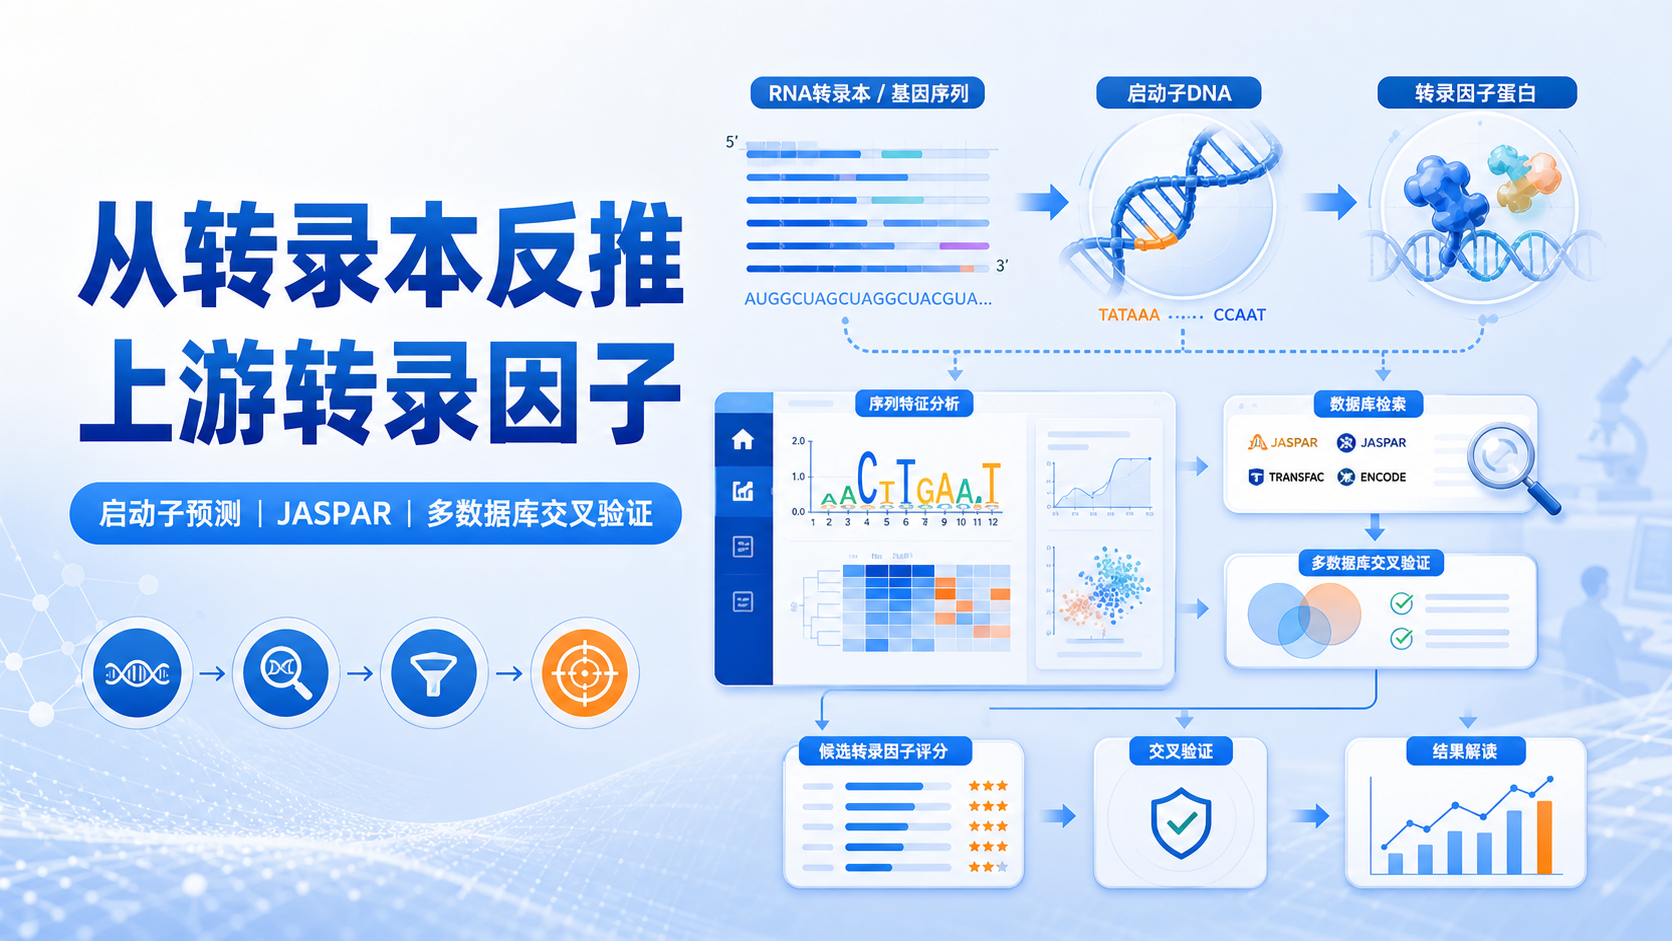 转录本相关研究常卡在上游调控环节。知道表达变化,却说不清是谁在调控,怎么验证,优先选哪个候选因子。如果你需要快速把“转录本变化”追到“转录因子调控”,启动子定位和基序预测是最直接的入口。阅读117 · 点赞1Dr.Sheng 于2026-08-03发布
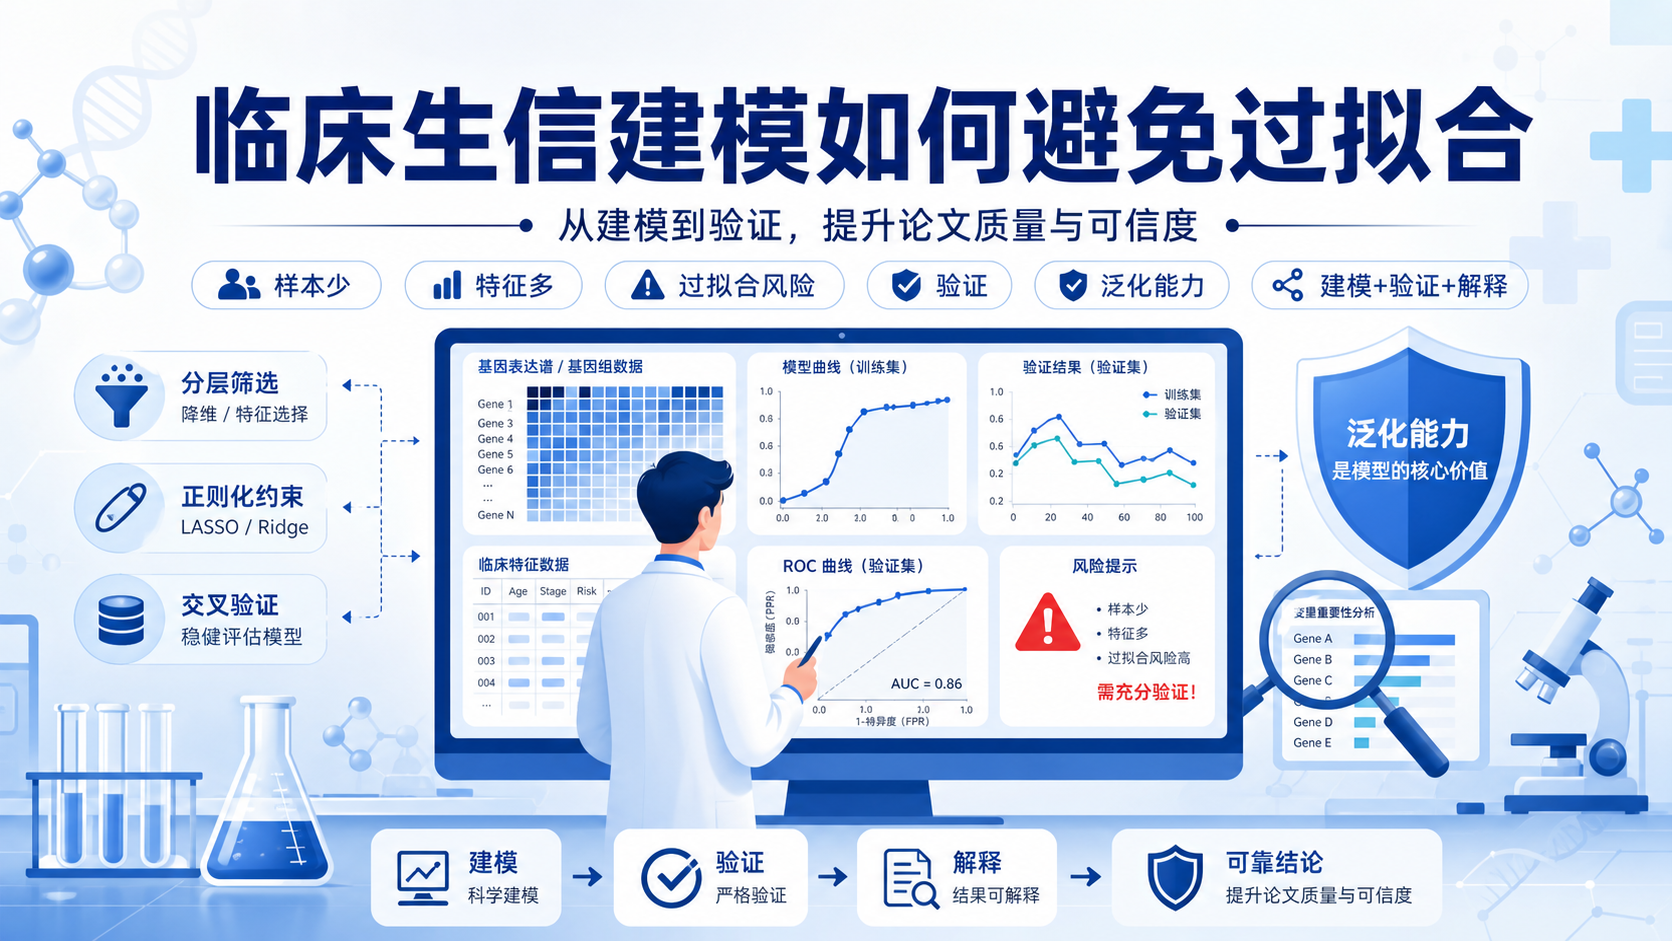 临床生信建模很容易“模型看起来很美,外部一验证就崩”。很多文章卡在这里,核心问题不是算法不够新,而是样本量、特征筛选和验证设计出了偏差。避免过拟合,才是临床生信发文能否站住脚的关键。阅读74 · 点赞0Dr.Sheng 于2026-07-26发布
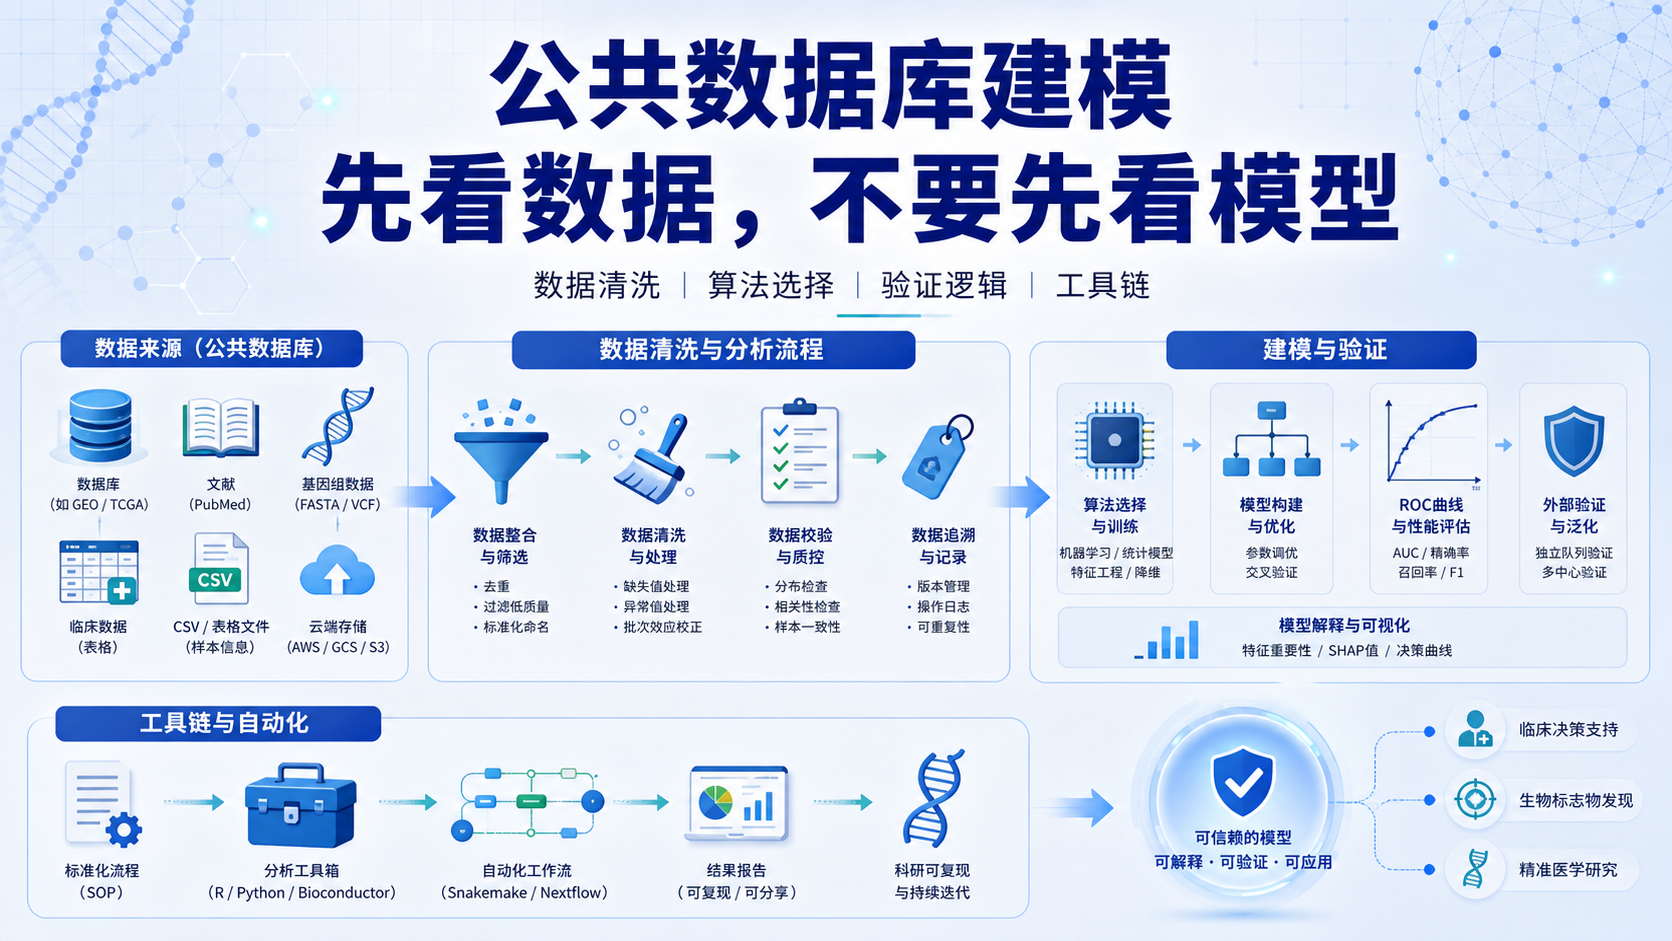 公共数据库建模是生信研究中最常见、也最容易出错的环节。很多项目不是败在算法,而是败在数据清洗不充分、分组不一致、终点定义模糊。如果起点数据不干净,后面的模型再复杂,结论也不稳。阅读63 · 点赞0Dr.Sheng 于2026-07-26发布
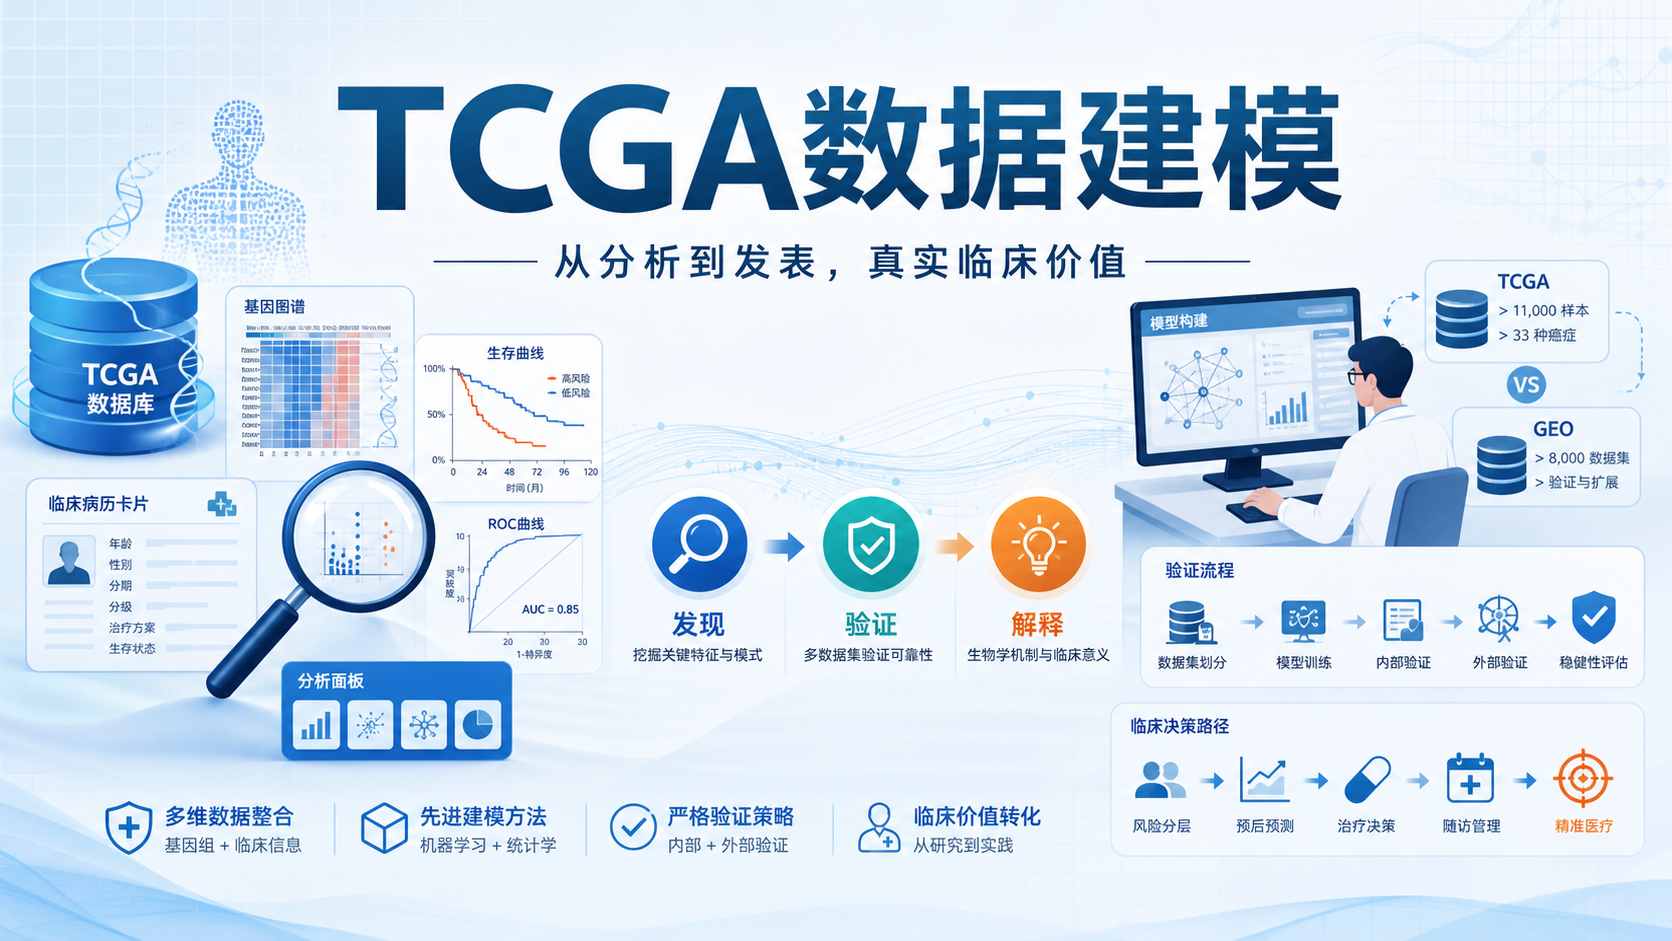 TCGA的价值,不只是“能下载数据”。它的优势在于样本量、临床信息、分子信息相对完整,适合做预后模型、分型研究、机制挖掘和外部验证。对临床课题而言,TCGA最大的作用,是让研究从“经验判断”转向“数据驱动”。阅读65 · 点赞0Dr.Sheng 于2026-07-26发布
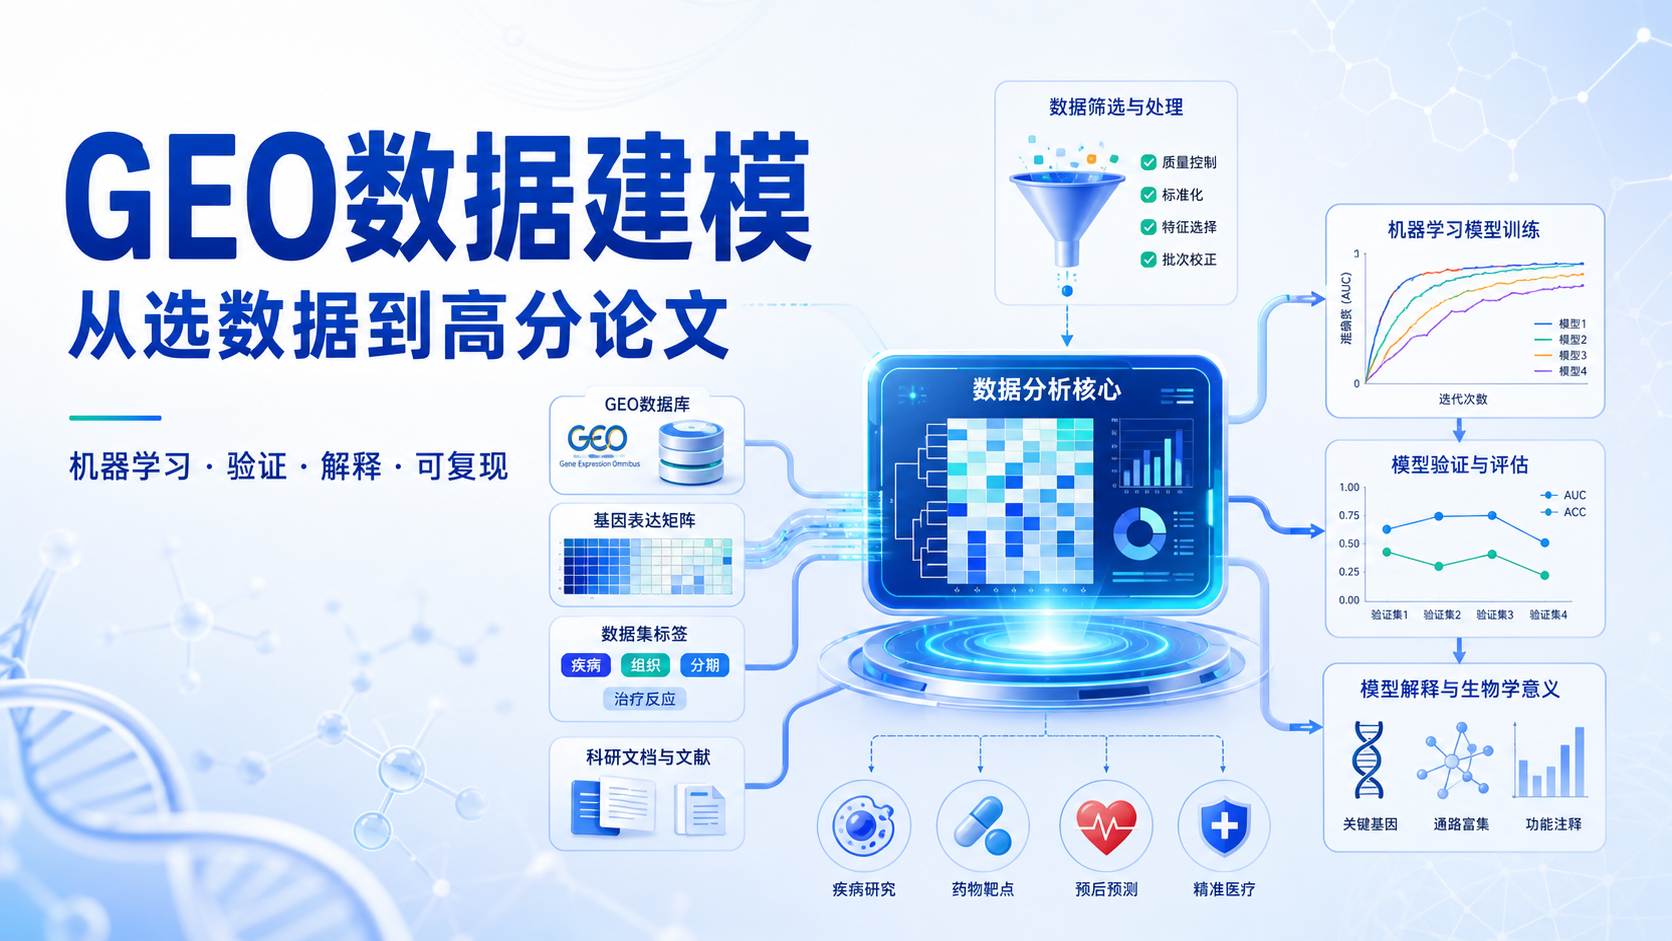 GEO数据量大,样本类型杂,很多生信初学者常卡在“会下载,不会建模”。更难的是,机器学习看似简单,真正写成高分论文却常因数据筛选、特征选择和验证不规范而失败。阅读76 · 点赞0Dr.Sheng 于2026-07-26发布
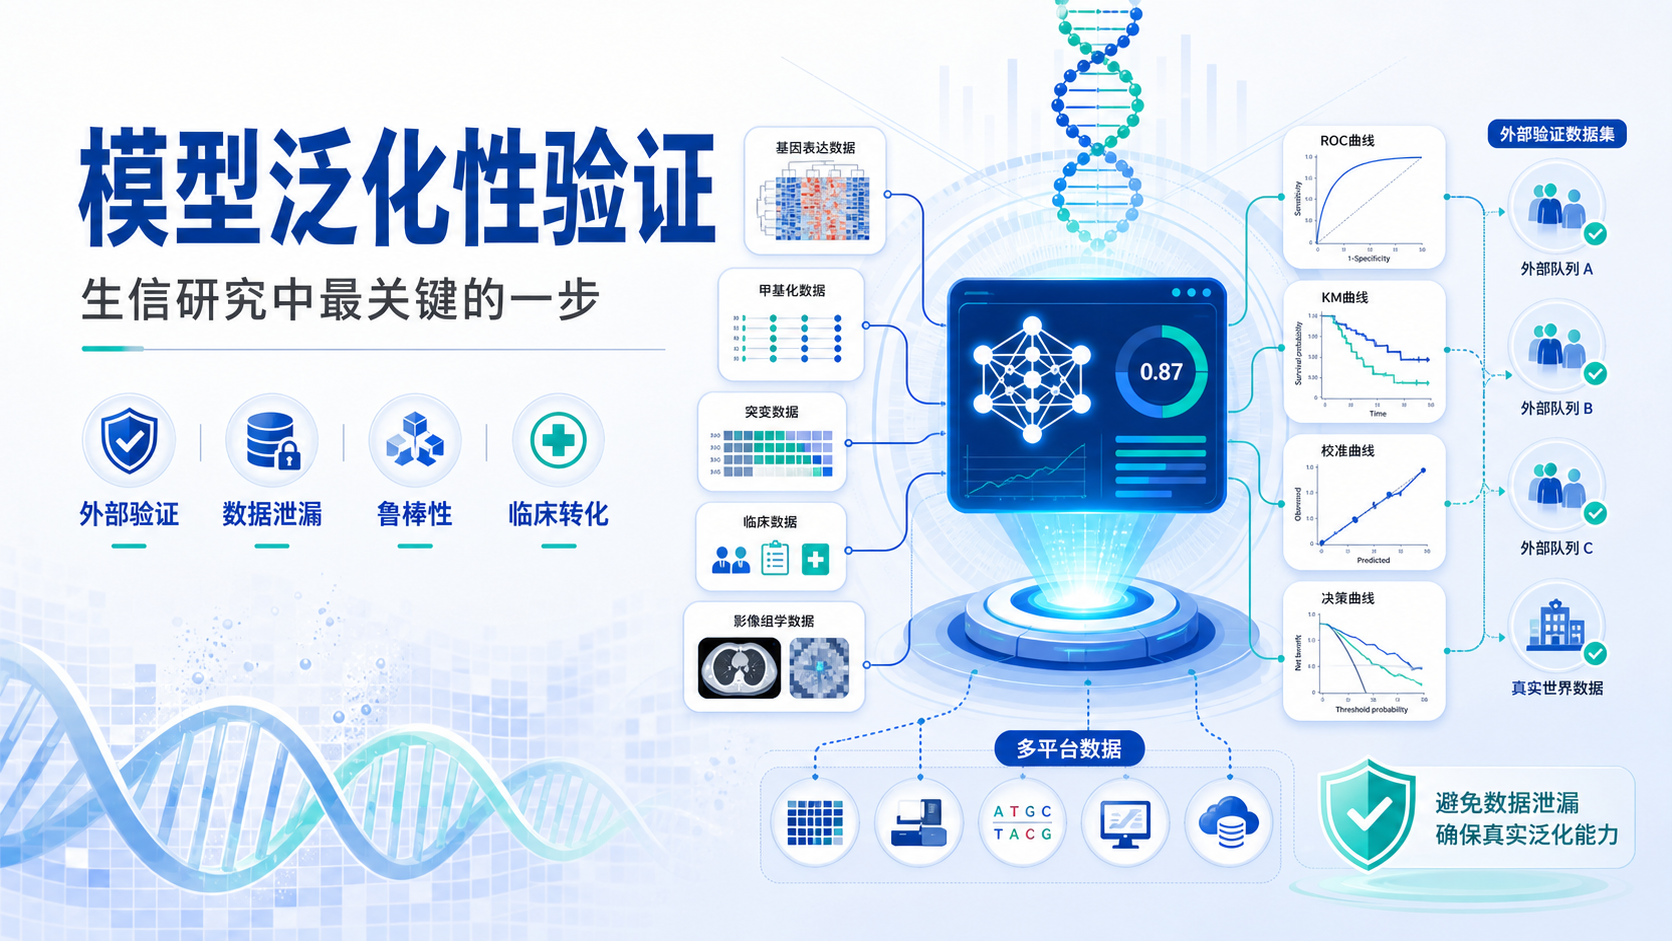 生信模型在训练集上表现很好,不代表到了真实世界还能用。很多研究卡在最后一步,不是模型不准,而是缺少严谨的模型泛化性验证。对医学生、医生和科研人员来说,这一步决定结果能否发表,也决定结论能否转化。阅读94 · 点赞0Dr.Sheng 于2026-07-26发布
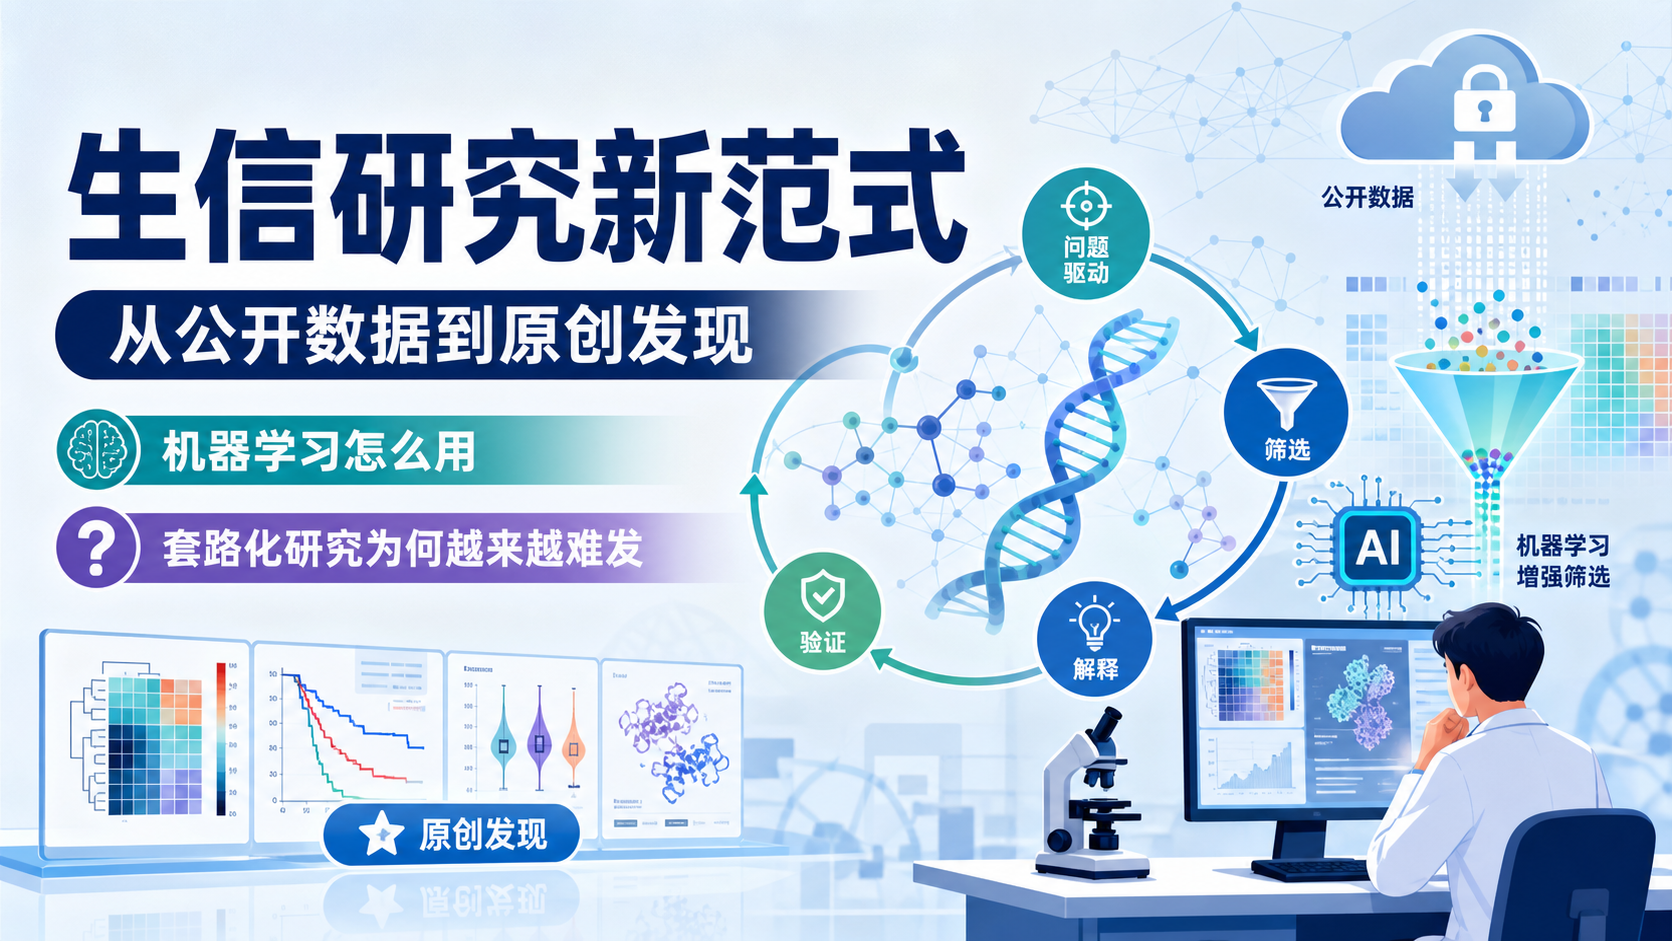 对医学生、医生和科研人员来说,新的挑战很明确。套路化生信研究正在快速贬值,而有临床问题导向、数据整合能力和算法思维的研究,反而更容易形成高质量成果。阅读87 · 点赞0Dr.Sheng 于2026-07-26发布
热门文章
测序reads是什么?5个核心要点解析
阅读934 · 点赞0
GEPIA2使用教程:超实用入门指南
阅读750 · 点赞0
GEPIA2数据分析:6步高效上手教程
阅读547 · 点赞0