


资讯
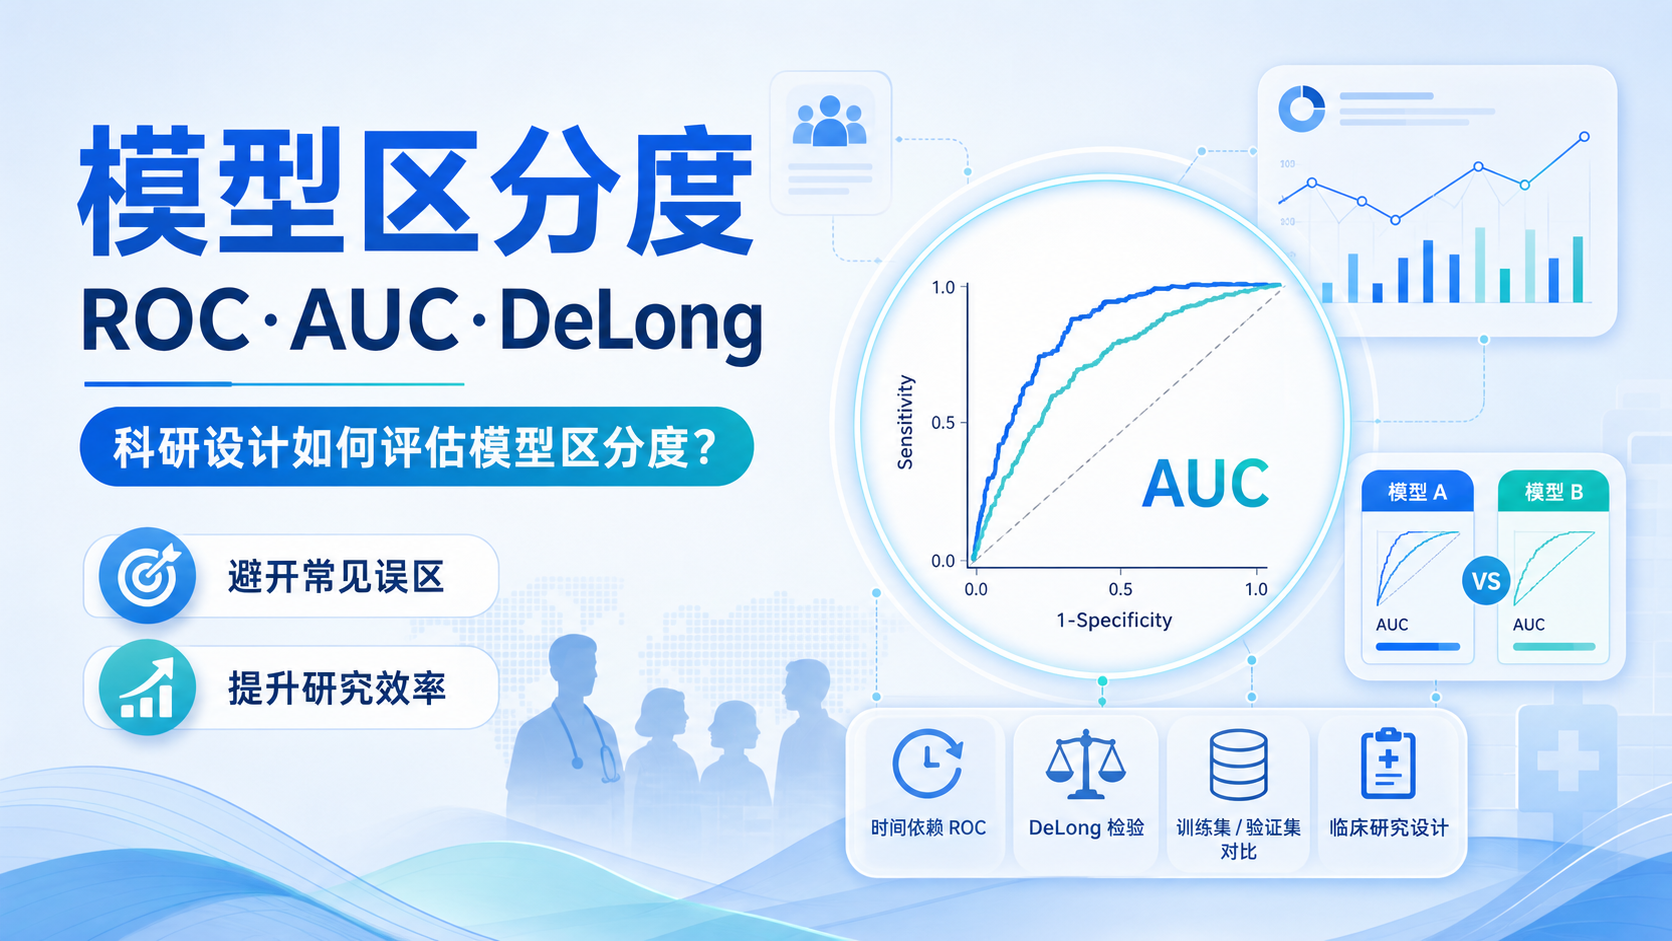 模型区分度决定预测模型能否把高风险与低风险个体真正分开。对医学生、医生和科研人员来说,常见问题不是“有没有模型”,而是“模型是否真的分得开”。区分度不足,后续校准和临床应用都没有基础。阅读75 · 点赞0Dr.Chuang 于2026-10-03发布
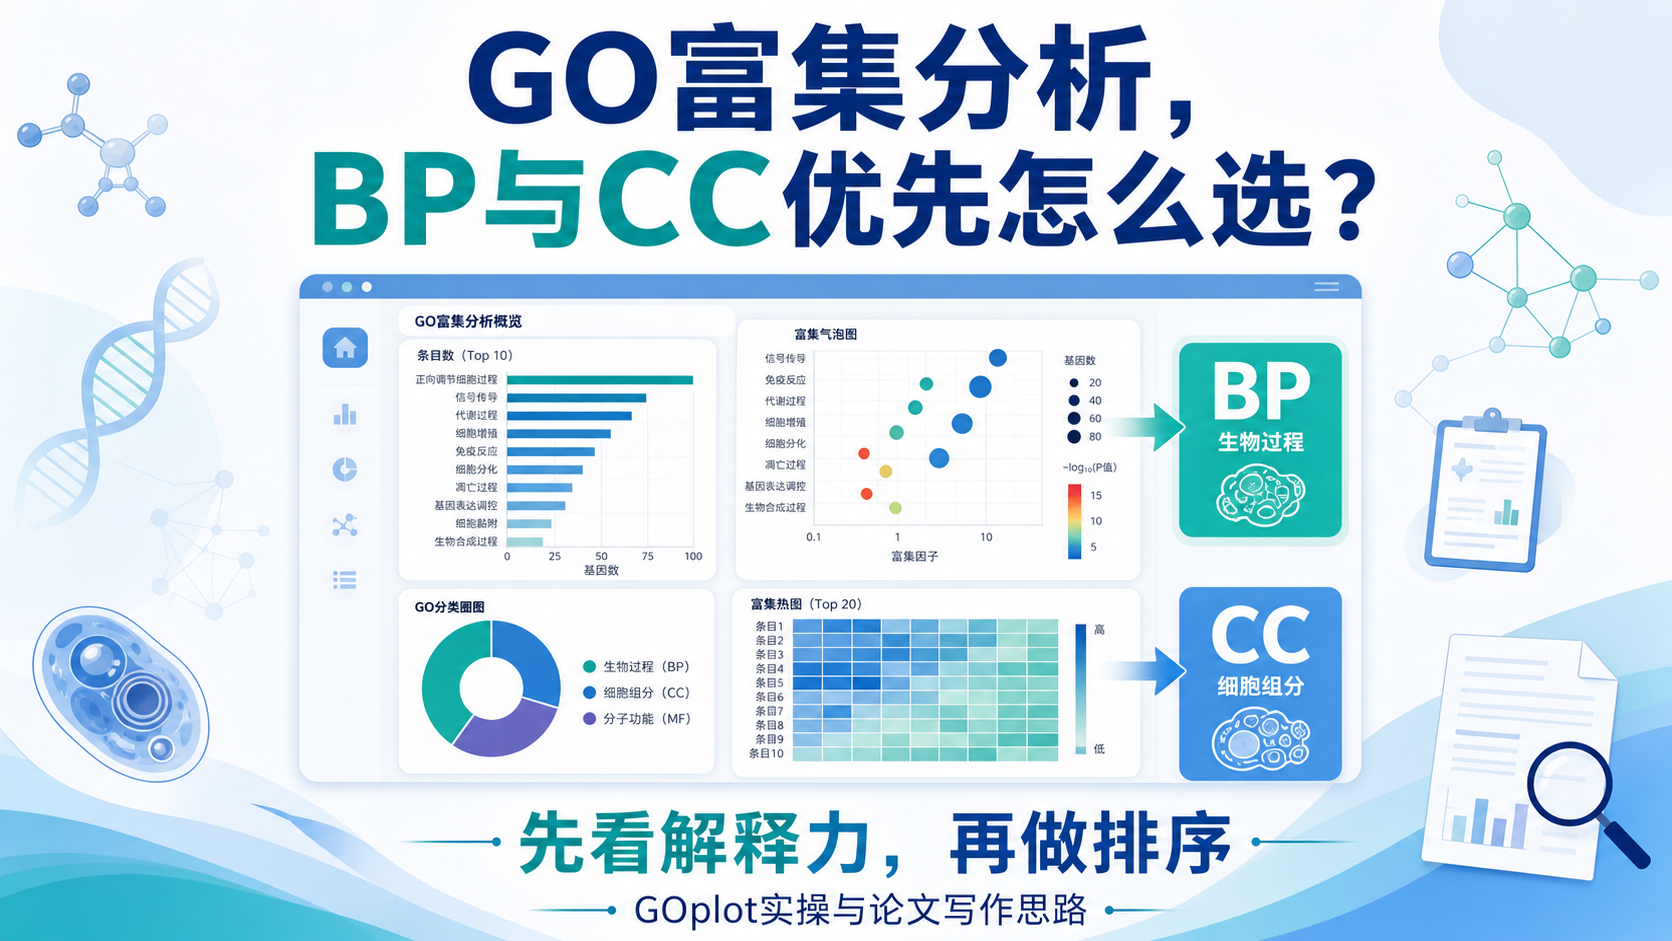 GO功能注释看似标准,但真正做分析时,很多人会卡在第一步。BP、CC、MF三类本体如何取舍,直接影响结果解释的区分度和可读性。对于医学生、医生和科研人员来说,选对分析路径,比堆砌图表更重要。阅读81 · 点赞0Dr.Chuang 于2026-10-03发布
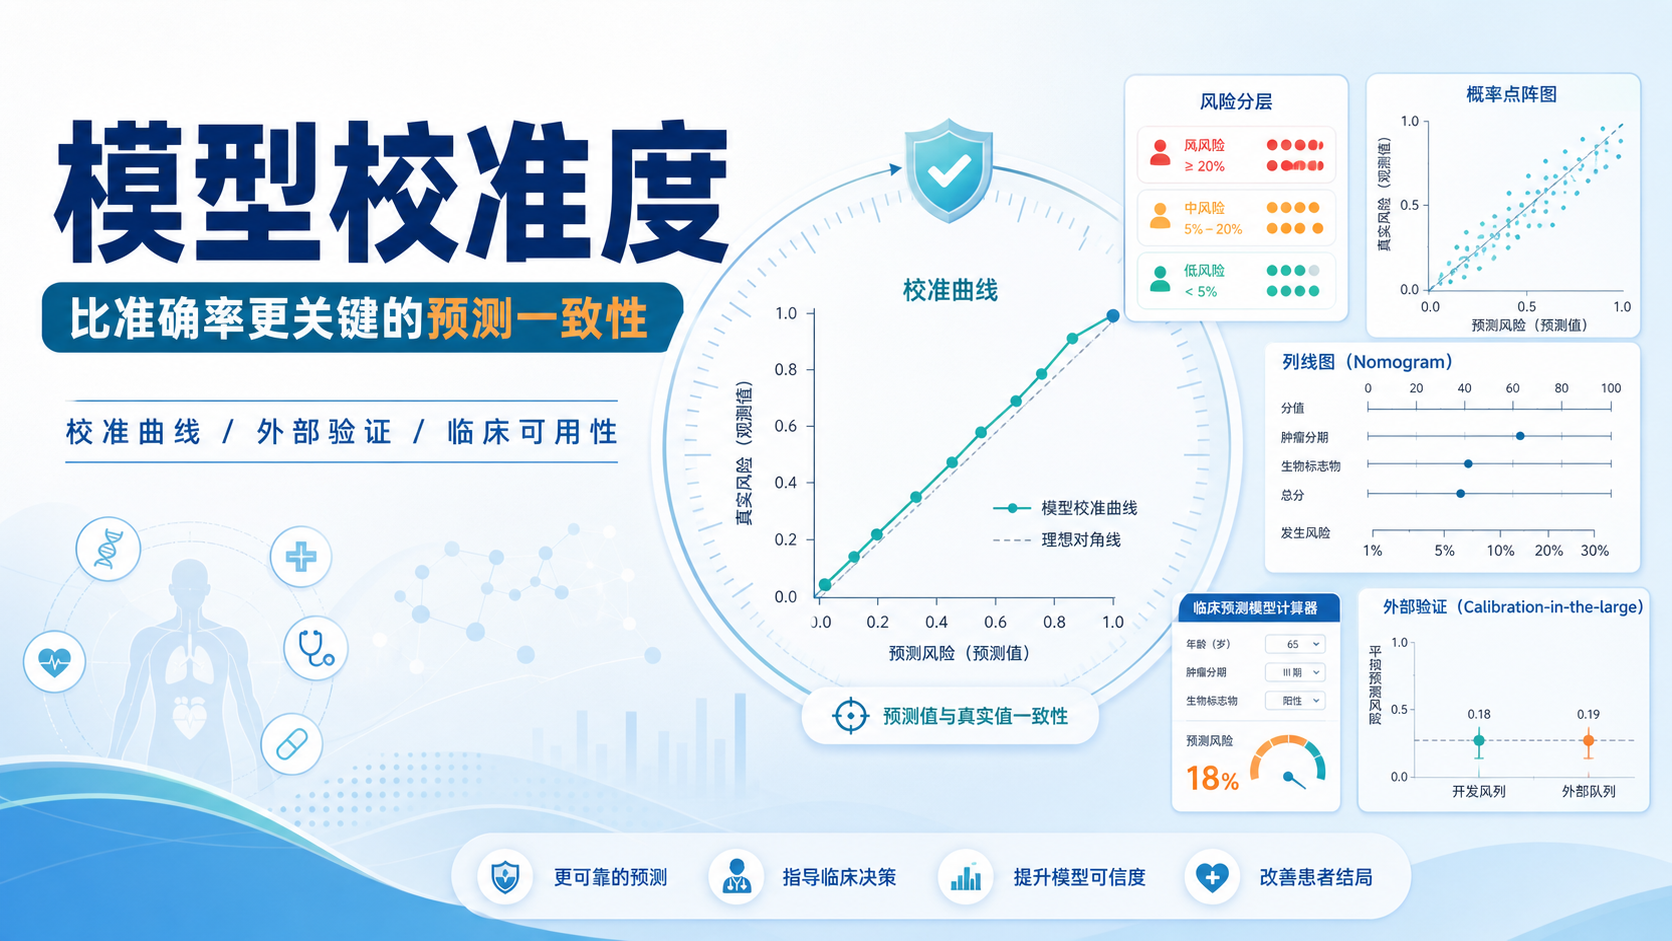 模型区分度高,不代表预测就准。很多研究在训练集表现很好,到了外部数据却明显“失真”。真正决定模型能不能落地的,不只是AUC,而是校准度。对医学生、医生和科研人员来说,理解校准度,是避免模型“看起来很强,实际很偏”的关键。阅读70 · 点赞0Dr.Chuang 于2026-10-03发布
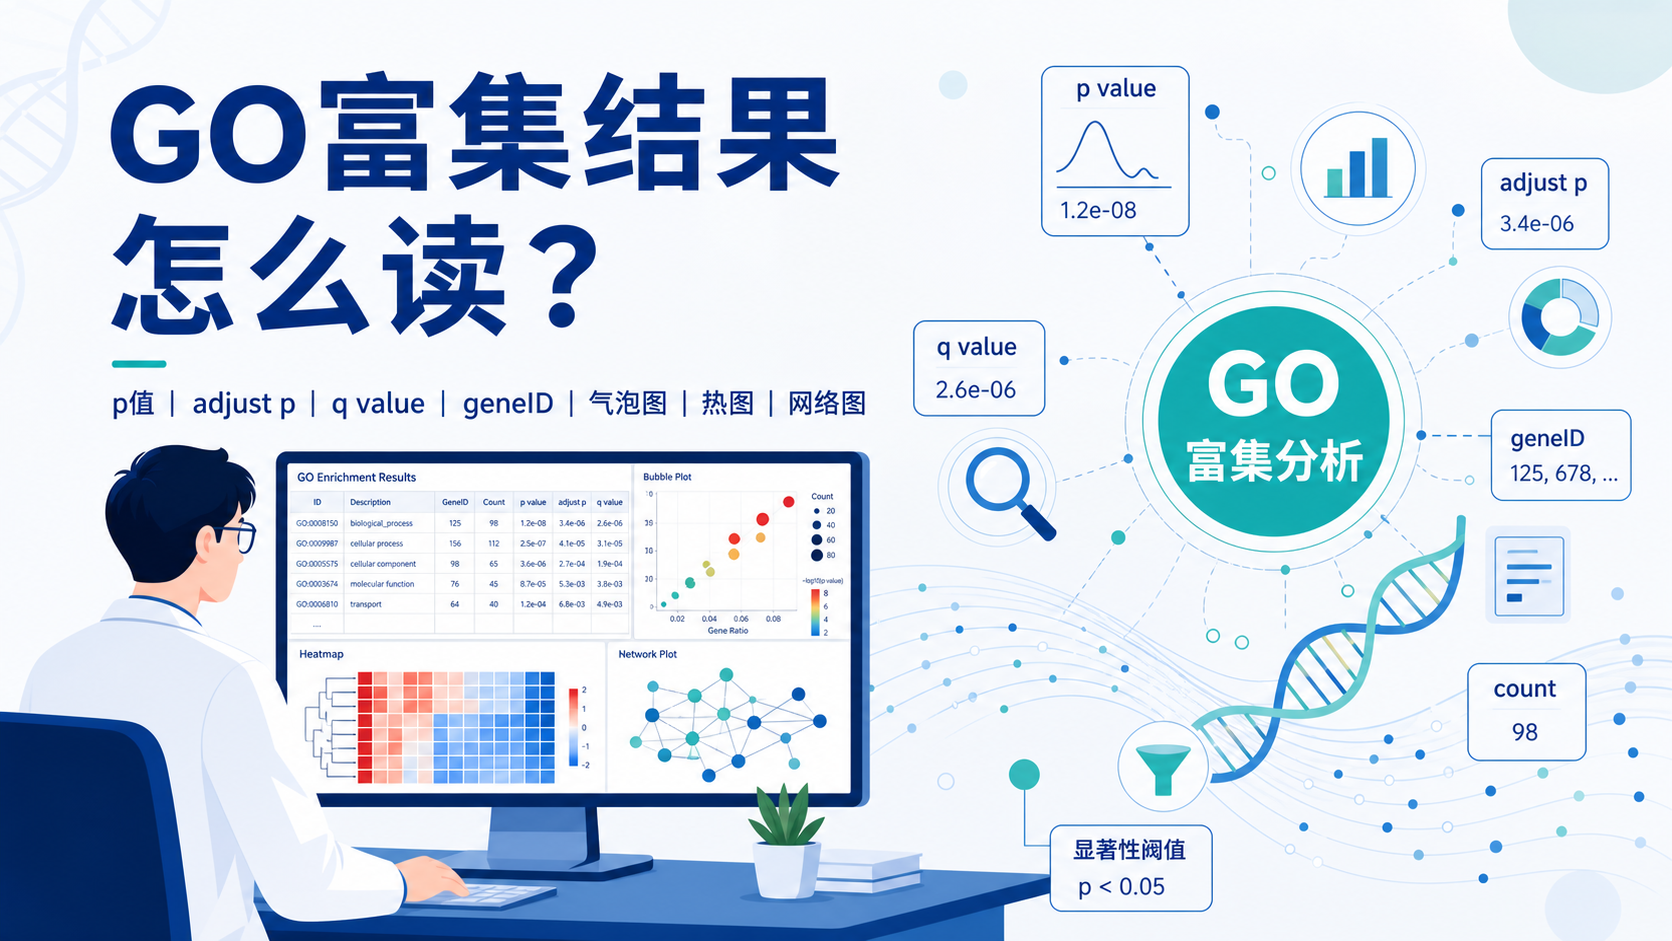 GO富集结果里,adjustp、qvalue、count和基因清单常常让人看不懂。只盯着原始p值,容易误判;只看气泡图,又容易忽略真实生物学含义。本文结合实操,帮你快速读懂富集结果,并把结果真正用到课题分析中。阅读128 · 点赞0Dr.Chuang 于2026-10-03发布
 校准曲线是生存分析模型审稿中最容易被追问的部分。很多稿件不是模型不好,而是校准图画得不规范,参数交代不清,导致一致性评价缺乏说服力。如果你正在写Cox回归、列线图或预后模型论文,这篇文章可以直接帮你避开常见争议。阅读92 · 点赞0Dr.Chuang 于2026-10-03发布
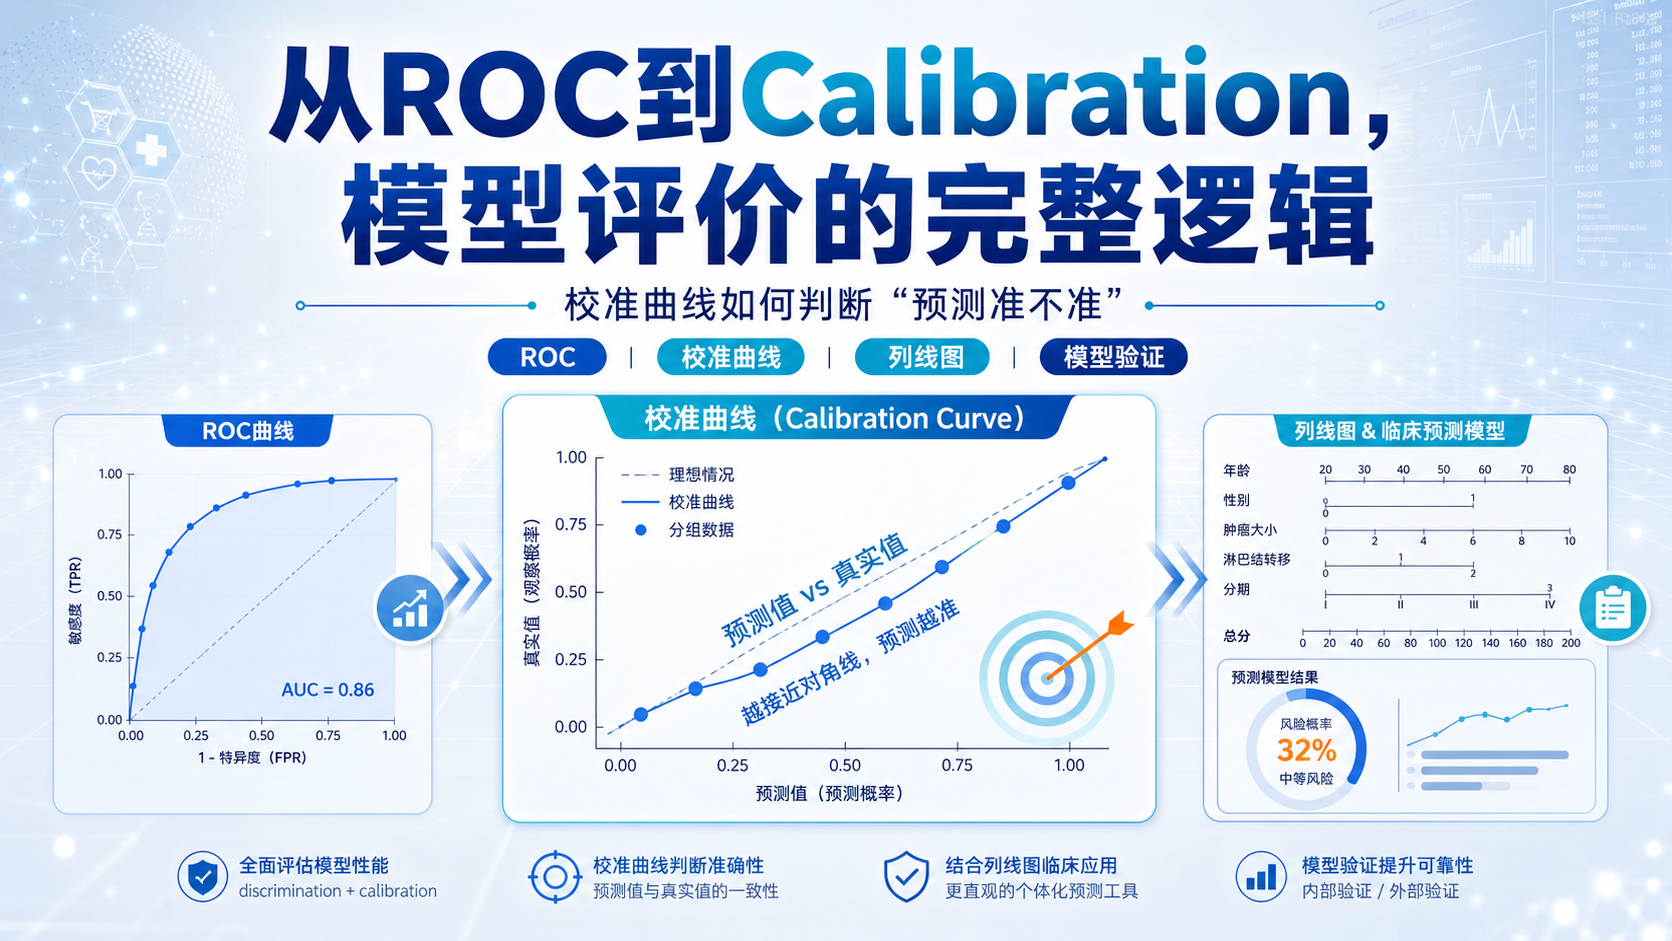 ROC能告诉你模型“分得开”,但不能证明它“算得准”。很多临床预测模型AUC很高,实际应用却偏差明显,问题往往出在校准不够好。区分度高,不等于临床可用。阅读97 · 点赞0Dr.Lin 于2026-10-02发布
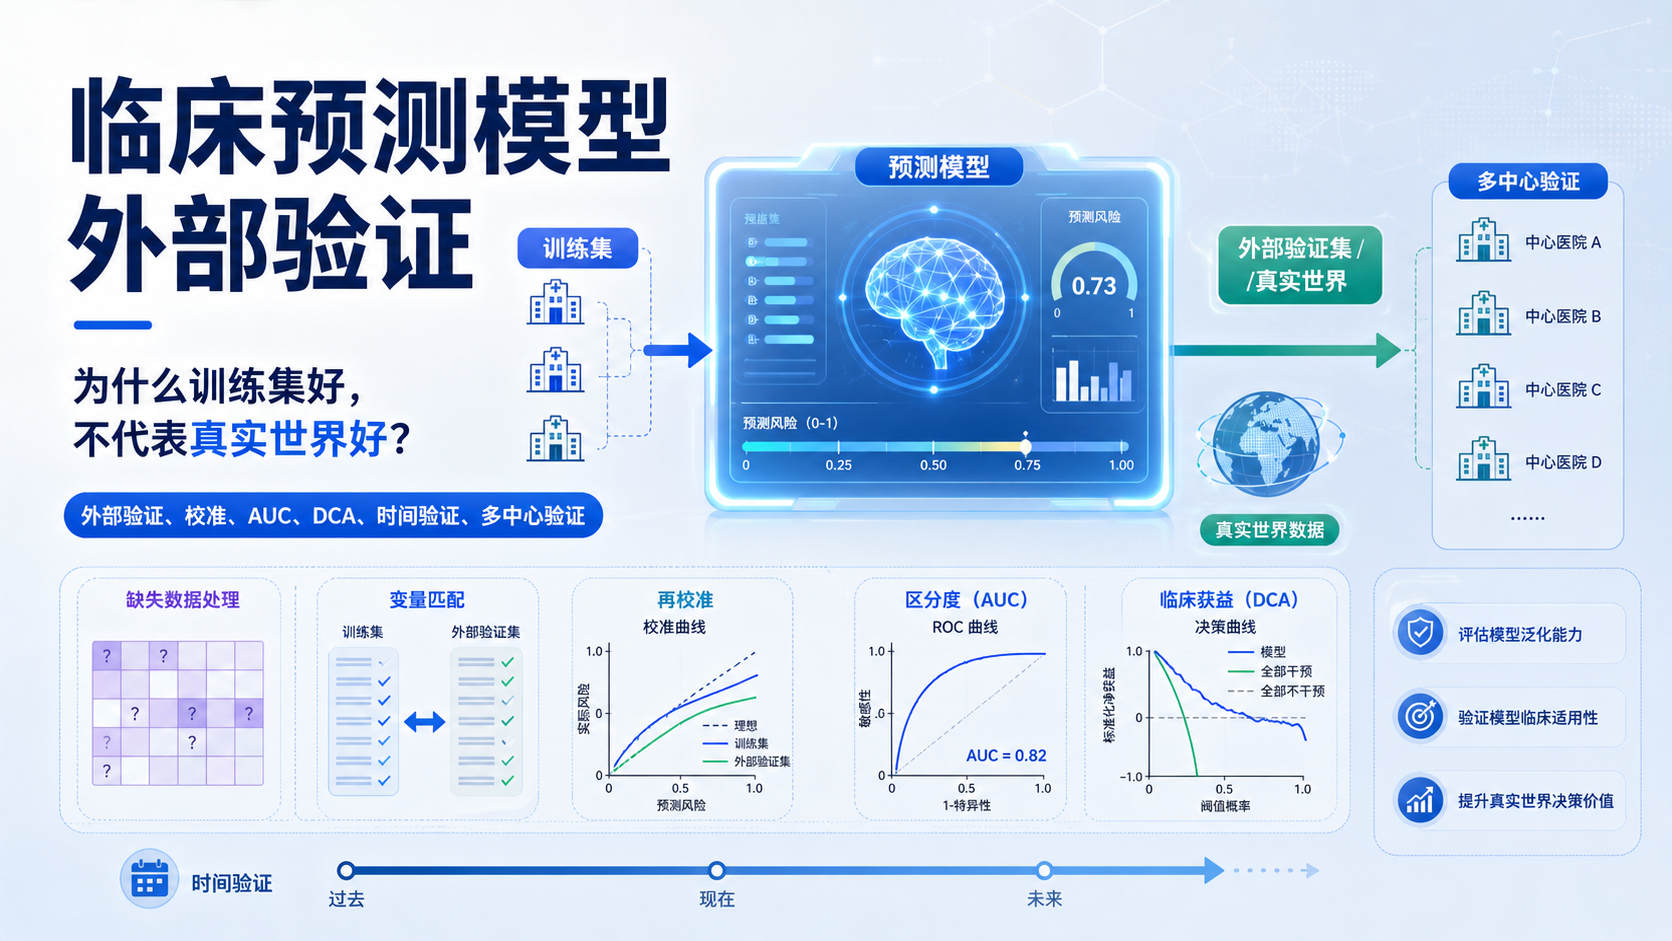
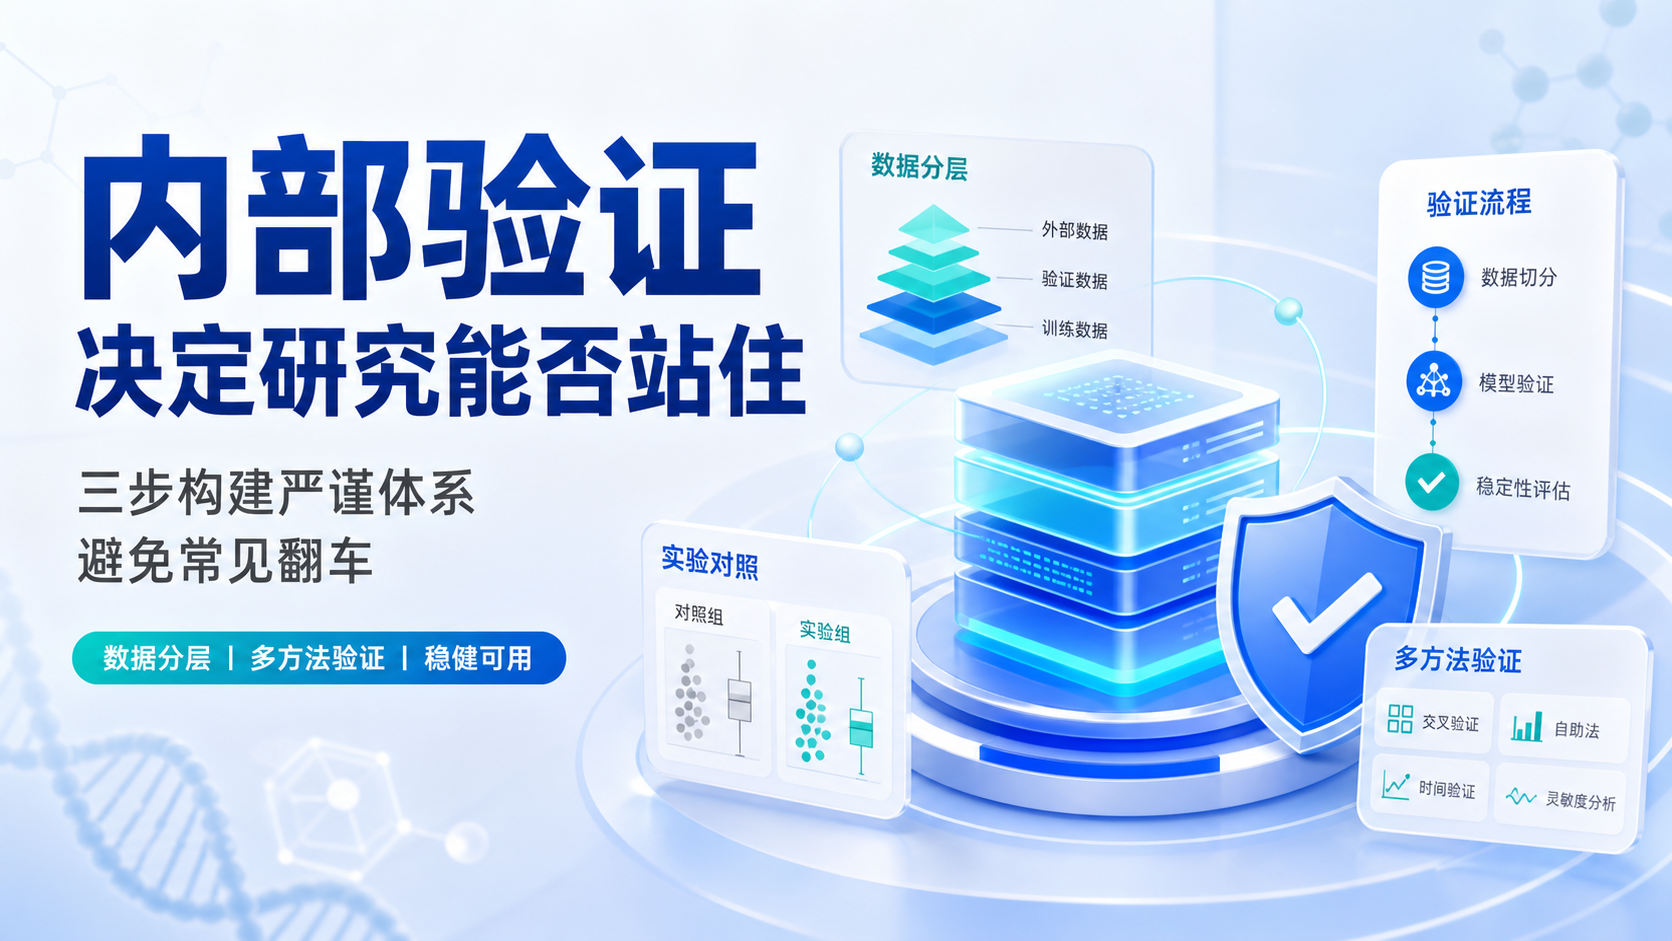 很多研究不是败在假设,而是败在验证。模型做出来了,结果看似漂亮,却经不起重复、分层和外部审视,最后只能停在“故事完整,证据不足”。内部验证缺失,往往是研究翻车的第一道裂缝。阅读68 · 点赞0Dr.Lin 于2026-10-02发布
 临床研究常见的问题,不是“没想法”,而是方案还没成型就急着开干。结果就是选题跑偏、结局不清、样本量不足,最后很难发表。四要素校验,就是把研究拉回正确轨道的第一步。阅读65 · 点赞0Dr.Lin 于2026-10-02发布
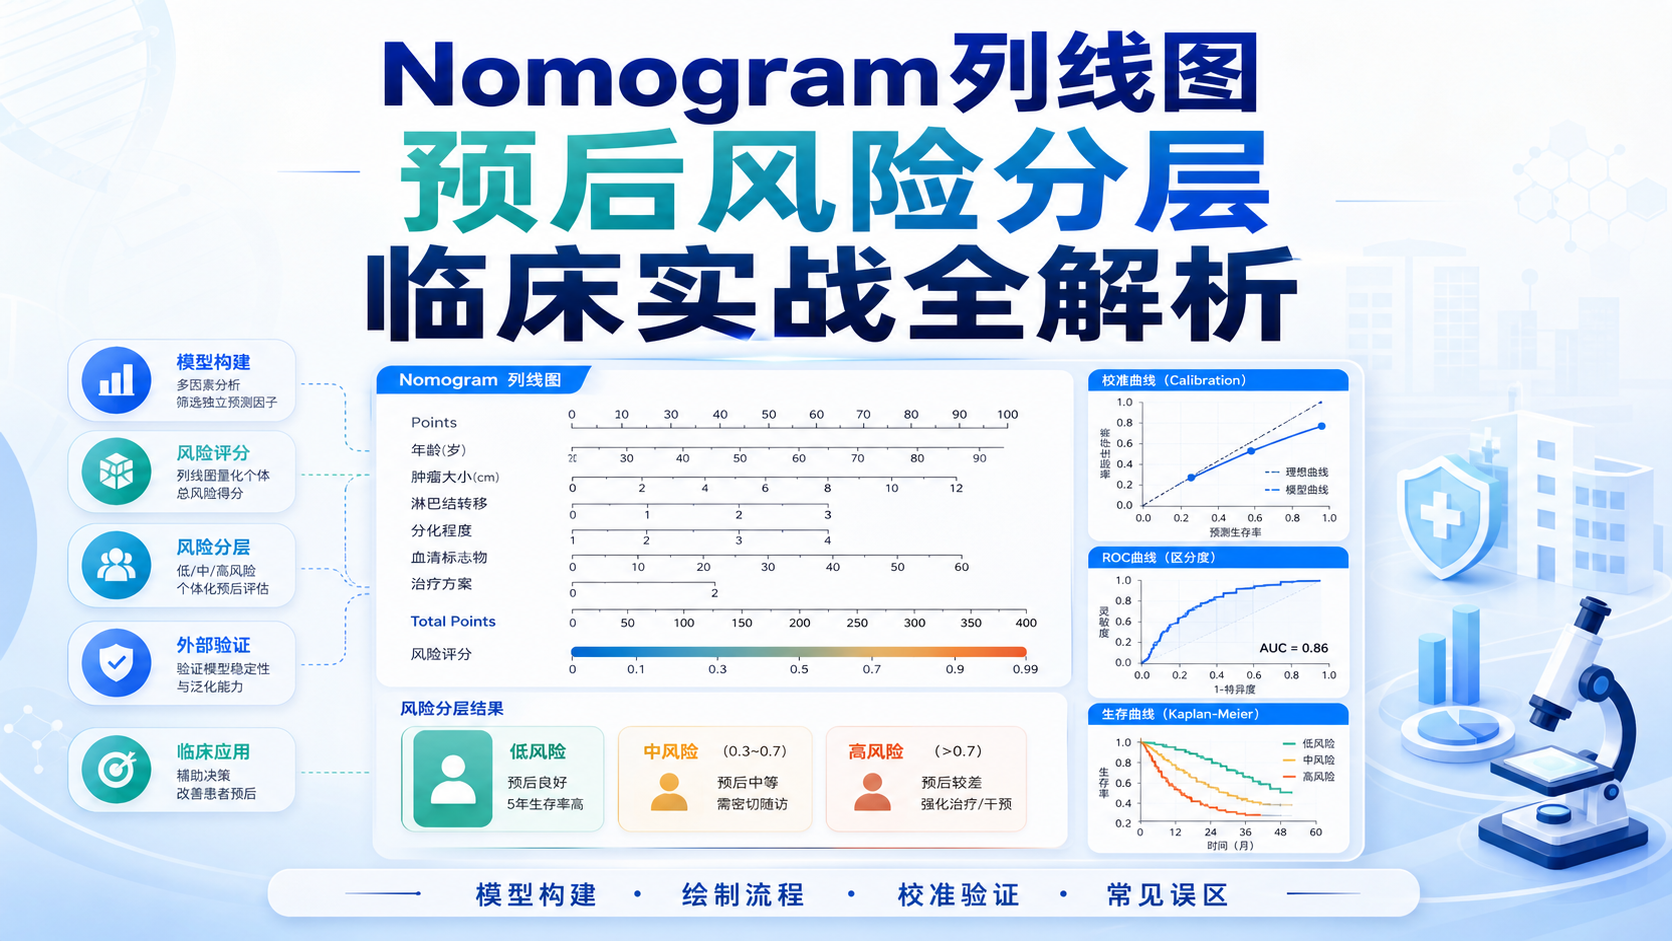
 列线图绘制并不只是“画图”。对医学生、医生和科研人员来说,它决定了预测模型能否真正用于临床。如果只会回归分析,却不会把结果转化为可解释、可验证的工具,模型的临床价值就会大打折扣。阅读101 · 点赞0Dr.Lin 于2026-10-02发布
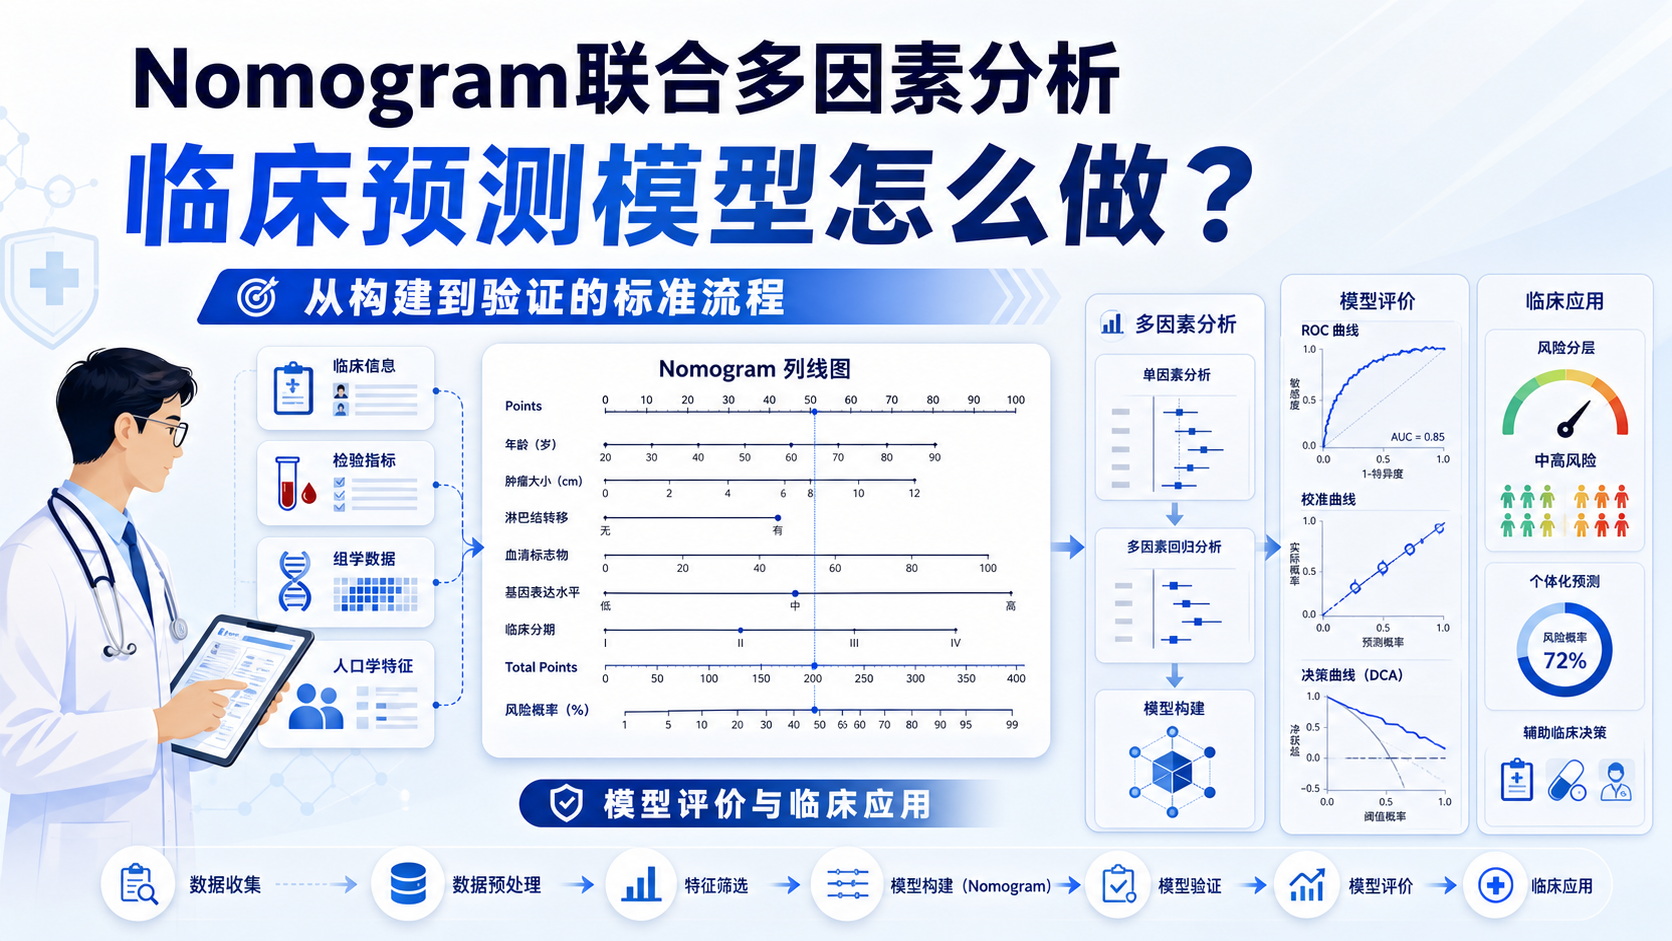 临床研究里,最常见的问题不是“有没有关联”,而是“能否真正用于决策”。单因素结果往往不稳,多因素模型虽更严谨,却不够直观。Nomogram把统计模型转成可读的风险评分图,帮助医生把复杂结果落到床旁判断。阅读57 · 点赞0Dr.Lin 于2026-10-02发布
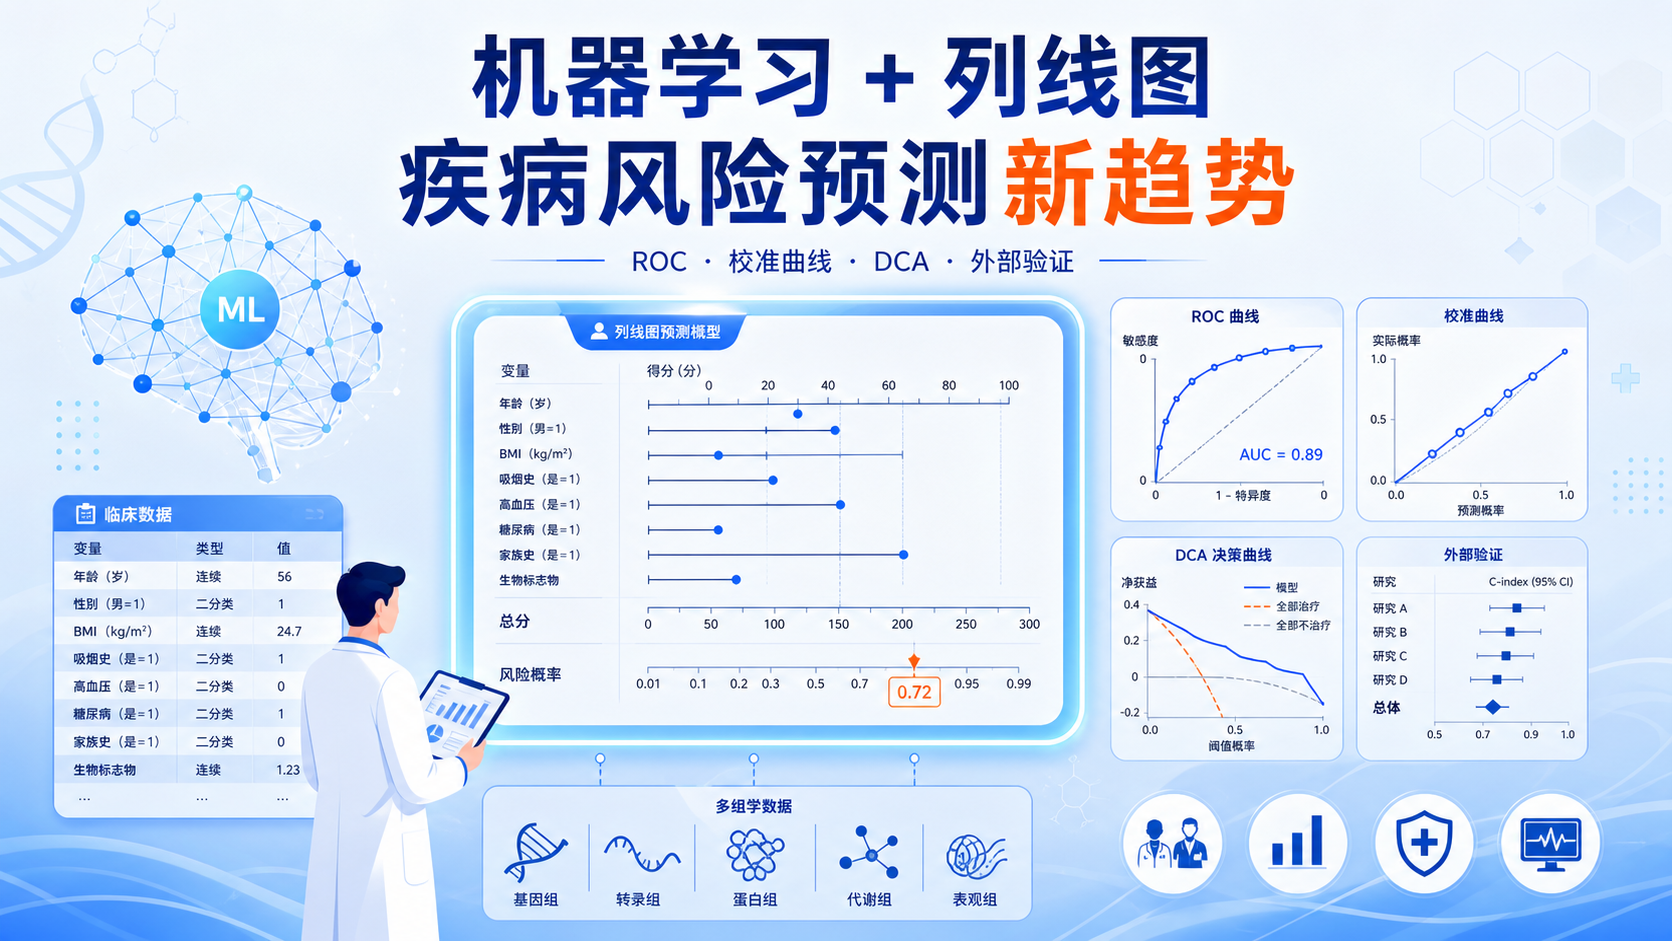 疾病风险预测正在从“单一统计模型”走向“机器学习加列线图”的组合范式。对医学生、医生和科研人员来说,难点不在于能否建模,而在于如何让模型既有区分度,又能被临床真正使用。阅读68 · 点赞0Dr.Lin 于2026-10-02发布
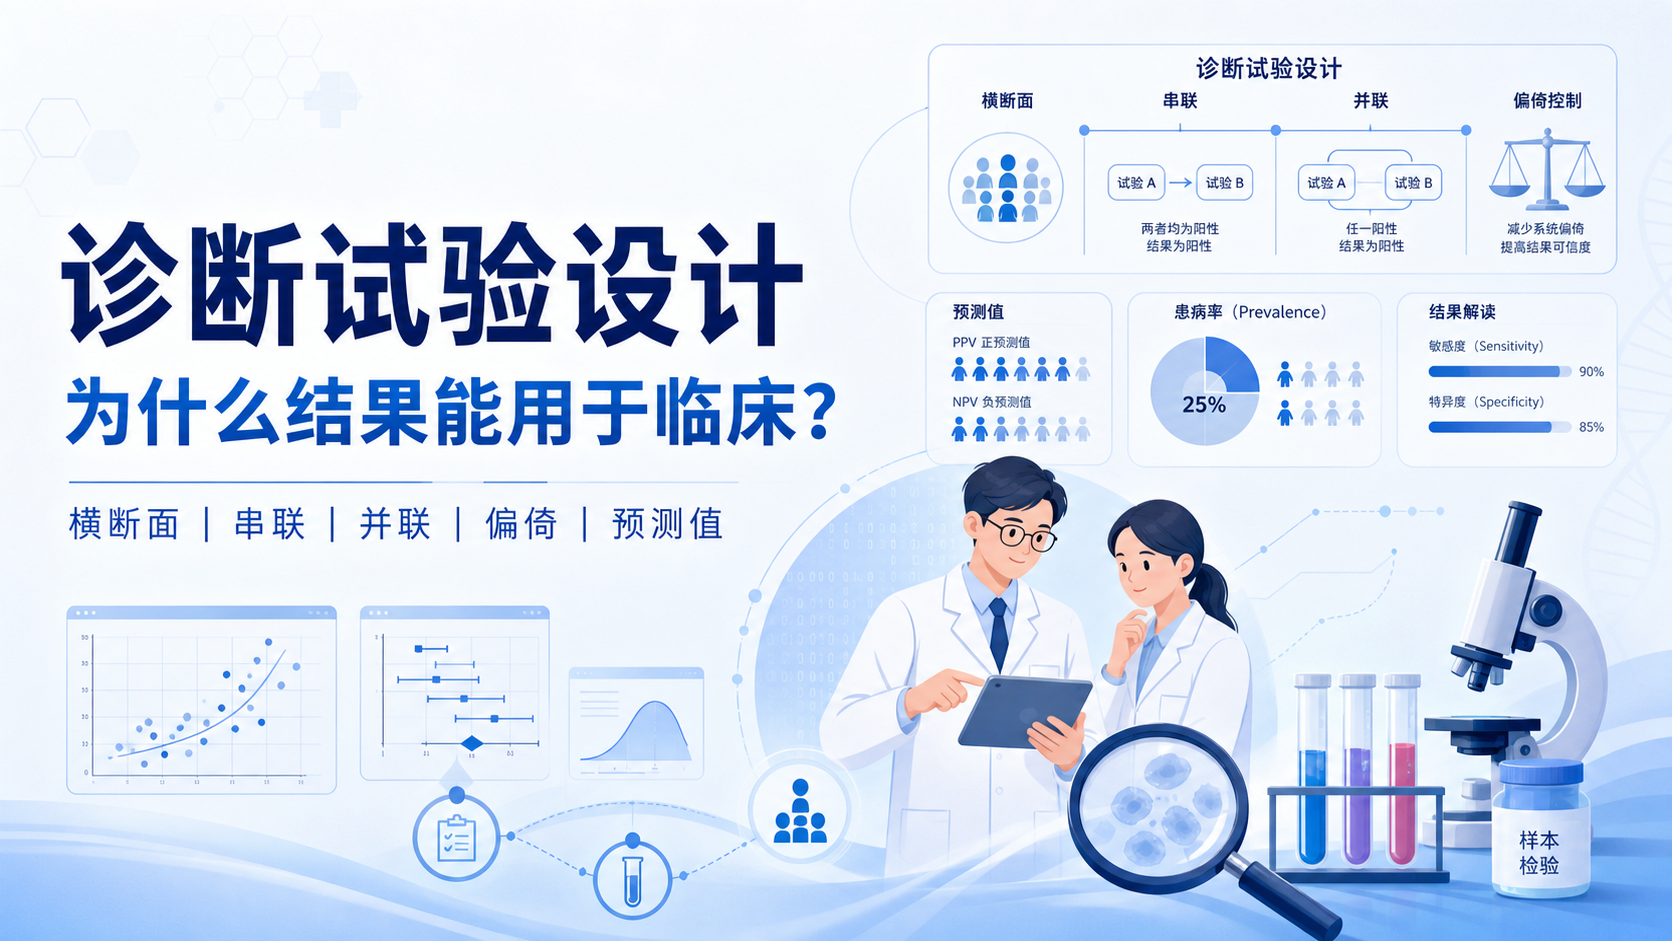 诊断试验做得好,能少漏诊,也能少误诊。但在真实临床里,设计不严谨、偏倚控制不到位、预测值理解错误,都会让结果失真,影响科研结论和患者预后。对医学生、医生和科研人员来说,真正重要的不只是“测出来”,而是“测得准、用得对”。阅读90 · 点赞0Dr.Chuang 于2026-10-01发布
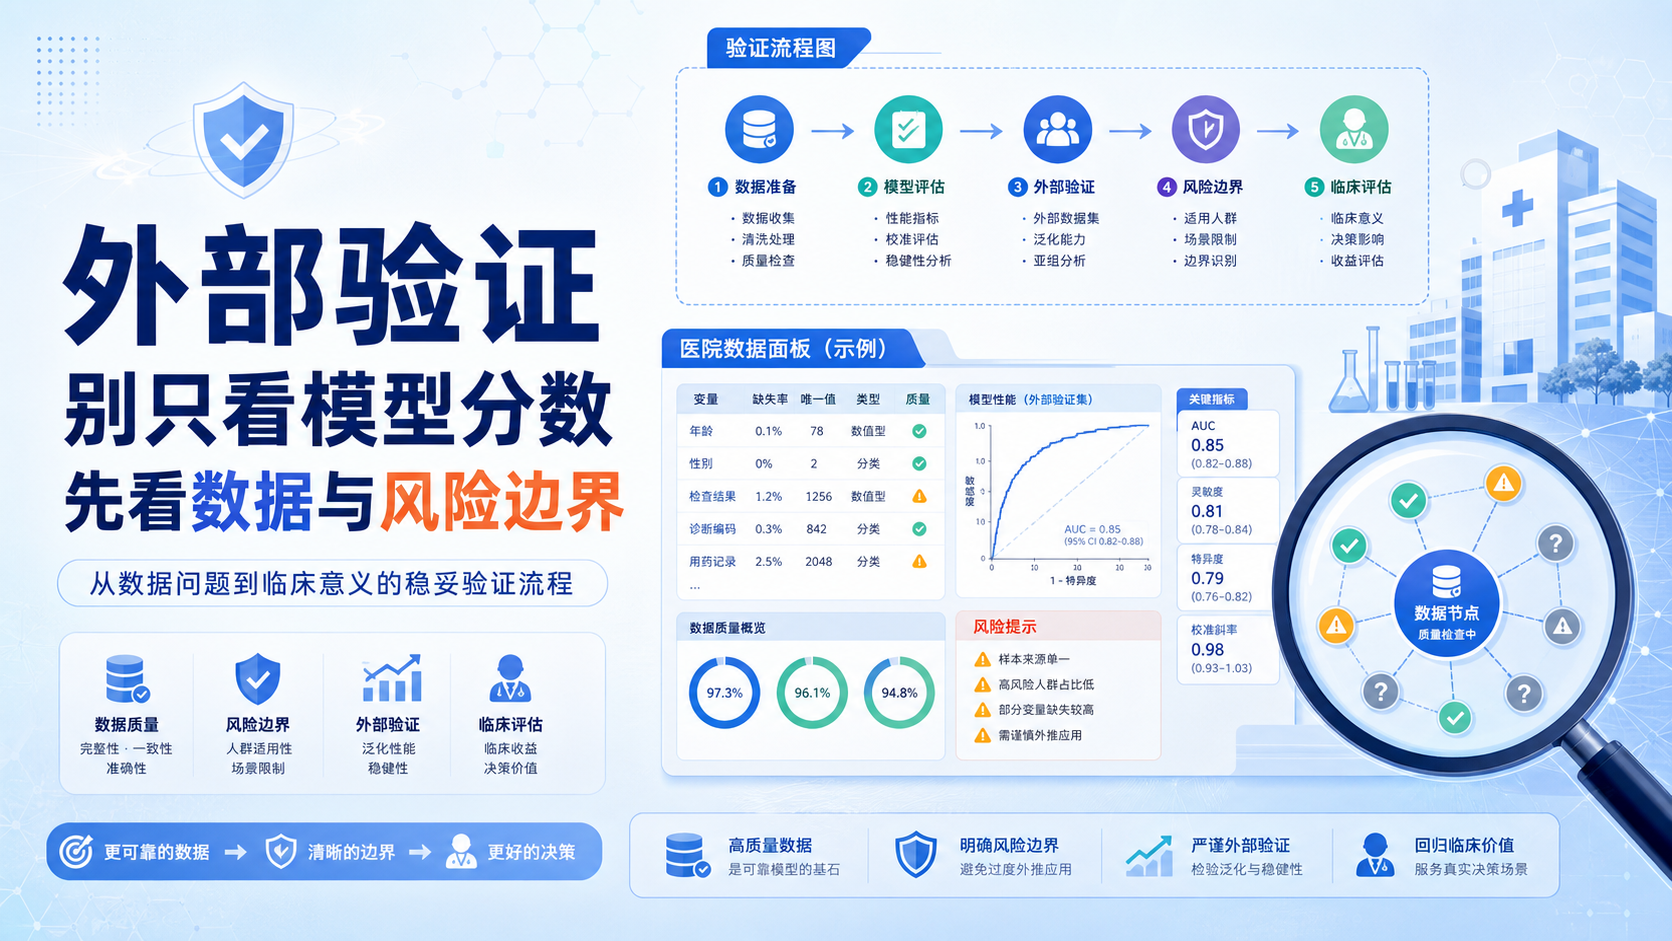
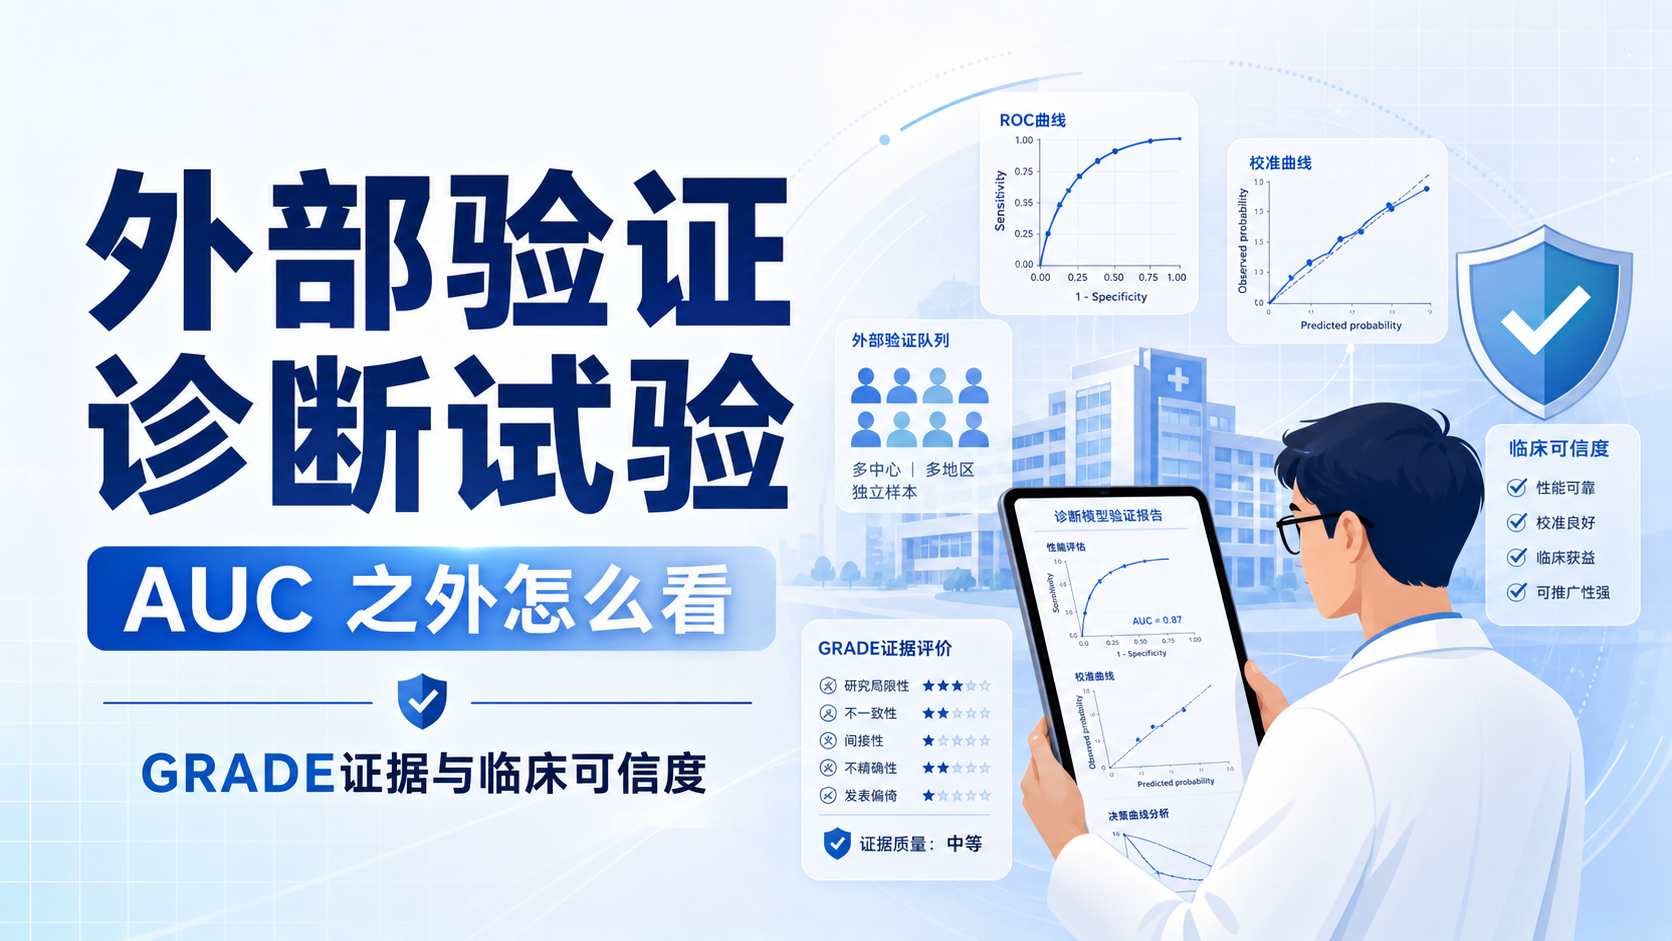 外部验证诊断试验,常卡在两个问题上。设计不规范,结果难比较。证据等级不清,临床难采信。对医学生、医生和科研人员来说,真正难的不是算出敏感度和特异度,而是判断这项试验能否推广到真实世界。阅读77 · 点赞0Dr.Chuang 于2026-10-01发布
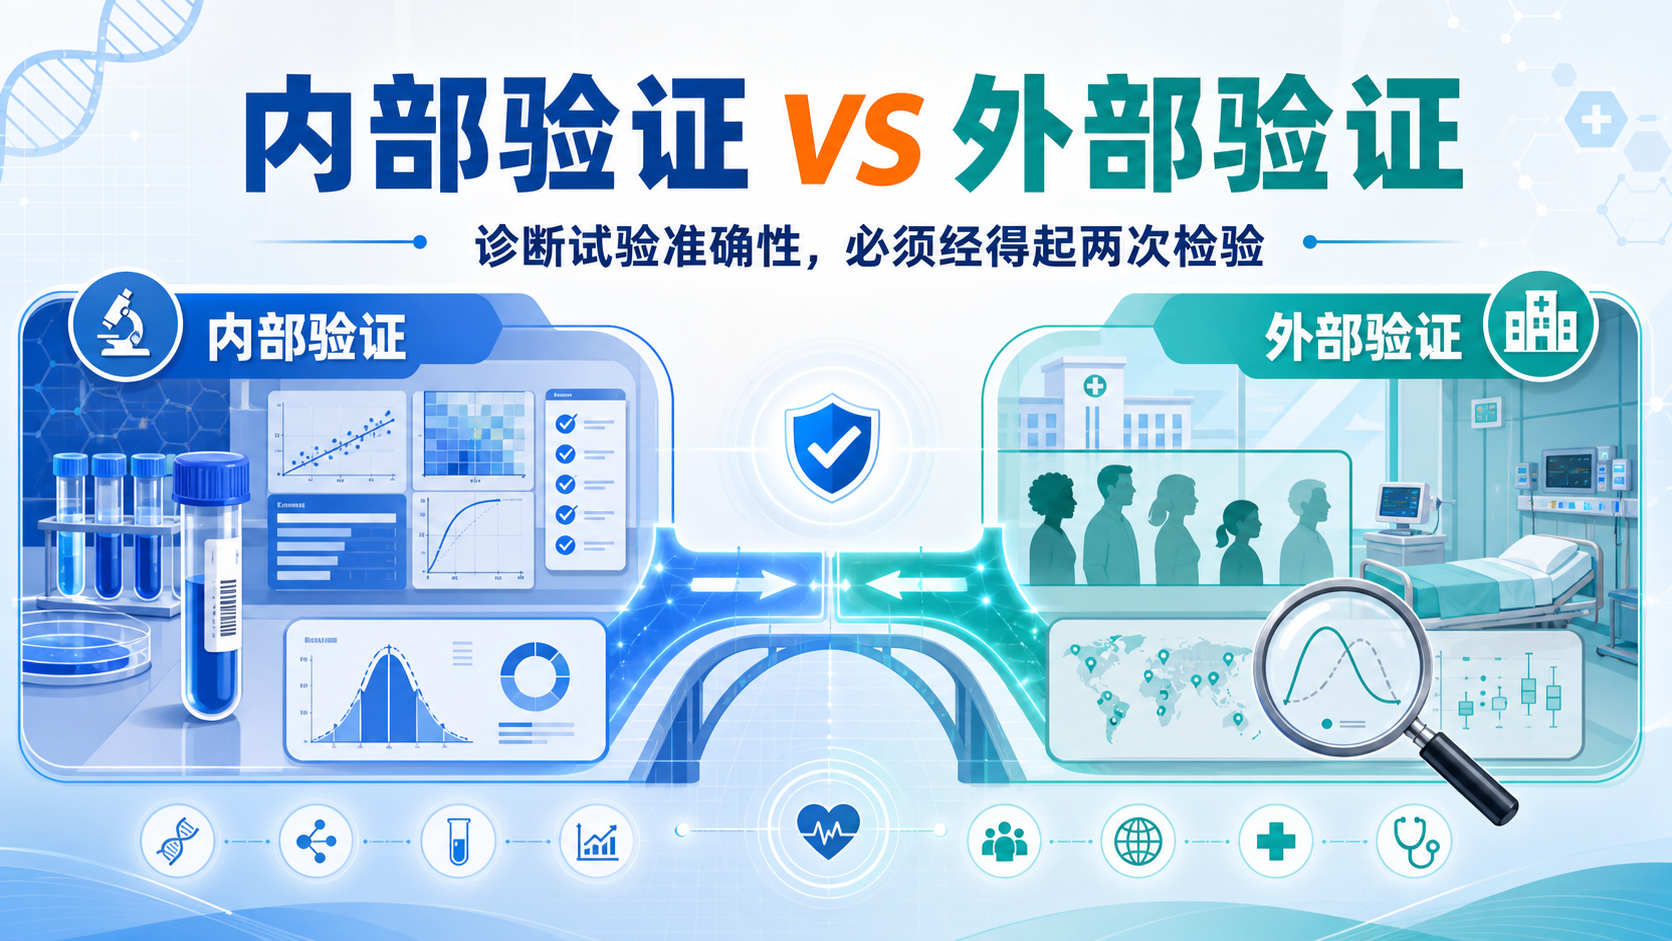 诊断试验做出来,不等于能直接用于临床。很多研究卡在同一个问题上。内部验证结果很好,外部一落地就失准。这不是方法本身无用,而是验证场景不同。阅读78 · 点赞0Dr.Chuang 于2026-10-01发布
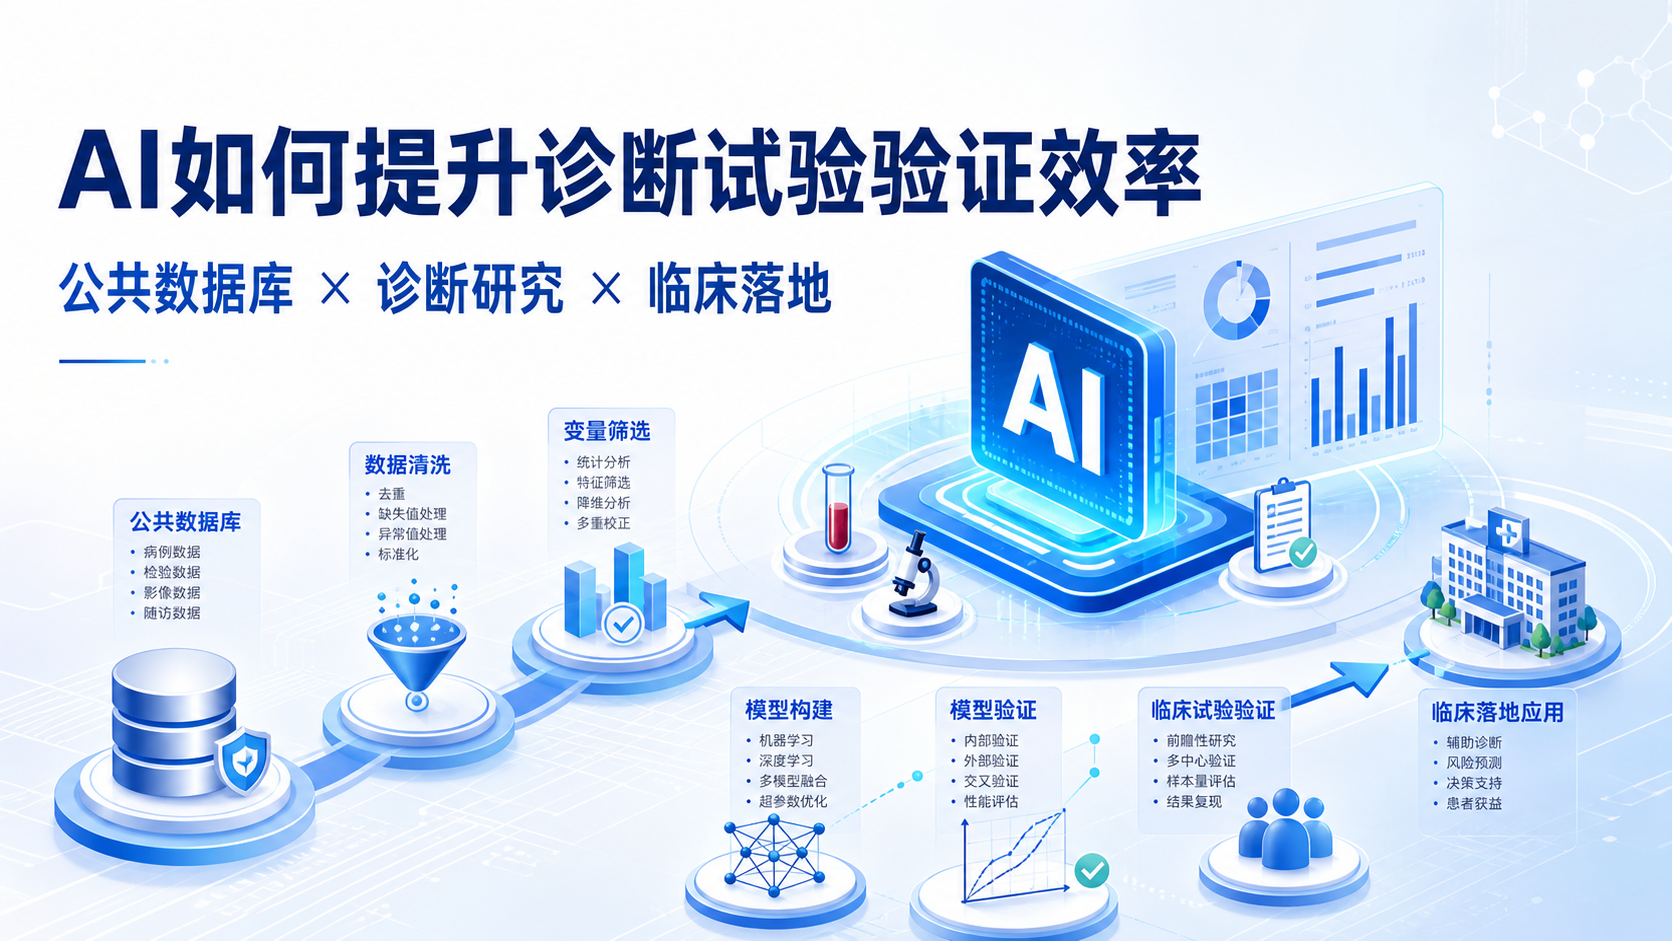
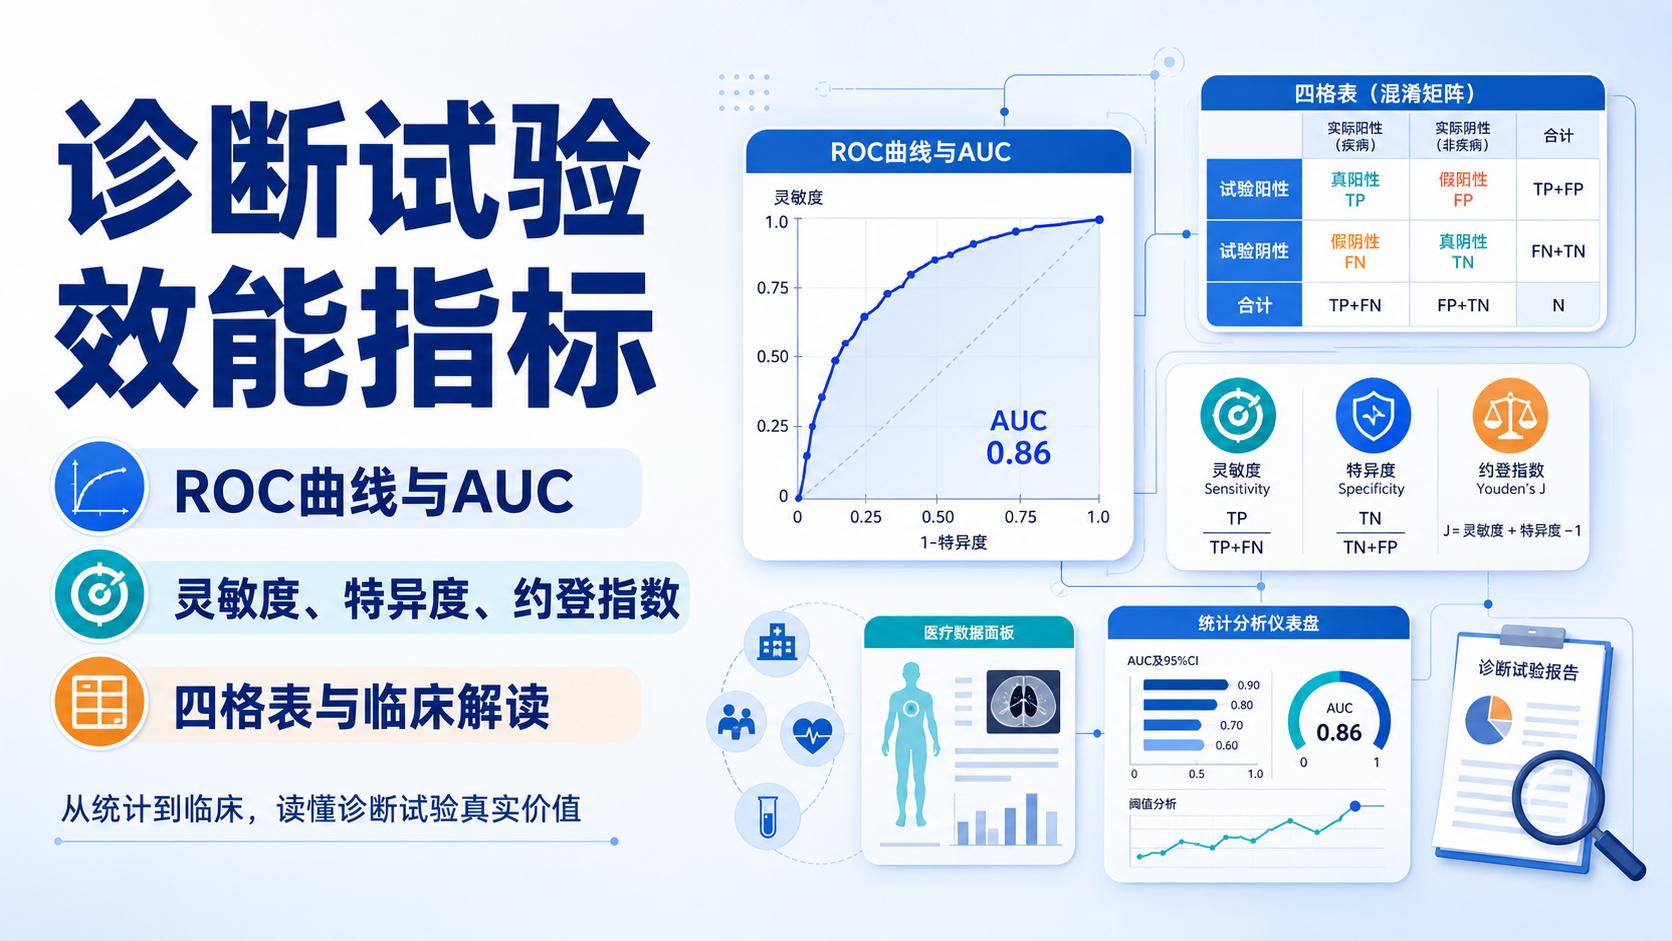 诊断试验看似简单,真正难点在于如何证明它“有用”。医学生、医生和科研人员常会遇到同样的问题:新方法到底能不能替代金标准,指标怎么选,结果怎么解读。如果效能指标选错,研究结论可能完全偏离临床价值。阅读95 · 点赞0Dr.Chuang 于2026-10-01发布
热门文章
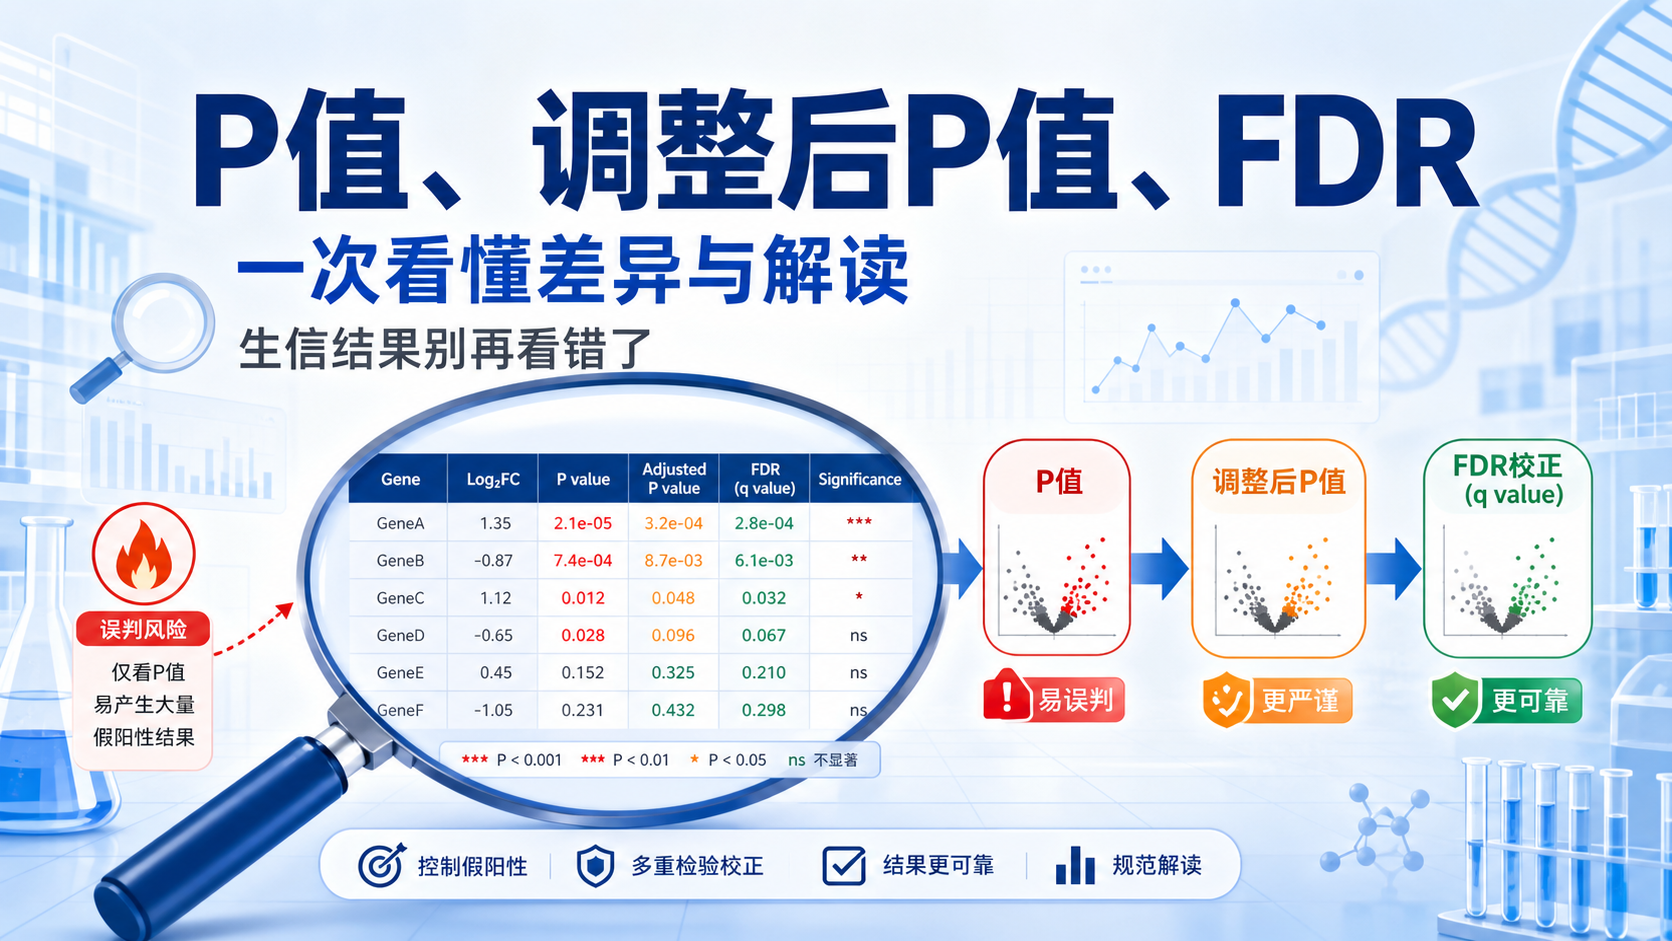
一文讲清P值、调整后P值与FDR校正的关系
阅读756 · 点赞0
TRIPOD声明发布指南:预测模型研究必读
阅读717 · 点赞1
Shapiro-Wilk 检验如何判断正态性?3步解析
阅读572 · 点赞0