117
 分享

引言Introduction
森林图是Meta分析里最常见的图表之一,但很多人真正卡住的,不是读效应量,而是判断结果是否“真的一致”。森林图异质性检验,核心就是回答:不同研究之间的差异,到底是随机波动,还是方法学或临床因素造成的真实不一致。 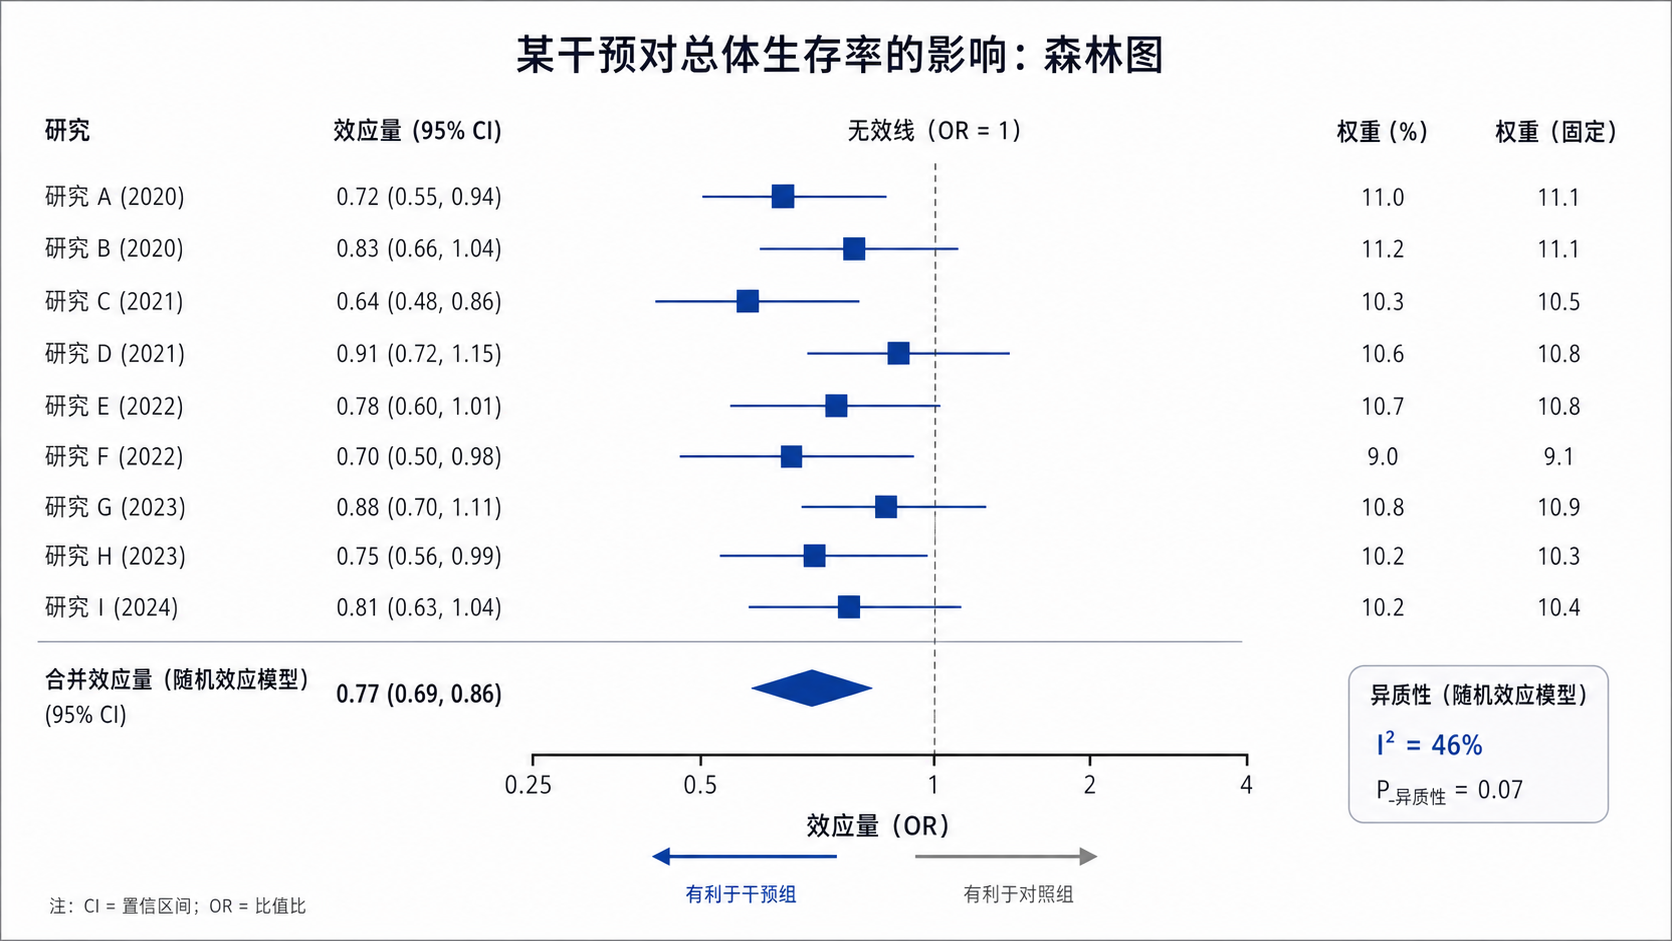
1. 森林图里到底看什么
1.1 中间参考线代表什么
森林图的中间参考线,通常表示无效值。
在比值类指标中,常见的是 1。
在均数差指标中,常见的是 0。
如果方块及其95%置信区间跨过参考线,通常提示差异无统计学意义。
但这只回答“有没有效应”,不直接回答“研究之间是否一致”。
1.2 方块、横线和权重
森林图中的小方块,代表单个研究的效应量。
方块越大,通常说明该研究权重越高。
横线代表95%置信区间。
横线越短,说明该研究估计越精确。
样本量大、标准误小的研究,往往置信区间更窄。
这也是为什么森林图能同时看见“效应大小”和“估计稳定性”。
1.3 先判断效应,再判断一致性
很多初学者会把“是否跨线”当成全部结论。
这不够。
Meta分析里,还要看研究间差异是否过大。
森林图异质性检验的目的,是判断不同研究的结果能否放在一起解释。
如果异质性很高,合并结果的可信度会下降。
这时需要进一步找原因,而不是只看总效应。
2. 异质性检验看哪些指标
2.1 I²是最常用指标
I²用于描述研究间差异中,有多少比例来自真实异质性,而非随机误差。
它是Meta分析里最常被引用的异质性指标。
一般经验判断如下。
- I² ≤ 50%,异质性较低或尚可接受。
- I² 50%至75%,提示中等偏高异质性。
- I² > 75%,提示异质性很高。
但要注意,I²不是绝对标准。
研究数量少时,I²会不稳定。
样本量很大时,轻微差异也可能导致I²升高。
2.2 卡方检验和p值怎么理解
异质性检验中,卡方检验也很常见,通常写作χ²或Q检验。
它检验的是:各研究效应量之间的差异,是否超出随机误差范围。
一般会同时给出p值。
如果p值较小,说明研究间差异可能并非偶然。
但卡方检验受研究数影响明显。
研究数量少时,卡方检验容易“检不出来”。
研究数量多时,又可能过于敏感。
所以实际解读时,通常要把χ²、p值和I²一起看。
2.3 只看一个指标会误判
异质性判断不能只盯着I²。
也不能只看p值。
更不能脱离临床背景机械下结论。
例如,两个研究I²相同。
但一个来自相同人群、相似干预,另一个来自不同国家、不同结局指标。
这两种情形的意义完全不同。
真正专业的做法,是把统计异质性和临床异质性一起判断。
3. 为什么会出现异质性
3.1 临床因素最常见
异质性常来自研究对象和干预方式不同。
比如年龄结构不同,疾病分期不同,治疗剂量不同,随访时间不同。
这些都会影响最终效应。
常见来源包括。
- 入组标准不一致。
- 干预方案不同。
- 对照组设置不同。
- 结局指标定义不同。
- 随访时长不同。
如果这些核心条件不统一,森林图再“整齐”,合并结果也可能不稳。
3.2 方法学差异也很重要
除了临床差异,研究设计差异也会制造异质性。
如随机化方法、盲法、失访率、结局测量工具不同。
这些都会影响偏倚水平。
在RCT meta分析里,方法学质量差异尤其关键。
低质量研究可能夸大效应。
高质量研究则更接近真实结果。
3.3 统计学处理方式会影响结果
同一组数据,采用固定效应模型和随机效应模型,结果可能不同。
尤其在异质性较高时,模型选择会明显影响合并效应。
固定效应模型默认各研究共享同一个真实效应。
随机效应模型则允许真实效应在研究间波动。
当I²偏高时,通常更要谨慎考虑随机效应模型。
4. 看到高I²后该怎么做
4.1 先确认数据和分层是否合理
不要一看到高I²就急着下结论。
先检查纳入研究是否混杂了不同人群、不同结局、不同干预强度。
建议按以下顺序排查。
- 检查是否把不相似的研究合并了。
- 核对结局指标方向是否统一。
- 确认效应量类型是否一致。
- 查看是否存在明显离群研究。
很多“高异质性”,其实来自研究分组不严谨。
4.2 做亚组分析
亚组分析是处理异质性的常见方法。
可以按年龄、地区、干预方案、疾病分层、随访时间等变量分组。
如果分层后I²明显下降,说明异质性的来源可能找到了。
这比直接汇总总结果更有解释力。
但亚组分析要避免过度切分。
变量太多,会增加假阳性风险。
所以亚组设置应有明确临床依据,而不是事后“试出来”。
4.3 做敏感性分析
敏感性分析的目的,是看结论稳不稳。
常见做法是逐一剔除单篇研究。
如果剔除某篇后,结果和I²变化很大,就要重点关注它。
敏感性分析能帮助判断,是否有某项研究强烈驱动总体结论。
这对科研写作和答辩非常重要。
它能提升结论可信度,也能避免过度解读。
5. 森林图异质性检验在论文里怎么写
5.1 结果部分怎么表达
写作时,不要只写“存在异质性”。
要把具体数值写清楚。
例如可以写成。
“合并分析显示,研究间存在中度异质性,I²=62%,χ²检验p<0.10,因此采用随机效应模型进行合并。”
这样的写法更规范。
也更符合审稿人习惯。
因为它同时交代了判断依据和模型选择。
5.2 讨论部分怎么解释
讨论异质性时,要区分“统计学解释”和“临床解释”。
统计上高I²,不等于结果一定不能用。
但它意味着合并结论需要更谨慎。
可以从以下角度写。
- 研究对象是否一致。
- 干预方案是否统一。
- 结局指标是否标准化。
- 研究质量是否存在差别。
有解释力的异质性分析,比单纯报数值更有学术价值。
5.3 常见写作错误
很多文章只贴一张森林图,就结束了。
这不够。
至少应说明以下几点。
- 是否存在异质性。
- 用了什么检验指标。
- 为什么选择固定效应或随机效应模型。
- 是否做了亚组或敏感性分析。
如果这些信息缺失,文章的完整性会明显下降。
也不利于读者判断结果可信度。
6. 发表偏倚和异质性不是一回事
6.1 漏斗图看的是什么
发表偏倚通常通过漏斗图判断。
它关注的是研究结果是否对称分布。
若小样本研究集中在一侧,可能提示发表偏倚。
发表偏倚和异质性是两个概念。
异质性是研究间结果不一致。
发表偏倚是研究发表和纳入过程可能存在选择性。
6.2 两者可以同时存在
有时I²很高,漏斗图也不对称。
也有时I²不高,但仍可能存在发表偏倚。
因此不能用一个指标代替另一个指标。
Meta分析里常规流程应包括。
- 森林图异质性检验。
- 漏斗图或相关检验。
- 敏感性分析。
- 必要时的亚组分析。
这样得到的结论才更完整。
7. 医学生和科研人员最该掌握的判断框架
7.1 三步读懂森林图
你可以按这三步走。
- 看效应方向,是否支持研究假设。
- 看置信区间,是否跨无效线。
- 看异质性,结果能否稳定合并。
只要这三步不漏,森林图就不会看错大方向。
7.2 一个实用判断口诀
可以记住这个顺序。
- 先看效应量。
- 再看置信区间。
- 后看I²和χ²。
- 最后决定模型和解释方式。
这套逻辑适用于大多数Meta分析。
对论文阅读、开题、答辩和投稿都很实用。
7.3 工具只是手段,规范才是核心
无论你用RevMan、Stata还是R,逻辑都一样。
软件只能帮你算数。
真正决定结论质量的,是数据选择和解释方式。
如果你在整理文献、绘制森林图、判断异质性时需要更高效的流程支持,可以借助解螺旋 的科研写作与分析服务,帮助你更快完成规范化Meta分析结果整理,减少重复试错。
总结Conclusion
森林图异质性检验的关键,不只是看一张图是否“跨线”,而是判断研究之间是否真正可合并。I²、χ²和p值要联合解读,临床差异、方法学差异和统计模型也要一起考虑。 对医学生、医生和科研人员来说,掌握这套判断框架,才能把Meta分析结果读准、写对、讲清楚。若你希望更高效地完成规范分析和论文输出,可以进一步了解** 解螺旋**,把复杂的异质性判断变成可执行的科研流程。
- 引言Introduction
- 1. 森林图里到底看什么
- 2. 异质性检验看哪些指标
- 3. 为什么会出现异质性
- 4. 看到高I²后该怎么做
- 5. 森林图异质性检验在论文里怎么写
- 6. 发表偏倚和异质性不是一回事
- 7. 医学生和科研人员最该掌握的判断框架
- 总结Conclusion