71
 分享
引言Introduction
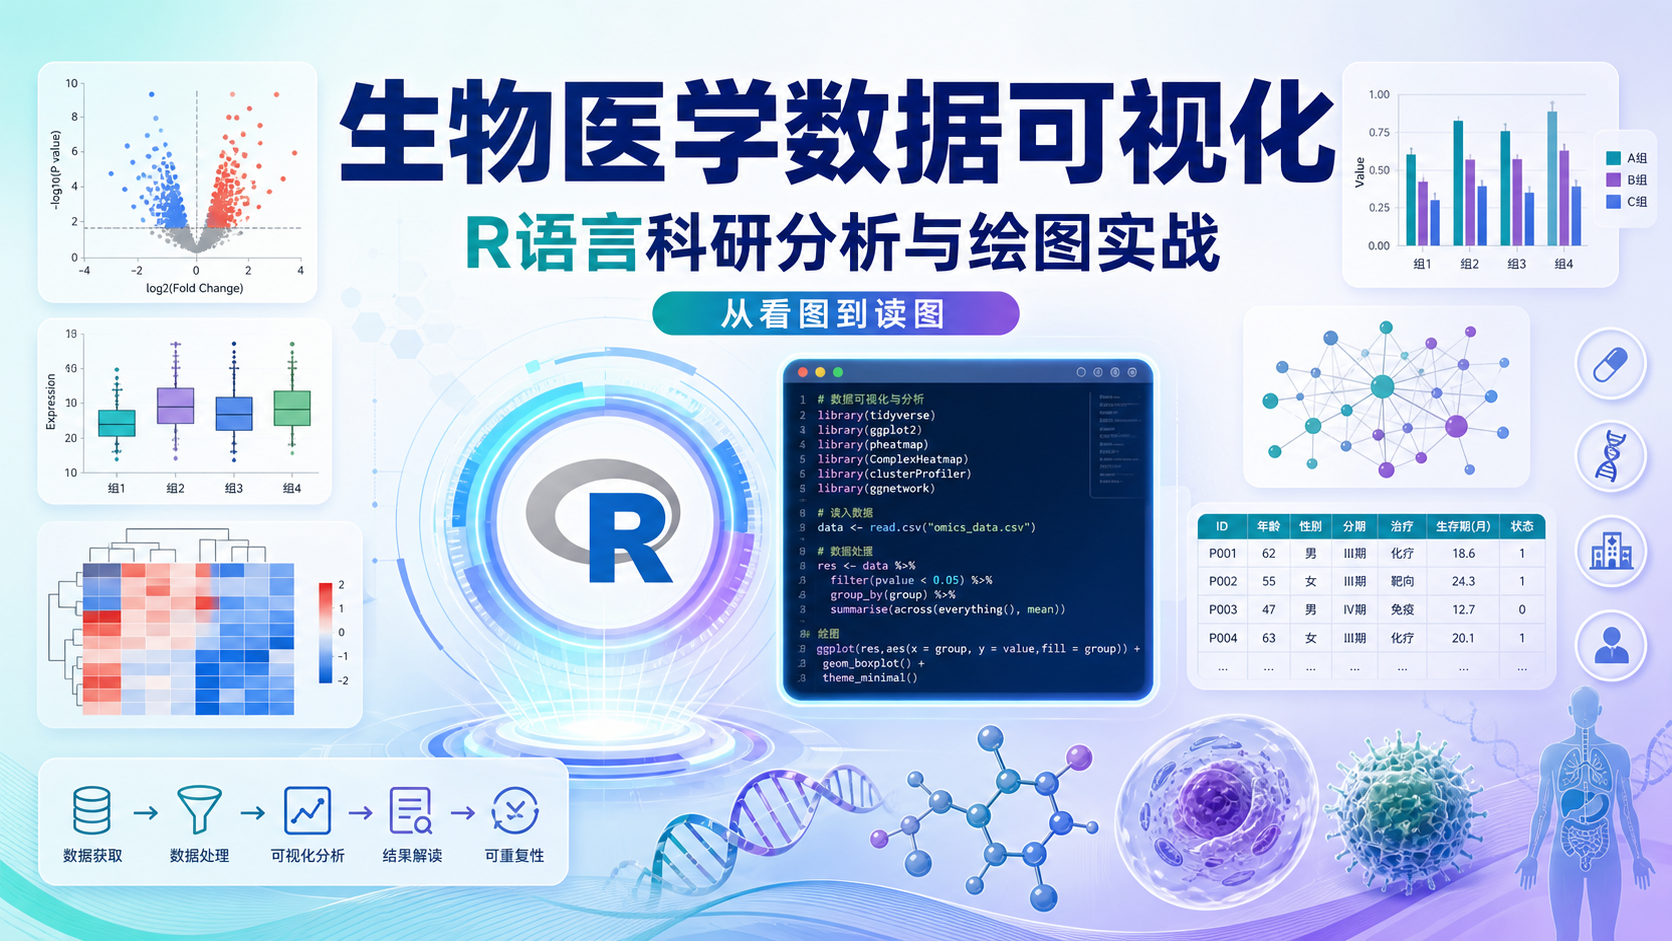
生物医学数据越来越复杂,单靠表格很难看出规律。医学生、医生和科研人员常面临同样的问题,数据很多,结论却不清晰。R语言的数据可视化,正在把“看不懂的数据”变成“可解释的证据” 。它不仅能呈现差异,还能帮助发现异常、分层和模型问题。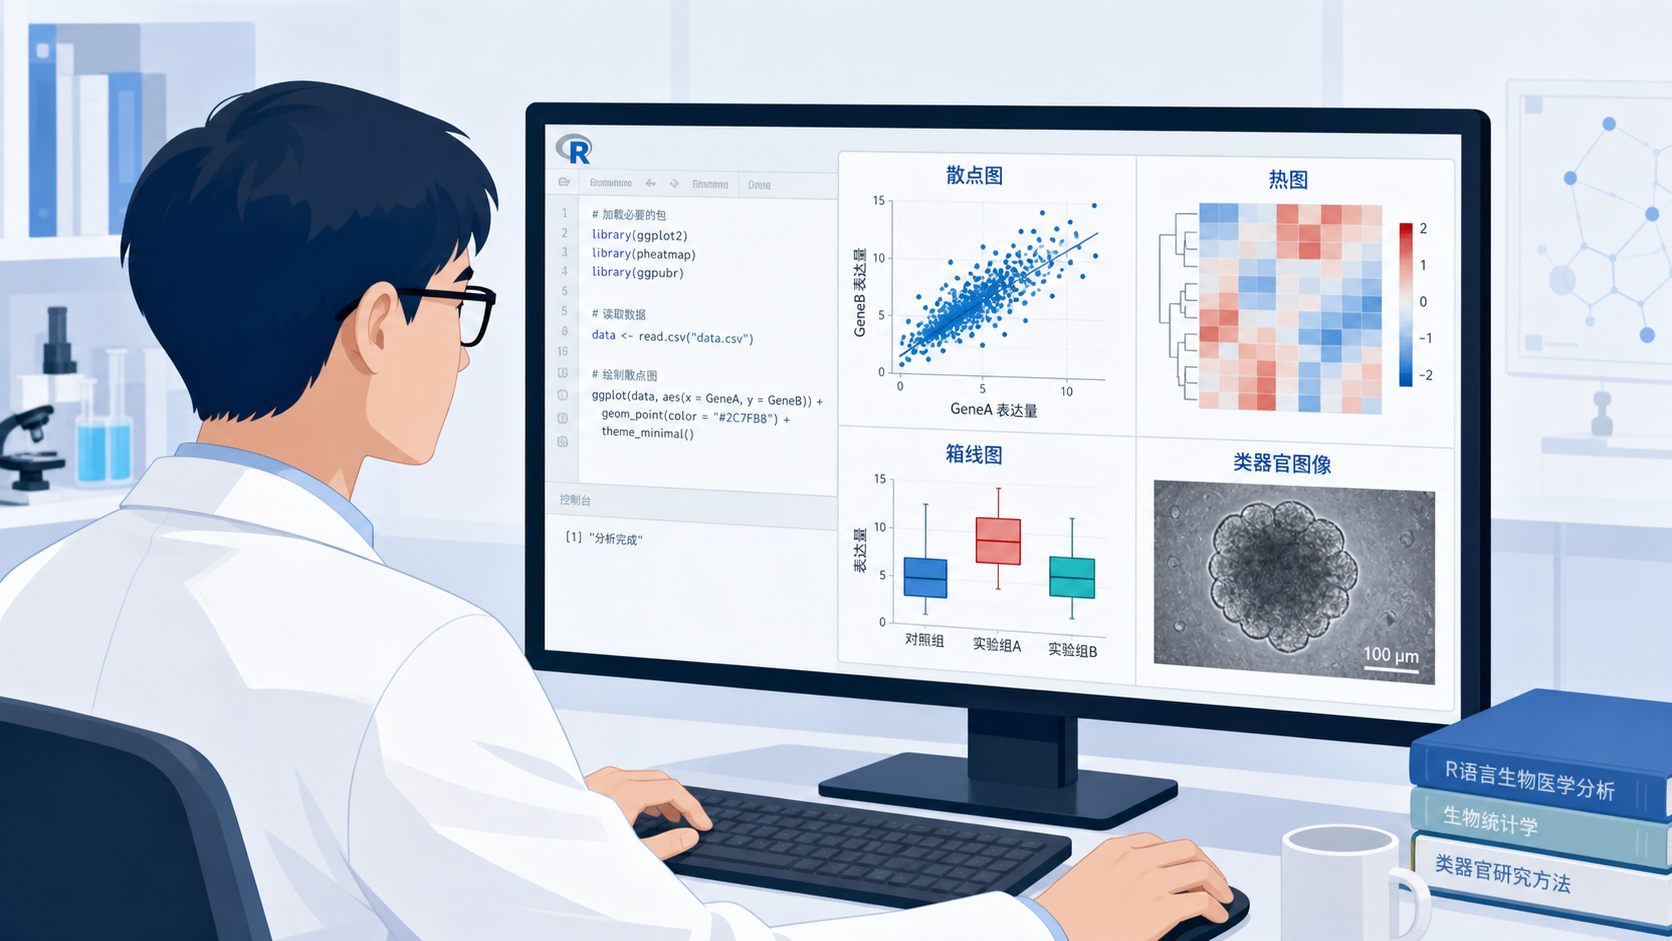
1. 为什么生物医学更需要可视化
1.1 数据复杂度已超过人工阅读能力
生物医学研究常见的数据类型很多,包括表型、基因组、转录组、蛋白质组、DNA甲基化和临床变量。单纯看原始数值,很难快速判断模式。尤其在精准医学场景中,研究目标不只是“有没有差异”,而是要回答“差异在哪里”“是否能分型”“是否与临床结局相关”。
可视化的价值,在于把多维数据压缩成可解释的结构。
例如,同样是一组患者数据,表格只能展示数值,图形却可以同时展示分布、离群点、组间差异和相关性。对于高维数据,这种信息密度优势非常明显。
1.2 从描述现象到发现机制
生物医学研究不只追求展示结果,还要支持机制分析。以神经精神疾病研究为例,研究者会收集患者细胞,进一步分析基因组、转录组、蛋白质组和表观遗传标记,再结合临床特征做深度表型分析。此时,可视化不只是“展示”,而是帮助建立变量之间的联系。
好的图形可以直接提示研究假设。
比如:
- 某个分组是否存在明显聚类。
- 某个指标是否与疾病严重程度同步变化。
- 某些样本是否是离群点或高杠杆点。
- 多个组学层面是否呈现一致趋势。
这类线索,往往决定后续统计分析是否有方向。
2. R语言为何成为科研数据可视化主力工具
2.1 兼顾统计分析和图形输出
R语言的优势,不只是“能画图”。它把数据处理、统计建模和可视化放在同一工作流中。对于科研人员来说,这意味着可以在同一环境中完成导入、清洗、分析、建模和制图,减少重复搬运数据的误差。
R语言特别适合科研数据可视化,因为它天然支持统计思维。
例如,回归诊断中可以直接检查残差分布、正态性、同方差性和异常点。课程材料中提到,使用诊断图后,点更接近参考线,U型趋势减弱,但仍可能存在强影响点。这个过程说明,图形不仅用于汇报,也用于检验模型是否可靠。
2.2 适合处理标准化与可重复研究
科研图形不是一次性展示,而是可重复、可审计的分析结果。R语言基于脚本化操作,便于记录每一步处理过程。对生物医学研究而言,这一点很重要,因为同一批数据可能要经历多轮修改、复核和再分析。
常见优势包括:
- 代码可追踪,便于复现。
- 图形生成过程可标准化。
- 便于批量处理多组样本。
- 方便与统计模型联动。
对于需要发表论文、做课题汇报或进行多中心协作的团队,R语言更容易形成统一规范。
3. 生物医学中常见的R可视化场景
3.1 类别数据与临床分组比较
在临床研究中,类别数据非常常见,例如治疗组和安慰剂组、男性和女性、不同分期、不同反应类型等。VCD等工具可将这类数据以图形方式展示,帮助快速比较组间结构。
课程中的关节炎数据是典型例子。84条记录中,治疗组和安慰剂组的改善情况可以通过图形一眼看出。相比逐行读表,图形更容易揭示“治疗后显著改善更多”这类结论。
这类可视化适用于:
- 治疗反应分层。
- 队列基本特征比较。
- 生存结局分组展示。
- 多分类临床结局分析。
3.2 连续变量的分布和离群点识别
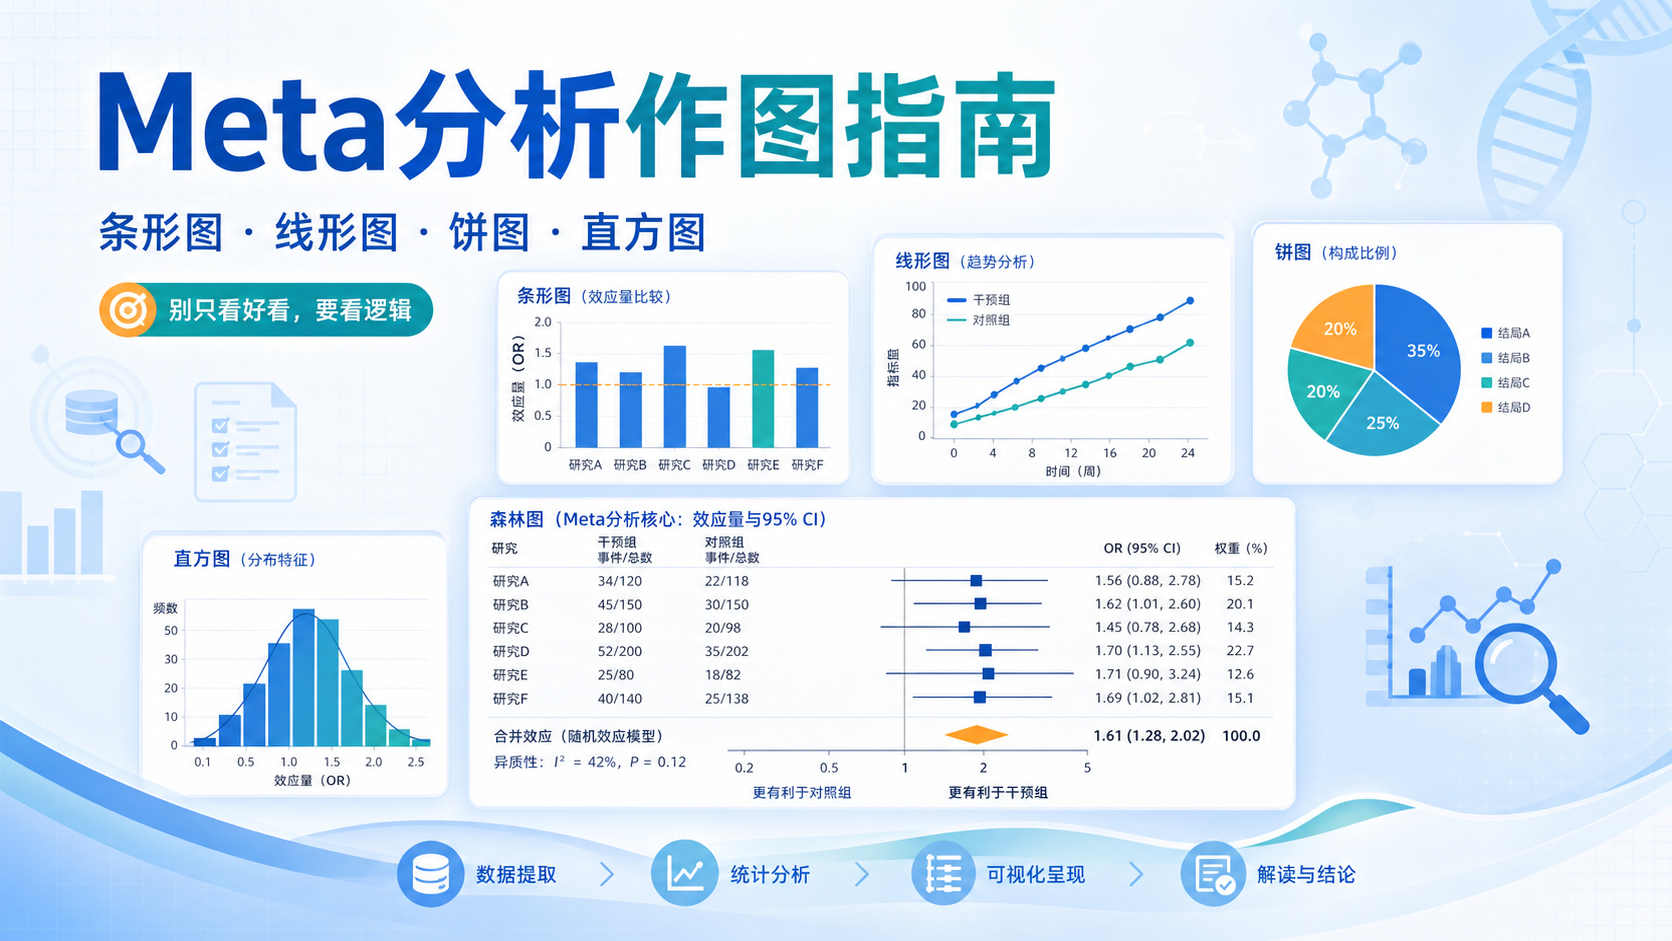
箱线图、直方图、密度图、QQ图,是生物医学中最常用的基础图形。它们适合观察连续变量是否偏态、是否存在异常值、是否满足模型假设。
在回归分析中,诊断图很关键。课程材料提到,拟合后应关注:
- 残差是否接近正态分布。
- 是否存在U型趋势。
- 是否存在强影响点。
- 是否需要变量变换或删去异常点。
对科研人员来说,图不是结果的装饰,而是模型可靠性的证据。
如果忽略离群点和高杠杆值,参数估计可能被明显拉偏,最终影响结论。
3.3 高维组学数据的模式识别
组学数据常常维度高、样本相对少。此时,热图、聚类图、PCA散点图等方法非常重要。它们可以帮助研究者先看结构,再做统计检验。
在实际研究中,常见问题包括:
- 样本是否按疾病状态分群。
- 某些基因是否共同上调或下调。
- 数据批次效应是否明显。
- 是否存在异常样本影响整体趋势。
对高维数据先可视化,再建模,往往比直接建模更稳妥。
4. 前沿应用正在从“看图”走向“读图”
4.1 深度表型分析推动疾病分型
现代生物医学研究越来越强调深度表型分析。它不仅看临床诊断名,还综合分子信息、细胞模型和数据库证据,尝试重新定义疾病分类。
例如,研究者把皮肤细胞诱导为干细胞,再进一步分化成神经元或类器官,用于研究神经系统疾病。这种人类细胞模型比部分动物模型更接近真实疾病状态。
在这个过程中,可视化承担两个任务:
- 呈现表型差异。
- 对照分子特征与临床标签。
这使得“分型”不再只依赖经验,而更接近数据驱动。
4.2 联合多组学数据支持精准医学
精准医学需要把表型分析和基础分析结合起来。单一数据源往往不足以支撑临床决策,只有把多组学和临床信息放在一起,才更容易识别稳定模式。
R语言的优势在于能把多个数据层整合到同一分析框架中。
例如:
- 基因表达与临床分组比较。
- 甲基化模式与药物响应关联。
- 蛋白表达与病程阶段对应。
- 多变量回归图形化诊断模型质量。
这类分析最终服务于两个目标。一个是发现新亚型。另一个是优化治疗路径。
5. 科研数据可视化的实用方法
5.1 先明确问题,再选图
很多图形问题,不是技术问题,而是研究问题没定义清楚。选择图之前,先回答三个问题:
- 你要比较的是分布、相关性,还是分组差异。
- 你的变量是连续型、类别型,还是混合型。
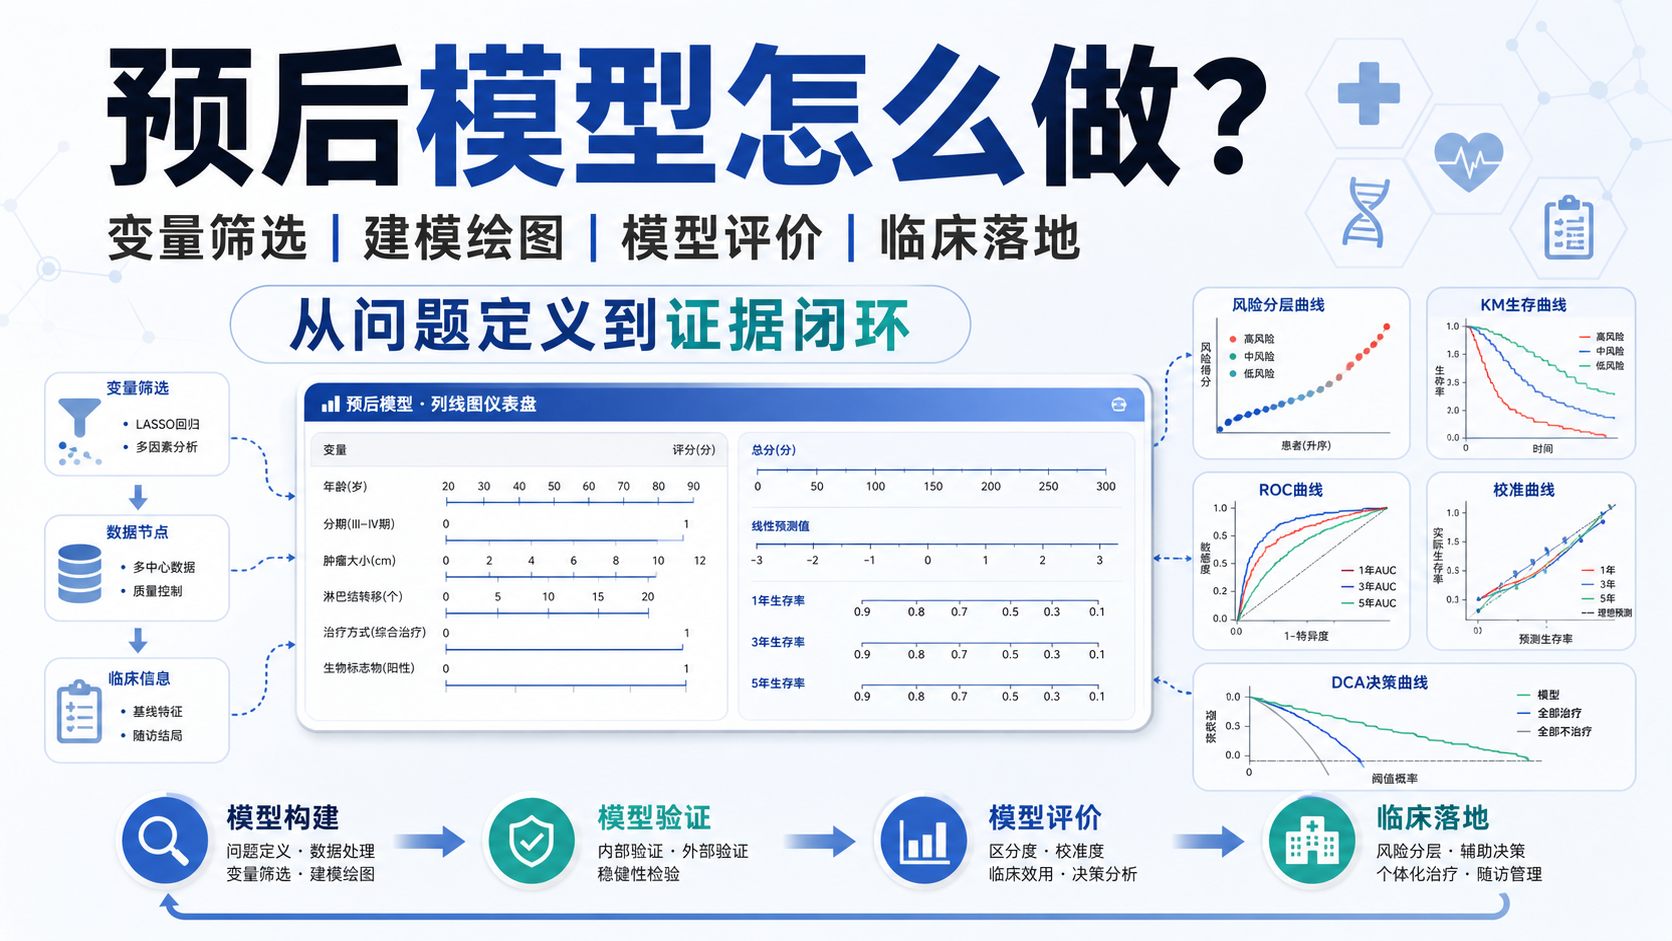
- 你的目标是描述、诊断,还是预测。
图形类型应服务于研究问题,而不是反过来。
常用对应关系可以简单理解为:
- 类别比较,适合条形图、马赛克图。
- 分布比较,适合箱线图、密度图。
- 相关关系,适合散点图、回归图。
- 多变量模式,适合热图、PCA图、聚类图。
5.2 统一风格,提升论文与汇报质量
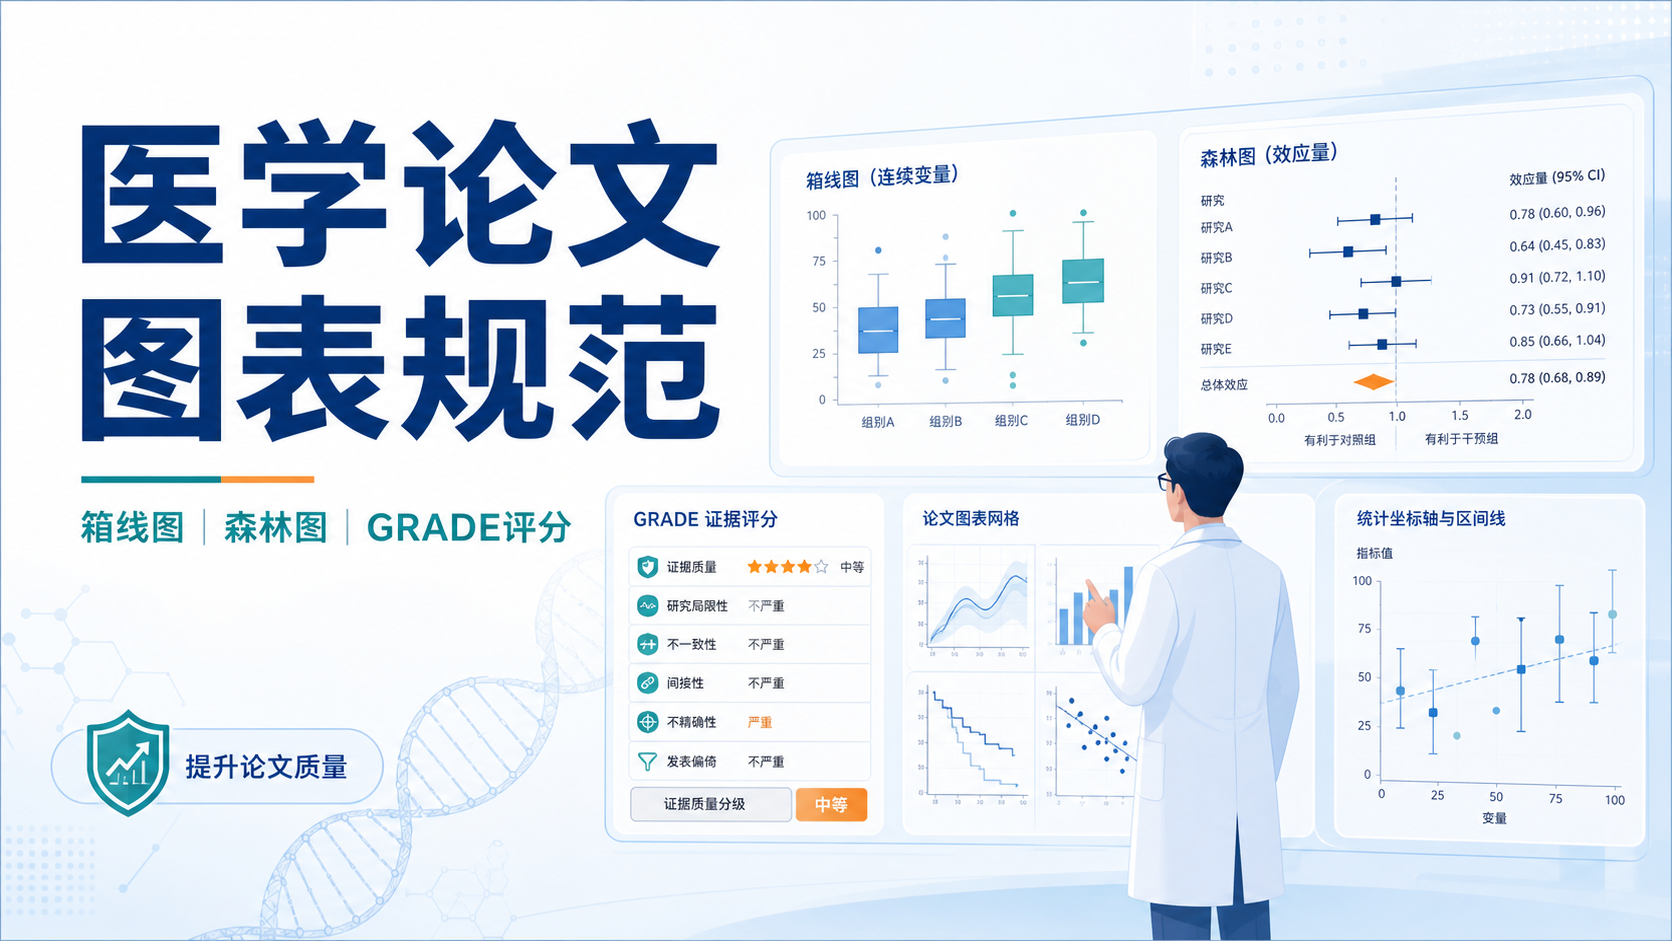
生物医学图形不仅要准确,还要规范。图例、坐标轴、分组颜色和统计标注都要清晰。对于论文投稿和答辩汇报,这些细节会直接影响专业感。
建议重点检查:
- 颜色是否区分清楚。
- 坐标轴是否有完整单位。
- 图注是否足够说明数据来源。
- 是否标注样本量。
- 是否保留统计方法说明。
一张合格的科研图,应该让审稿人不需要猜。
6. 从基础分析到可重复科研流程
6.1 诊断模型比单纯作图更重要
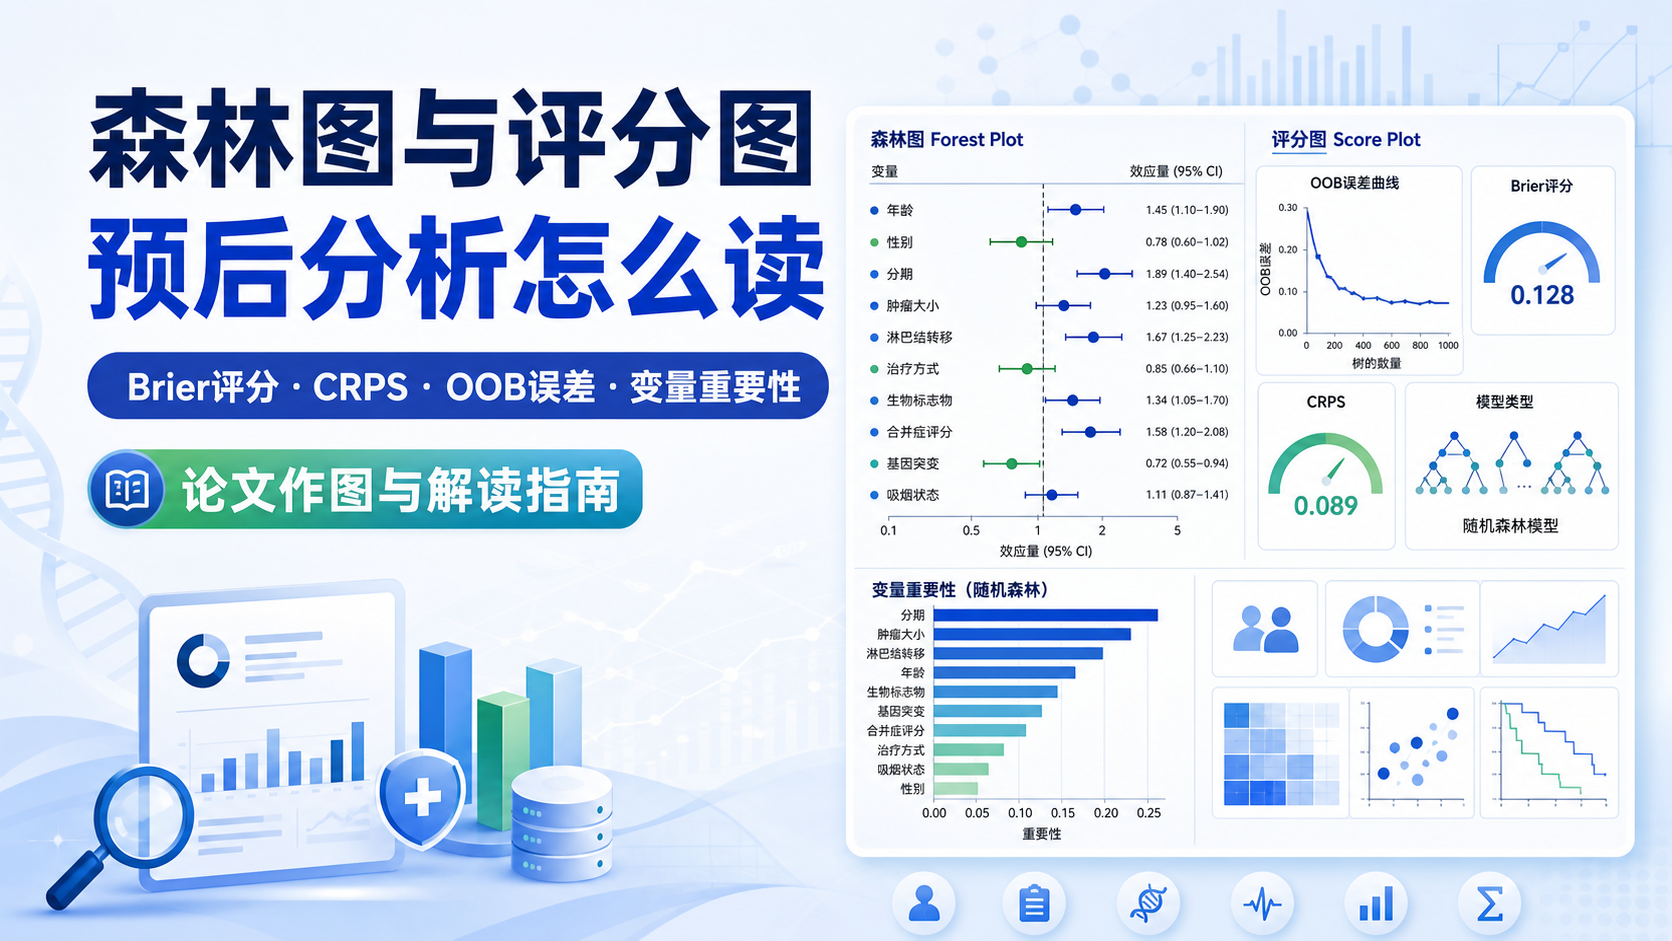
很多研究者会把重点放在“画得好不好看”,但在科研语境里,更重要的是图是否支持结论。回归图、QQ图、残差图、影响点图,都是检验模型的工具。
课程材料中提到,标准诊断方法有局限,可以结合car包、gvlma包等工具进一步检查正态性、误差独立性、离群点和高杠杆值。这说明,现代科研可视化已经不是单一出图,而是“图形诊断+统计检验”的组合。
6.2 用脚本化工作流提高稳定性
R语言中,工作空间、包管理、路径设置和注释等基础操作,都直接影响分析可重复性。对于真实科研项目,规范流程包括:
- 明确工作目录。
- 记录每一步数据处理。
- 使用注释解释代码意图。
- 安装并调用对应包。
- 保留关键输出图和结果。
这些看似基础,却决定后续协作是否顺畅。科研数据可视化的价值,最终体现在可重复、可解释、可追溯。
总结Conclusion
基于R语言的数据可视化,已经不只是“画图工具”,而是生物医学研究的重要分析环节。它能帮助研究者识别分组差异、发现异常样本、检查模型假设,并支撑多组学整合和精准医学分型。对于医学生、医生和科研人员来说,真正有价值的图,不是最炫的图,而是能回答问题、能支持结论、能被复现的图 。
如果你正在做生物医学科研,想把复杂数据整理成更清晰、更适合发表和汇报的图形,可以关注【解螺旋】。它能帮助你更高效地理解数据可视化思路,把科研数据可视化做得更规范,也更接近论文和课题真实需求。
- 引言Introduction
- 1. 为什么生物医学更需要可视化
- 2. R语言为何成为科研数据可视化主力工具
- 3. 生物医学中常见的R可视化场景
- 4. 前沿应用正在从“看图”走向“读图”
- 5. 科研数据可视化的实用方法
- 6. 从基础分析到可重复科研流程
- 总结Conclusion