8
 分享
引言Introduction
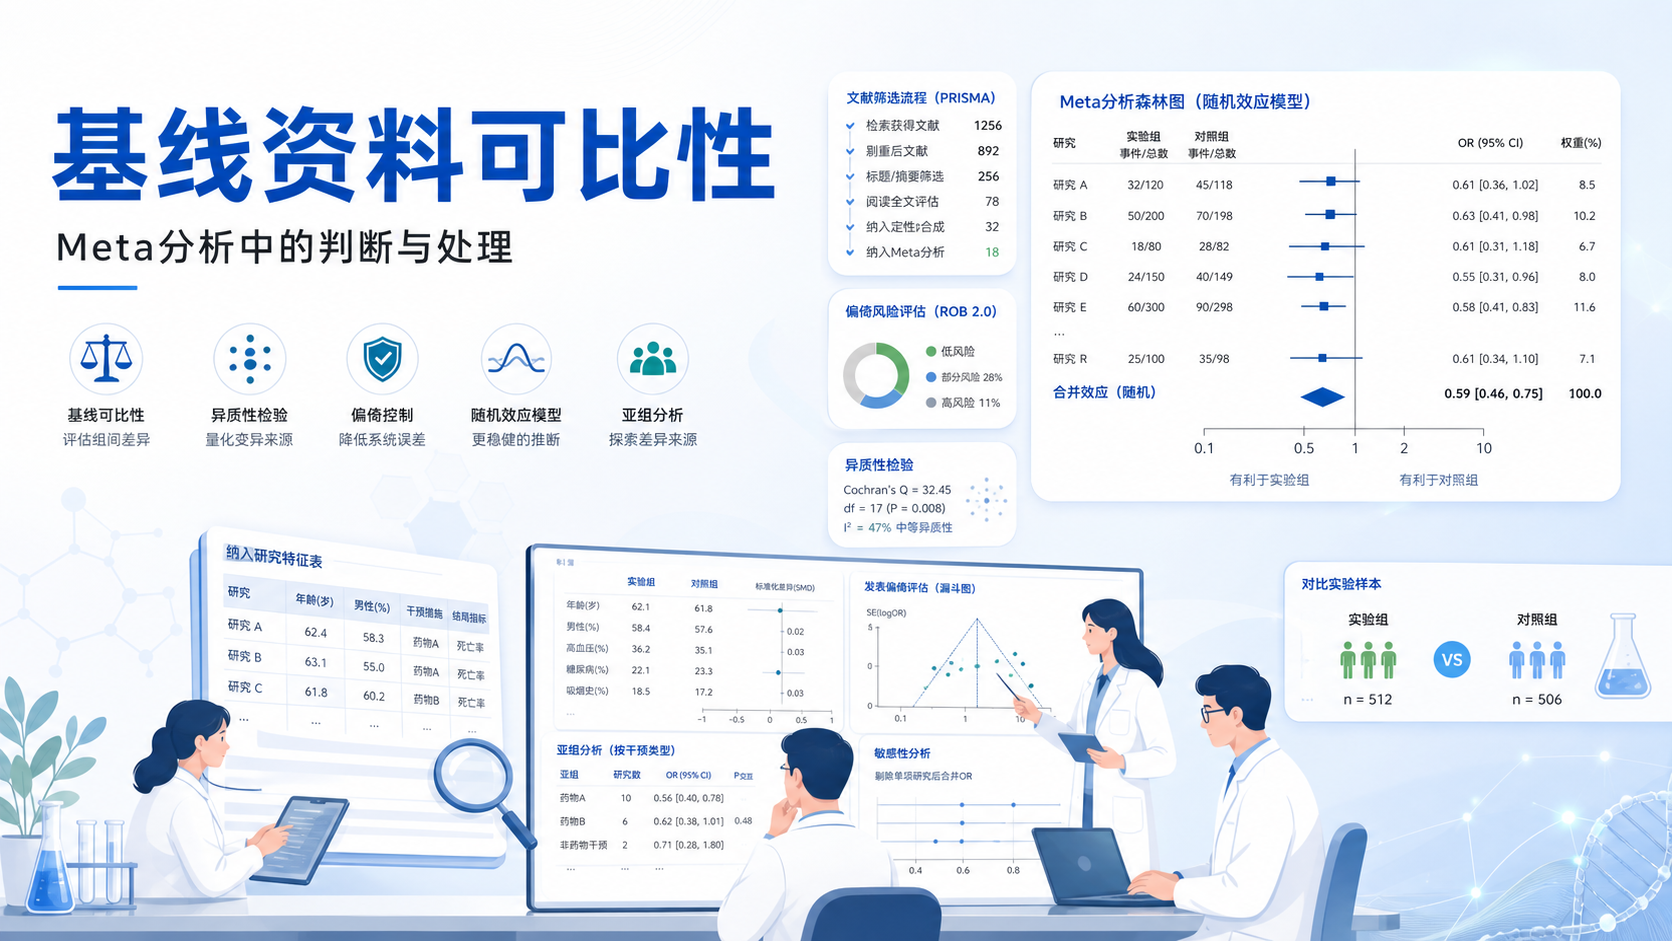
Meta分析看起来是“合并结果”,但真正决定结论可信度的,往往是纳入研究之间是否可比。如果基线资料差异大,效应值再漂亮,也可能只是偏倚的表象。
这也是很多医学生、医生和科研人员在写Meta分析时最容易忽略的一步。
1. 为什么基线资料可比性如此重要
1.1 它直接影响效应值解释
基线资料可比性,本质上是看纳入研究在研究对象、疾病严重程度、干预前状态等方面是否接近。如果两组或多项研究起点差异明显,最终观察到的效应,就可能来自“起点不同”,而不是干预本身。
在随机对照试验中,基线平衡是随机分组是否成功的重要体现。在Meta分析中,这一问题更复杂,因为你面对的是多项研究。即使单篇研究内部平衡,研究与研究之间仍可能存在明显差异。比如年龄构成不同,病程长短不同,诊断标准不同,都会影响合并结果。
1.2 它是异质性的重要来源
基线差异常常会转化为统计学异质性。
例如,不同研究纳入的患者年龄分布不同,病情轻重不同,干预前指标不同,最后就可能表现为I²升高。
常见的基线差异包括以下几类。
- 人群特征差异,如年龄、性别、种族。
- 疾病特征差异,如病程、分型、严重程度。
- 方法学差异,如诊断标准、实验方法、随访时间。
- 干预前差异,如治疗前指标水平、共病情况、合并用药。
因此,基线可比性不是形式问题,而是影响合并效应真实性的核心前提。
1.3 它影响结论外推性
如果纳入研究的基线资料高度一致,结论更容易推广。
如果差异很大,结论可能只适用于特定人群。比如某Meta分析主要纳入老年患者,但结果被直接外推到儿童群体,往往并不稳妥。
2. 如何在Meta分析中判断基线资料可比性
2.1 先看基线资料表
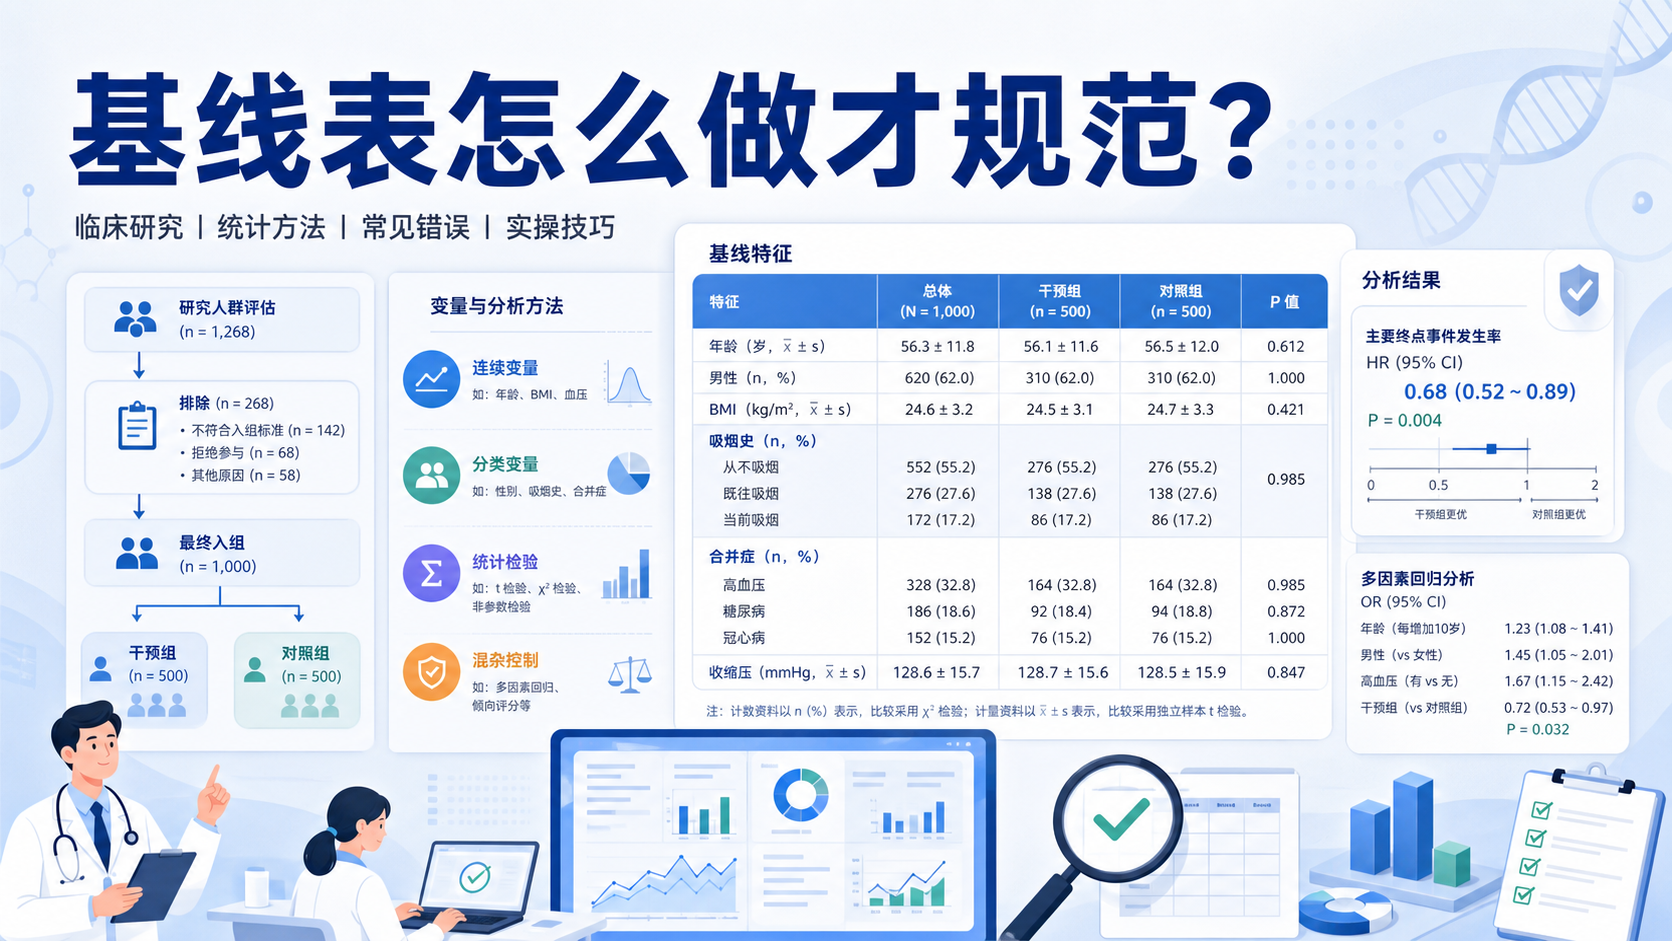
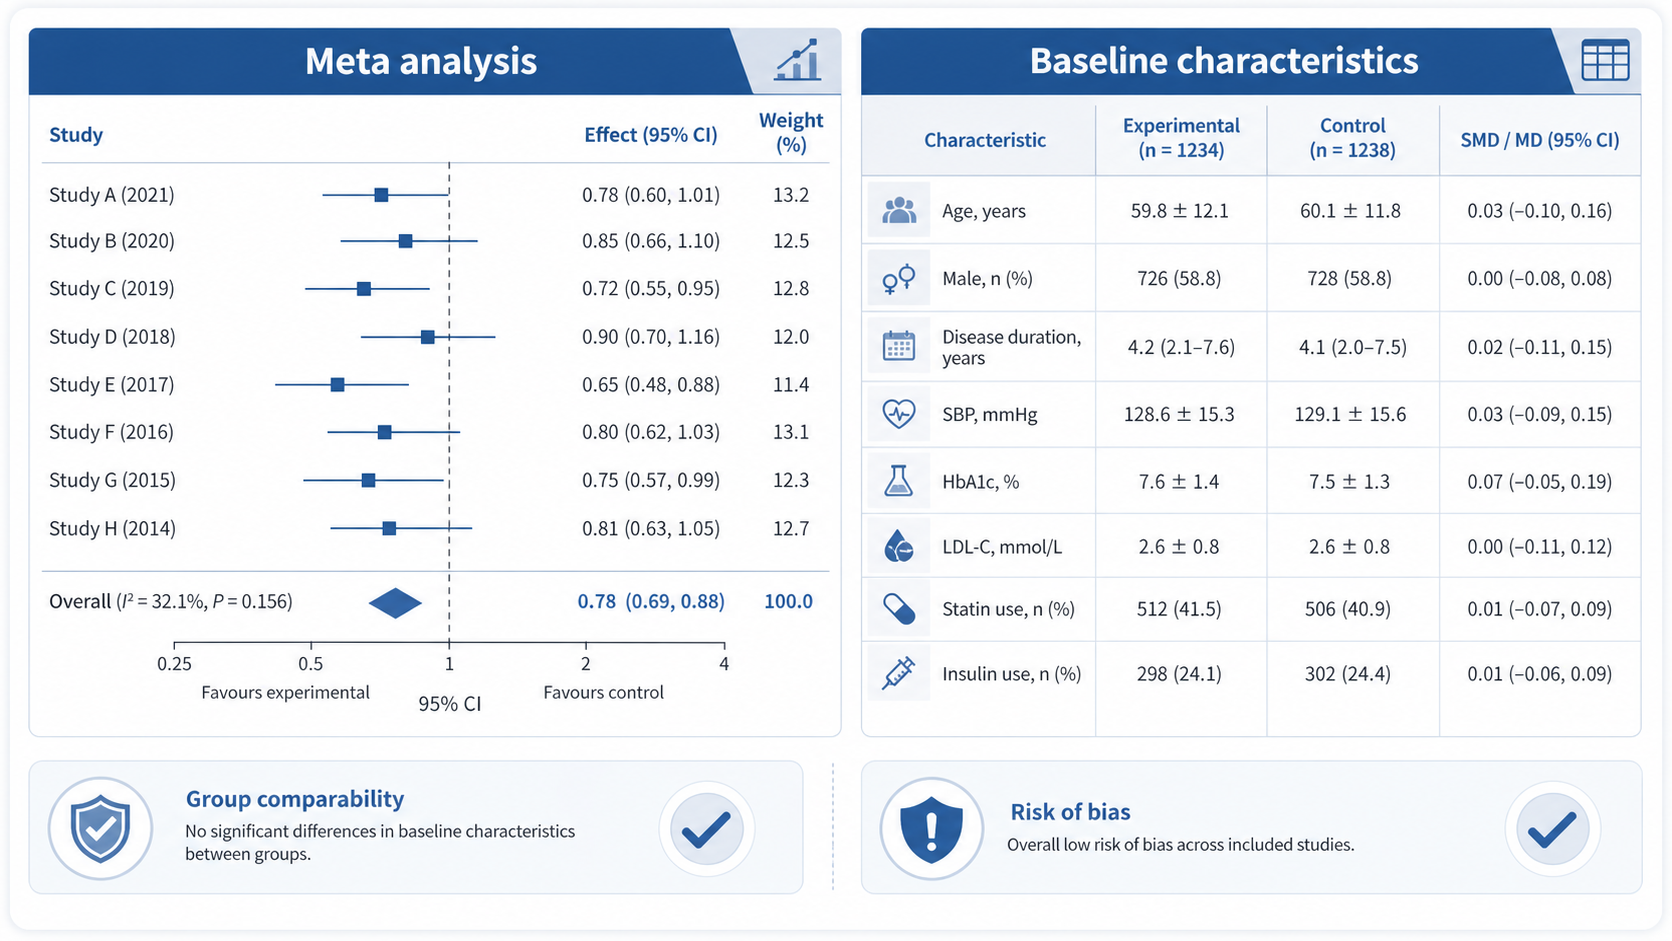
Meta分析中的基线资料表,通常包含作者、年份、国家、研究设计、样本量、年龄、性别、疾病类型、干预措施等信息。这张表不是“附属品”,而是判断可比性的第一步。
建议优先检查以下项目。
- 研究对象是否来自相似人群。
- 纳入标准和排除标准是否接近。
- 疾病诊断标准是否一致。
- 干预前关键指标是否平衡。
- 随访时间和结局指标是否一致。
如果这些信息缺失,不能简单视为“无差异”。更严谨的做法是标注为“信息不足”,并在讨论中说明。
2.2 关注是否存在重复发表
在文献筛选中,重复发表会人为放大某些基线特征,造成偏倚。同一研究如果在不同期刊、不同主题或不同版本中重复出现,通常应保留最新或样本量更大的版本。
这一步很关键。因为重复纳入不仅影响样本独立性,也会扭曲基线可比性判断。
如果小样本和大样本同时纳入,可能让某一特征被过度代表。
2.3 用统计和临床双重视角判断
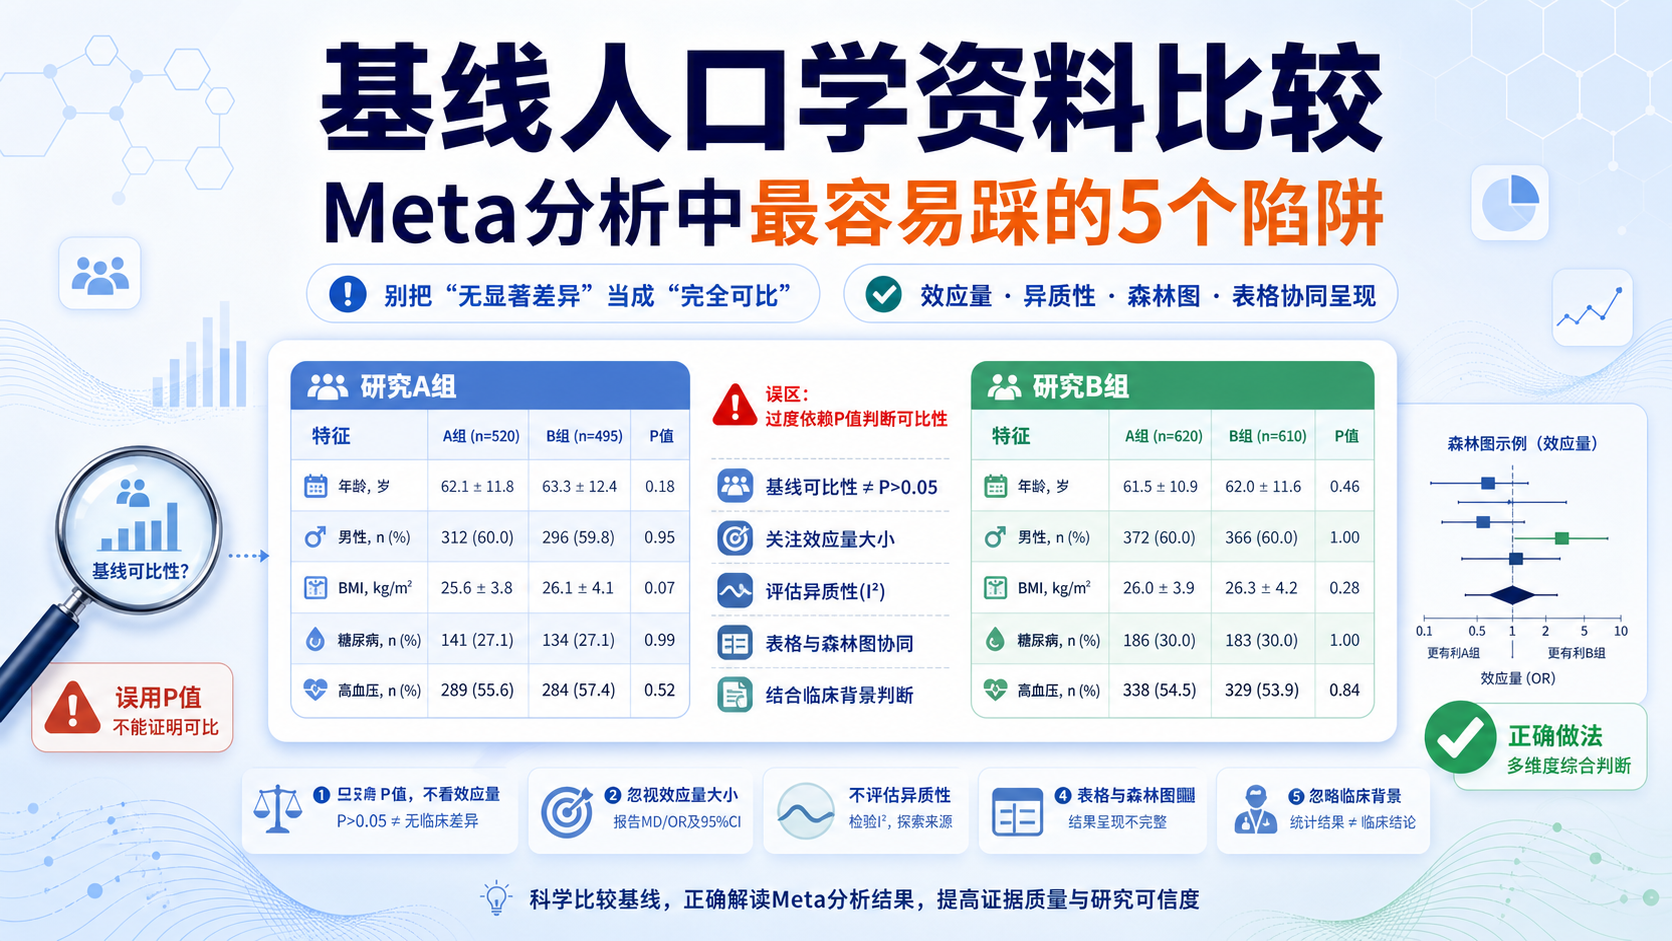
基线可比性不能只看P值。
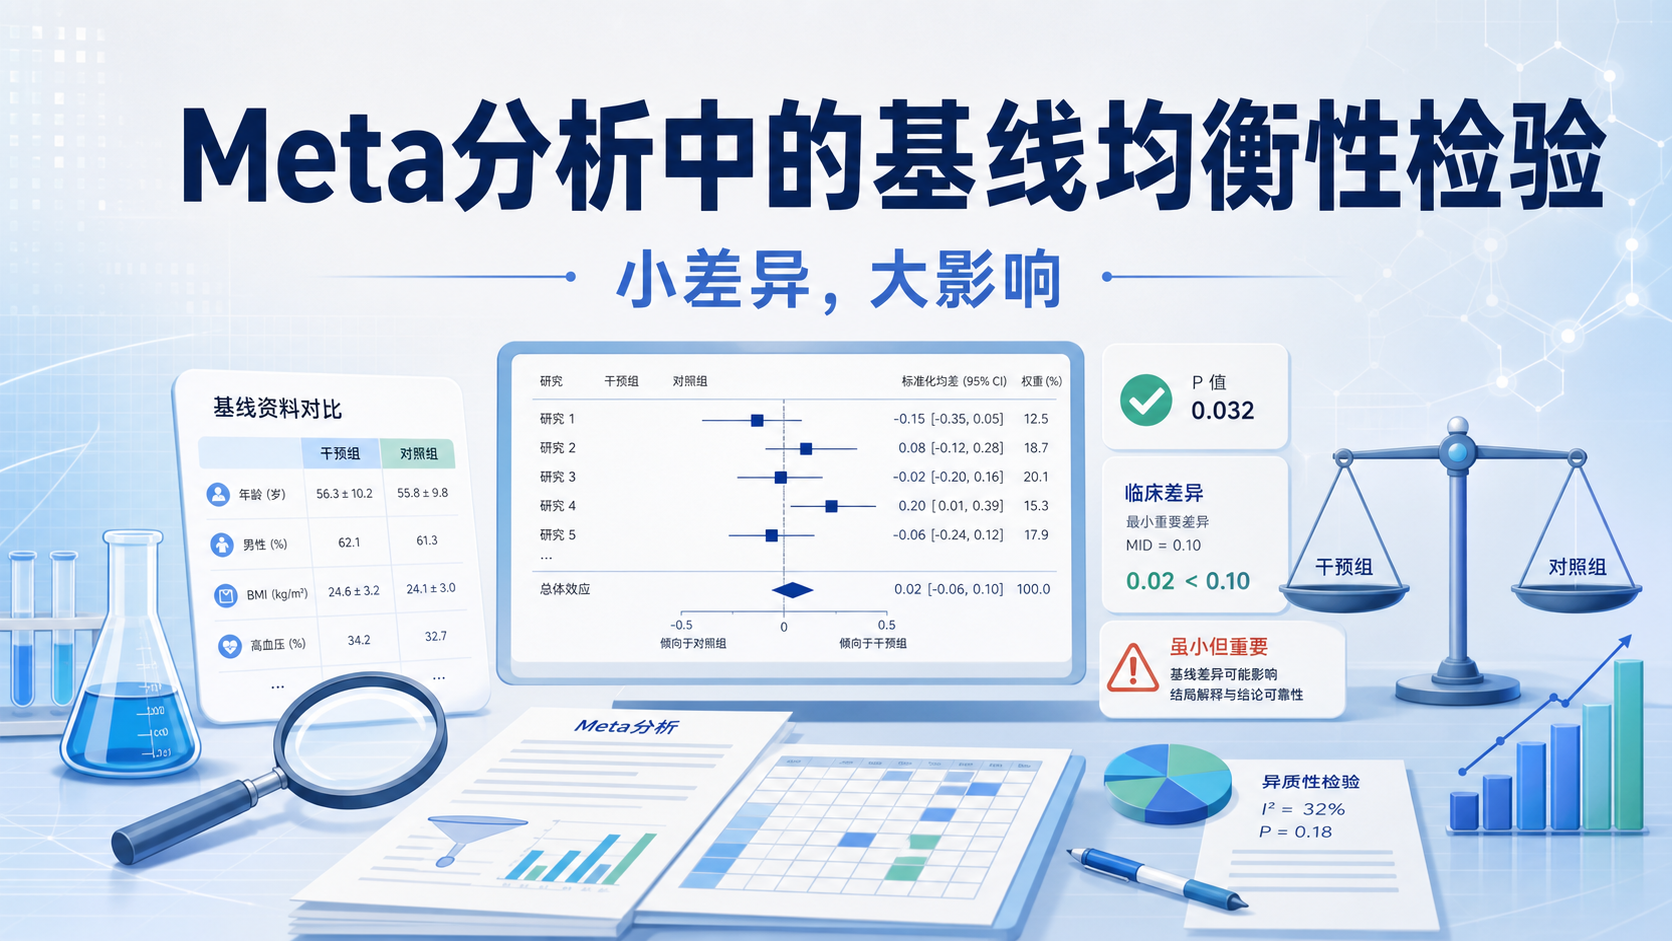
统计学“无差异”不等于临床上“完全可比”,统计学“有差异”也不一定就会造成严重偏倚。
更合理的判断方式是结合两点。
- 统计学差异:是否存在显著P值。
- 临床意义:差异是否足以影响结局。
例如,年龄均值差2岁,可能统计上显著,但临床影响有限。
但如果病程差异达到数年,或重症比例差距明显,就可能显著影响结局解释。
3. 基线资料不平衡时,Meta分析应该怎么处理
3.1 通过亚组分析降低偏倚
当研究之间基线差异较大时,亚组分析是最常用的方法之一。
它的核心目的,是把“不同来源的数据”拆开看,而不是强行合并。
常见亚组依据包括:
- 年龄,成人与儿童。
- 地区,中国、亚洲、欧美。
- 疾病分型,轻症与重症。
- 诊断标准,不同诊断体系。
- 研究时间,早期研究与近期研究。
- 样本量,大样本与小样本。
如果亚组结果一致,说明结论更稳健。
如果亚组结果差异明显,就要警惕基线异质性影响了总体效应。
3.2 必要时使用随机效应模型
当研究间差异不可避免时,随机效应模型更符合实际。
固定效应模型假设各研究共享同一个真实效应值,而随机效应模型承认不同研究之间存在真实差异。
但要注意,模型选择不是“修饰结果”的工具。
它应当基于异质性判断,而不是为了得到更好看的结果。通常可结合Q检验和I²来决定。
- I²≤50%,异质性相对可接受。
- I² 50%到75%,提示异质性偏高。
- I²>75%,说明异质性较强,应优先考虑亚组或敏感性分析。
3.3 对严重不平衡研究谨慎纳入
如果某些研究的基线差异极大,且无法通过亚组或敏感性分析解释,最稳妥的做法不是“硬合并”,而是考虑剔除或单独讨论。
尤其在以下情况中要特别谨慎。
- 纳入对象明显不同。
- 干预前严重程度差距过大。
- 诊断标准不同。
- 关键结局指标不可比。
这类研究即使数量少,也可能对总效应造成明显拉动。
4. 基线资料可比性与偏倚控制的实战要点
4.1 文献筛选阶段就要设定标准
很多问题不是分析阶段才出现,而是筛选阶段就埋下了。
在确定题目后,应先写清纳入和排除标准,再开始检索和筛选。
建议至少明确以下内容。
- 研究类型。
- 发表年限。
- 语言限制。
- 样本量要求。
- 随访时间。
- 结局指标。
- 诊断标准。
标准越清晰,后续基线可比性越容易控制。
4.2 数据提取时要保留足够细节
除了发生数、均数和标准差,还应尽可能提取影响可比性的变量。
例如作者、国家、实验方法、研究对象分布、性别比例等。
这些信息后续可以用于:
- 亚组分析。
- 敏感性分析。
- 解释异质性来源。
- 判断某些研究是否应排除。
不要只提取结局值,而忽略基线信息。
这是很多新手Meta分析最常见的漏洞。
4.3 质量评价不能省略
质量评价是判断基线可比性和整体可信度的重要环节。
观察性研究常用NOS等量表,RCT可结合相应风险偏倚工具。质量评价不是装饰性步骤,而是决定结果能否被信任的前提。
一般来说,质量较低、基线失衡明显、报告不完整的研究,对总体结论的干扰更大。
如果存在这类文献,最好在敏感性分析中单独检验其影响。
5. 写作时如何呈现基线资料可比性
5.1 结果部分要客观描述
写作时,不要简单写“各组基线资料可比”。
更严谨的表达应当是:“纳入研究在年龄、性别、疾病类型及主要干预前指标方面总体接近,部分研究存在轻度差异,已通过亚组或敏感性分析处理。”
这样写更符合学术表达,也更便于审稿人判断。
5.2 讨论部分要承认局限
如果基线资料不完全可比,讨论中必须说明。
可以从以下角度写。
- 差异是否可能影响结局。
- 是否已通过亚组分析控制。
- 是否增加了异质性。
- 是否限制了外推性。
诚实呈现局限,比强行强调“无差异”更符合E-E-A-T原则。
5.3 结论不要超出证据范围
当基线不平衡较明显时,结论应更保守。
不要把“在某类样本中观察到有效”直接扩大成“适用于所有人群”。
这不仅是写作规范,也是研究伦理。
总结Conclusion
基线资料可比性分析,是Meta分析中最容易被低估、却最影响结论可信度的环节。它关系到异质性、偏倚、外推性和结果解释。真正高质量的Meta分析,不是把所有研究简单堆叠,而是先判断它们是否站在同一起点上。
在实战中,建议从筛选标准、基线资料表、亚组分析、随机效应模型和敏感性分析五个层面同步控制偏倚。若你希望把这些步骤系统化、模板化,提升文献筛选、数据提取和结果呈现效率,可以借助解螺旋 提供的科研写作与分析支持,让基线资料可比性分析更规范,也让你的Meta分析更稳、更可信。
- 引言Introduction
- 1. 为什么基线资料可比性如此重要
- 2. 如何在Meta分析中判断基线资料可比性
- 3. 基线资料不平衡时,Meta分析应该怎么处理
- 4. 基线资料可比性与偏倚控制的实战要点
- 5. 写作时如何呈现基线资料可比性
- 总结Conclusion