15
 分享
引言Introduction
临床研究里,样本量不足很常见。问题是,很多人把“样本少”简单理解成“结果没意义”。其实,样本量不足最直接的风险不是结论一定错,而是估计不稳、效应被放大或缩小、阴性结果更难解释。
1. 为什么样本量不足会影响结果可信度
1.1 小样本最常见的问题不是“没结果”,而是“结果漂移”
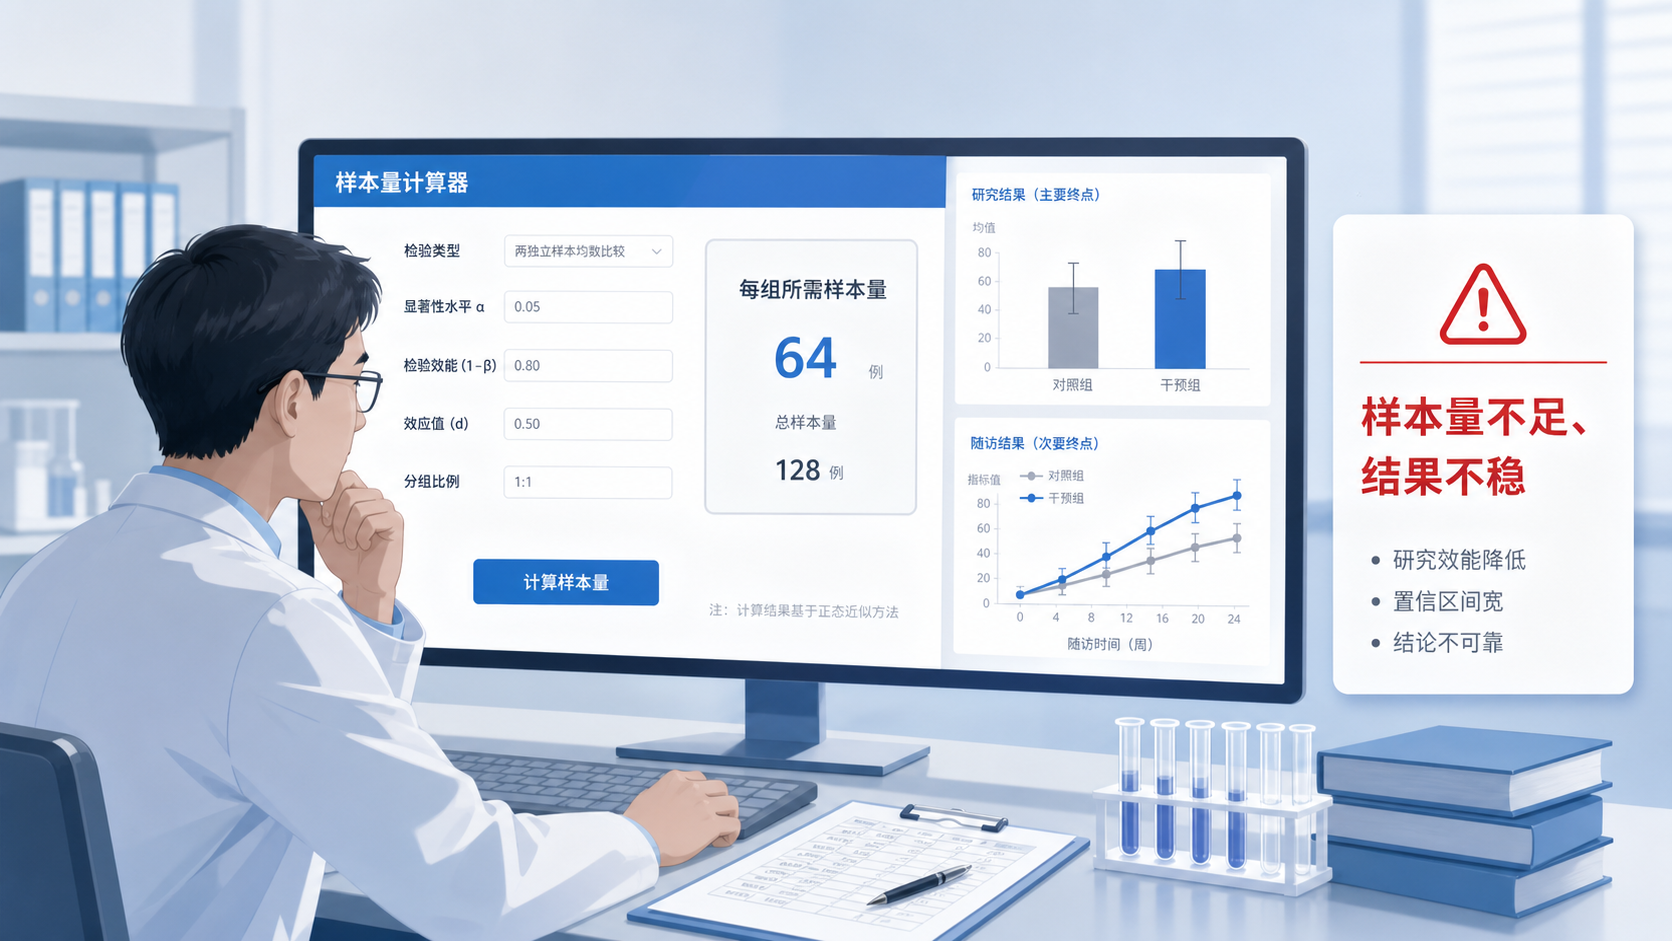
样本量小的时候,随机误差会明显增大。对横断面研究来说,患病率可能被高估或低估。对关联研究来说,OR、RR、均值差都更容易波动。同一个真实效应,在小样本下可能表现为显著,也可能完全不显著。
例如,调查患病率时,如果只抽2个人,结果只能是0%、50%或100%。即便抽10个人,可能也只能得到0%、10%、20%这类粗糙结果。这类结果不是“更真实”,而是“更不稳定”。
1.2 样本量不足结果不可靠,常体现在三种偏差
样本量不足时,最常见的问题有三类。
- 效应量不稳定。 估计值容易被少数个体拉动。
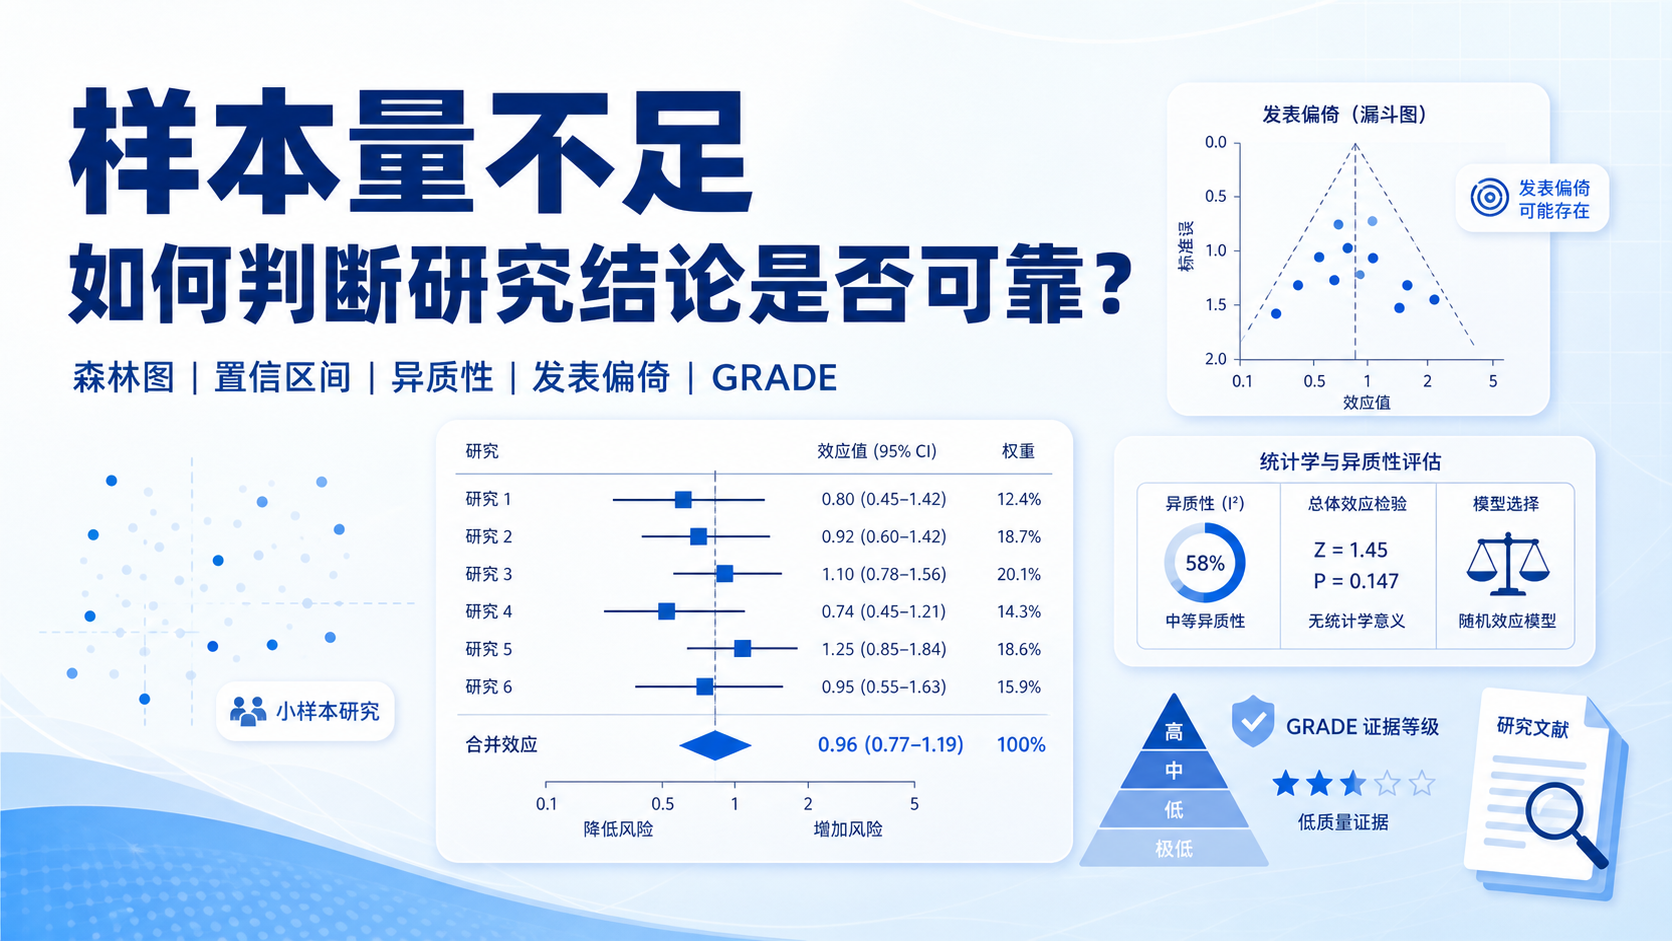
- 置信区间过宽。 说明精度差,临床解释价值下降。
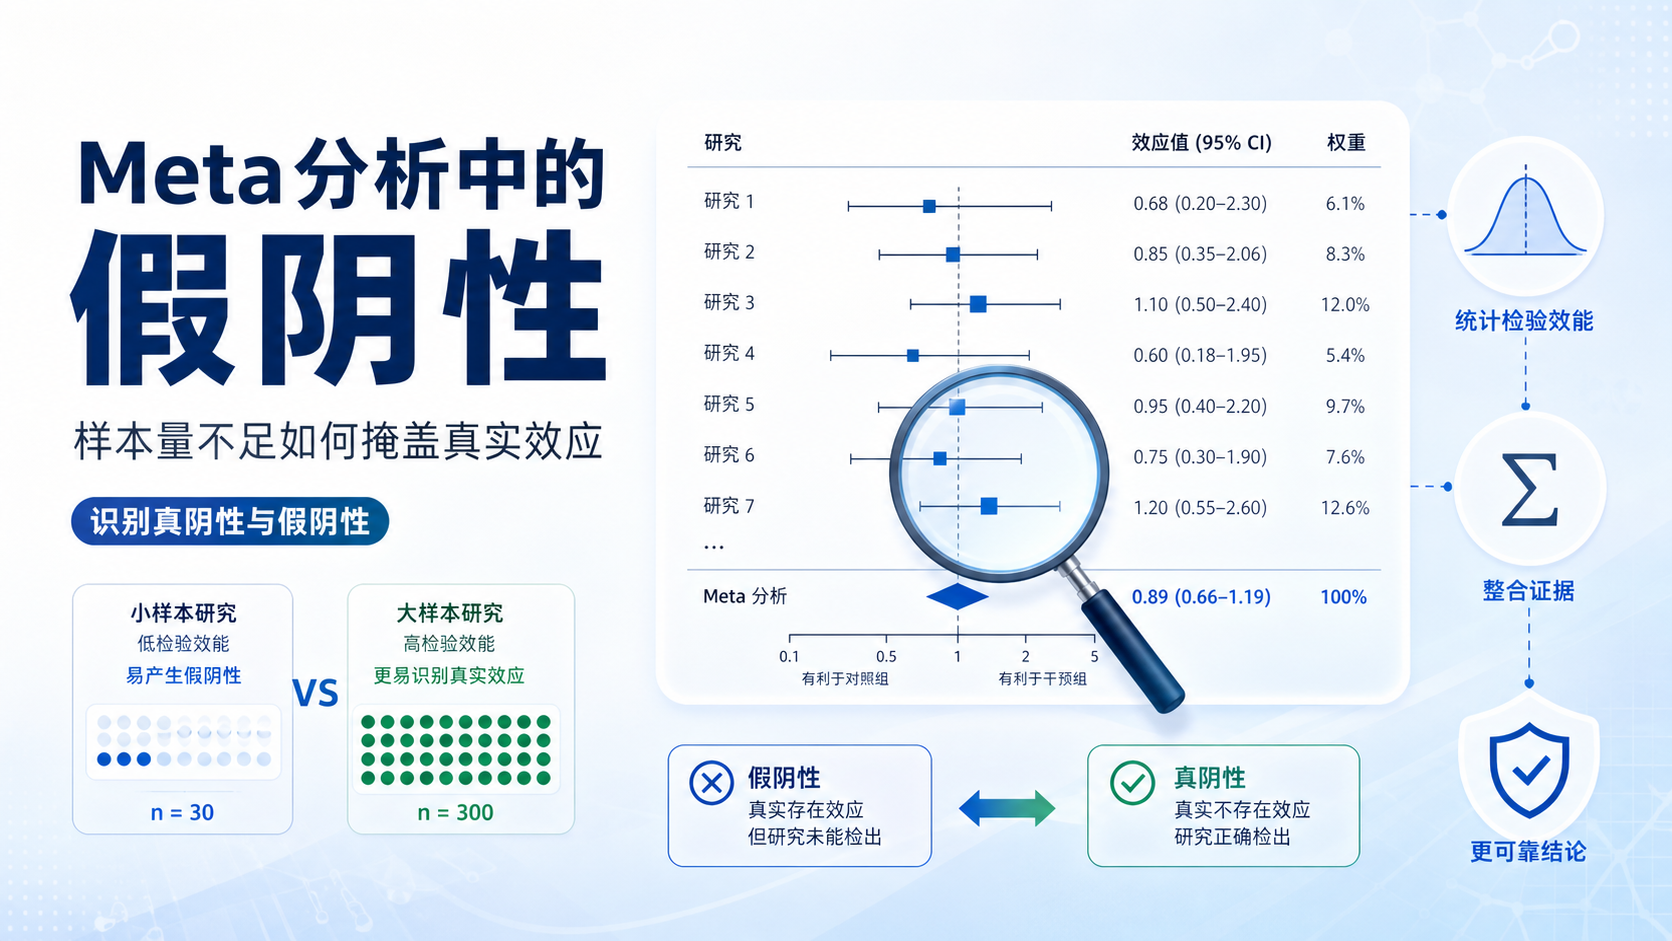
- 检验效能不足。 真正存在的差异也可能检不出来。
这也是为什么很多研究“P值不显著”,并不等于“没有差异”。它可能只是样本量不足结果不可靠。
1.3 阴性结果更需要警惕
如果研究结果是阴性,研究者最需要问的不是“有没有差异”,而是“有没有足够能力发现差异”。当样本量不足时,阴性结果很可能只是低把握度的体现。
这在临床论文里尤其重要。审稿人常会追问:研究是没有效应,还是没有检出效应。两者不是一回事。
2. 样本量不足时,研究者最容易踩的统计学误区
2.1 误区一,把“没显著”直接当作“没差异”
这是最常见的错误。P值不显著,只能说明当前数据未能提供足够证据。它不能证明两组真的没有差异。
如果样本少、方差大、效应本来就小,那么统计检验很容易失败。此时更合理的做法是结合效应量、置信区间和临床意义一起判断,而不是只看P值。
2.2 误区二,研究结束后再补做样本量估计
样本量估计应在研究设计阶段完成,而不是数据分析完后再补一段公式。事后补样本量,不能弥补设计缺陷。
如果研究已经结束,更合适的是做把握度分析或敏感性分析,用来解释研究为何可能未检出差异,而不是把它包装成前瞻性设计的一部分。
2.3 误区三,认为“有公式”就一定能说服审稿人
样本量估计不是简单套公式。审稿人会看你的前提是否合理,包括:
- 预期效应量是否来自文献或预实验。
- α和把握度是否设定合理。
- 容许误差是否符合研究目的。
- 研究设计是否和公式匹配。
如果前提本身不科学,再漂亮的样本量计算也站不住。
比如为了把样本量算得很小,故意设定一个不现实的大效应,这种做法通常会被质疑。
2.4 误区四,忽视研究类型对样本量的影响
横断面研究、病例对照研究、队列研究、连续变量估计,样本量公式都不同。先谈研究设计,再谈样本量,顺序不能反。
如果只告诉统计学家“我要做一个临床研究”,是无法准确计算的。至少要说明研究目的、主要结局、变量类型和分组方式。
3. 不同研究场景下,如何识别样本量是否足够
3.1 横断面研究:看精度,不只看人数
横断面研究最常见的目标,是估计患病率或均数。此时样本量是否足够,关键看是否达到预期精度。
例如:
- 估计患病率时,关注容许误差。
- 估计连续变量时,关注标准差和误差界限。
如果你的研究目标是估计某人群高血压患病率,而容许误差设得很小,就需要更大的样本。
反过来,如果样本太少,患病率区间会很宽,临床参考价值就会下降。
3.2 关联研究:看把握度是否支持检出差异
病例对照研究和队列研究,核心是比较暴露或结局差异。样本量要基于预期差异、暴露率、效应量和把握度。
这里的关键点是:想检出越小的差异,需要越大的样本。
如果暴露率本身很低,所需样本也会进一步增大。若样本量不够,研究可能“看起来做了”,但实际上没有足够能力证明问题。
3.3 观察性数据库研究:样本多不等于设计好
有些人认为,只要数据库足够大,样本量就不是问题。这个判断并不完全正确。数据库大,只解决了“数量”问题,不自动解决“设计”和“偏倚”问题。
如果结局定义不清、混杂控制不足、缺失值多,再大的样本也可能导出偏倚结论。
4. 应对样本量不足的实用策略
4.1 优先明确主终点
当资源有限时,不要把所有结局都当作主问题。先确定一个最重要的主终点,再围绕它做样本量估计。这样可以避免研究目标发散,也更容易获得合理样本。
4.2 提高研究效率,而不是盲目扩大样本
如果短期内无法获得足够病例,可以考虑:
- 延长纳入时间。
- 多中心联合。
- 使用连续入组,减少选择偏倚。
- 优化纳排标准,提升样本可用性。
- 在设计阶段做预实验,获取更可信的参数。
这些方法比“硬凑样本”更有统计学价值。
4.3 适当调整设计,而不是强行套用原方案
当病例数有限时,可以考虑提高对照比例。病例对照研究中,增加对照数有助于提升统计效能,但这种提升不是无限的。超过一定比例后,收益会递减。
因此,设计调整要建立在研究问题和可行性基础上,而不是为了填补样本不足而盲目改变方案。
4.4 报告时主动披露局限性
如果样本确实不足,正文和讨论部分应明确说明:
- 研究的样本来源。
- 实际纳入人数与计划样本量的差距。
- 可能带来的效能不足。
- 结果解释应采取谨慎态度。
主动披露局限性,反而更能提升论文可信度。
5. 写作与投稿时,如何让样本量问题更专业
5.1 在方法学部分写清楚样本量依据
建议在方法部分交代:
- 研究设计类型。
- 主要终点。
- 样本量估计参数。
- α值、把握度或容许误差。
- 参数来源,来自文献、预实验还是专家经验。
这能帮助审稿人判断你的设计是否严谨。
5.2 在结果部分避免过度解读
如果研究样本偏少,不要把边缘性结果写成强结论。尤其不要把“未达到统计学显著”直接包装成“无临床意义”。
更稳妥的写法,是结合效应方向、置信区间范围和已有文献进行解释。
5.3 在讨论部分强调统计解释,而不是修饰结论
小样本研究最怕“过度自信”。更好的做法是承认局限,并解释:
- 结果可能存在随机误差。
- 统计功效可能不足。
- 需要更大样本或前瞻性研究验证。
这种写法更符合E-E-A-T,也更容易获得同行认可。
6. 结论:把“样本量不足结果不可靠”变成可控问题
样本量不足不等于研究无价值,但它会明显削弱结果的稳定性、精度和可解释性。真正专业的做法,不是事后找理由,而是在研究设计阶段就把样本量、效应量、误差和把握度算清楚。
对于医学生、医生和科研人员来说,最重要的是先选对研究设计,再判断样本量是否支持研究目的。只有这样,阴性结果才更有说服力,阳性结果才更可信。
如果你希望把样本量计算、研究设计和投稿写作一次性做规范,建议使用解螺旋 的研究支持工具和方法学资源,减少因样本量不足导致的结论风险,让研究从一开始就更稳。
- 引言Introduction
- 1. 为什么样本量不足会影响结果可信度
- 2. 样本量不足时,研究者最容易踩的统计学误区
- 3. 不同研究场景下,如何识别样本量是否足够
- 4. 应对样本量不足的实用策略
- 5. 写作与投稿时,如何让样本量问题更专业
- 6. 结论:把“样本量不足结果不可靠”变成可控问题