8
 分享
引言Introduction
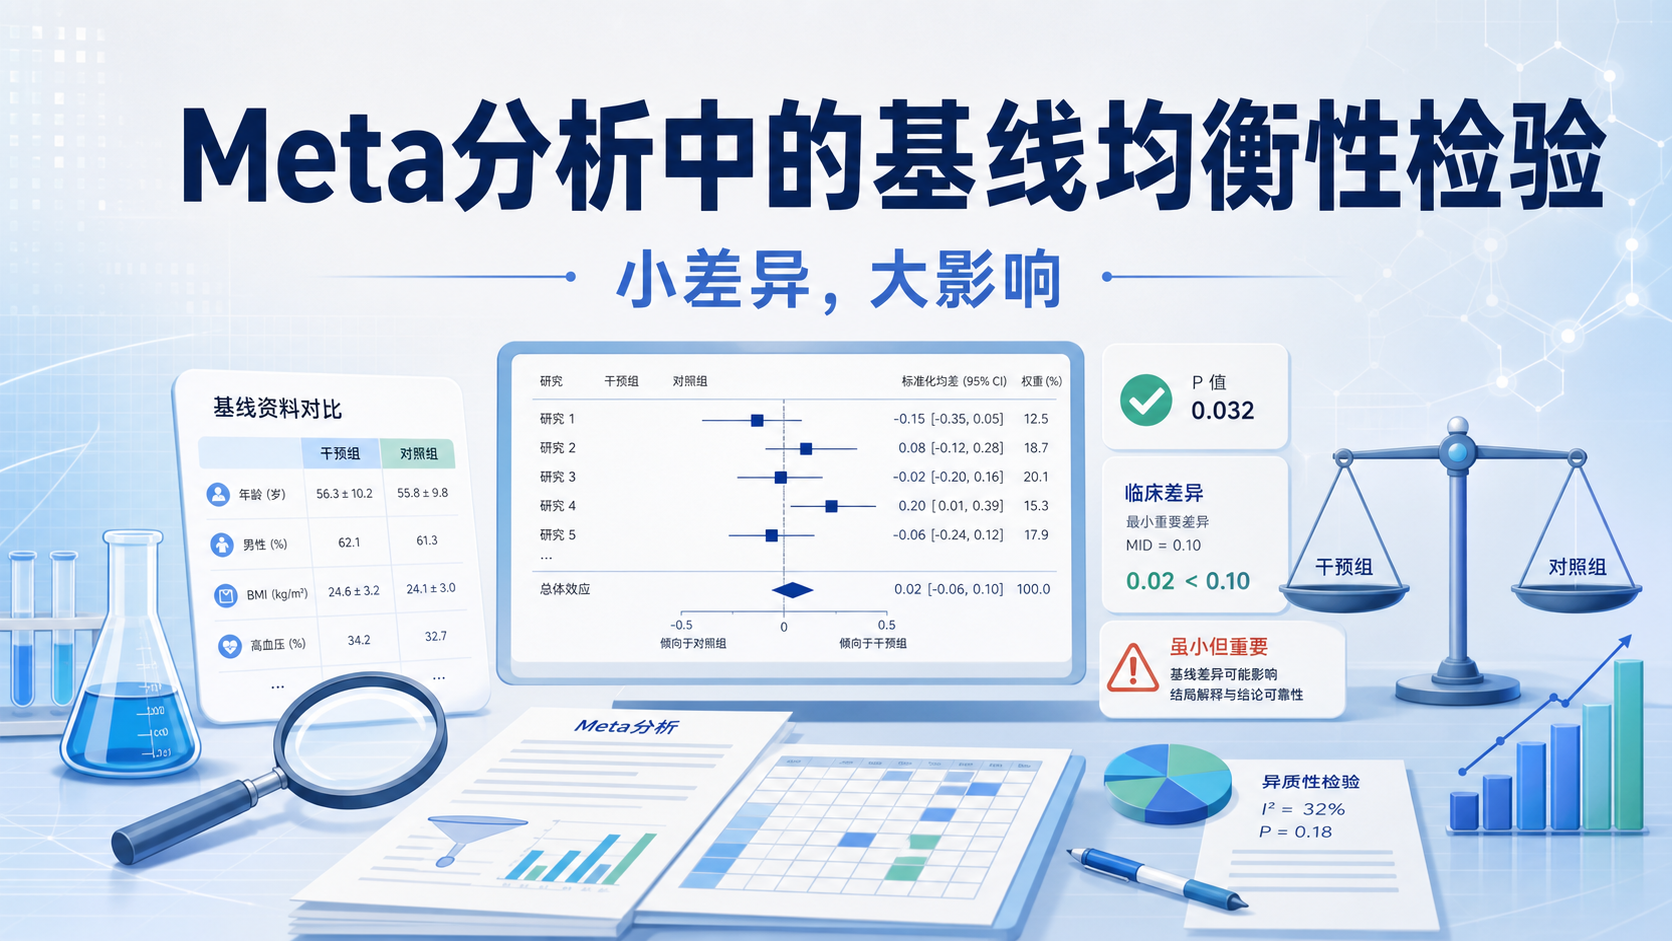
Meta分析前,很多人只盯着结局指标,却忽略了基线资料是否均衡 。如果纳入研究在年龄、病情、样本量或诊断标准上差异过大,合并结果再显著,也可能解释不清。基线资料均衡性检验,是判断研究可比性和结果可信度的第一步。
1. 为什么要做基线资料均衡性检验
1.1 先判断“能不能比”,再判断“比得出什么”
Meta分析的核心是合并多项研究的效应值。但在合并前,必须先看这些研究是否站在同一起跑线。基线资料均衡性检验,本质上是检查各研究组之间是否存在系统性差异。
如果干预组和对照组在年龄、性别、疾病分期、病程长度上差异明显,后续结局变化就可能不是干预本身导致,而是基线差异造成的混杂。尤其在RCT之外的观察性研究中,这种问题更常见。
1.2 基线不均衡会带来哪些风险
常见风险主要有三类:
- 混杂偏倚 。例如重症患者更多集中在某组,会放大不良结局。
- 异质性升高 。不同研究的起点不同,合并后I²往往偏高。
- 结论解释失真 。即使总体效应显著,也难以说明是干预有效,还是基线不平衡导致。
因此,基线资料均衡性检验不是形式步骤,而是决定Meta分析可信度的关键环节。
2. Meta分析中应提取哪些基线资料
2.1 最常见的基线变量
在临床Meta分析中,通常优先提取以下信息:
- 年龄
- 性别
- 样本量
- 疾病类型和分型
- 病程或随访时间
- 诊断标准
- 基线结局指标
- 干预前实验室指标或评分
如果是基因多态性、诊断性或预后性Meta分析,还需结合研究领域补充特定变量。比如基因研究会关注遗传平衡性,诊断研究会关注金标准一致性。
2.2 提取时要统一口径
不同研究的基线资料,必须尽量统一成同一指标口径。
例如年龄有的写均数±标准差,有的写中位数和四分位数,有的只给区间。此时不能直接硬合并,需要先判断是否可转换,或改用描述性总结。
对于二分类变量,如性别、吸烟史、合并症,常记录发生人数和总人数。
对于连续性变量,如年龄、BMI、评分、实验室指标,常记录均数、标准差和样本量。
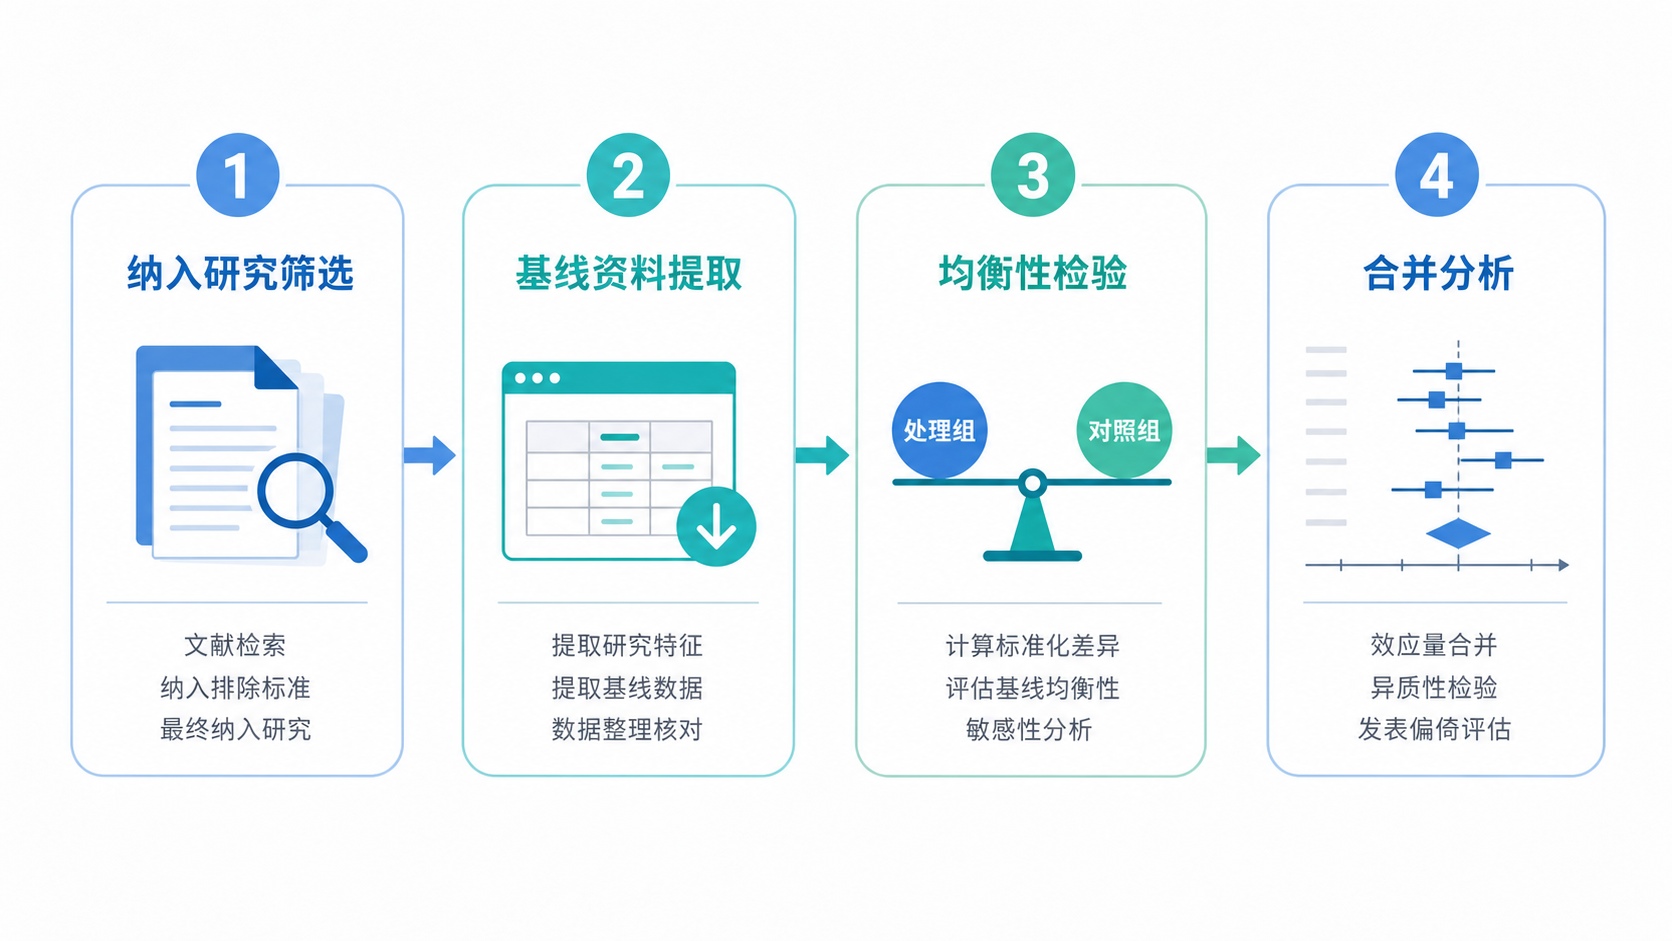
3. 如何进行基线资料均衡性检验
3.1 二分类变量的检验方法
对于性别、阳性率、合并症等二分类变量,常用卡方检验或Fisher精确检验。若各研究样本量较小,某些单元格理论频数不足5,Fisher检验更稳妥。
判断标准很直接。P值大于0.05,通常提示两组基线差异无统计学意义。
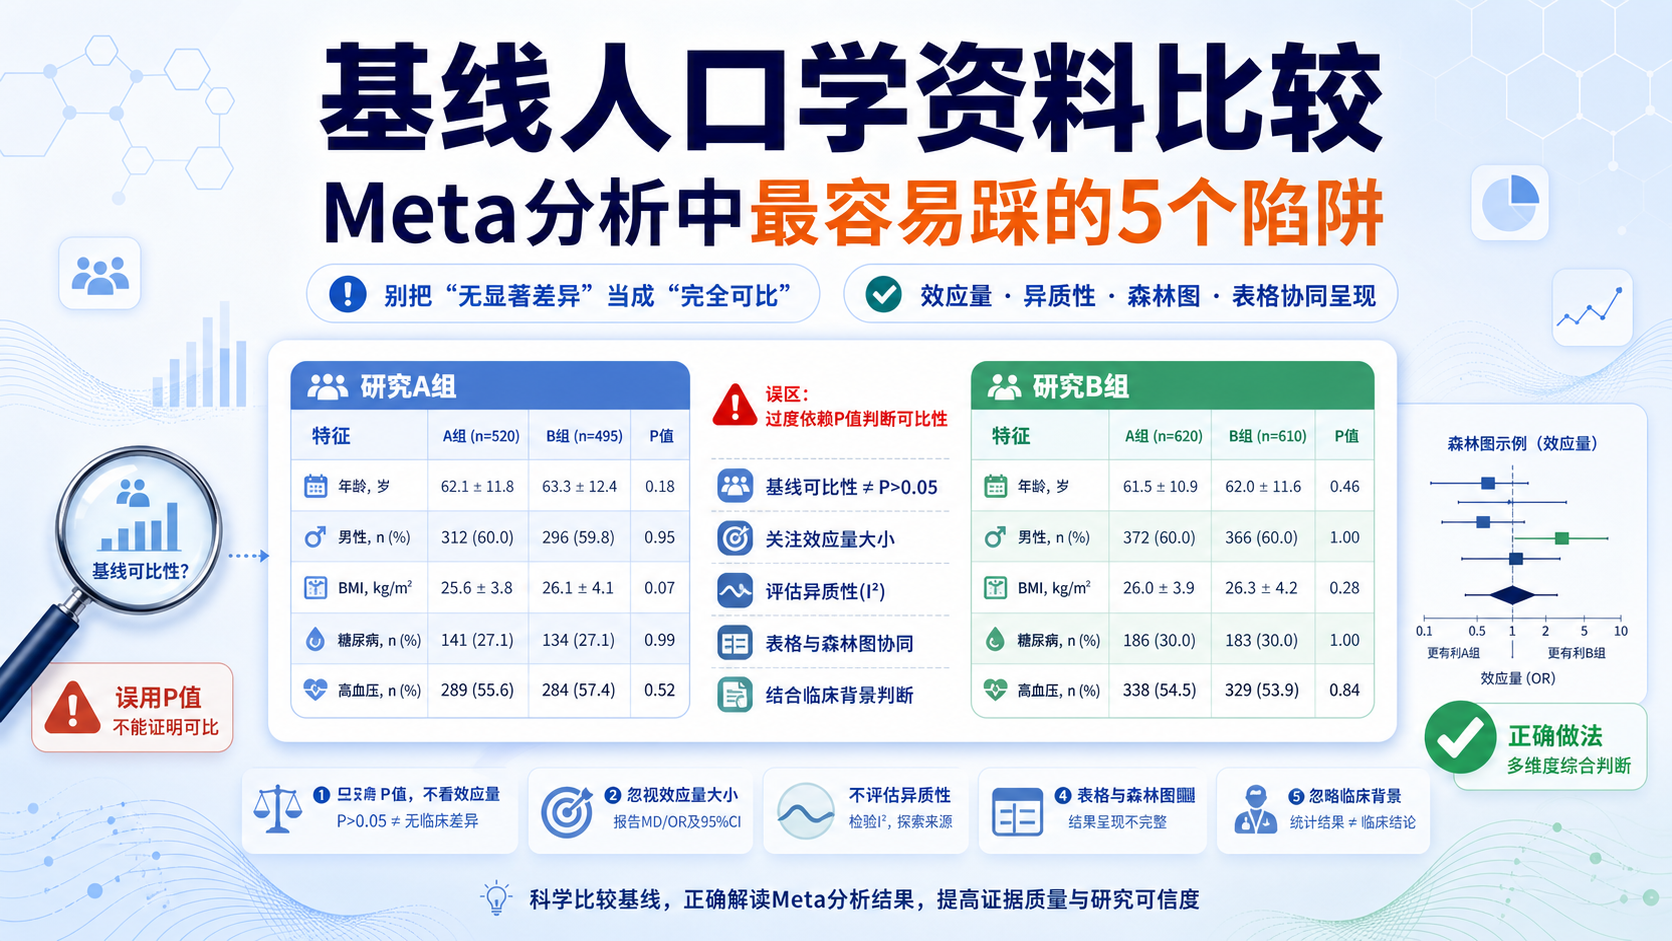
但要注意,P值不等于“完全均衡”。它只能说明当前样本下未观察到显著差异。
3.2 连续性变量的检验方法
连续变量一般采用t检验、方差分析,或在非正态分布下使用秩和检验。若是Meta分析中的单项研究基线比较,也可以先计算均值差,再判断是否存在统计学差异。
更常见的做法是先做描述性比较,再结合效应量和95%CI判断。
如果95%CI跨越无效值,说明差异不显著。
3.3 多研究合并时怎么判断
当你面对的是多篇文献的基线资料,不是单个RCT内部的组间比较时,更常见的做法是:
- 先按研究逐项列出基线信息
- 再汇总各研究范围、均值和分布
- 必要时对关键变量做亚组分析或敏感性分析
这一步的重点不是追求一个“统一的P值”,而是判断研究之间是否存在明显起点差异 。
4. 基线均衡性检验在Meta分析中的实际解读
4.1 不要把“P值>0.05”当成唯一标准
很多人习惯性把P值大于0.05理解为“基线平衡”,这并不严谨。原因有两个。
第一,样本量小会导致检验效能不足 ,真实差异可能检不出来。
第二,样本量大时,即使差异很小,也可能检出统计学显著。
所以,基线均衡性检验应同时看:
- 变量的实际差异大小
- 方向是否一致
- 是否可能影响结局
- 是否需要进一步分层或校正
4.2 更推荐看“临床可接受差异”
在临床研究中,真正重要的是差异是否具有实际意义。比如年龄差1岁,统计学上可能显著,但临床上未必重要。相反,病程差3年,哪怕P值尚未达到0.05,也可能严重影响结局判断。
Meta分析中,临床意义往往比单纯P值更重要。
4.3 基线资料不均衡时怎么处理
如果发现基线不平衡,常见处理方式包括:
- 亚组分析 ,按年龄、地区、病程、疾病分期分层。
- 敏感性分析 ,逐一剔除偏差较大的研究。
- 随机效应模型 ,在存在异质性时更稳妥。
- Meta回归 ,用于探索连续变量对效应量的影响。
- 明确在讨论中说明限制 ,避免过度推断。
对于RCT,若原始研究基线失衡严重,应在质量评价中注明。
对于观察性研究,更要重点考虑混杂因素控制是否充分。
5. 基线资料均衡性检验和其他Meta分析环节的关系
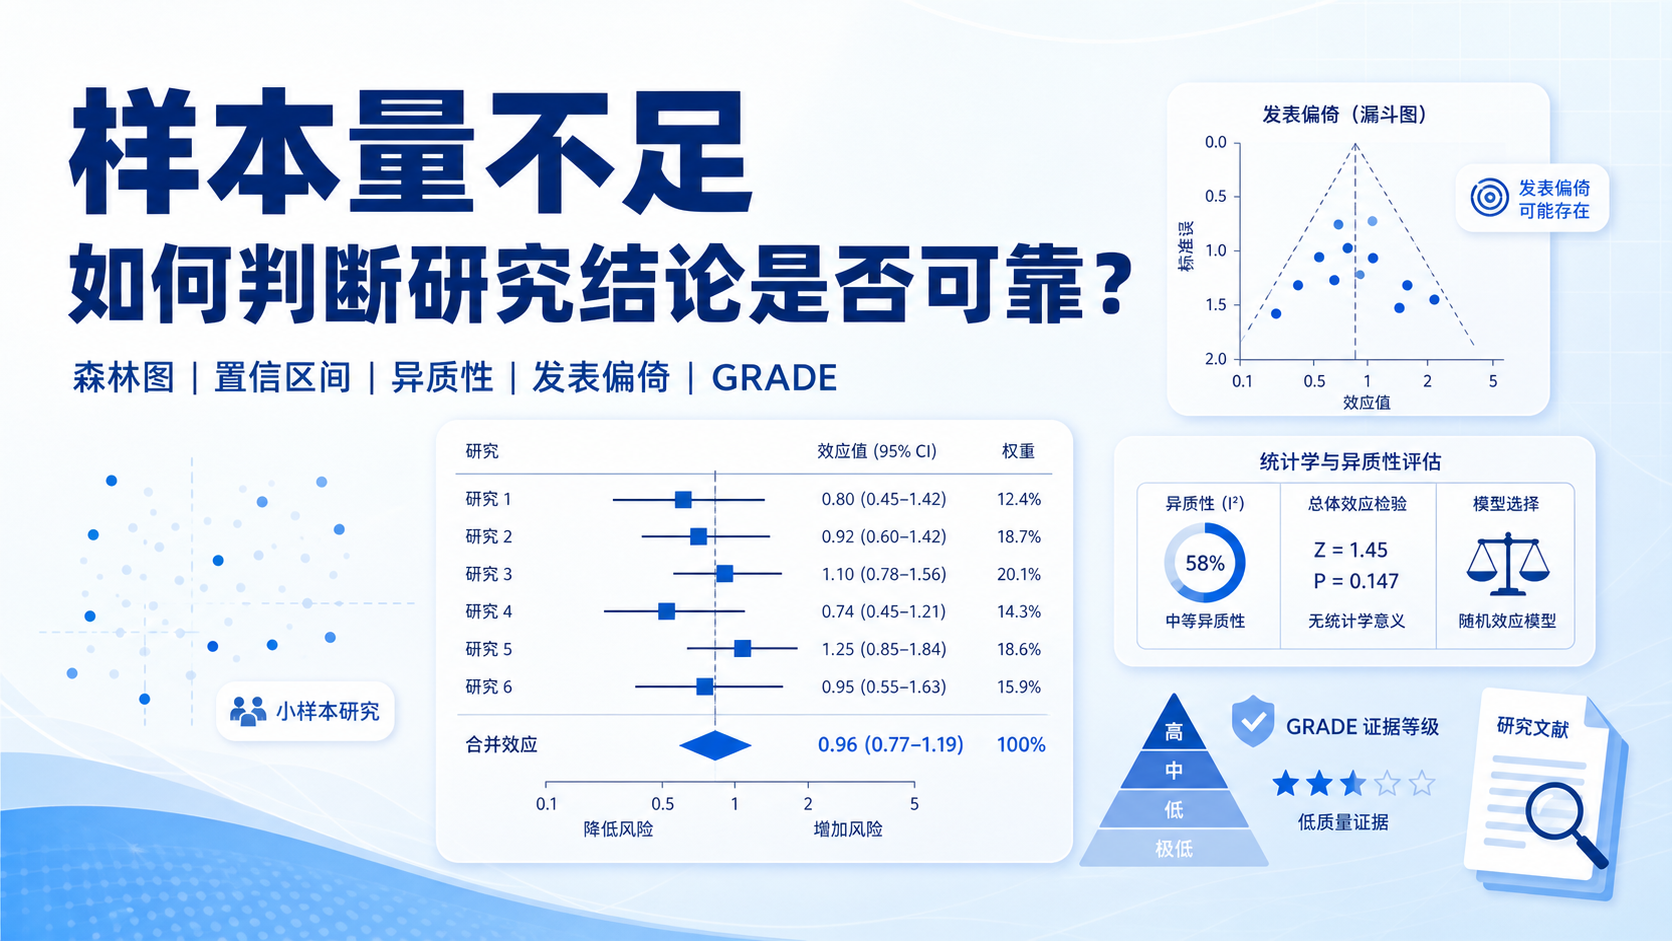
5.1 它会影响异质性判断
异质性并不只来自统计误差,基线差异本身就是重要来源。
例如不同研究纳入的患者年龄层、疾病严重程度、治疗时机不同,即使干预相同,结局也会不同。
因此,在看到I²升高时,不能只盯着统计模型。要回到基线资料,看看研究起点是否一致。
5.2 它决定你能否做可靠的亚组分析
如果基线信息不全,亚组分析就容易失真。
比如你想按病程分组,却发现多数研究没有报告病程,或者分组标准不一致,这时结果解释力就会很弱。
完整、规范的基线资料提取,是后续亚组分析、敏感性分析和Meta回归的基础。
5.3 它也影响发表偏倚判断
发表偏倚通常通过漏斗图、Egger检验等方法判断。但如果纳入研究本身在基线方面就高度不一致,漏斗图的不对称未必只是发表偏倚,也可能是临床异质性导致。
所以,先做基线资料均衡性检验,再判断发表偏倚,更符合分析逻辑。
6. 写作和汇报时,如何规范呈现基线均衡性
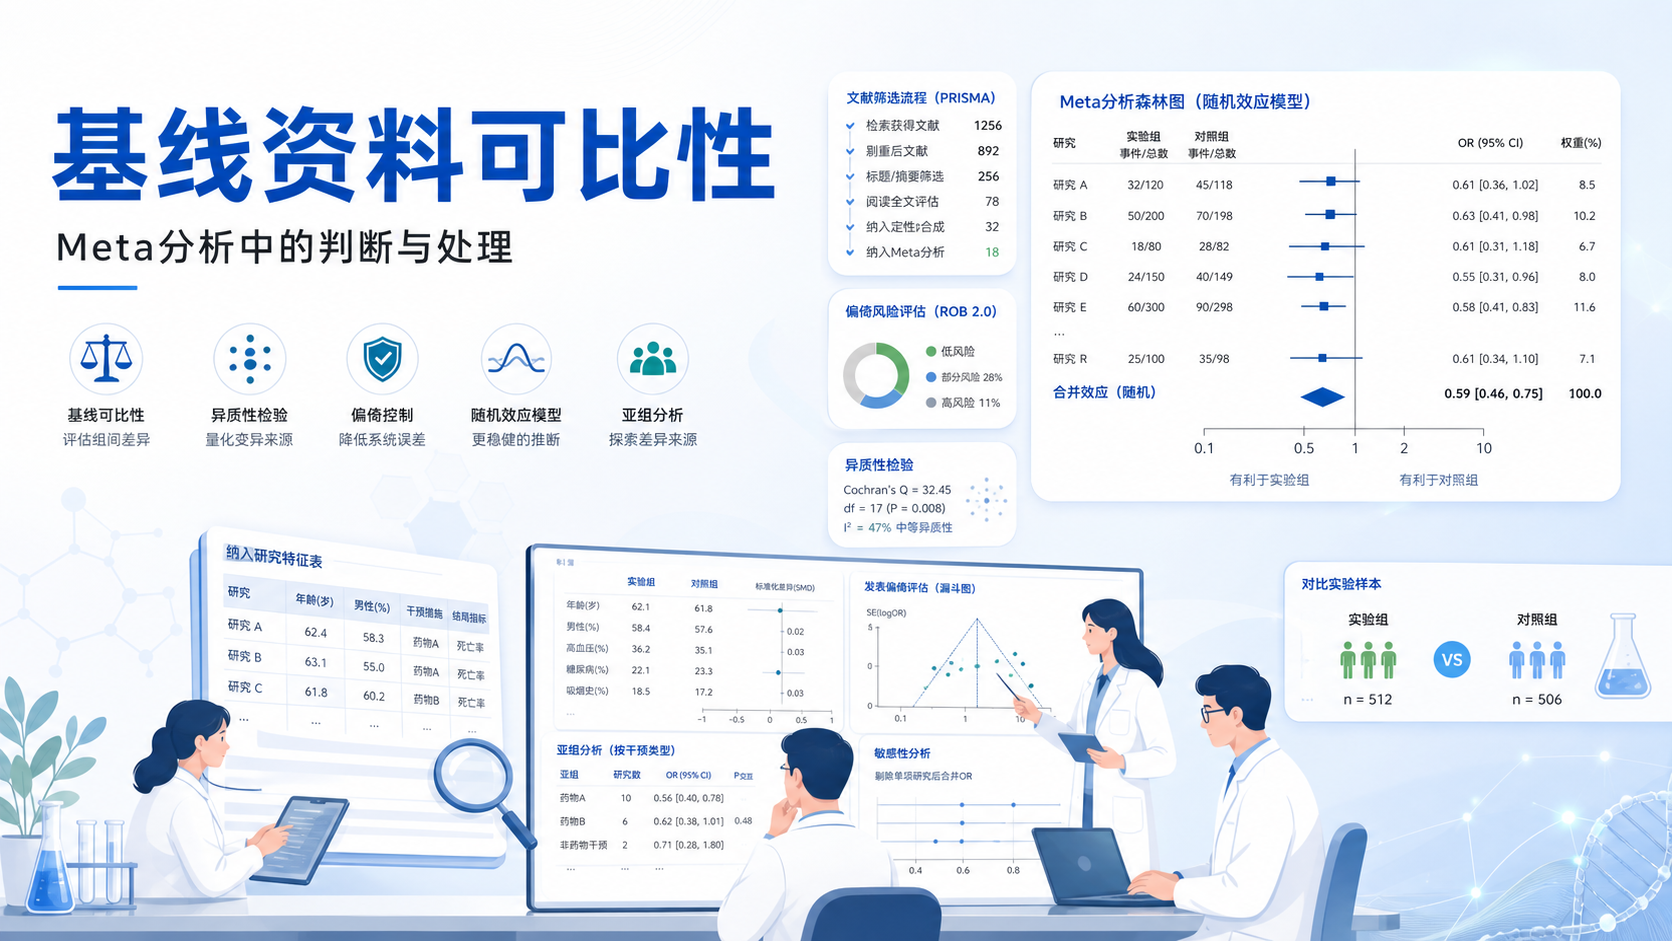
6.1 建议用表格清晰呈现
论文中通常建议设置基线表,列出:
- 作者和年份
- 国家和中心
- 研究类型
- 样本量
- 年龄
- 性别
- 疾病特征
- 干预措施
- 对照措施
- 主要基线指标
表格比文字更利于审稿人快速判断可比性。
6.2 结果描述要客观
可以写成:
- 各研究在年龄、性别及基线疾病严重程度方面差异不大。
- 部分研究在随访时间或样本量上存在差异,但总体可比。
- 某些关键变量报告不完整,限制了均衡性判断。
这类表述比“组间完全均衡”更严谨,也更符合医学论文写作规范。
总结Conclusion
基线资料均衡性检验,是Meta分析中最容易被忽视、却最影响结论可信度的一步。 它不仅关系到研究可比性,也影响异质性判断、亚组分析和最终解释。对医学生、医生和科研人员来说,真正规范的Meta分析,不是简单合并数据,而是先确认研究起点是否一致,再谈结果是否可靠。
如果你正在整理Meta分析数据、搭建基线表、筛查异质性来源,建议使用更规范的工具和模板提高效率。解螺旋 可为你的文献整理、数据提取和科研写作提供支持,帮助你更快完成高质量Meta分析。
- 引言Introduction
- 1. 为什么要做基线资料均衡性检验
- 2. Meta分析中应提取哪些基线资料
- 3. 如何进行基线资料均衡性检验
- 4. 基线均衡性检验在Meta分析中的实际解读
- 5. 基线资料均衡性检验和其他Meta分析环节的关系
- 6. 写作和汇报时,如何规范呈现基线均衡性
- 总结Conclusion