7
 分享
引言Introduction
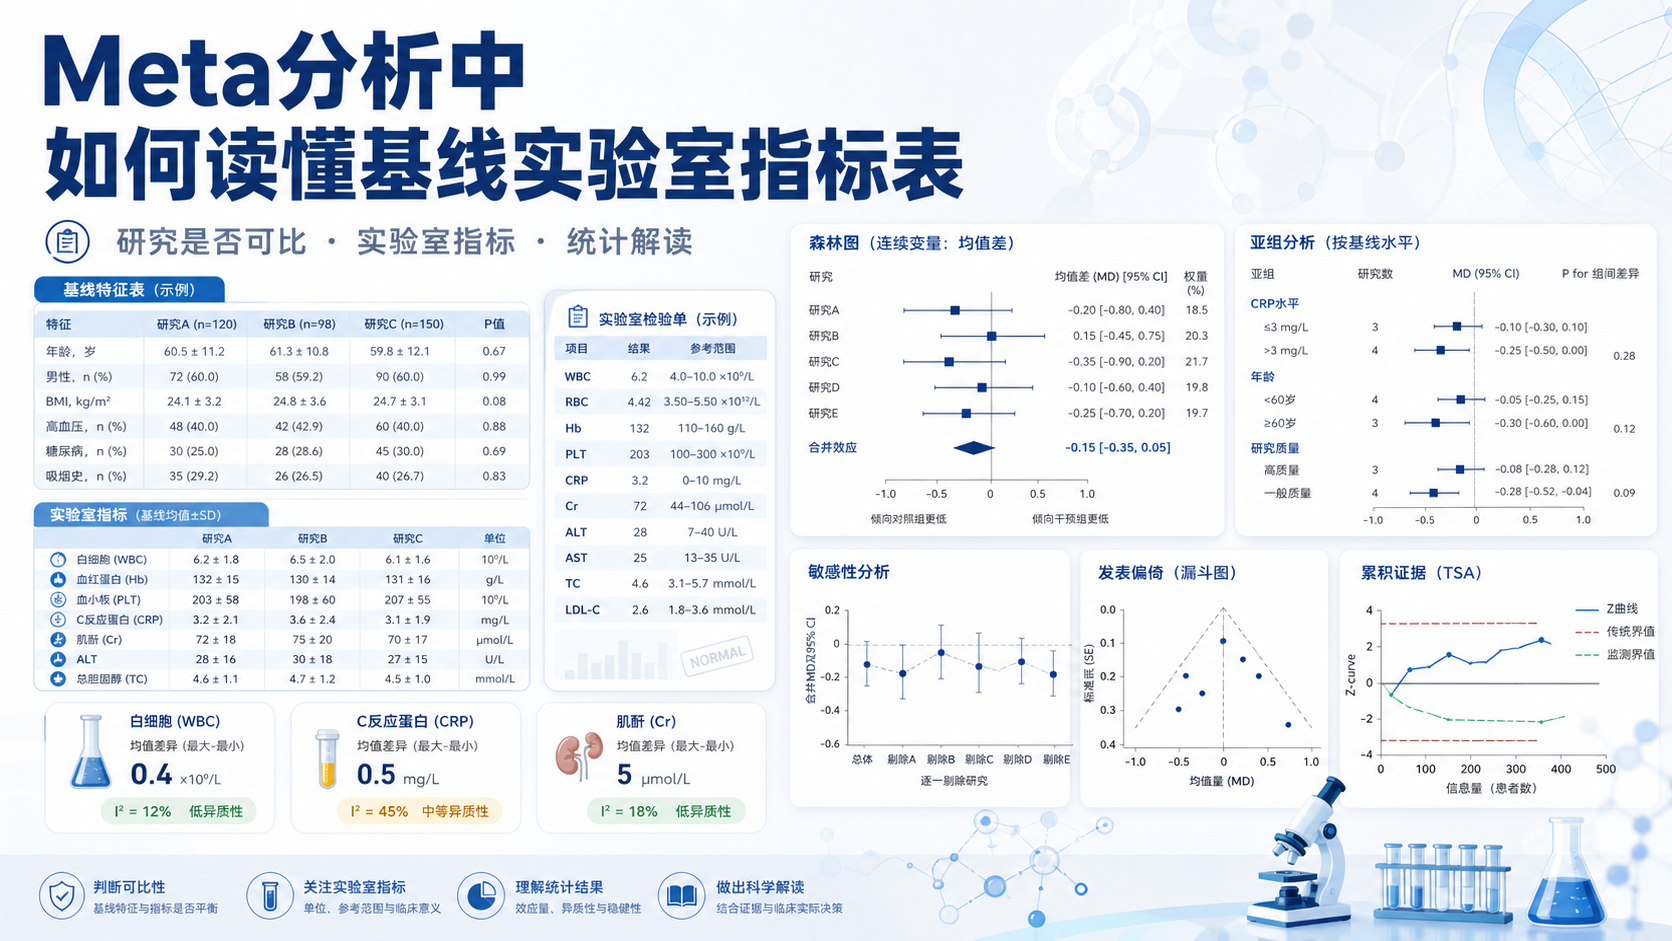
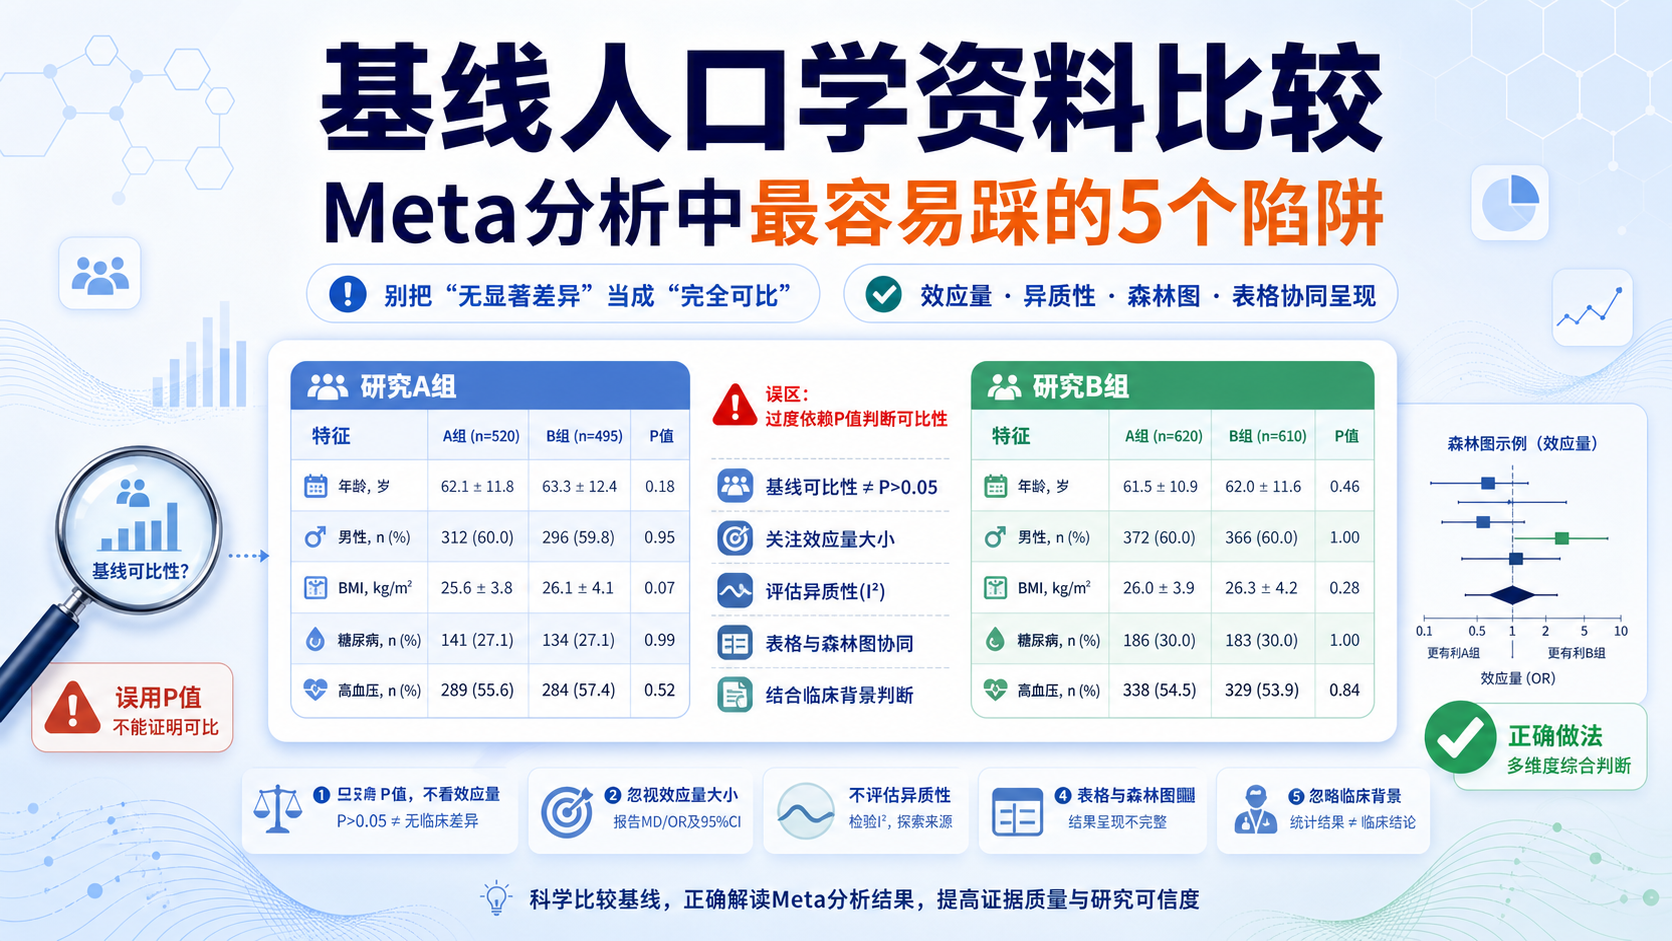
Meta分析里,基线人口学资料比较看似简单,却最容易出错。很多人只会抄表,不会判断“可比性”是否真的成立,导致异质性、偏倚和结论偏差被忽略。基线不是装饰性表格,而是结果可信度的前提。 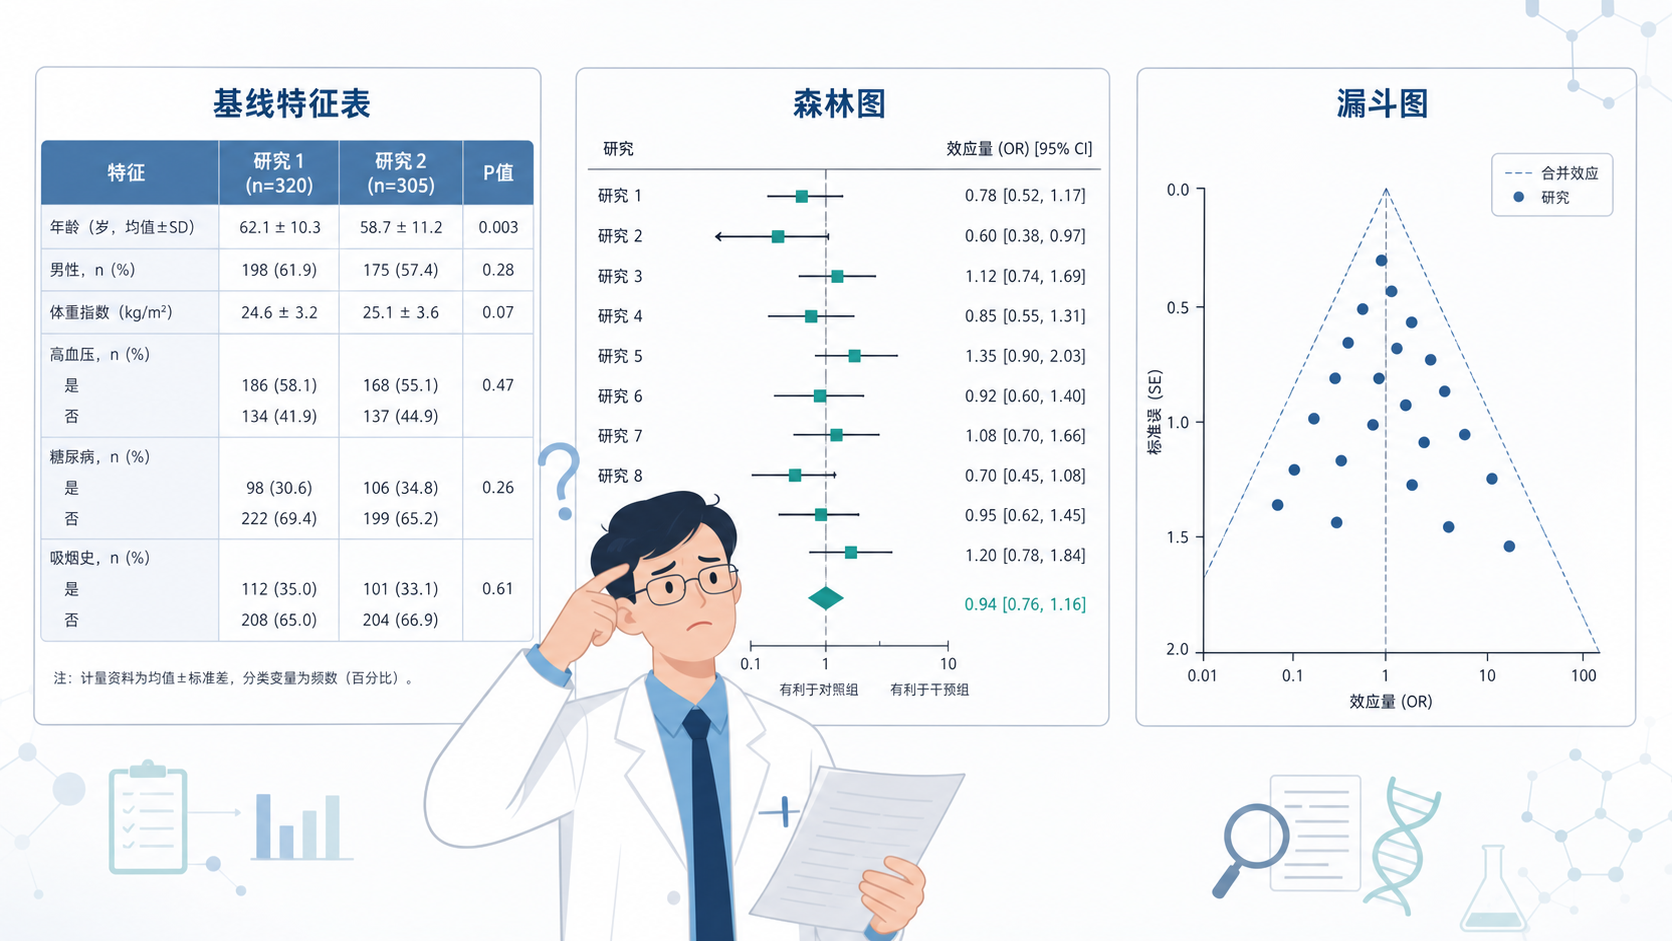
1. 为什么基线人口学资料比较在Meta分析中容易被误用
1.1 先分清“研究内基线”和“研究间基线”
在单个RCT中,基线人口学资料比较的目标,是判断试验组和对照组在干预前是否大体均衡。
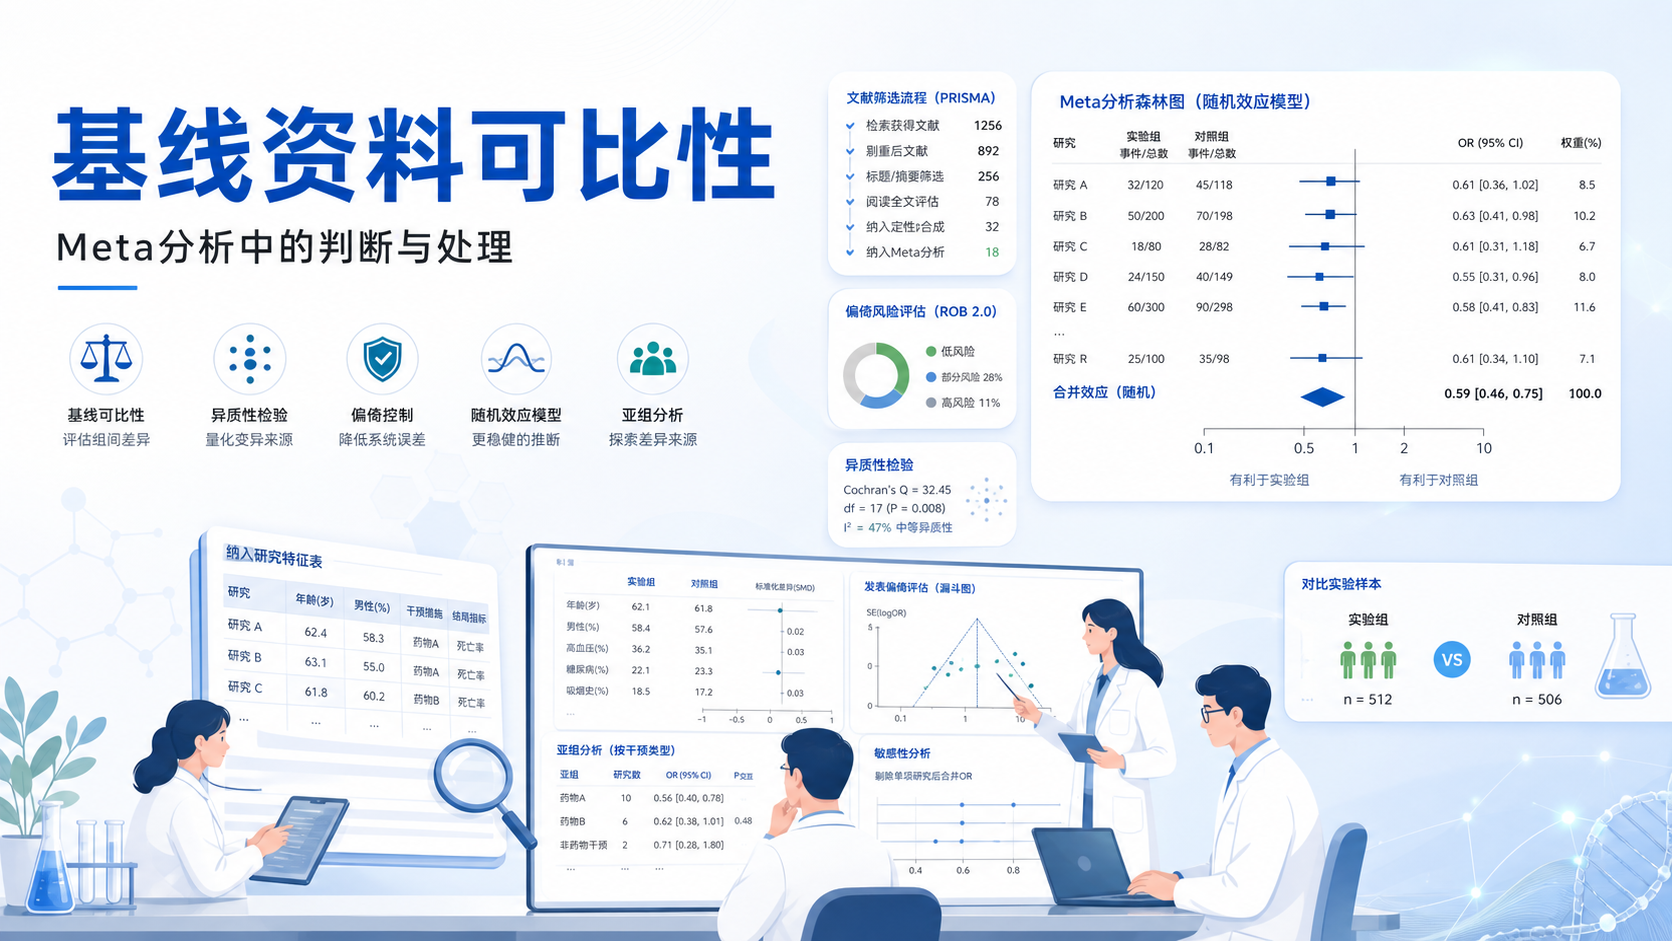
但在Meta分析里,研究对象变成了“多篇研究”。此时比较的重点,不是简单看每篇文章内部是否P>0.05,而是判断纳入研究之间是否存在系统差异。
这两个层面的基线比较,不能混为一谈。
前者服务于单项研究内部的随机化质量,后者服务于合并分析的外部一致性。
1.2 只看P值,常常会得出错误安全感
很多作者会机械地在基线表后面加P值,看到P>0.05就认为“均衡”。这在大样本中并不可靠。
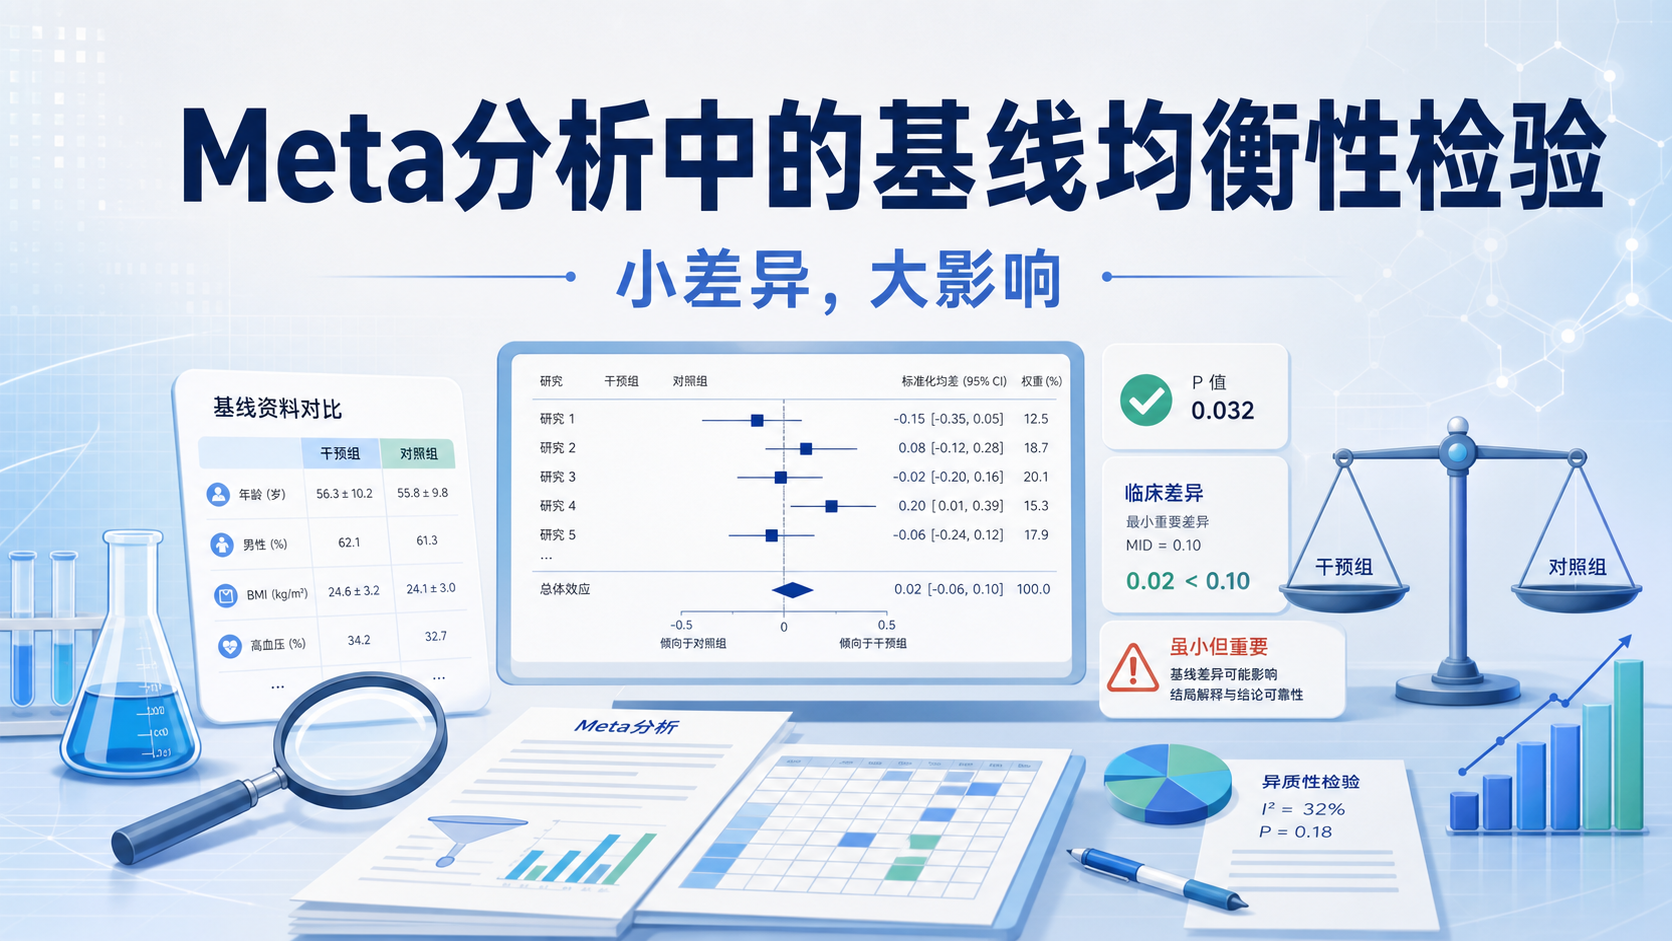
原因很简单,P值受样本量影响很大。样本足够大时,微小差异也可能显著。样本较小时,明显差异也可能不显著。
因此,基线人口学资料比较不能只依赖P值。
更稳妥的做法是结合效应量、标准化差值和临床意义一起判断。
1.3 Meta分析里最常见的误区,是把“无显著差异”当成“完全可比”
这是一个高频陷阱。
即使两组基线没有统计学差异,也不等于完全均衡。
尤其在年龄、病程、疾病严重程度、合并症比例这些变量上,临床上的微小偏差也可能影响结局。
Meta分析更应关注“差异方向”和“差异大小”,而不是只盯着显著性。
如果基线差异与结局高度相关,后续亚组分析、敏感性分析和解释都要更谨慎。
2. 基线人口学资料比较中最容易踩的5个陷阱
2.1 只列变量,不说明来源和口径
不少Meta分析的基线表看起来很完整,但变量定义不统一。
例如“年龄”有的写均数±标准差,有的写中位数和四分位数。
“疾病严重程度”有的按分级,有的按评分,有的直接写“较重”。
这类表格的问题不是“没数据”,而是变量口径不一致,无法真正比较。
如果原始研究定义不同,简单汇总只会增加噪音。
2.2 混淆“总样本量”和“可用样本量”
很多论文会在基线表里写总例数,但实际某些变量有缺失。
比如年龄、BMI、病程、既往史并不一定在所有研究中都完整报告。
如果作者仍按总样本量解读,就会夸大信息完整性。
Meta分析的基线比较必须明确每个变量的分母。
这是判断数据可信度的基础。缺失越多,越不能把表格当成“完整证据”。
2.3 过度依赖组间比较P值
在临床研究中,基线表常见“组间比较P值”。
但在Meta分析中,如果把各研究的基线P值直接拼接,意义很有限。
因为这些P值来自不同研究、不同样本、不同测量方式,不能直接横向解释。
更合理的思路是看:
- 基线是否集中在同一范围。
- 是否存在方向一致的系统偏移。
- 差异是否足以解释结局差异。
换句话说,Meta分析中的基线比较是“质量判断”,不是“统计表演”。
2.4 把类别变量和连续变量一视同仁
这是方法学写作里最常见的错误之一。
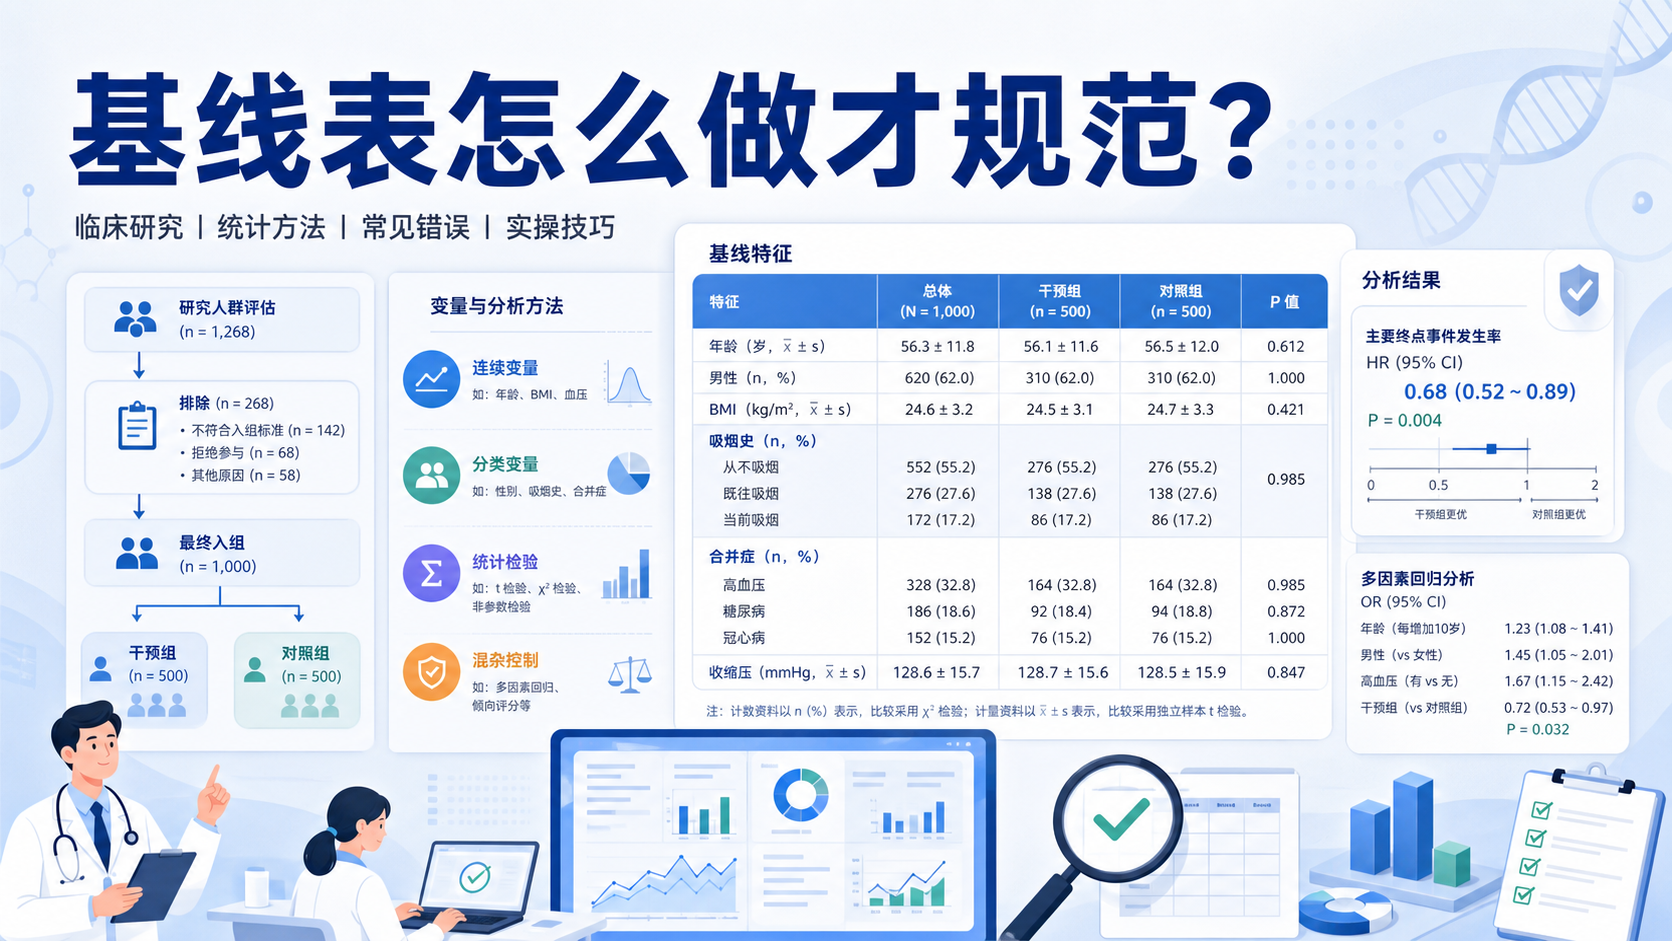
分类变量通常用频数和百分比描述。
连续变量则要看分布,选择均数±标准差或中位数(四分位数间距)。
如果作者把所有变量都粗暴处理成“均值比较”,就容易产生误导。
尤其是年龄、BMI、炎症指标、实验室结果这类数据,分布偏态很常见。
变量类型不同,比较方法就不同。
这不是格式问题,而是统计学前提。
2.5 忽略研究设计差异
随机对照试验、队列研究、病例对照研究、横断面研究的基线结构本来就不同。
如果纳入Meta分析时没有先做设计层面的分层,直接合并比较基线,很容易把设计差异误判为人口学差异。
例如:
- RCT中试验前基线通常更接近均衡。
- 观察性研究中,暴露组和非暴露组常常本来就不均衡。
- 回顾性研究更容易受到选择偏倚影响。
研究设计差异,本身就是基线不一致的重要来源。
3. 更可靠的基线人口学资料比较怎么做
3.1 先统一变量,再谈比较
做Meta分析前,建议先建立变量字典。
把每篇研究中的关键变量统一到同一口径,再进入比较阶段。
这一步看似繁琐,但能显著减少后续误判。
常见统一项包括:
- 年龄。
- 性别比例。
- 样本来源。
- 疾病病程。
- 基线严重程度。
- 主要合并症。
- 干预前关键实验室指标。
统一口径,永远比后期修补更重要。
3.2 优先看效应量,而不是只看显著性
在基线人口学资料比较中,效应量比P值更有解释力。
对于连续变量,可关注均值差或标准化差值。
对于分类变量,可关注比例差异。
在临床研究里,标准化差值常用于衡量组间平衡。
一般认为,绝对值超过0.1,提示不平衡值得关注。
虽然不同领域阈值略有差异,但这个经验判断对筛查问题很有帮助。
3.3 把基线比较和异质性分析联系起来
基线人口学资料比较不是孤立环节。
它和异质性判断、亚组分析、敏感性分析是连在一起的。
如果纳入研究在年龄、病程、疾病类型上差异明显,后续就要警惕:
- 结局效应是否会被混杂。
- 异质性是否来源于基线不一致。
- 是否需要亚组分析或Meta回归。
基线差异越大,后续解释越要保守。
3.4 用森林图和表格协同呈现
基线信息最适合用表格呈现。
但如果研究间差异明显,也可以辅助用森林图展示连续变量或比例差异。
森林图的中线通常代表无效值。
方块代表效应量,横线代表95%CI。
如果CI跨越无效线,提示差异不显著;如果不跨越,则提示统计学差异更明确。
这类图形化展示的价值在于,能让读者快速看到差异分布,而不是只看一串数字。
4. 基线人口学资料比较与常见统计陷阱的边界
4.1 不要把“基线比较”当作结论本身
基线表只是描述研究对象,不是主要结论。
它的任务是告诉读者,这些研究在起点上是否大体可比。
真正的结论来自效应合并、异质性分析和偏倚评估。
基线表只能支持解释,不能替代结果。
4.2 不要忽略发表偏倚和选择偏倚
如果只有基线“更好看”的研究被发表,Meta分析就会高估一致性。
如果纳入标准偏向某类中心或某类人群,基线分布也会被系统扭曲。
这类偏倚往往不会在基线表里直接暴露,但会体现在研究间差异上。
4.3 不要把单篇研究的异常值直接当成规律
有时某一篇研究的年龄特别低,或某一组疾病严重程度特别高。
这不一定代表真实人群特征,也可能是样本量太小、入组标准特殊或数据录入问题。
这时应结合敏感性分析判断。
单篇异常不等于总体趋势。
5. 写作时如何把基线人口学资料比较写得更专业
5.1 推荐的写法顺序
比较稳妥的写法是:
- 先描述纳入研究总体特征。
- 再说明核心人口学变量的分布。
- 接着指出是否存在明显不均衡。
- 最后解释这些差异对结论的潜在影响。
这样写,逻辑清楚,也更符合E-E-A-T要求。
5.2 可直接套用的表达思路
可以写成:
- “纳入研究在年龄、性别和基线疾病严重程度方面总体可比。”
- “部分研究在病程和合并症比例上存在差异,提示存在一定临床异质性。”
- “因此,后续采用亚组分析和敏感性分析进一步验证结果稳定性。”
这类表述比单纯罗列P值更专业,也更符合读者需要。
5.3 解螺旋能帮你把“表格”变成“结论”
很多人卡在基线人口学资料比较,不是不会做表,而是不知道怎么把表格转化为论文语言。
解螺旋提供的研究写作支持,可以帮助你统一变量口径、梳理比较逻辑、优化结果表达。
这样不仅能减少方法学误区,也能让基线比较真正服务于Meta分析主结论。
总结Conclusion
Meta分析中的基线人口学资料比较,核心不是“有没有P值”,而是“研究是否真的可比”。
常见陷阱包括变量口径不一、忽略缺失、过度依赖P值、混淆研究设计,以及把无显著差异误认为完全均衡。
真正专业的做法,是结合效应量、临床意义、异质性和敏感性分析一起判断。
如果你正在整理Meta分析论文,建议先把基线变量统一,再去判断可比性和偏倚风险。
当你希望把复杂的基线比较写得更清楚、更规范时,可以借助解螺旋的专业内容与写作支持,提升论文的准确性和发表竞争力。
- 引言Introduction
- 1. 为什么基线人口学资料比较在Meta分析中容易被误用
- 2. 基线人口学资料比较中最容易踩的5个陷阱
- 3. 更可靠的基线人口学资料比较怎么做
- 4. 基线人口学资料比较与常见统计陷阱的边界
- 5. 写作时如何把基线人口学资料比较写得更专业
- 总结Conclusion