9
 分享
引言Introduction
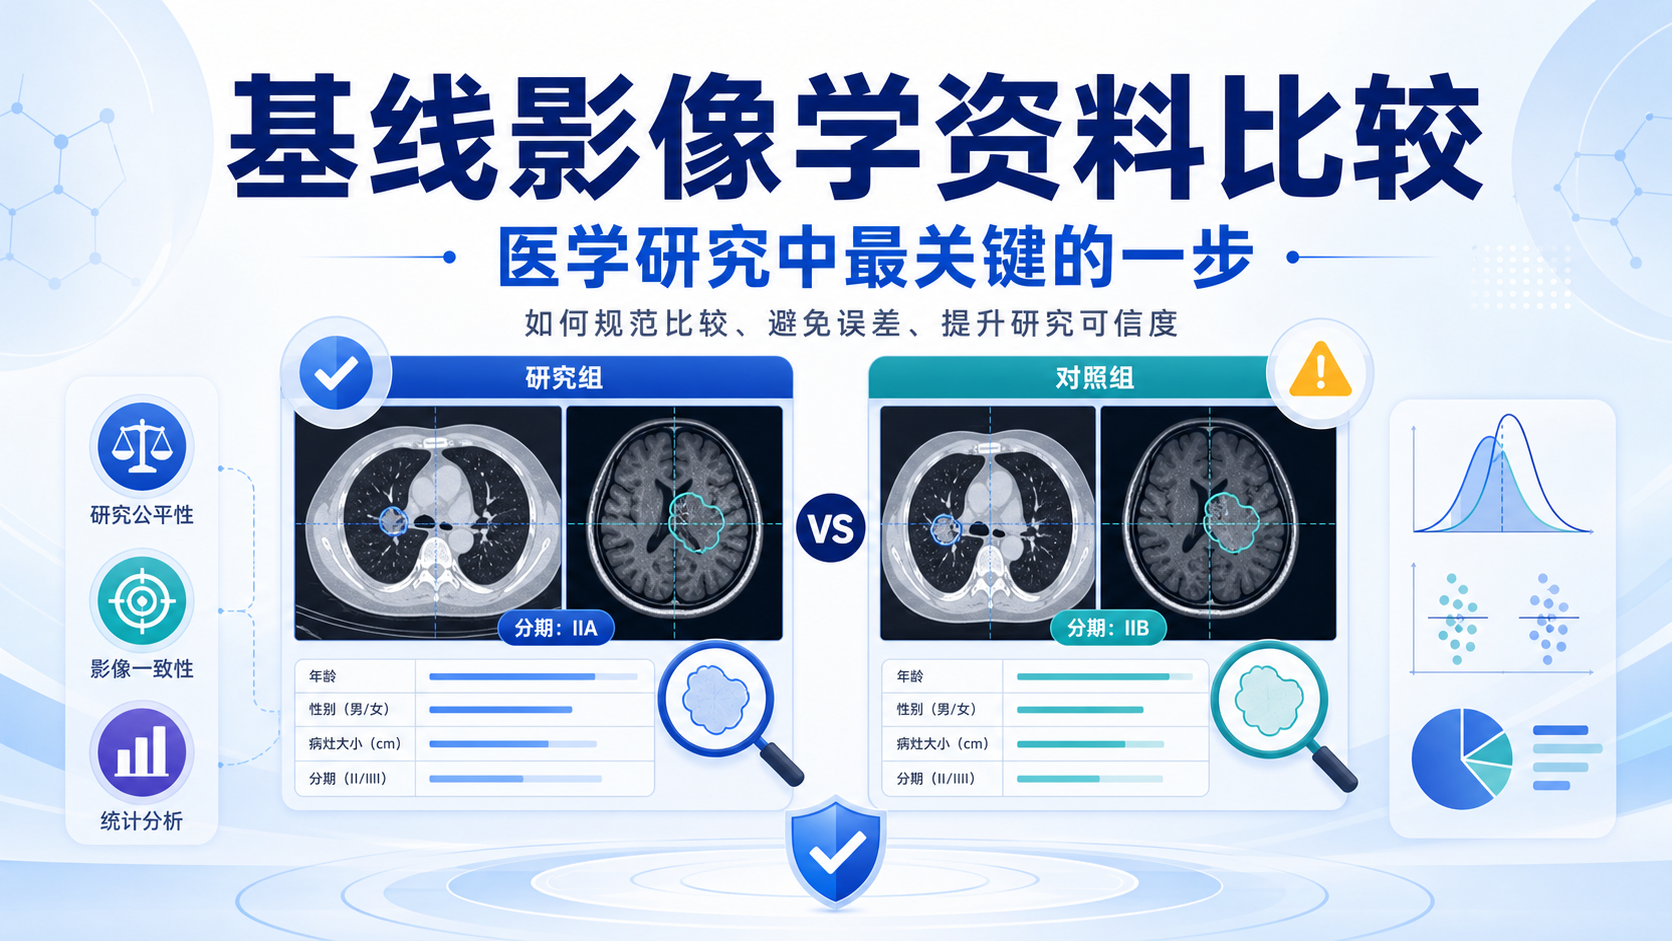
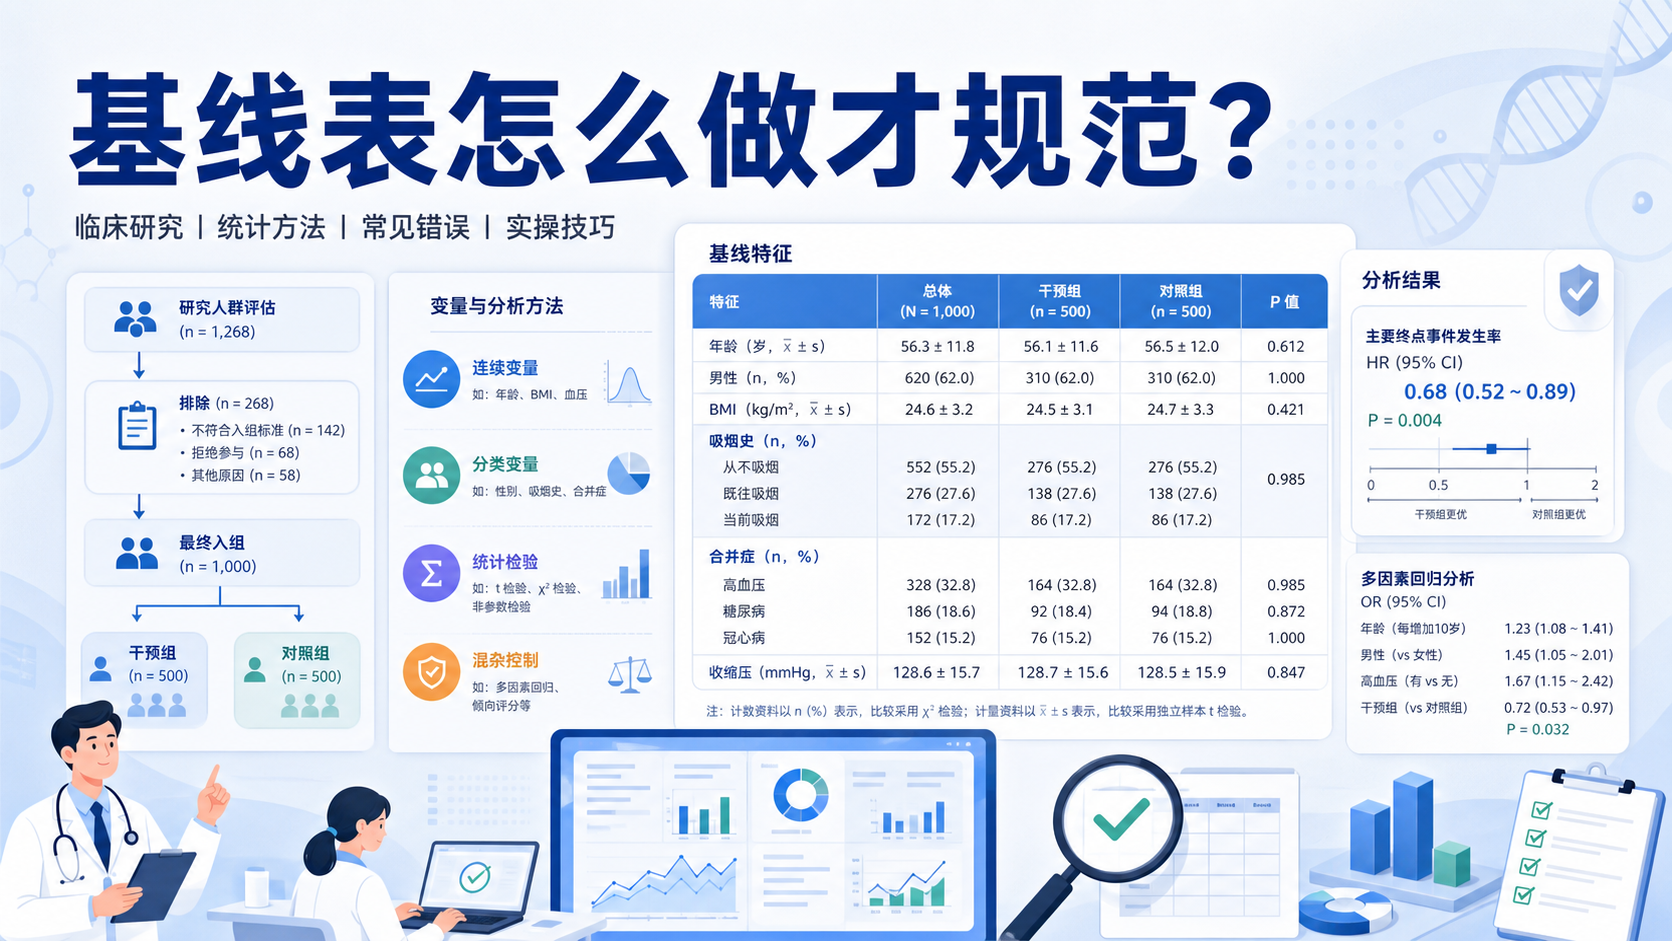
临床研究里,基线表做不好,后面的结果就很难站得住。很多医学生和研究者常见的问题是,变量选不全,分组不对,统计方法也用错了。基线临床资料分析不是简单排表,而是研究设计、变量描述和组间比较的综合体现。
1. 基线表的核心作用是什么
1.1 基线信息决定研究人群是否可比
基线信息,通常指研究对象在干预前或结局发生前的初始状态。对于前瞻性研究,它对应“0”时刻。它的核心价值,不是为了“好看”,而是为了判断组间是否平衡。
在干预性研究中,基线表常用于比较试验组和对照组。在观察性研究中,常按暴露因素分组。回顾性研究则常按病例组和对照组分组。分组逻辑不对,后续单因素和多因素分析的解释就会偏离研究问题。
1.2 基线表包含哪些内容
基线信息通常分两部分。
- 研究人群的纳入和排除过程。
- 研究人群的基线特征描述与比较。
常见变量包括以下几类。
- 社会人口学特征,如年龄、性别。
- 临床特征,如血压、BMI、合并症。
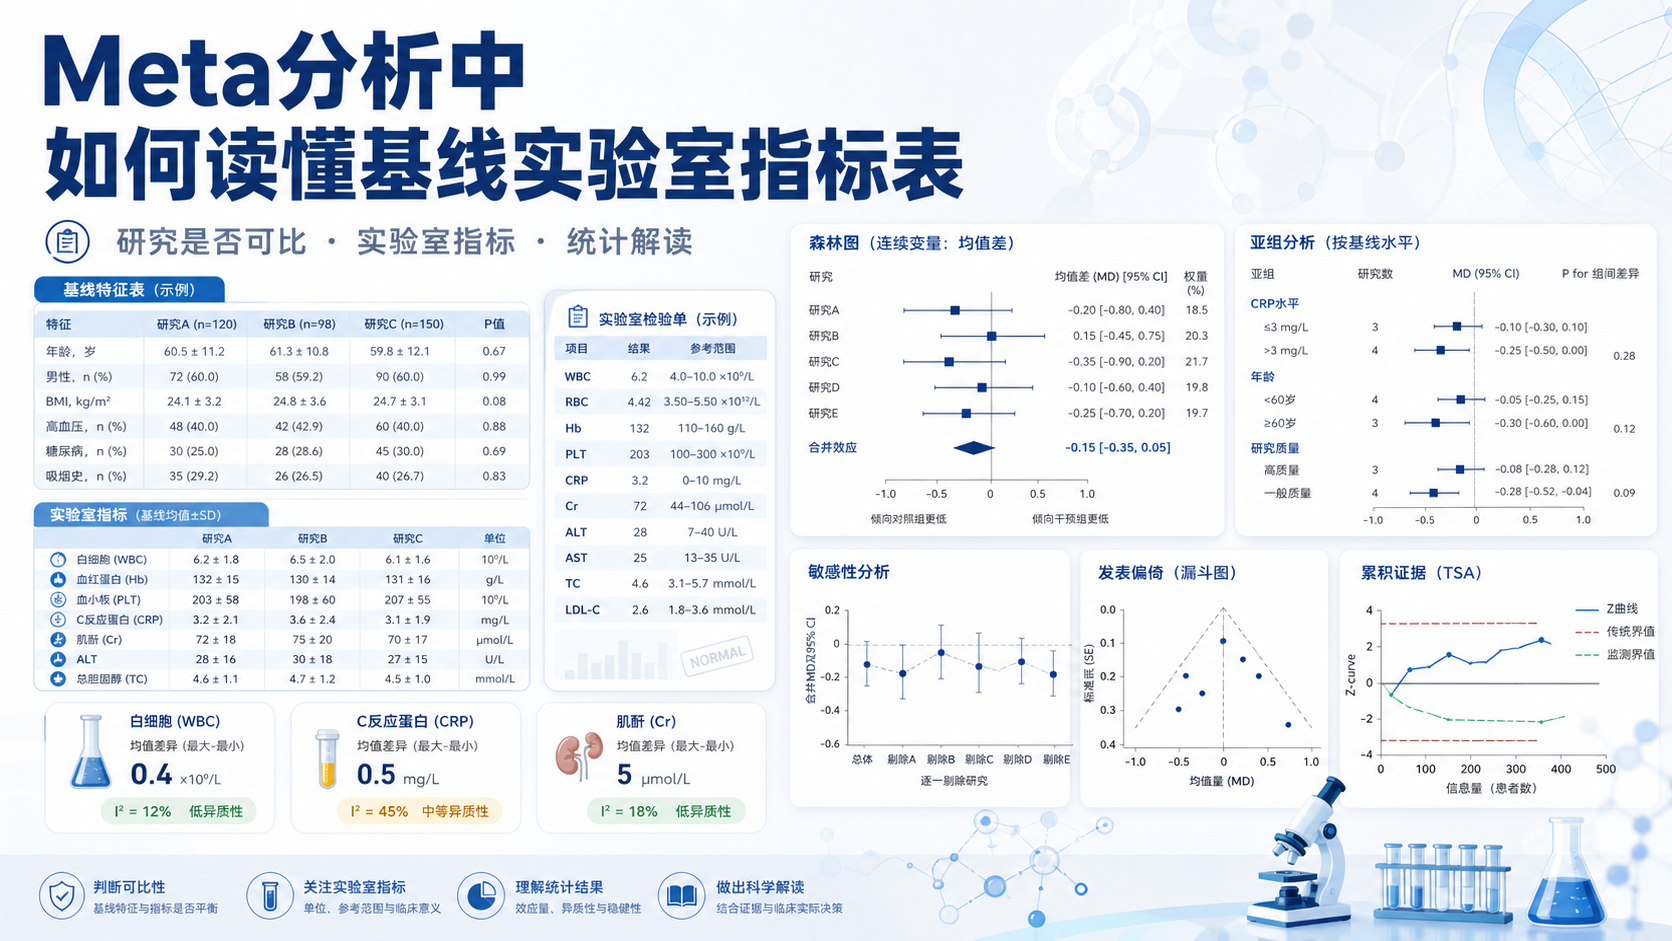
- 实验室指标,如血红蛋白、白细胞、肌酐。
- 疾病史和用药史。
如果变量与研究结局或暴露无关,或者时间上不属于“基线”,就不应硬塞进表1。
2. 基线表怎么搭建才规范
2.1 先做入选排除流程图
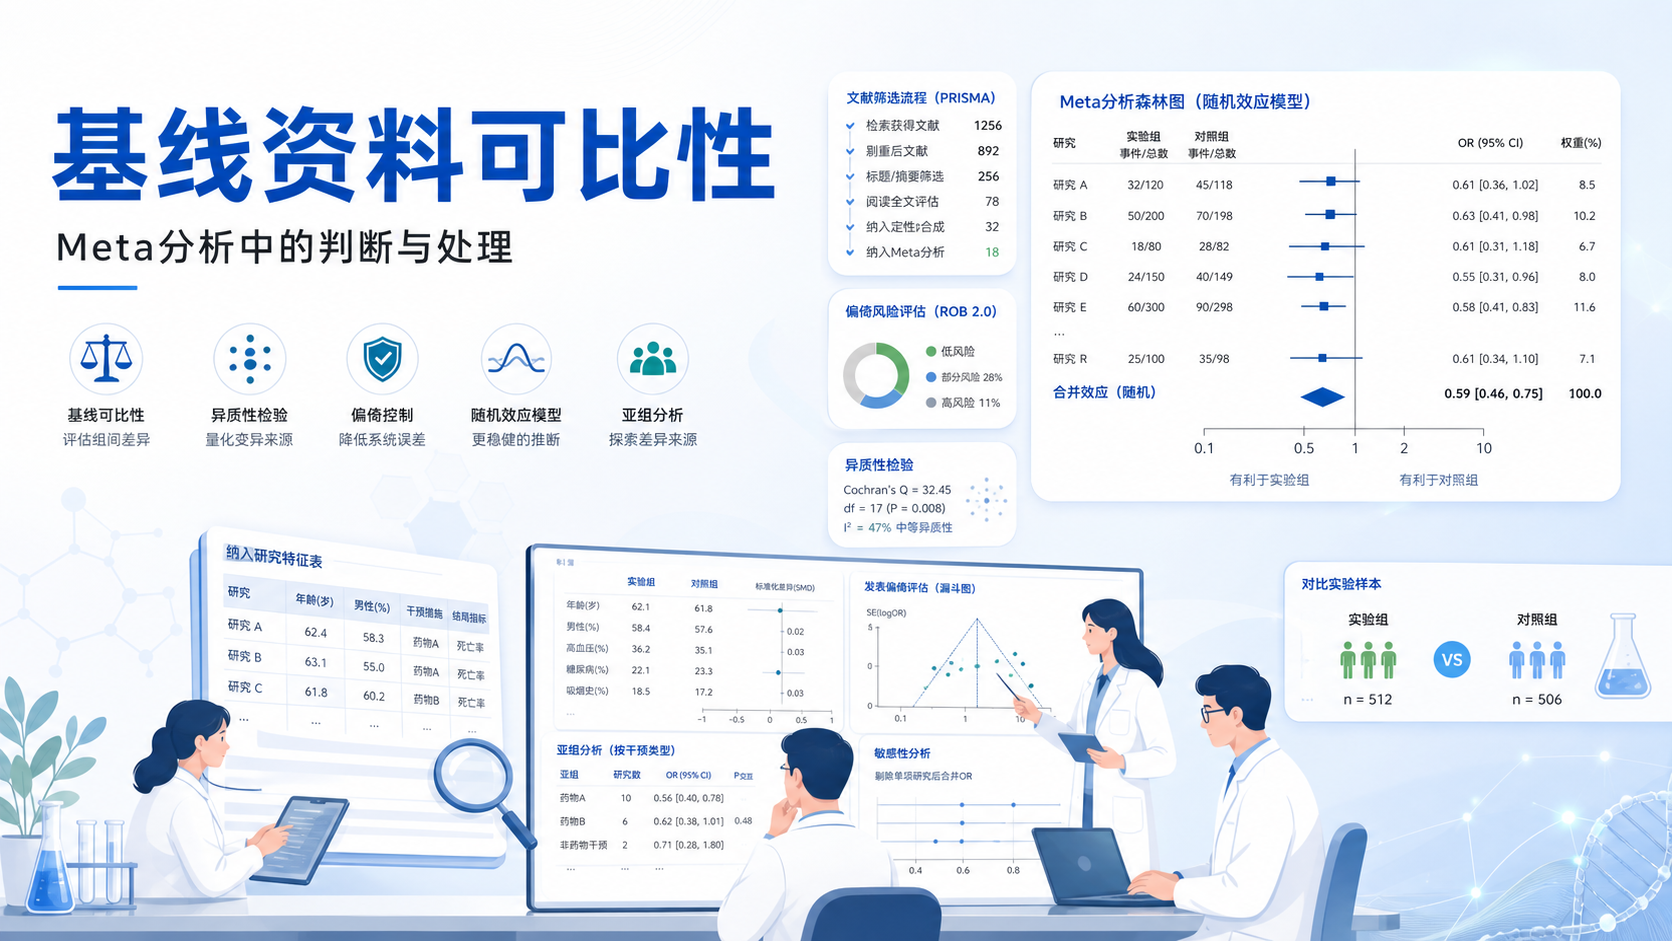
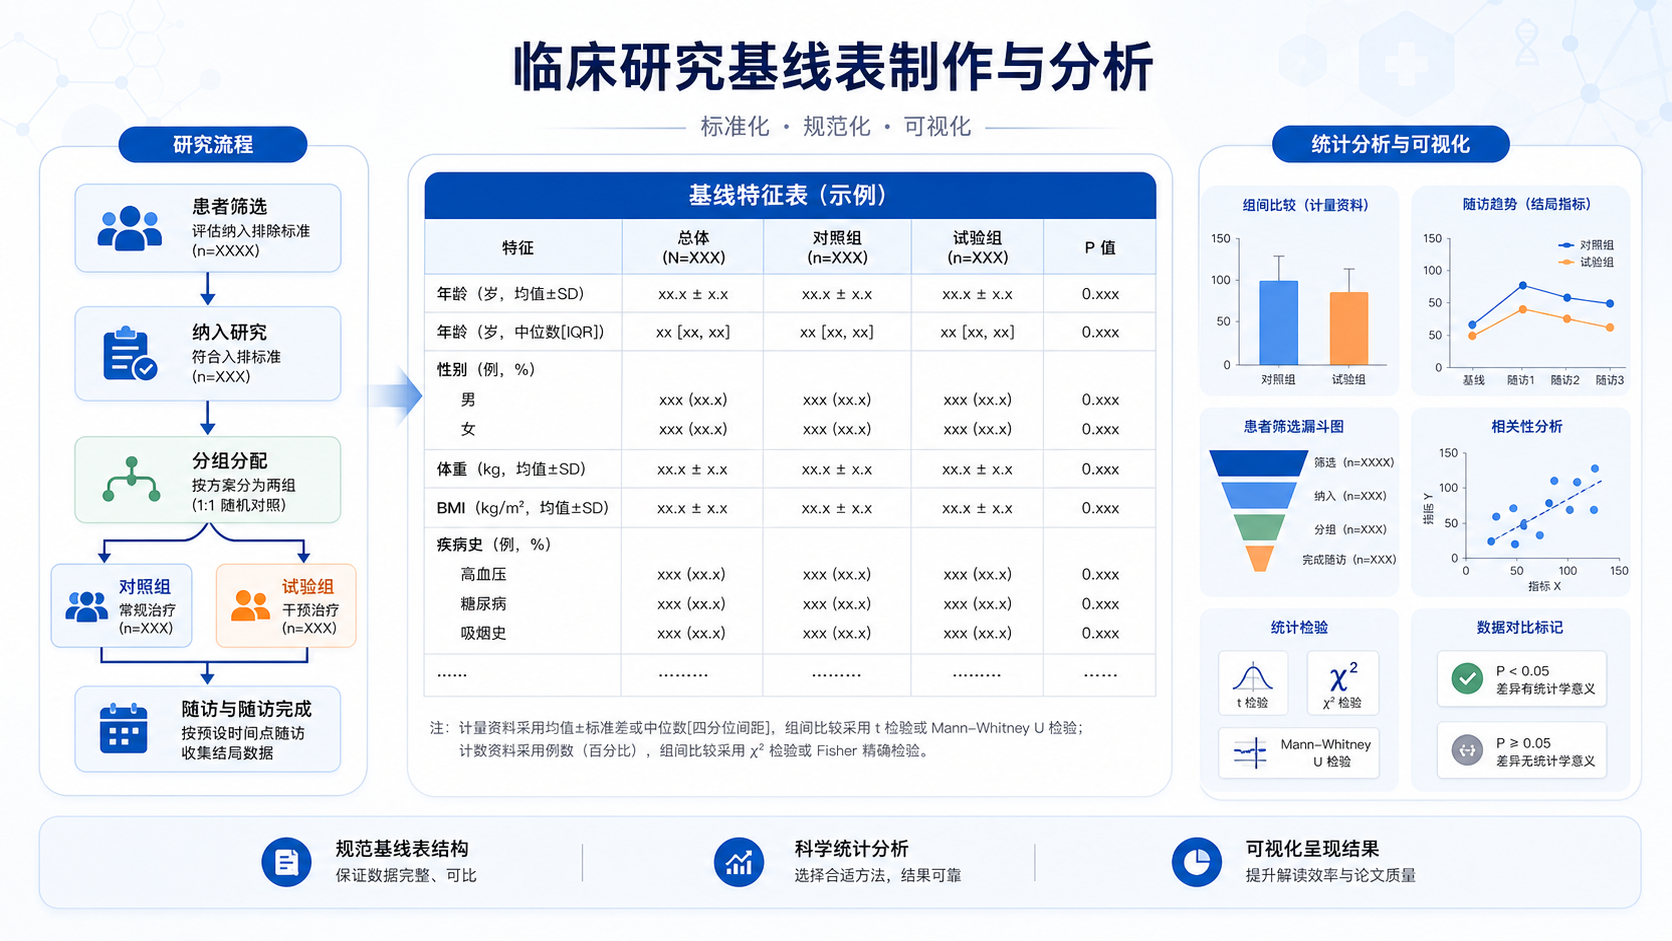
基线表之前,先要把研究对象的筛选过程讲清楚。通常会用流程图展示。写作时建议按层次统计每一步排除人数和百分比。这样可以避免不同排除标准之间交叉重复,导致总人数对不上。
常见写法是:
- 初始筛查人数。
- 排除不符合纳入标准者。
- 排除资料不完整者。
- 排除随访失访者。
- 最终纳入分析人数。
流程图的逻辑要和正文、表格完全一致。 这是很多论文返修时最先被审稿人指出的问题。
2.2 再确定分组方式
不同研究设计,基线表的分组方式不同。
- 干预研究:按试验组、对照组分组。
- 观察性研究:按暴露因素分组。
- 回顾性研究:按结局分组。
- 单组研究:只做描述,不做组间比较。
如果研究本身没有明确分组,就不要为了凑“基线表”而强行分组。
2.3 基线表的标准格式
常见基线表通常包含以下列。
- 变量名称。
- 总体样本。
- 各分组样本。
- 统计量。
- P值,或标准化差值。
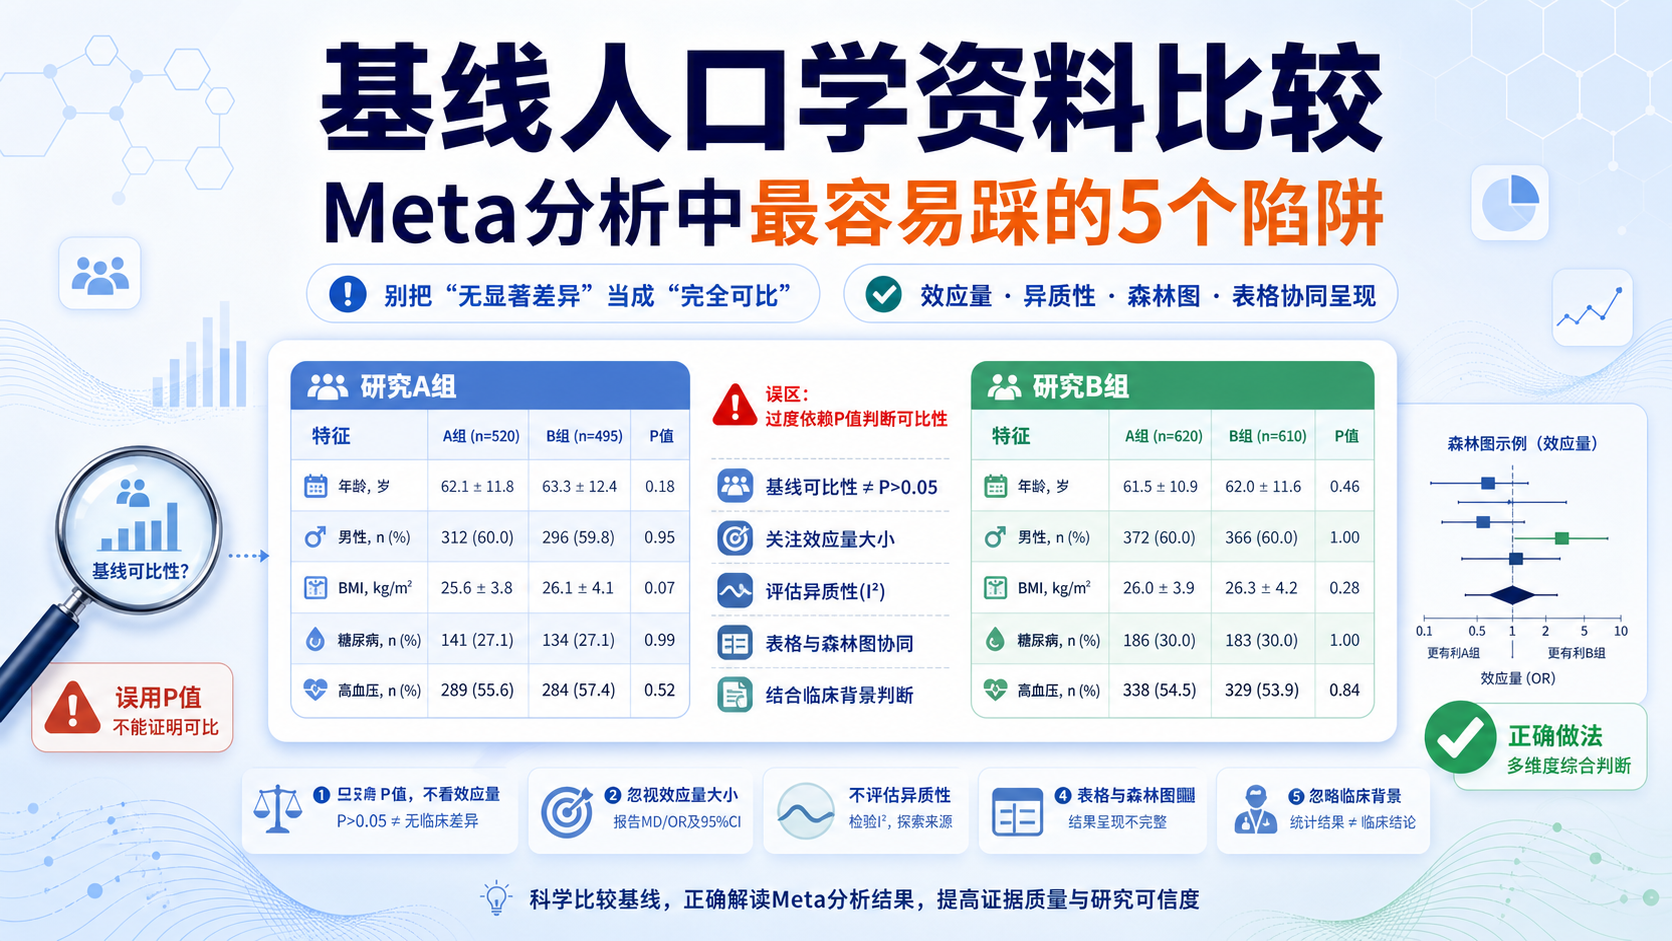
对于随机对照试验,大样本时不一定需要报告P值,更推荐看标准化差值。 这一点在方法学上更稳妥,也更符合平衡性评价的本意。
3. 基线临床资料分析如何选择统计方法
3.1 连续变量和分类变量要分开处理
这是基线临床资料分析中最容易出错的地方。变量类型不同,描述方式就不同。
连续变量常见描述方式有两种。
- 正态分布:均数±标准差。
- 非正态分布:中位数,四分位数间距。
分类变量通常用:
- 频数。
- 百分比。
不要把所有变量统一写成“均数±标准差”。这会直接降低统计可信度。
3.2 组间比较该用什么检验
如果是两组比较,连续变量常用以下方法。
- 正态分布:t检验。
- 非正态分布:Wilcoxon秩和检验。
如果是三组及以上。
- 正态分布:方差分析。
- 非正态分布:Kruskal-Wallis检验。
分类变量常用卡方检验。
单组描述时,只做描述,不做假设检验。
3.3 为什么大样本不建议只看P值
传统做法是用P值判断协变量是否平衡。但在大样本下,哪怕差异很小,也可能出现统计学显著。这样会产生“有统计学意义,但没有实际意义”的问题。
因此,很多高质量研究会进一步看:
- 标准化差值。
- Hodges-Lehmann估计数。
其中,标准化差值绝对值超过10,通常提示组间差异较大。它比单纯P值更适合评价基线平衡。
4. 单因素分析和多因素分析怎么接到基线表后面
4.1 单因素分析的目的不是“显著性堆叠”
很多研究者把单因素分析当成筛变量工具,但这并不等于研究结论本身。单因素分析的价值在于初步识别与结局相关的变量,为后续多因素建模提供依据。
常见单因素分析包括:
- 单因素卡方分析。
- 单因素Cox回归。
- 单因素Logistic回归。
- 单因素相关性分析。
单因素结果只能说明“相关”,不能说明“独立影响因素”。
4.2 多因素分析用于控制混杂
多因素分析的核心作用,是在同时纳入多个变量后,判断某个变量是否仍然与结局独立相关。常见模型包括:
- Logistic回归,用于二分类结局。
- Cox回归,用于生存结局。
- 线性回归,用于连续结局。
在建模时,变量纳入通常要结合三点。
- 临床意义。
- 文献证据。
- 单因素分析结果。
不要只按P值筛变量。临床意义优先级往往高于统计筛选。
4.3 常见建模原则
建模时建议注意以下几点。
- 自变量不要过多,避免过拟合。
- 共线性变量不要同时纳入。
- 连续变量优先保留原始形式,必要时再分类。
- 样本量不足时,谨慎加入过多协变量。
对于临床研究,常见经验是事件数不足时,多因素模型不宜过度复杂。模型越复杂,不一定越好,关键是稳定和可解释。
5. 基线表制作时最常见的错误
5.1 变量选择不合理
有些文章把治疗后指标放进基线表,这是明显错误。基线表只能体现干预前状态。还有些文章把与研究问题无关的变量全部塞进去,导致表格冗长,重点不突出。
5.2 分组逻辑混乱
同一篇文章里,流程图按一种分组,表1按另一种分组,正文分析又换一种分组,这会让读者无法理解研究设计。所有表格和正文必须使用统一逻辑。
5.3 统计方法与变量类型不匹配
常见错误包括:
- 非正态连续变量仍用均数±标准差。
- 多组比较却只做两组t检验。
- 分类变量样本太少却直接套用卡方检验。
- 结局是时间事件,却误用普通Logistic回归。
方法错了,表再漂亮也没有意义。
5.4 忽略软件输出后的人工核对
无论用 SPSS、SAS、R 还是 Stata,生成表格后都要人工检查。
重点核对:
- 样本数是否一致。
- 缺失值是否处理正确。
- 百分比是否以同一分母计算。
- P值是否对应正确检验。
- 小数点位数是否统一。
6. 实操时可以怎么提高效率
6.1 先整理数据,再做表格
推荐顺序是:
- 明确变量字典。
- 统一编码。
- 处理缺失值。
- 区分连续变量和分类变量。
- 选择统计方法。
- 输出基线表。
先整理数据,再做分析,是避免返工的关键。
6.2 常用工具怎么选
临床研究中,常用工具包括 SPSS、SAS、R 和 Stata。不同工具各有优劣。
- SPSS:操作直观,适合入门。
- SAS:适合规范化批量分析。
- R:可重复性强,适合科研工作流。
- Stata:在流行病学和临床研究中应用广。
如果要同时兼顾效率和规范性,可以借助专业化工具完成流程图、基线表和回归分析的联动处理。像解螺旋这类科研工具平台,能帮助研究者更快完成数据整理、基线表输出和单因素、多因素分析,减少重复劳动,把更多时间留给研究设计和结果解释。
总结Conclusion
临床研究基线表不是简单的“表1”。它连接了研究对象筛选、变量描述、组间比较和后续建模。真正规范的基线临床资料分析,必须做到变量选对、分组合理、统计方法匹配、结果可解释。
如果你正在准备论文或课题,建议先从数据整理和变量定义开始,再按研究设计完成基线表、单因素分析和多因素分析。这样能显著减少返工,提高论文质量。若你希望进一步提升制表和统计效率,可以尝试使用解螺旋 ,把基线表和回归分析流程做得更稳、更快、更规范。
- 引言Introduction
- 1. 基线表的核心作用是什么
- 2. 基线表怎么搭建才规范
- 3. 基线临床资料分析如何选择统计方法
- 4. 单因素分析和多因素分析怎么接到基线表后面
- 5. 基线表制作时最常见的错误
- 6. 实操时可以怎么提高效率
- 总结Conclusion