10
 分享
引言Introduction
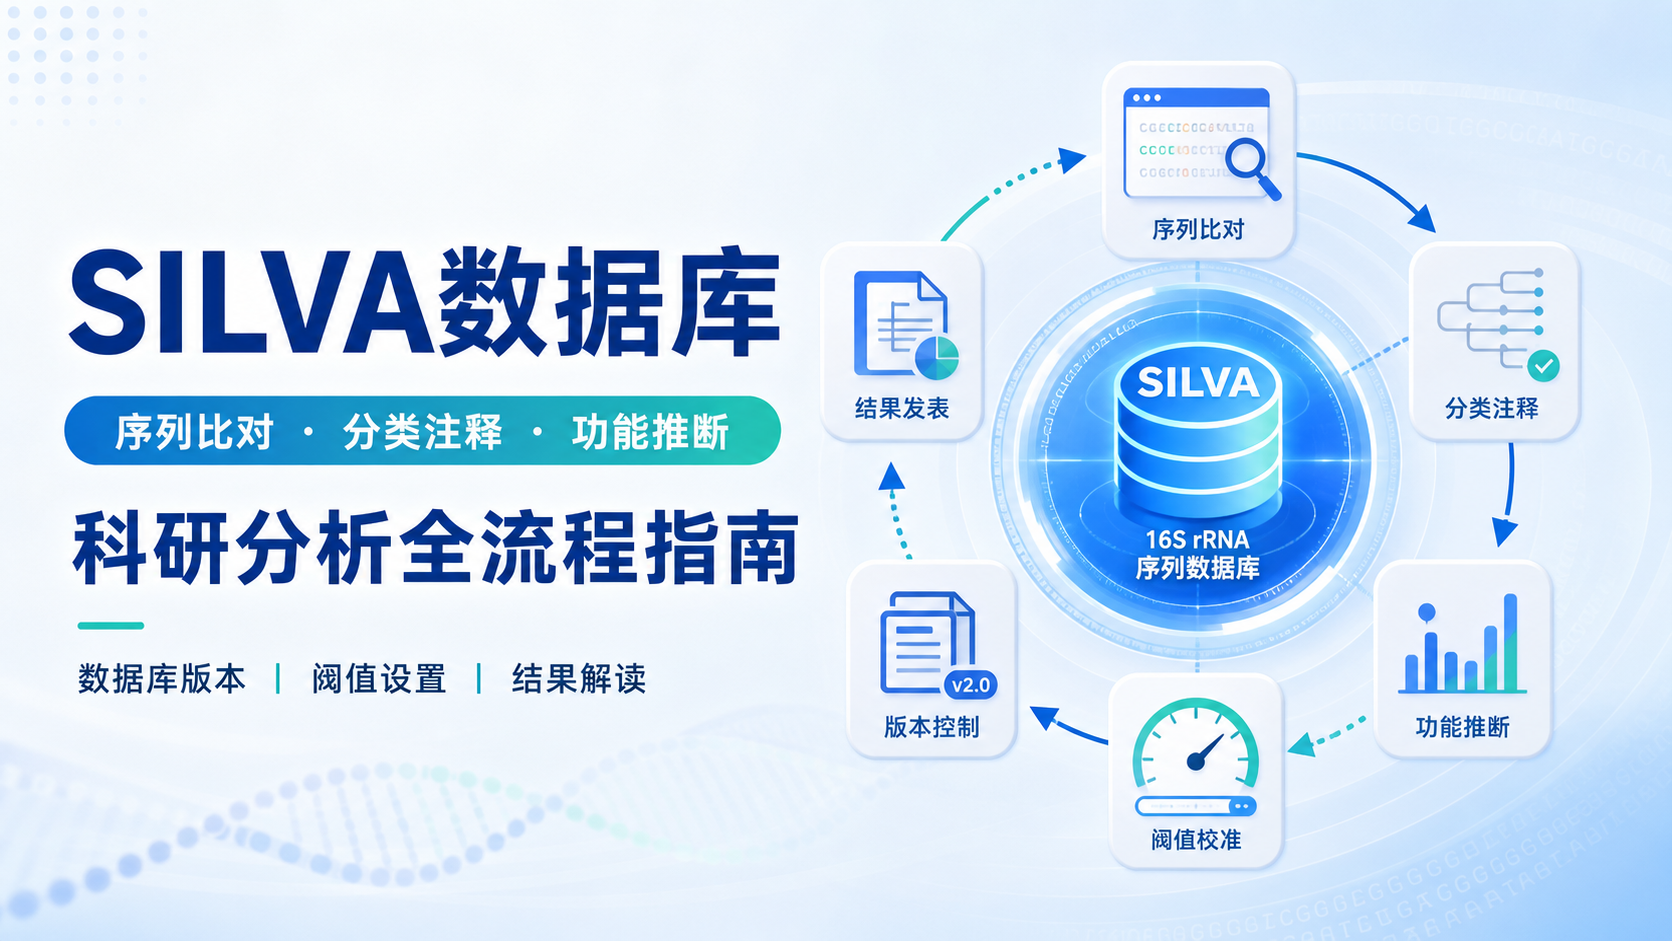
SILVA数据库是16S、18S和23S/28S rRNA研究中最常用的参考资源之一。但很多人只会“拿来比对”,却不清楚它的分类体系、比对逻辑和后续注释流程。如果参考库选错,后面的物种注释和群落分析都会偏。 
1. 什么是SILVA数据库
1.1 SILVA的核心定位
SILVA是一个专门收录核糖体RNA序列的高质量数据库,重点覆盖细菌、古菌和真核生物的rRNA参考序列。它最常见的用途,是用于扩增子测序中的分类注释,也常用于环境微生物、肠道菌群和生态样本分析。
对医学生、医生和科研人员来说,SILVA最重要的价值不是“有很多序列”,而是它提供了相对统一、可追溯的分类参考。 这对减少注释偏差非常关键。
1.2 与其他数据库的区别
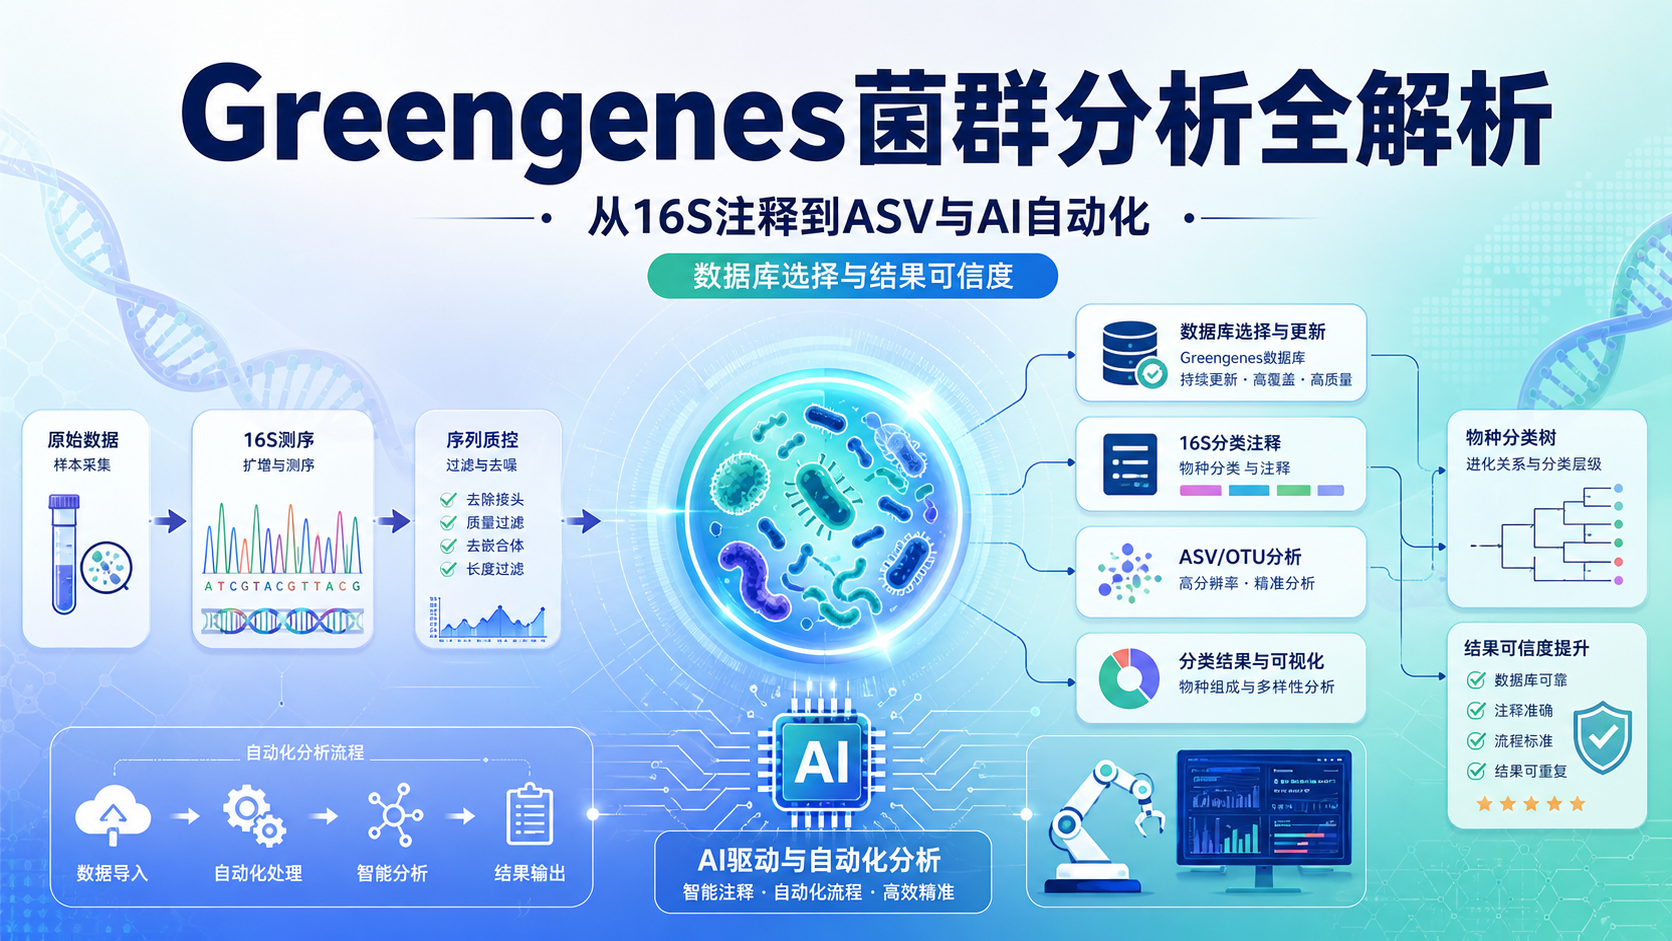
在微生物分类注释中,常见参考库还有Greengenes和RDP。相比之下,SILVA的更新频率更高,覆盖范围更广,尤其适合需要较新分类体系的项目。
可以简单理解为:
- Greengenes适合部分旧流程和历史数据对比。
- RDP适合快速注释和教学场景。
- SILVA更适合当前主流的高通量测序分析。
对于16S rRNA数据,SILVA通常是优先选择之一。对于18S和部分真核rRNA分析,它的优势也很明显。
1.3 为什么它适合科研分析
SILVA的优势主要体现在三点:
- 序列收录广。
- 分类信息完整。
- 更新持续,适合跟进最新研究。
但也要注意,数据库再好,也不能替代实验设计和质控。 如果扩增区域选择不当,或者测序质量差,再好的参考库也难以挽救结果。
2. 从序列比对开始:SILVA如何参与注释
2.1 先明确输入数据是什么
使用SILVA之前,先要知道你的输入是哪类序列。常见情况包括:
- 16S rRNA扩增子序列。
- 18S rRNA真核扩增子序列。
- 23S/28S相关序列。
- 经过去噪后的ASV或OTU表。
SILVA不是原始测序文件的替代品,而是比对和分类注释的参考框架。 换句话说,先做好质控、去噪和特征提取,再进入数据库比对。
2.2 序列比对的基本逻辑
比对的核心,是把待分析序列与SILVA参考序列进行相似性匹配,再根据最佳匹配结果赋予分类学标签。这个过程通常包括:
- 序列清洗。
- 去除低质量reads。
- 构建或调用参考库。
- 执行比对。
- 生成分类结果。
在实际分析中,常见工具包括QIIME 2、mothur、DADA2配套流程,以及基于BLAST或VSEARCH的比对方法。工具不同,但底层思路一致,都是“参考库驱动的分类推断”。
2.3 比对时最容易出错的地方
常见问题有四类:
- 参考库版本混用。
- 扩增区域与数据库训练区间不一致。
- 序列长度过短,导致分类分辨率下降。
- 过滤过严或过松,影响有效注释比例。
比如,若你的V3-V4区域数据只覆盖部分可变区,往往只能稳定到属级,甚至部分只能到科级。想得到物种级注释,不能只依赖数据库,还要看扩增片段本身是否支持。
3. 从分类注释到功能推断
3.1 先分清“分类注释”和“功能注释”
这是很多初学者最容易混淆的地方。SILVA本身是rRNA分类数据库 ,它的直接作用是做分类注释,不是直接给出代谢通路或基因功能。
也就是说:
- SILVA能告诉你“这条序列更像哪个类群”。
- SILVA不能直接等同于“这个菌有什么功能”。
功能注释通常需要进一步结合PICRUSt、Tax4Fun、FAPROTAX等工具。 这些工具会基于SILVA得到的分类结果,去推断潜在功能。
3.2 功能推断的前提条件
功能注释不是凭空生成的,它依赖于分类结果质量。常见前提包括:
- ASV/OTU注释要尽量准确。
- 分类层级越细,功能推断越稳。
- 参考基因组覆盖越好,预测越可靠。
如果样本中存在大量未注释类群,或者注释仅停留在门水平,后续功能预测的可信度就会下降。所以,SILVA是功能推断的起点,不是终点。
3.3 医学和科研中常见的应用场景
SILVA参与的下游分析,常见于:
- 肠道菌群与疾病关联研究。
- 感染相关微生态分析。
- 环境暴露与微生物变化研究。
- 免疫、代谢和炎症相关队列分析。
例如,在肠道菌群项目中,研究者常先用SILVA完成分类注释,再结合差异丰度分析和功能预测,观察不同组别在菌群组成和潜在代谢能力上的变化。这条链路已经是微生物组研究中的标准思路。
4. 实战流程中需要注意的关键点
4.1 数据库版本要固定
做科研最怕“版本漂移”。同一个项目里,如果参考库前后不一致,分类结果可能出现系统性差异。尤其在投稿、复现和多中心研究中,数据库版本必须写清楚。
建议记录以下信息:
- SILVA版本号。
- 使用的软件和参数。
- 比对方法。
- 分类阈值。
- 过滤标准。
这不是流程习惯,而是可重复性要求。
4.2 阈值设置要合理
不同项目的阈值不应机械套用。常见做法是根据序列长度、测序平台和研究目标调整分类置信度门槛。阈值过高,可能导致大量序列无法注释。阈值过低,又会引入误注释。
因此,分析前最好先做小规模测试,比较不同参数下的注释率和一致性,再确定正式流程。
4.3 不要把“高注释率”直接等同于“高准确率”
注释率高,不代表结果一定可信。尤其在复杂样本中,很多序列可能被粗略分到较高层级,但这并不意味着下游解释完全成立。
建议同时关注:
- 分类层级分布。
- 未注释比例。
- 优势菌是否符合生物学背景。
- 结果与文献是否一致。
真正可靠的分析,不是看“注释了多少”,而是看“注释得是否合理”。
5. 如何把SILVA流程落到可发表的结果
5.1 标准分析链条
一个规范的SILVA分析链条通常是:
- 原始数据质控。
- 去噪或聚类得到ASV/OTU。
- 使用SILVA进行分类注释。
- 整理丰度表和分类表。
- 进行差异分析、Alpha/Beta多样性分析。
- 进一步开展功能推断或临床关联分析。
只有把每一步都写清楚,结果才具备发表和复现价值。
5.2 结果展示建议
在论文或汇报中,建议重点展示:
- 分类组成堆叠图。
- 门、属水平丰度差异。
- 物种热图。
- PCoA或NMDS分群。
- 差异菌火山图或LEfSe图。
如果涉及功能预测,还可以补充:
- 代谢通路差异图。
- 功能类别富集图。
- 与临床指标的相关性分析。
这些图表能帮助审稿人快速判断你的分析是否完整。
5.3 常见写作要点
方法学部分建议明确写出:
- 使用的SILVA版本。
- 注释软件和参数。
- 分类置信度阈值。
- 是否过滤低丰度特征。
- 是否剔除污染和线粒体、叶绿体序列。
这些细节往往决定方法学是否过关。
总结Conclusion
SILVA数据库的价值,在于它为rRNA序列提供了稳定、广泛、可追溯的分类参考。它本质上解决的是“序列属于谁”的问题,而功能注释则需要在分类结果基础上进一步推断。对于医学生、医生和科研人员来说,掌握SILVA的正确用法,意味着你能更规范地完成微生物组分析,也能更稳妥地解释结果。
如果你希望把SILVA分析流程真正落到项目中,减少版本选择、参数设置和结果整理的反复试错,可以结合专业工具和标准化模板来提高效率。解螺旋 可以帮助你把数据库注释、结果整理和科研表达串成一条完整链路,让分析更快、更稳、更接近可发表标准。
- 引言Introduction
- 1. 什么是SILVA数据库
- 2. 从序列比对开始:SILVA如何参与注释
- 3. 从分类注释到功能推断
- 4. 实战流程中需要注意的关键点
- 5. 如何把SILVA流程落到可发表的结果
- 总结Conclusion