9
 分享
引言Introduction
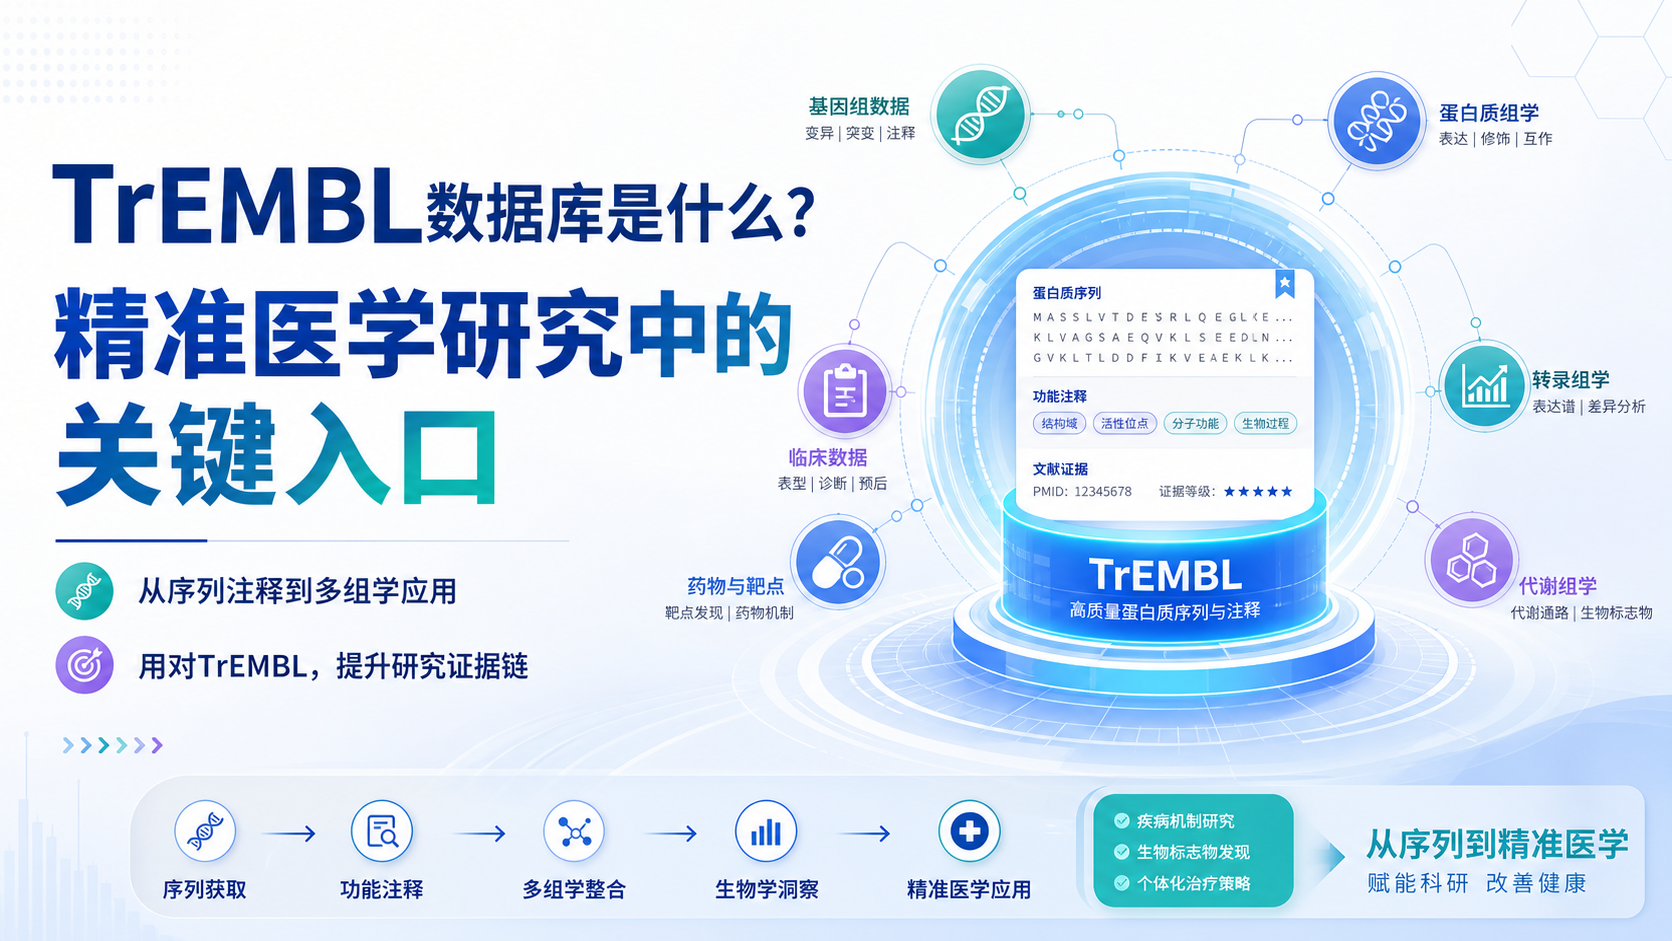
精准医学研究常卡在第一步。数据很多,但蛋白注释不全,靶点筛选慢,功能推断也容易失真。TrEMBL数据库正是解决“序列多、注释少”这一痛点的重要资源。
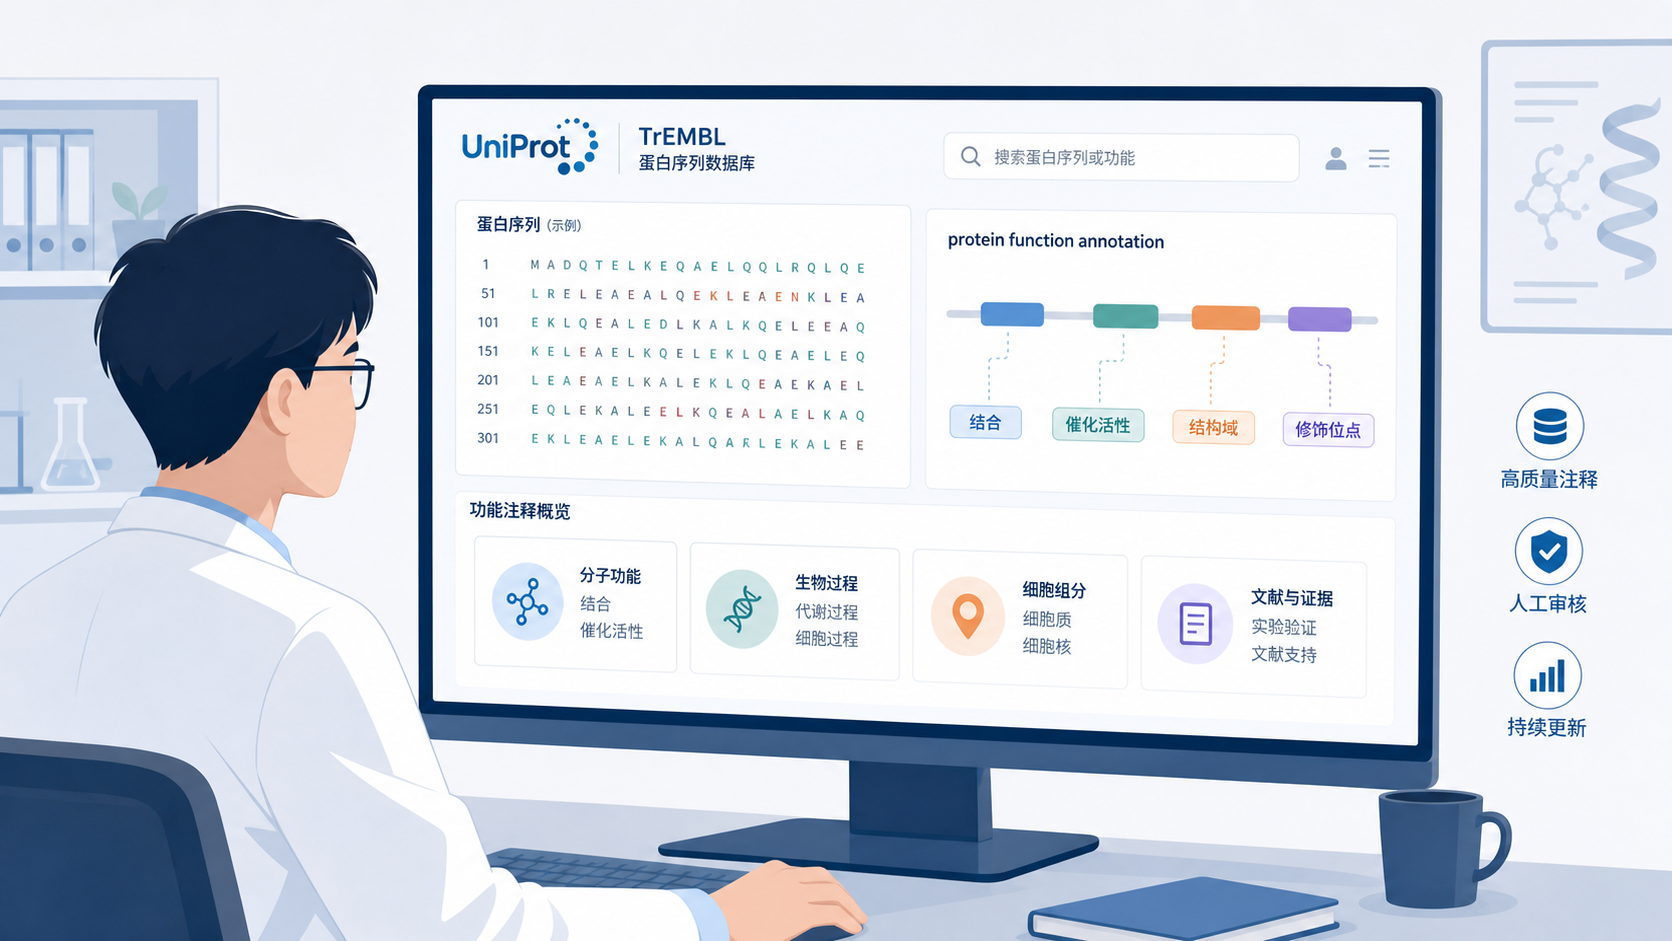
TrEMBL并不是“冷门数据库”,而是很多蛋白组学、转录组学和多组学分析的基础入口。对医学生、医生和科研人员来说,理解它的定位、数据来源和应用边界,能显著提升研究设计质量。如果你想把候选基因、蛋白和疾病机制真正连起来,TrEMBL值得优先掌握。
1. TrEMBL数据库是什么,为什么重要
1.1 TrEMBL的基本定位
TrEMBL是UniProt知识库的一部分,名称来自“Translated EMBL nucleotide sequence Data Library”。它主要收录的是自动注释的蛋白质序列 ,与人工精注的Swiss-Prot形成互补。
这意味着,TrEMBL的数据量大、更新快,覆盖范围广。很多新测序项目、非模式生物、低研究热度疾病相关样本,都会先落在TrEMBL这类自动注释库中。对于需要尽快扩展候选蛋白范围的研究,它非常实用。
一句话概括:TrEMBL解决的是“先把蛋白找全,再做精细注释”的问题。
1.2 为什么精准医学需要它
精准医学强调分层、分型和机制定位。无论是肿瘤、免疫病还是罕见病,研究者最终都要回答三个问题。
- 这个分子是否真实存在。
- 它在什么蛋白水平上发挥作用。
- 它与哪些通路、细胞和表型相关。
TrEMBL可以帮助研究者更快完成蛋白层面的初筛。尤其是在以下场景中,它的价值更明显。
- 新发现转录本对应的蛋白预测。
- 非模式物种或少见病种的蛋白注释。
- 大规模蛋白组学结果的功能扩展。
- 与UniProt、InterPro、GO等资源联动分析。
对精准医学而言,TrEMBL的核心价值不是“替代人工注释”,而是扩大可分析范围。
1.3 它和Swiss-Prot的关系
很多初学者会把TrEMBL和Swiss-Prot混为一谈。实际上,两者的定位不同。
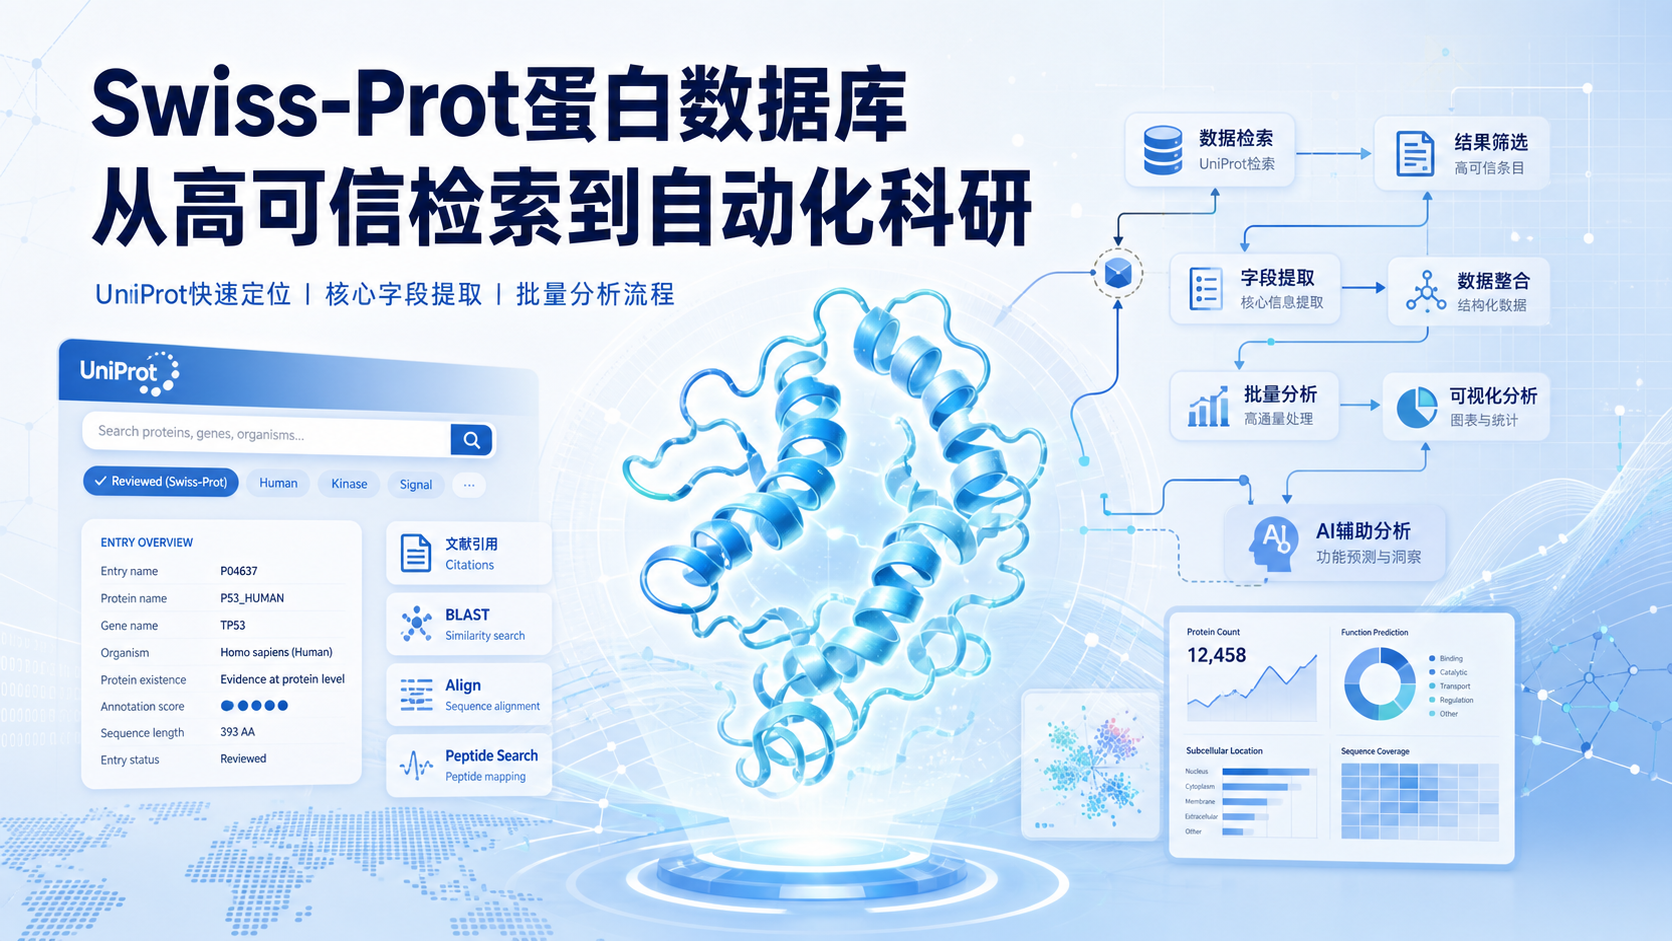
- Swiss-Prot强调人工审核,质量高,适合高可信功能结论。
- TrEMBL强调自动注释,覆盖广,适合探索性研究。
如果你在做疾病机制研究,常见策略是先用TrEMBL扩大候选蛋白池,再用Swiss-Prot和文献证据做二次筛选。这种“宽筛选、严验证”的逻辑,符合高质量科研的基本要求。
2. TrEMBL数据库在研究中的典型应用
2.1 从序列到功能的基础注释
很多研究的起点不是功能,而是序列。比如转录组测到一个新转录本,蛋白组学发现一个差异肽段,但它的功能并不明确。这时可以先借助TrEMBL进行自动注释,得到初步蛋白身份、结构域和同源信息。
常见可获得的信息包括:
- 蛋白名称或预测名称。
- 序列长度和氨基酸组成。
- 结构域和家族信息。
- 跨膜区、信号肽等特征。
- 与已知蛋白的同源关系。
这些信息看似基础,却能决定后续实验方向。没有这一步,很多机制研究会直接从“候选分子”变成“猜测分子”。
2.2 多组学研究中的桥梁作用
在精准医学里,单一组学往往不够。转录组给出差异表达,蛋白组给出真实翻译产物,代谢组提示功能终端变化。TrEMBL可作为蛋白序列和功能映射的桥梁,帮助不同组学接轨。
例如,在肿瘤研究中,你可能先在转录组中找到一个上调基因,再在蛋白组中验证其产物是否存在。若该蛋白属于未充分研究类别,TrEMBL的自动注释能帮助你快速判断:
- 它是否有保守结构域。
- 是否可能参与膜转运、信号传导或酶催化。
- 是否能进一步进入通路分析。
这类桥接能力,正是多组学整合中最容易被忽视、却最关键的一环。
2.3 非模式生物和稀有疾病研究
在非模式生物研究中,很多蛋白缺少成熟的人工注释。罕见病研究也类似,候选基因少,证据稀疏,现成数据库覆盖不足。此时TrEMBL常常是最先能用上的资源。
它的优势在于收录范围广,能为研究者提供最初的功能线索。对于临床相关科研,尤其是以下项目很有帮助:
- 罕见遗传病致病蛋白筛查。
- 病原微生物蛋白功能初判。
- 动物模型与人类同源蛋白比对。
- 新靶点的保守性与可转化性分析。
当已知信息很少时,先有“可解释的蛋白条目”,比直接追求完美注释更现实。
3. 使用TrEMBL数据库时,必须注意的三个问题
3.1 自动注释不等于高置信结论
这是最重要的一点。TrEMBL的数据来源广,但很多条目是自动生成的,未经过人工逐条审核。因此,它适合做探索,不适合直接做最终结论。
研究中应避免以下错误:
- 仅凭TrEMBL条目就断定蛋白功能。
- 忽略同源性较低条目的不确定性。
- 不结合文献、结构域和实验结果验证。
TrEMBL给的是“候选答案”,不是“最终答案”。
3.2 物种差异会影响解释
同一个蛋白家族,在不同物种中的功能可能并不完全一致。尤其是免疫、代谢和发育相关蛋白,保守性与特异性常常并存。直接照搬注释结论,很容易产生偏差。
建议在分析时补充以下信息:
- 物种来源。
- 同源蛋白的一致性。
- 保守结构域是否完整。
- 是否存在实验验证文献。
只有把物种背景放进来,TrEMBL的注释才有研究意义。
3.3 研究发表时要讲清楚证据链
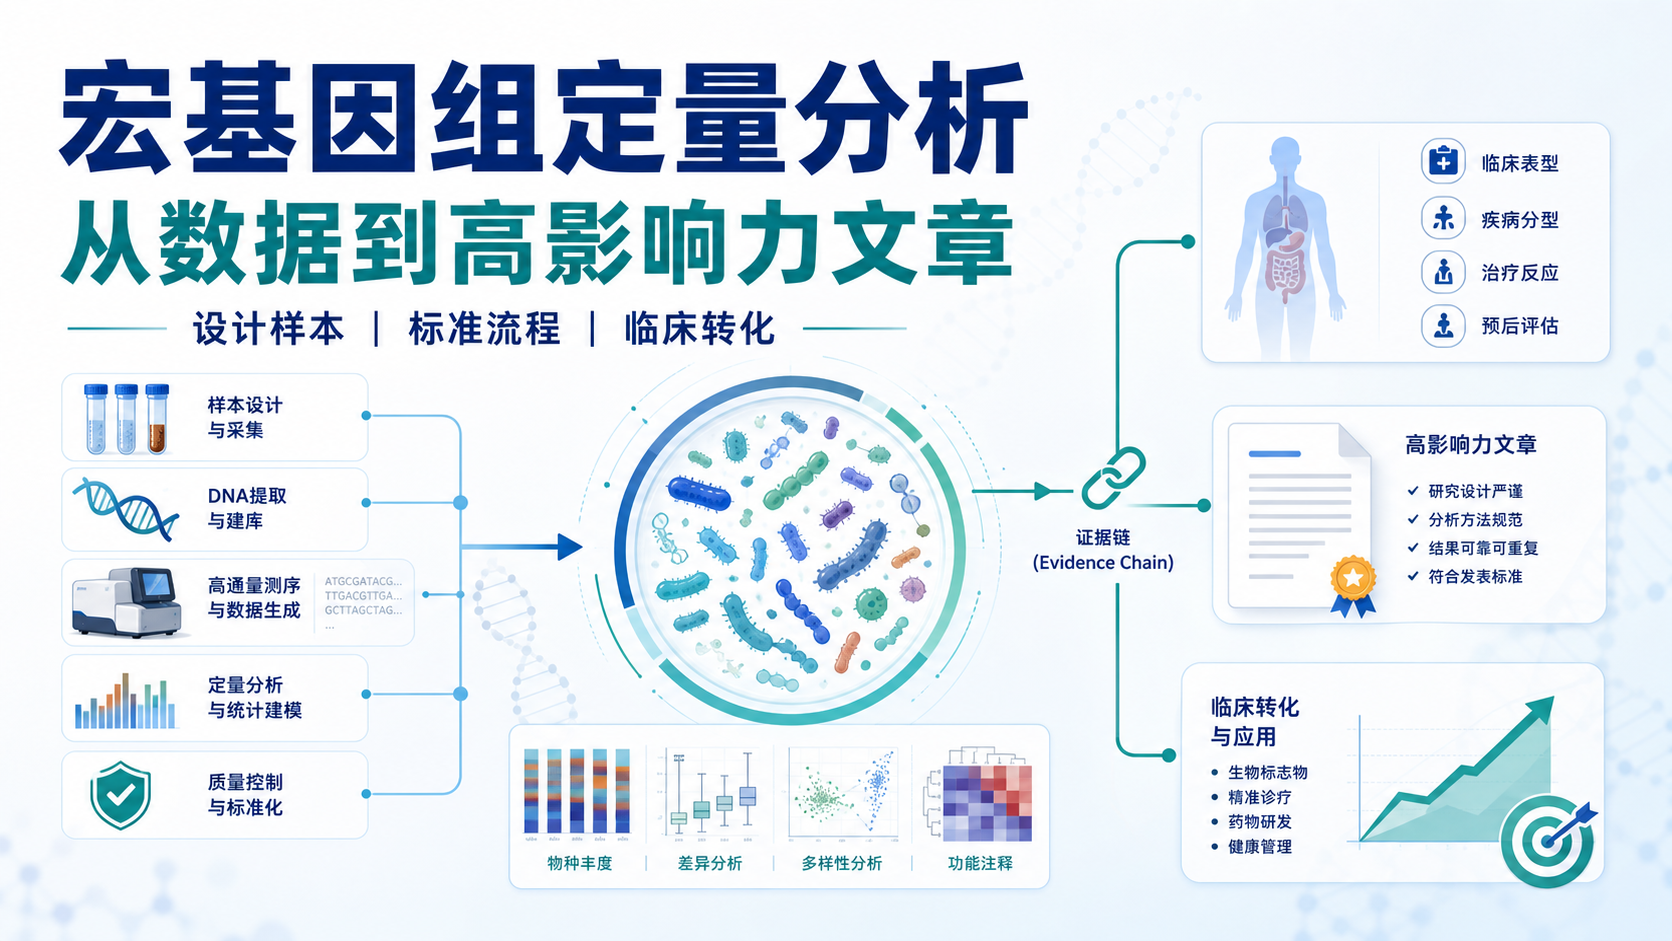
在SCI写作中,审稿人最关心的不是你用了什么数据库,而是你如何证明结论成立。若使用TrEMBL,应当把证据链写清楚。
建议至少包含:
- 数据来源与版本。
- 检索条件和筛选标准。
- 自动注释结果与人工验证结果的区分。
- 与GO、KEGG、InterPro或文献证据的交叉验证。
证据链完整,数据库才是加分项。证据链缺失,数据库就会变成弱点。
4. 如何把TrEMBL真正用进精准医学研究
4.1 一个可执行的研究思路
如果你的目标是做更扎实的精准医学分析,可以按以下步骤推进。
第一步,明确研究问题
先判断这个方向是否值得做,是否具备独特性。正如当前生信研究的基本要求,先确认“值不值得继续”,再确认“是否已有类似研究” 。这一步决定项目能否成立。
第二步,做蛋白层初筛
将候选序列或候选基因映射到TrEMBL,获取自动注释、结构域和同源信息。此阶段重在“广”。
第三步,进行交叉验证
再结合Swiss-Prot、文献、疾病数据库和通路数据库进行筛选。此阶段重在“准”。
第四步,进入机制层分析
如果研究条件允许,可以进一步做上下游调控、疾病分层、免疫浸润、药物预测,甚至分子对接。这样研究深度会明显提高。
当前高水平生信研究的趋势,就是从单点注释走向网络化、分层化和机制化。
4.2 从数据库到故事线的关键转变
很多文章的问题,不在于数据少,而在于故事线弱。TrEMBL的价值,恰恰在于帮助你把“未知蛋白”纳入一个可讲述的科学故事中。
一个更完整的逻辑通常是:
- 发现候选分子。
- 用TrEMBL补充蛋白注释。
- 结合调控网络确定上下游关系。
- 结合疾病分层解释不同患者的差异。
- 最后用药物或分子对接增强转化价值。
当研究从“我看到了一个变化”变成“我解释了这个变化为什么发生”,论文层级就会明显上升。
4.3 解螺旋如何帮助你把TrEMBL用到位
如果你在做蛋白注释、疾病机制或多组学整合,真正难的往往不是找到数据库,而是把数据库结果变成能发表的研究方案。解螺旋可以围绕你的课题,帮助你梳理数据路径、筛选分析模块,并把TrEMBL与转录组、蛋白组、网络分析、药物预测等步骤串联起来。
对于想提高研究完整度、减少无效试错的团队来说,这种个性化设计比单纯堆分析更有价值。
总结Conclusion
TrEMBL数据库的核心作用,是为研究者提供大范围、快速、可扩展的蛋白自动注释能力。它适合探索阶段,也适合多组学整合和非模式生物研究。但要记住,TrEMBL不是最终证据,必须与人工审核、文献验证和实验结果结合使用。
如果你正在推进精准医学相关课题,建议把TrEMBL放入你的基础分析流程中,再向调控网络、疾病分层和转化验证延伸。想把一个“有数据”的课题,真正做成“有故事、有深度、有发表价值”的研究,可以进一步了解解螺旋的定制化支持。
- 引言Introduction
- 1. TrEMBL数据库是什么,为什么重要
- 2. TrEMBL数据库在研究中的典型应用
- 3. 使用TrEMBL数据库时,必须注意的三个问题
- 4. 如何把TrEMBL真正用进精准医学研究
- 总结Conclusion