14
 分享
引言Introduction
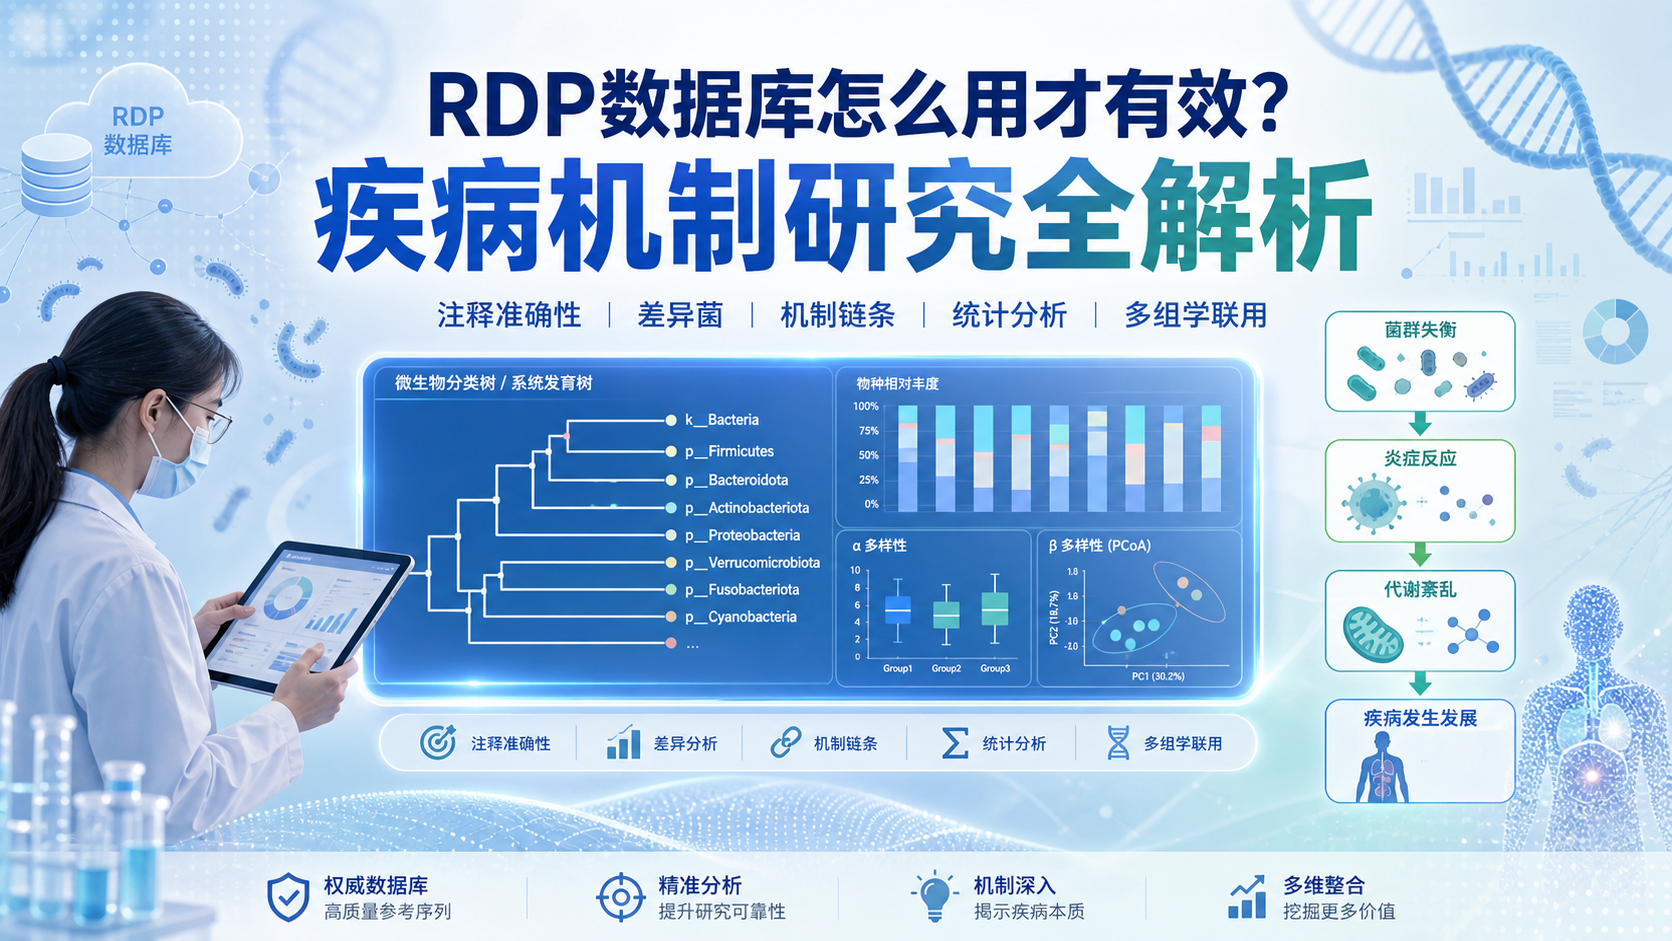
微生物组研究已经从“测序看群落”进入到“定位机制”的阶段。对医学生、医生和科研人员来说,真正的难点不再是拿到数据,而是如何准确注释、合理筛选、再把结果转化为疾病机制线索 。RDP数据库正是在这一环节中常被用到的基础工具。
1. RDP数据库是什么,为什么值得在疾病研究中使用
1.1 RDP数据库的核心价值
RDP数据库,即 Ribosomal Database Project,主要围绕16S rRNA 等核糖体序列的分类注释 展开。它最重要的价值,不是“替代所有数据库”,而是为微生物分类学提供一个稳定、标准化的参考框架。
在疾病机制研究中,分类注释的准确性直接影响后续分析。比如你研究肠炎、代谢综合征、肿瘤微环境或神经退行性疾病时,样本中的菌群变化如果连门、属层面都不稳定,后面的差异分析、富集分析和相关性分析都会失真。
RDP数据库的优势在于分类体系清晰,适合做16S数据的初步注释和标准化比较。 对于基础科研来说,这一步是机制研究的入口。
1.2 适合哪些研究场景
RDP数据库更适合以下场景:
- 16S rRNA 扩增子数据的物种注释。
- 疾病组与对照组的菌群差异比较。
- 多队列微生物组数据的统一分类标准建立。
- 作为后续机制分析的分类学基础。
如果你的研究目标是宏基因组功能预测、菌株水平分析或耐药基因挖掘,RDP本身不是终点,但仍可作为前期分类注释的重要参考。
换句话说,RDP更像“分类地基”,不是全部楼层。
2. 在疾病机制研究中,RDP数据库怎么用才有效
2.1 先解决“注释准不准”的问题
微生物组学最常见的误区,是一上来就看差异菌,忽略注释质量。实际研究中,很多结论不稳,往往不是统计方法错了,而是分类注释层级不统一、参考库不一致、低丰度噪音过多 。
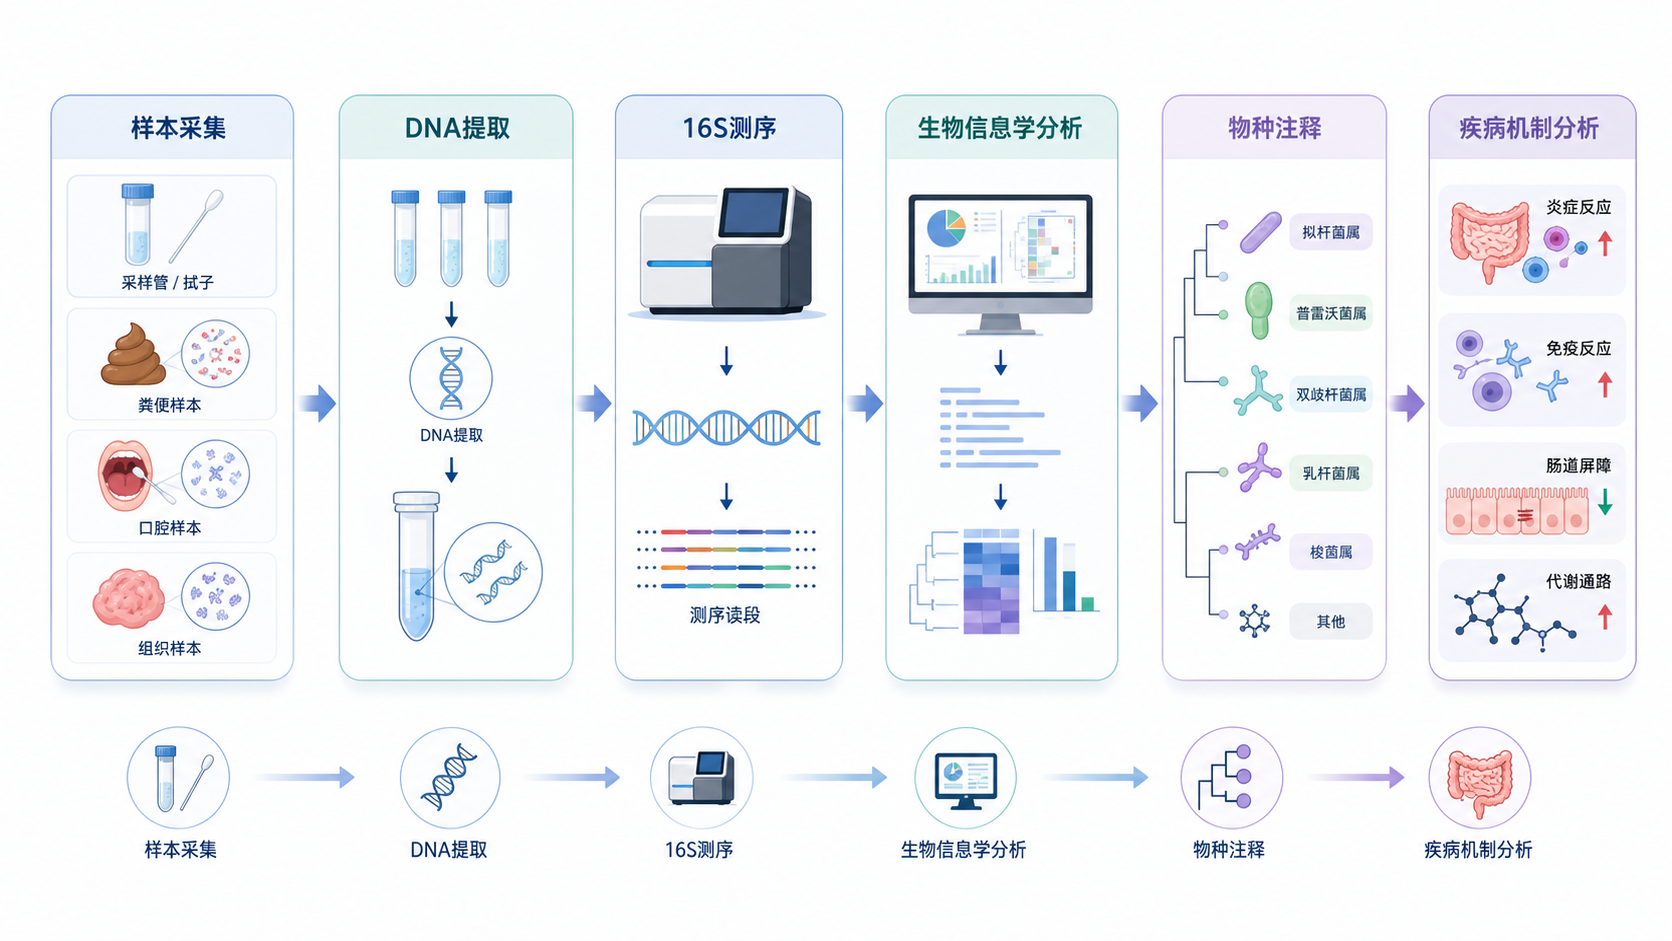
使用RDP时,建议按以下思路处理:
- 先完成原始测序质控。
- 再进行OTU或ASV聚类。
- 用RDP完成分类注释。
- 统一到门、纲、目、科、属层级后再做比较。
这样做的原因很简单。疾病机制研究关注的是群落变化与宿主表型之间的稳定关系 ,而不是某个偶然出现的噪音菌。
2.2 从“差异菌”走向“机制链条”
RDP注释完成后,下一步不是直接下结论,而是把差异菌放回疾病背景中解释。常见路径包括:
- 病例组与对照组的核心菌群是否改变。
- 某些菌属是否与炎症因子、代谢指标相关。
- 菌群变化是否指向屏障损伤、免疫失衡或代谢紊乱。
例如,在炎症性疾病研究中,如果你观察到产短链脂肪酸相关菌减少,促炎相关菌增加,就不能只停留在“菌变了”。还要进一步追问:
- 是否伴随 IL-6、TNF-α 升高。
- 是否存在肠屏障蛋白下降。
- 是否存在代谢通路重编程。
机制研究的关键,是把“菌群变化”连接到“宿主反应”。
2.3 RDP结果如何和统计分析配合
RDP数据库本身不负责统计学结论,但它提供的分类基础,必须和统计方法结合。
常见分析步骤包括:
- Alpha多样性,观察样本内部丰富度与均匀度。
- Beta多样性,比较组间群落差异。
- 差异丰度分析,识别显著变化的分类单元。
- 相关性分析,连接菌群与临床指标。
- 多变量回归,控制年龄、性别、用药等混杂因素。
如果没有统计控制,RDP注释再准确,也很难支撑疾病机制结论。
3. RDP在疾病机制研究中的精准运用策略
3.1 先看群落,再看关键分类单元
很多初学者喜欢直接盯着某个菌属,但更稳妥的策略是先看整体群落结构。因为疾病并不总是由单一菌引起,更多时候是群落失衡导致的网络变化 。
建议按这个顺序分析:
- 先看门水平的大趋势。
- 再看属水平的候选菌。
- 最后锁定与临床表型最相关的分类单元。
这样更符合微生物生态学逻辑,也更容易形成可发表的机制框架。
3.2 从相关性到因果推断,要分层推进
RDP注释帮助你确定“谁在变”。但疾病机制研究还要回答“为什么变、变了有什么后果”。
你可以用三步推进:
-
相关性层面
看菌群与炎症、代谢、免疫参数的关系。 -
功能层面
结合PICRUSt、宏基因组或代谢组,推测相关通路。 -
验证层面
用细胞、动物或临床样本进一步验证。
这也是从“现象描述”走向“机制阐释”的标准路线。RDP负责前半段,后半段必须靠实验和多组学联动完成。
3.3 不同疾病方向的应用重点
RDP在不同疾病中的侧重点并不相同。
- 消化系统疾病 :重点看肠道菌群失衡、黏膜屏障和炎症通路。
- 代谢性疾病 :重点看能量代谢、脂质代谢和胰岛素抵抗相关菌群。
- 肿瘤研究 :重点看微生物与免疫微环境、治疗反应之间的关系。
- 神经疾病 :重点看肠脑轴、炎症介质和代谢物变化。
同一个RDP注释结果,在不同疾病模型中,解释框架完全不同。
4. 常见误区:为什么很多RDP分析“有结果但没机制”
4.1 只看显著性,不看生物学意义
很多文章的问题在于,虽然统计上有差异,但并没有回答疾病机制问题。比如只写“某菌升高、某菌降低”,这类结果很难形成高质量结论。
更好的写法应该是:
- 该菌是否参与炎症调控。
- 是否影响代谢产物生成。
- 是否与疾病分期或预后相关。
- 是否能解释临床表型变化。
没有生物学上下文的差异菌,只是列表,不是机制。
4.2 忽略混杂因素
微生物组研究特别容易受饮食、抗生素、年龄、BMI、住院环境影响。若这些因素不控制,RDP注释得到的群落差异可能并不来自疾病本身。
建议在研究设计阶段就记录:
- 抗生素使用史。
- 饮食习惯。
- 合并用药。
- 采样时间和样本处理流程。
这部分数据越完整,后续分析越可靠。
4.3 过度依赖单一数据库
RDP很重要,但不能孤立使用。更成熟的策略是:
- 用RDP做分类注释。
- 用其他数据库做交叉验证。
- 再结合临床资料和实验验证。
单一数据库只能说明“可能”,多源验证才能支撑“可信”。
5. 让RDP结果真正服务于高质量研究
5.1 与多组学联用,提升机制深度
如果你只做16S分类注释,文章通常停留在描述层面。若能联用代谢组、转录组或蛋白组,机制深度会明显提升。
例如:
- 菌群变化 + 代谢物变化,可提示代谢通路异常。
- 菌群变化 + 炎症转录谱,可提示免疫激活。
- 菌群变化 + 临床结局,可提示预后价值。
RDP适合做入口,多组学适合做延伸。
5.2 读文献,决定该保留哪些菌
RDP分析完成后,真正决定论文质量的,往往不是“数据有多少”,而是“你保留了哪些菌,舍弃了哪些菌”。
这一步必须回到文献。你需要确认:
- 该菌是否已有疾病关联报道。
- 它是保护性菌还是致病相关菌。
- 是否存在跨疾病一致性。
- 是否有机制实验支持。
如果一个菌既有文献基础,又在你的数据中稳定变化,才更适合作为主线分子或核心菌群继续深入。
5.3 借助专业平台减少试错成本
对于很多团队来说,真正的痛点不是没有想法,而是分析链条长、工具多、数据整合难 。这时候,像解螺旋这样的专业科研服务平台,就能帮助研究者把RDP注释、数据库联动、富集分析和机制梳理整合起来,减少重复试错,把精力集中在问题设计和结果验证上。
对于想把微生物组研究做深、做稳、做快的团队,专业化的数据分析支持非常关键。
总结Conclusion
RDP数据库在微生物组学中的价值,核心不是“给出一个菌名”,而是为疾病机制研究提供可靠的分类起点 。它适合用于16S数据注释、群落比较和候选菌筛选,但真正的机制结论还需要结合统计分析、文献证据和多组学验证。
如果你希望把微生物组数据从“相关”推进到“机制”,就不能只停留在分类结果上,而要把RDP、临床信息和功能验证整合起来。解螺旋可以帮助你完成这一整条分析链,减少试错成本,让研究更接近高质量发表。
- 引言Introduction
- 1. RDP数据库是什么,为什么值得在疾病研究中使用
- 2. 在疾病机制研究中,RDP数据库怎么用才有效
- 3. RDP在疾病机制研究中的精准运用策略
- 4. 常见误区:为什么很多RDP分析“有结果但没机制”
- 5. 让RDP结果真正服务于高质量研究
- 总结Conclusion