15
 分享
引言Introduction
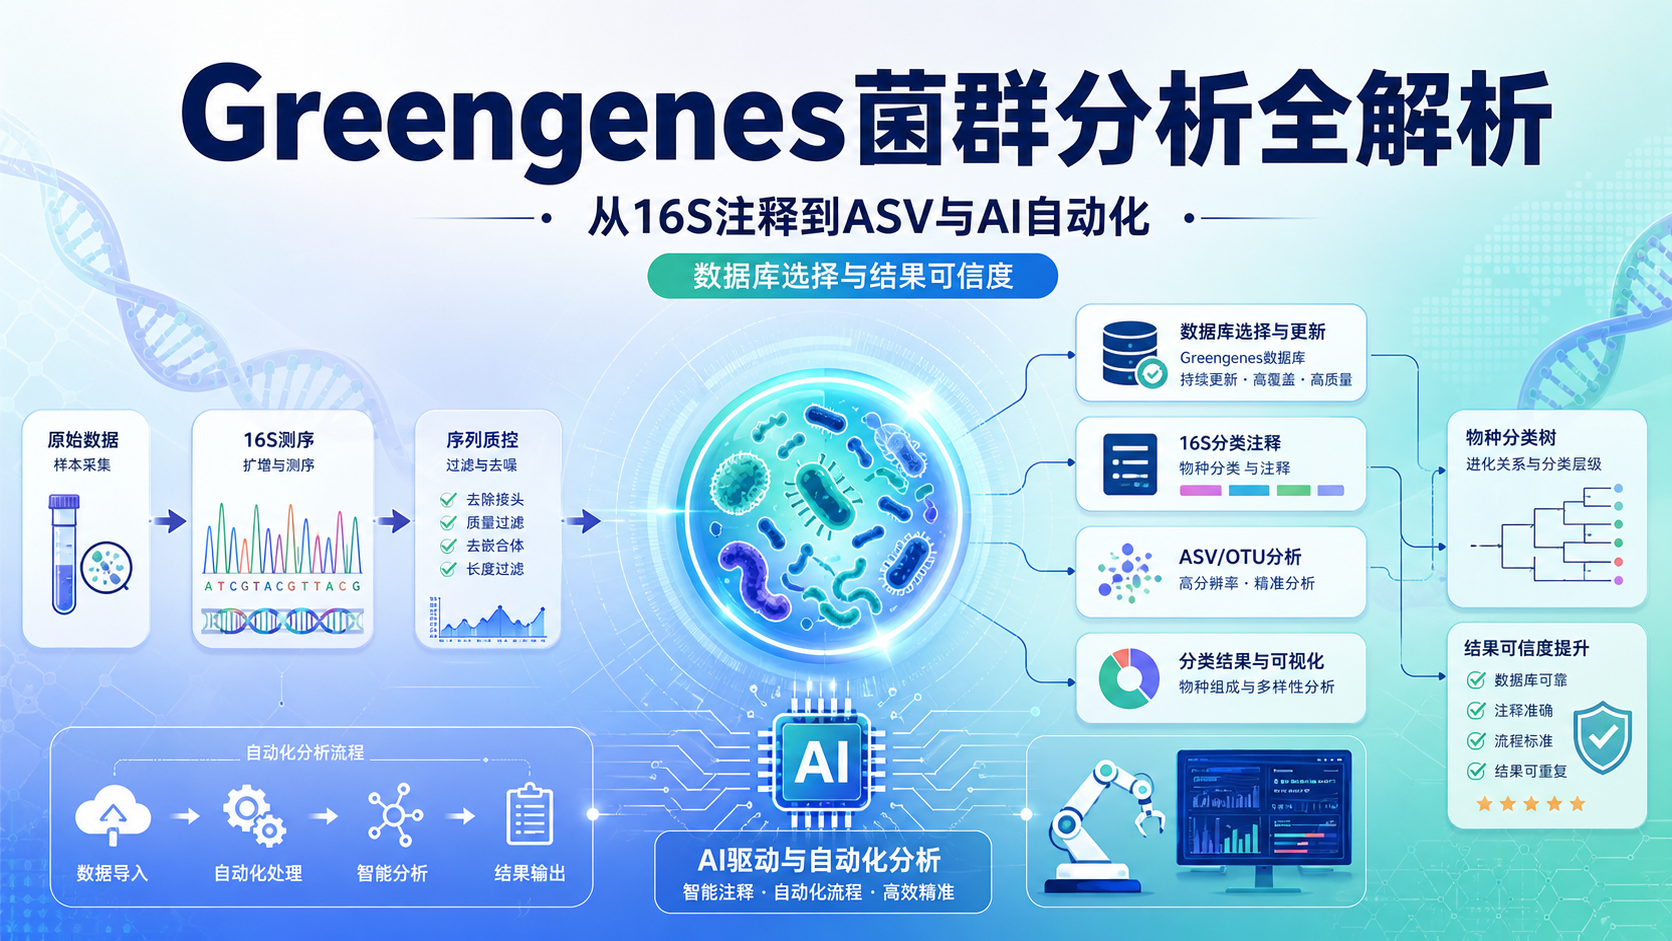
菌群分析常常卡在同一个问题上。数据库选错,注释偏差就会放大,后续统计和结论也可能失真。Greengenes数据库 曾是16S rRNA研究中的经典参考,但在当前微生物组研究中,它的适用边界、局限和替代方案,值得重新评估。
1. Greengenes数据库在菌群分析中的基础地位
1.1 作为16S分类注释参考库的作用
Greengenes是面向16S rRNA序列分类注释的经典数据库之一。它的核心价值在于提供统一的参考序列和分类体系,便于将测序片段映射到已知分类单元。在早期QIIME生态中,Greengenes几乎是标准配置 ,因此很多菌群分析流程都以它为默认参考。
对于医学生和科研人员来说,理解它的作用非常重要。数据库本质上不是“结果本身”,而是影响结果的坐标系。不同数据库会改变菌属水平的归类方式,进而影响丰度表、α/β多样性解释,甚至差异菌筛选结论。
1.2 为什么它曾经被广泛使用
Greengenes受欢迎,主要因为三个原因。
- 分类体系相对稳定。
- 能和早期分析工具无缝衔接。
- 在教学和标准流程中易于复现。
但要注意,数据库的历史优势,不等于当前研究中的最优选择 。微生物组研究发展很快,测序平台、分析软件和参考库都在更新。数据库如果长期不维护,就会逐步暴露覆盖不足和分类滞后的问题。
1.3 适合哪些研究场景
Greengenes仍可能出现在一些场景中。比如历史数据复现、旧项目再分析、与早期文献对照,或者实验室内部标准化流程沿用。对于这类任务,统一性比“最新”更重要。
但如果是新项目,尤其是需要更高分类准确度的临床样本、环境样本或跨队列研究,仅依赖Greengenes往往不够 。研究者应先明确目标,是复现旧数据,还是建立面向发表的新分析框架。这个判断会直接影响数据库选择。
2. Greengenes菌群分析的关键流程与优化点
2.1 从原始序列到分类表的标准步骤
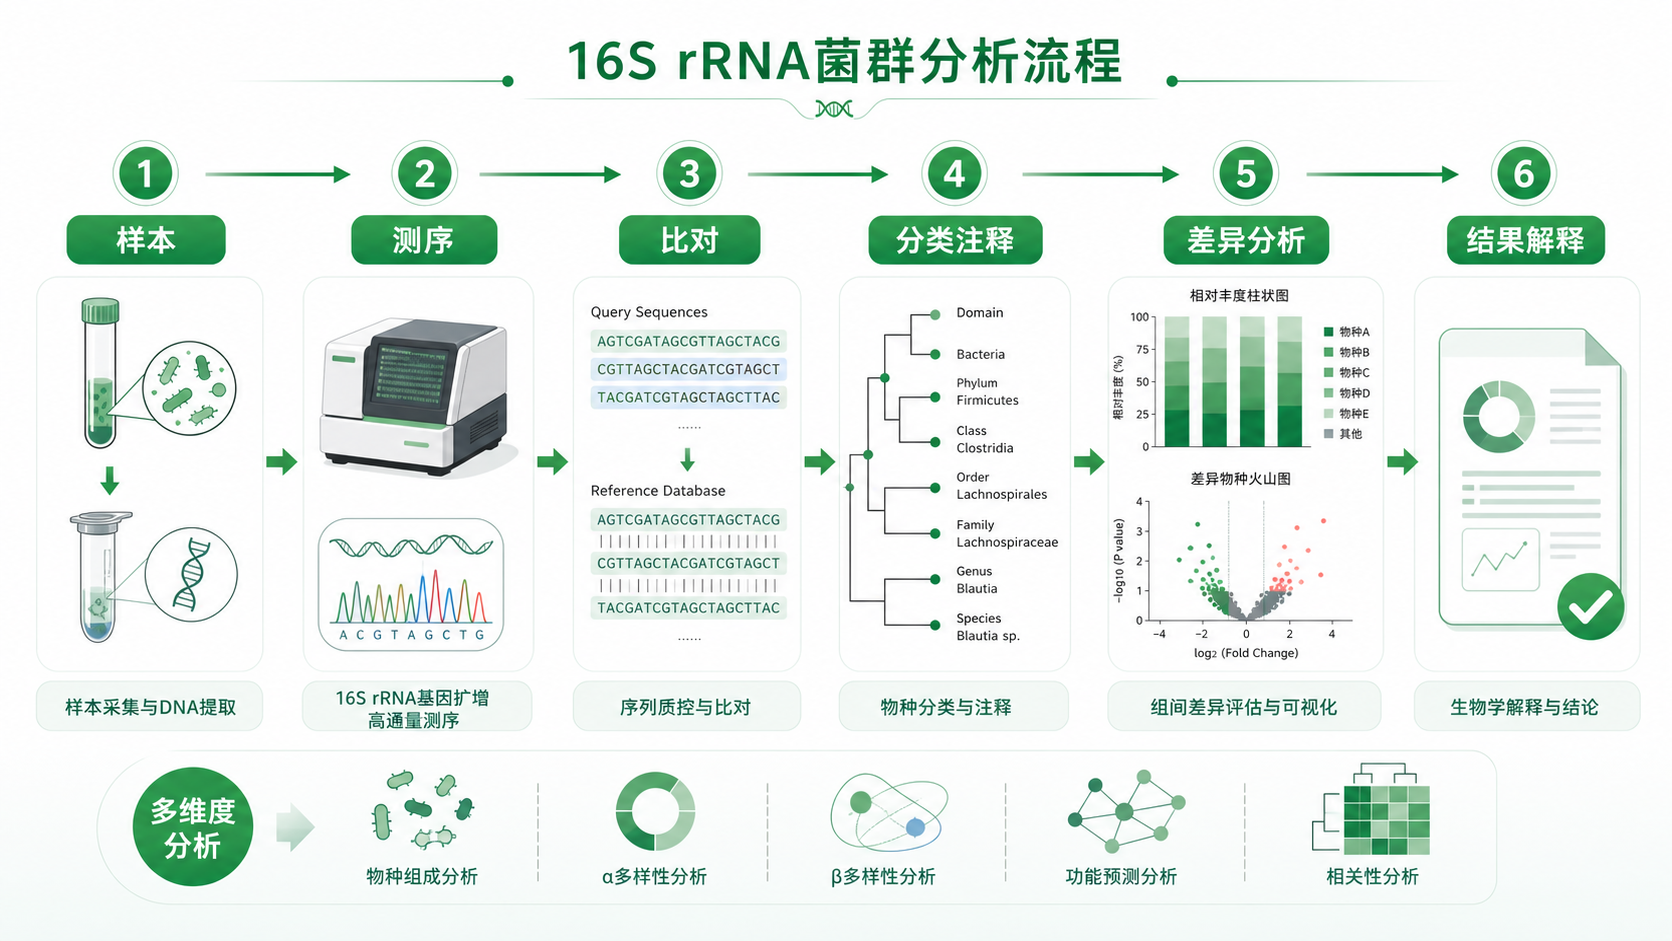
基于Greengenes的菌群分析,通常包括以下步骤。
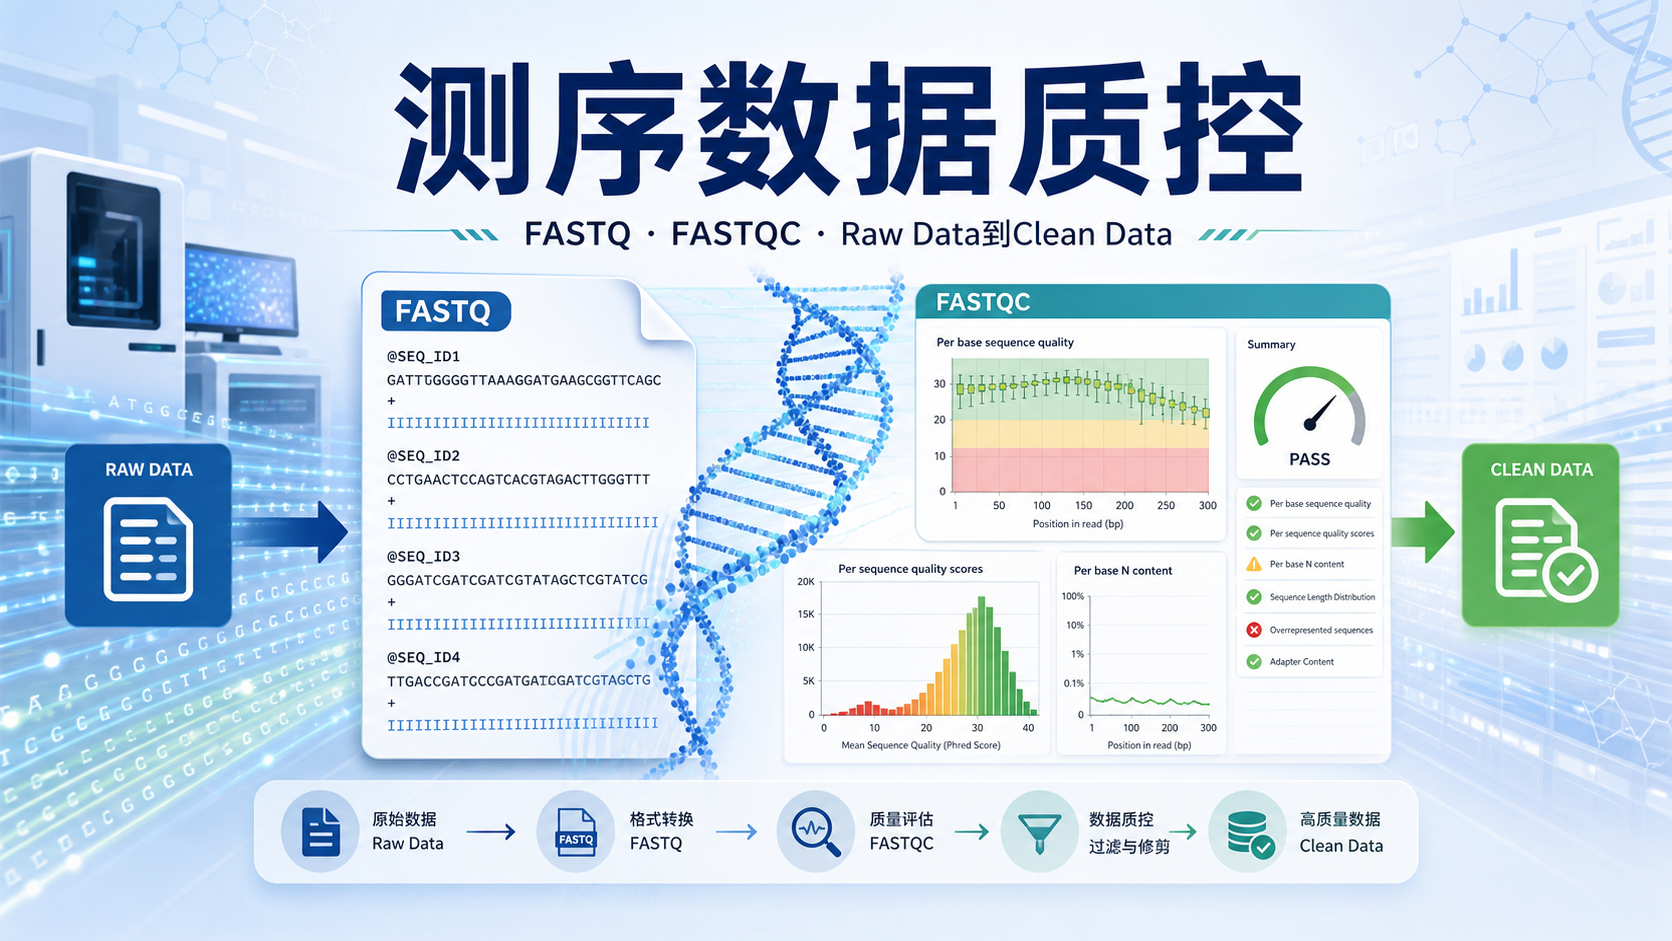
- 质控与去噪。
- 构建ASV或OTU特征表。
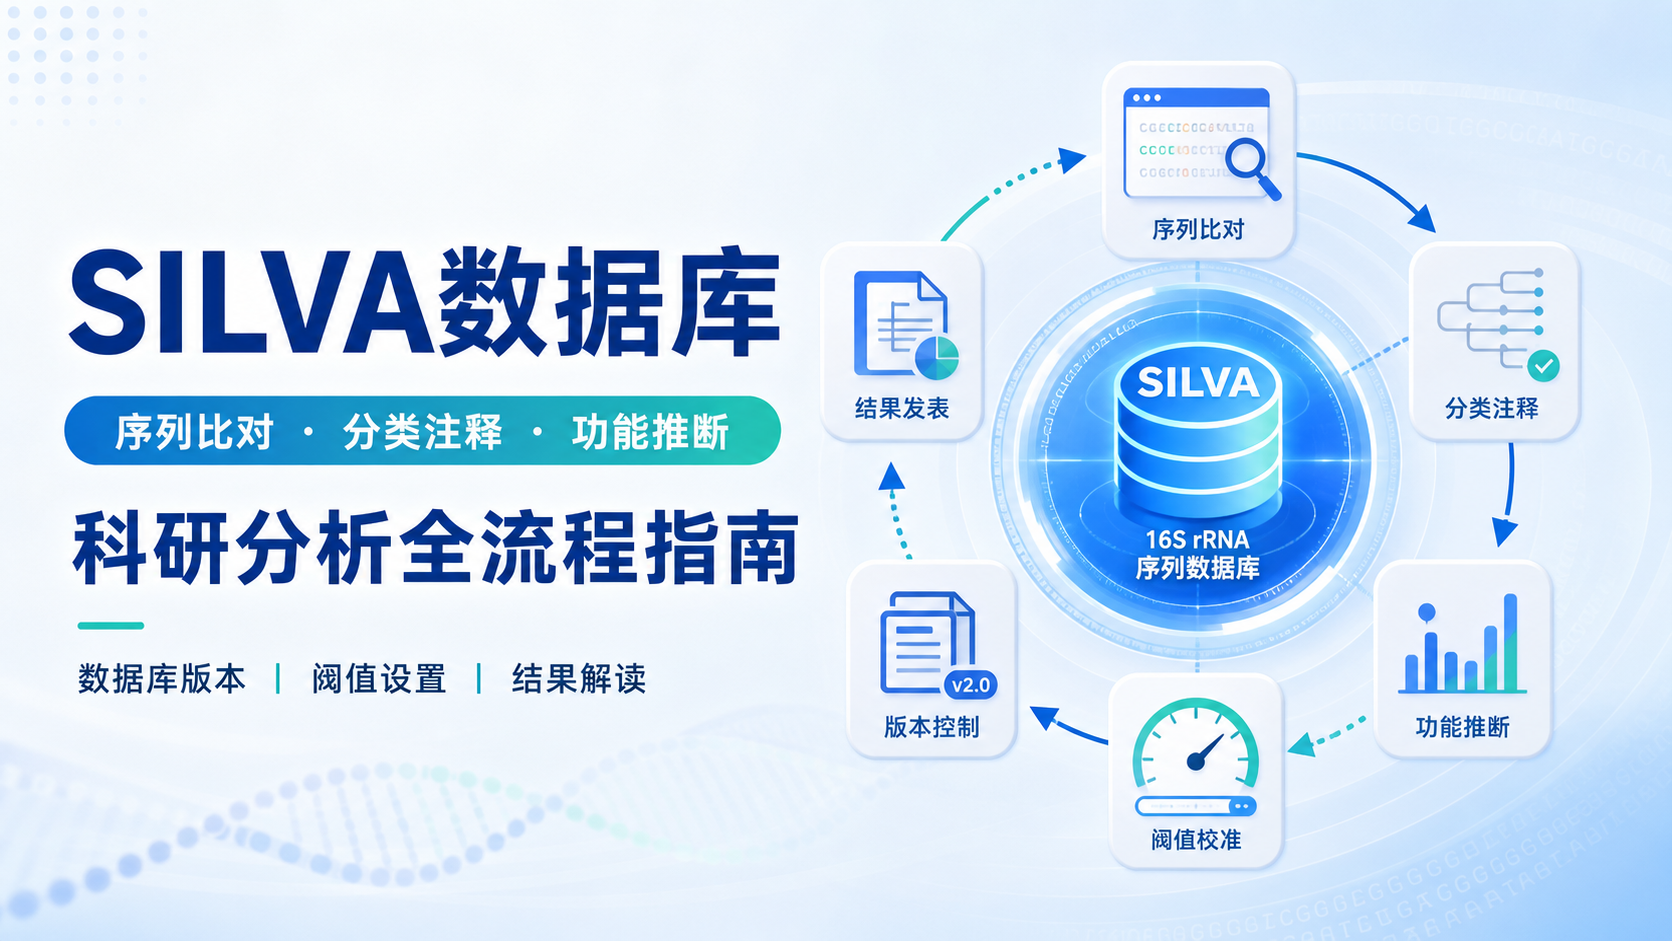
- 用参考库进行分类注释。
- 生成丰度矩阵和多样性指标。
- 开展差异分析与功能推断。
其中最关键的环节,是注释阶段。如果参考库本身更新不足,即使前处理再规范,也只能得到“流程上正确、解释上有限”的结果。 因此,优化重点应放在数据库适配、参数选择和结果交叉验证,而不是只盯着软件按钮。
2.2 常见误区:把分类结果当成绝对真相
菌群注释具有概率性,不是绝对判定。16S片段长度有限,很多近缘菌在相同扩增区域内难以完全区分。尤其在属以下层级,误判和合并注释更常见。
常见误区包括:
- 认为所有OTU或ASV都能稳定到种水平。
- 忽略扩增区域差异对分类能力的影响。
- 把数据库差异误认为生物学差异。
- 只看相对丰度,不看注释置信度。
科研写作中,最需要避免的是过度解读。 如果结果只支持到科或属,就不要硬推到种和机制层面。严谨的表述,通常比夸张结论更容易通过同行评审。
2.3 方法优化的三个方向
想提高Greengenes相关分析的可信度,可从三个方向优化。
第一,优化测序片段和引物设计。 不同V区对分类分辨率影响明显。研究开始前就应明确目标菌群和适配区域。
第二,优化注释策略。 不要只跑单一数据库。至少做Greengenes与其他主流库的交叉比对,比较分类一致性。
第三,优化统计解释。 菌群分析的核心不是“找出最多的菌”,而是结合临床分组、实验设计和混杂因素,识别可解释的差异模式。
这些步骤看似基础,但正是很多文章质量分层的关键。数据库选型合理,结果解释才站得住。
3. Greengenes的局限性与替代趋势
3.1 数据更新不足带来的问题
Greengenes最突出的限制,是更新停滞。对于快速扩展的微生物分类学,这意味着部分分类单元无法及时纳入,新的命名体系也可能无法充分反映。对新样本来说,这会造成两个后果。
一是注释覆盖率下降。二是分类粒度受限。
尤其在肠道菌群、口腔菌群和疾病相关微生物组研究中,研究者越来越需要更高精度的分类结果。当数据库不再及时更新,它在前沿研究中的竞争力自然会下降。
3.2 与当前主流数据库的比较思路
当前微生物组研究中,更常见的做法是根据任务选择数据库,而不是固定依赖单一库。比较时可以关注四个指标。
- 分类覆盖率。
- 分类一致性。
- 与当前命名体系的匹配度。
- 在目标样本中的实际可用性。
对于医学生和实验室科研人员,重点不是“哪个数据库最好”,而是“哪个数据库最适合当前问题”。如果你的研究是临床队列,并且希望结果更接近最新分类学,通常需要考虑更现代、更新频繁的参考资源。
3.3 研究报告中应如何处理数据库差异
在论文和基金写作中,数据库差异必须透明报告。建议写清楚以下内容。
- 使用的数据库名称和版本。
- 比对软件和参数。
- 分类阈值。
- 主要结果是否进行替代数据库验证。
可重复性是微生物组研究的底线。 如果数据库版本不写清楚,别人很难复现你的结果。对于审稿人来说,这往往是方法学部分最先看的地方之一。
4. 面向前沿研究的菌群分析新趋势
4.1 从OTU时代走向ASV时代
传统OTU聚类强调相似性阈值,而ASV方法更注重精确序列变体。近年来,ASV已成为主流趋势。它能保留更高分辨率的信息,也更利于跨研究比较。
这对数据库提出了更高要求。当特征层级更精细时,参考库的准确性和更新频率就更关键。 这也是为什么很多新项目会重新评估是否继续使用Greengenes作为唯一注释库。
4.2 多数据库联合验证成为常规做法
前沿研究越来越强调联合验证。单一数据库适合初步分析,但在结果发表前,常常需要与其他数据库、系统发育树或文献证据交叉确认。
常见的验证思路包括:
- 比较不同库的同一ASV注释是否一致。
- 对关键菌进行系统发育定位。
- 结合临床表型和独立队列验证。
- 在必要时补充宏基因组或培养证据。
这类策略的本质,是把“数据库输出”转化为“证据链”。 这也是E-E-A-T思路在生物信息学中的真实体现。
4.3 AI与自动化分析正在改变流程
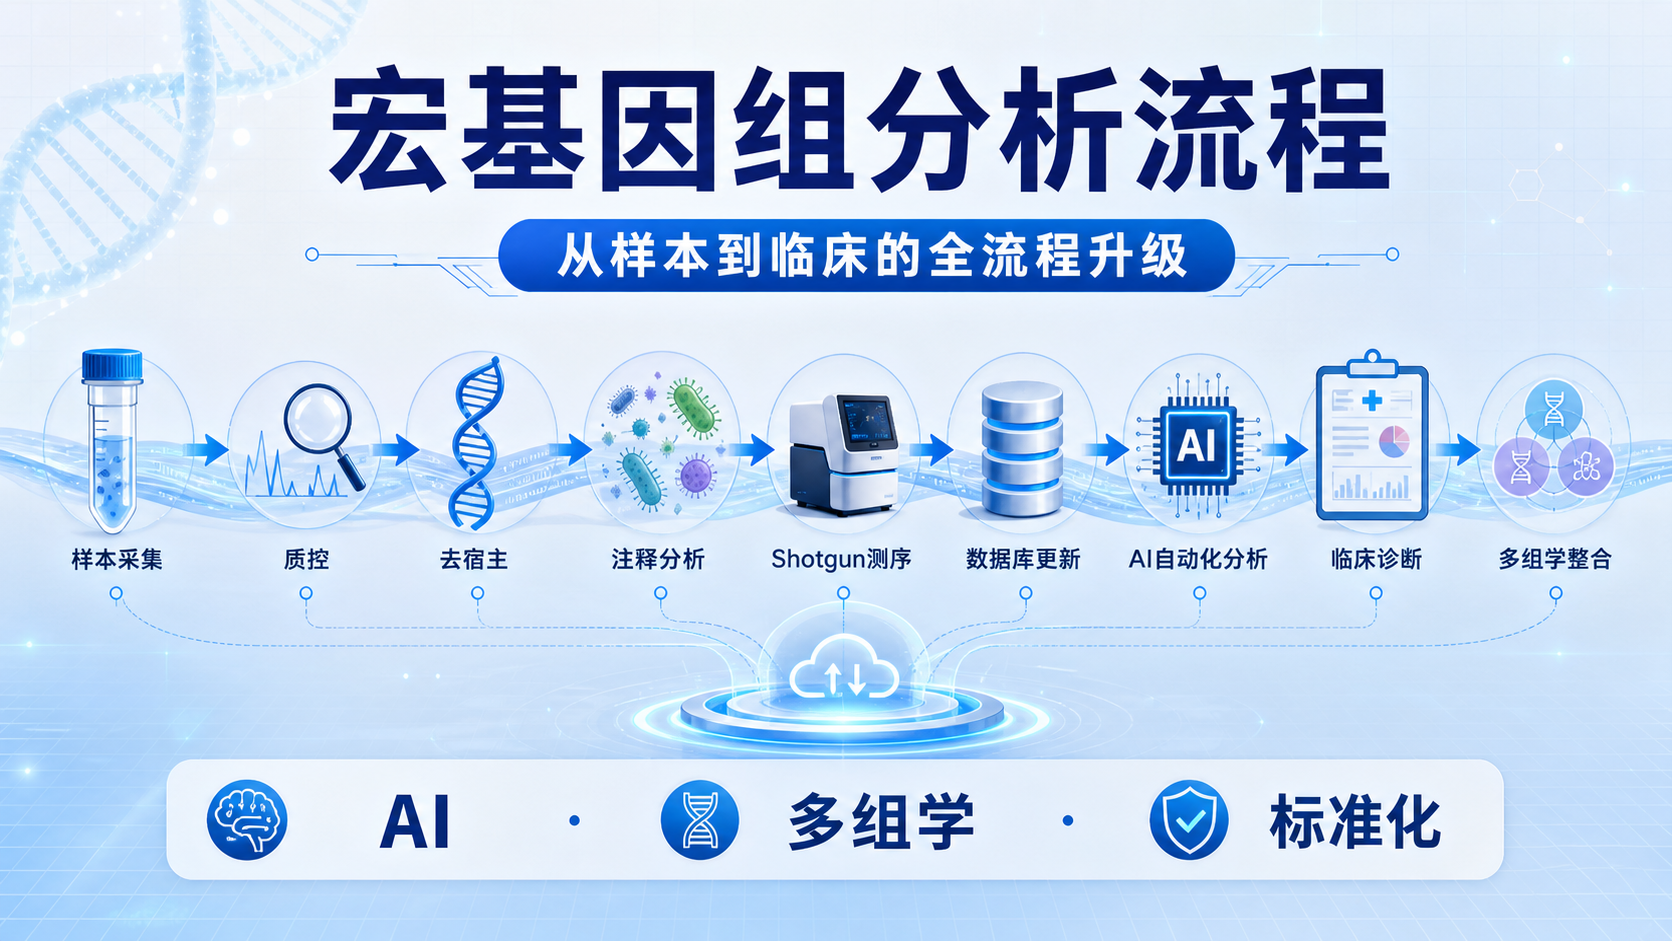
菌群分析正在从“手工拼流程”走向“自动化协作”。AI工具越来越多地参与数据质控、文献检索、结果解释和报告生成。未来的趋势,不只是更快出图,而是让分析过程更标准、更可追溯。
例如,研究者可以先完成基础数据处理,再借助智能工具完成数据库比对、结果汇总和方法记录。这样能减少重复劳动,也能降低流程遗漏。对临床科研和转化研究来说,这种效率提升非常重要。
5. 如何在实际项目中提升结果可信度
5.1 建议的实践框架
如果你正在做基于Greengenes数据库的菌群分析,建议按下面的思路执行。
- 先明确研究目的,是复现旧数据还是开展新研究。
- 根据目标区域选择合适引物和扩增片段。
- 使用明确版本的数据库进行注释。
- 与至少一种替代数据库交叉验证。
- 结合临床信息解释,而不是孤立解读丰度变化。
这个框架的核心是减少单点偏差。数据库、软件、参数、样本设计,任何一个环节不稳,都会影响最终结论。
5.2 结果展示要突出方法透明度
在图表展示上,建议重点呈现以下内容。
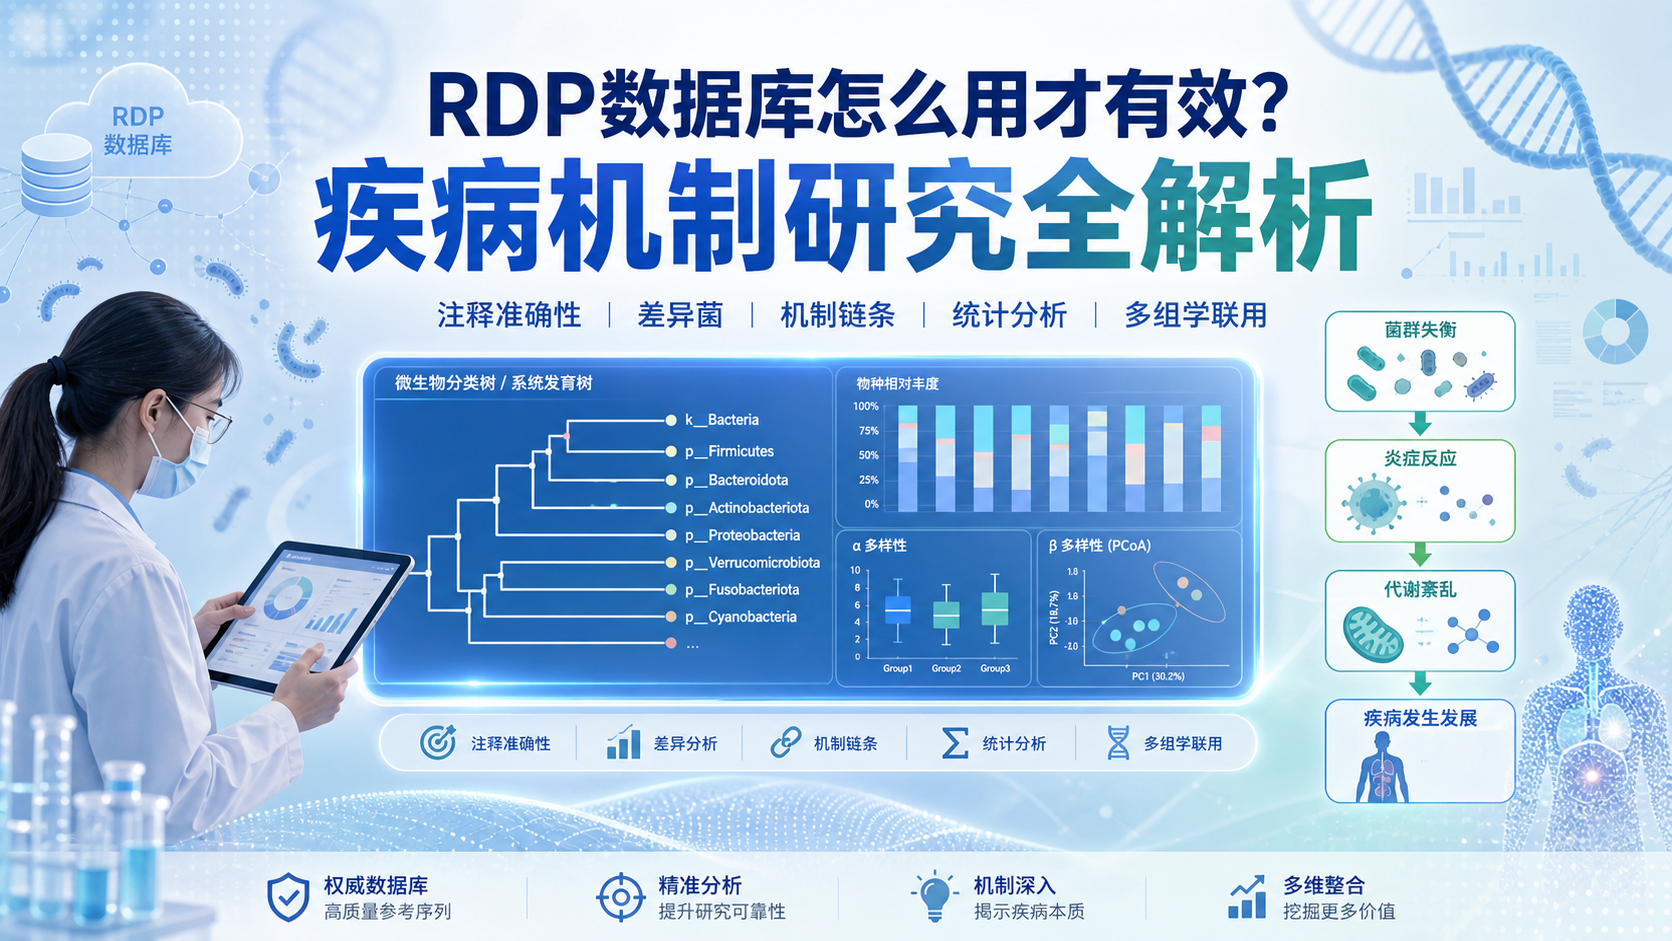
- 分类层级分布。
- 主要菌群相对丰度。
- α多样性和β多样性。
- 差异菌及其统计学支持。
- 关键菌的数据库注释说明。
对于高水平论文,方法透明度非常重要。图做得漂亮不够,必须让读者看懂你是怎么得到结果的。这也是审稿人判断研究可信度的基础。
5.3 让分析流程更稳定的工具选择
对于希望提升菌群分析效率的团队,可以考虑将标准流程工具化、模块化。这样能减少重复操作,也能提高不同项目之间的一致性。像解螺旋这类面向科研场景的工具与服务,适合帮助研究者把数据处理、数据库注释和结果整理做得更规范。当流程标准化后,研究者就能把更多精力放在机制解释和论文产出上。
总结Conclusion
Greengenes数据库在菌群分析史上有重要地位,但它更适合被理解为“经典参考库”,而不是所有新研究的唯一答案。真正专业的做法,是根据研究目标选择数据库,并对分类结果进行交叉验证与透明报告。
对于医学生、医生和科研人员来说,菌群分析的竞争力,最终来自方法严谨、注释清晰和解释克制。若你希望进一步提升微生物组分析效率与规范性,可以结合解螺旋的科研支持工具,让数据处理、结果整理和方法优化更高效、更可靠。
- 引言Introduction
- 1. Greengenes数据库在菌群分析中的基础地位
- 2. Greengenes菌群分析的关键流程与优化点
- 3. Greengenes的局限性与替代趋势
- 4. 面向前沿研究的菌群分析新趋势
- 5. 如何在实际项目中提升结果可信度
- 总结Conclusion