13
 分享
引言Introduction
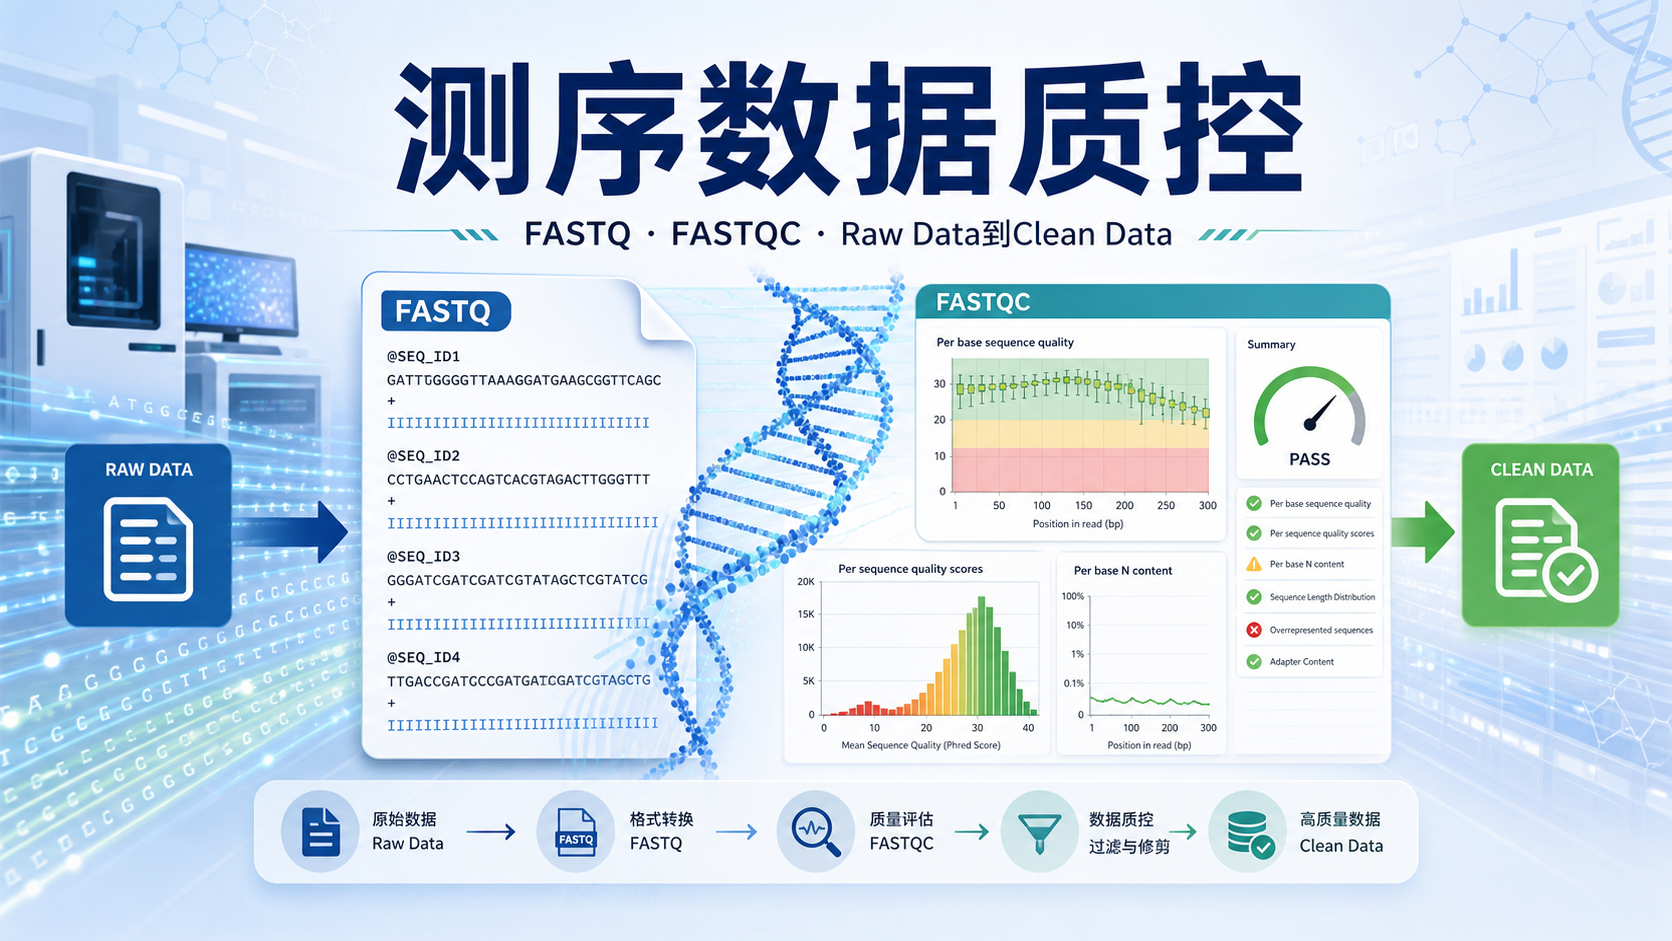
测序数据看起来“已经拿到”,但真正能不能用,往往卡在质控这一步。很多后续分析失败,不是算法问题,而是原始数据质量不过关。 对医学生、医生和科研人员来说,先把测序数据质控做好,才能避免比对偏差、差异分析失真和重复返工。
1. 为什么测序数据质控是第一道门槛
1.1 质控决定数据能不能进入后续分析
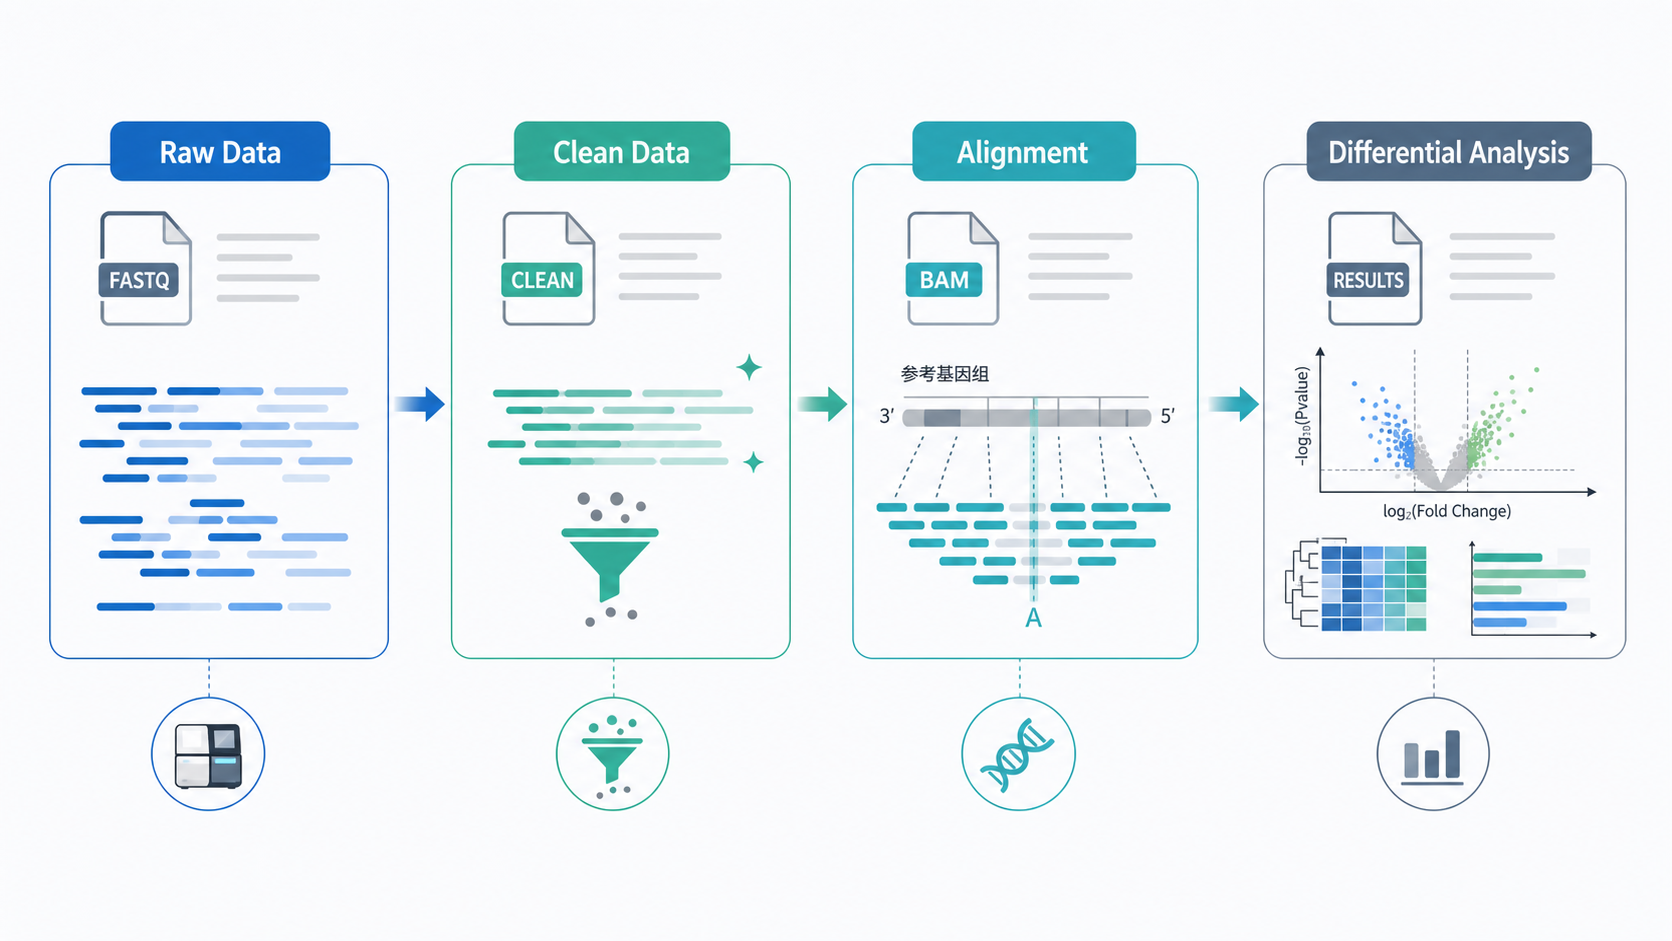
FASTQ文件从raw data到clean data,通常要经历两个核心步骤,QC和filter。只有通过测序数据质控,数据才具备进入比对、组装、定量、差异基因分析和注释的基础。 这一步不是形式,而是分析流程的入口。
如果原始数据中接头污染、低质量碱基过多,后续分析会出现系统性误差。比如比对率下降,表达量估计偏移,甚至把技术噪音误判为生物学差异。对于不常亲自处理原始数据的课题组,这一步尤其重要。
1.2 高通量测序不等于自动可靠
现在测序平台普遍成熟,以Illumina为代表的仪器整体质量已经很高。但“平台可靠”不等于“每个样本都合格”。 样本制备、建库、上机和数据输出任何一个环节有问题,都会反映在FASTQ质控结果里。
因此,不能只看测序公司给出的结论。建议研究者自己至少做一次独立质控验证。这样能尽早发现问题,避免把错误数据带入整个项目。
2. 先读懂FASTQ文件,再谈质控
2.1 FASTQ的四行结构是质控基础
FASTQ文件每个read由四行组成,理解它,才能正确解读质控报告。
- 第一行,以“@”开头,包含序列识别信息。
- 第二行,是真实测序序列,如ATCG。
- 第三行,通常是“+”。
- 第四行,是对应每个碱基的质量值。
第二行是序列本体,第四行是质量判断核心。 如果第二行出现较多N,说明该位置测不准。N越多,数据可用性越差。
2.2 Q值是判断碱基可信度的核心指标
质控时最常见的是Q值体系。Q30通常代表准确率99.9%,Q20代表准确率99%以上。 Q值越高,说明测序误差越少。
实际分析中,最常关注的是Q30。因为它能较直观反映碱基级别的可靠性。一般来说,碱基质量图在Q30以上,属于较好的状态。若大部分碱基低于Q30,就需要警惕数据质量。
2.3 不要只盯着一个数字
FASTQ质控不是只看一个Q30就结束。还要结合:
- 序列长度分布。
- GC含量。
- Adapter污染。
- N碱基比例。
- 序列重复水平。
其中,碱基质量仍是最核心的判断指标。 其他指标要结合样本类型和测序策略综合解释。
3. FASTQC怎么做,质控流程怎么跑
3.1 从原始文件到可分析文件
拿到测序数据后,通常先确认文件类型。很多数据会以.gz压缩包形式存在,需要先解压,再进行查看和质控。整理文件时,建议先确认目录结构,再清理不需要的临时文件,避免混淆。
常见流程是:
- 进入数据目录。
- 查看是否有SCI或SRA相关文件。
- 解压得到FASTQ文件。
- 确认文件完整。
- 运行FASTQC进行质控。
在进入比对之前,先完成文件整理和基础质控,是最稳妥的做法。
3.2 FASTQC命令适合批量处理
FASTQC是最常用的FASTQ质控工具之一。它支持单文件,也支持多个文件批量分析。输出一般包含HTML报告和ZIP压缩包。实际阅读时,优先看HTML报告,因为更直观。
常用参数包括:
-o,指定输出路径。-t,指定线程数。
例如,多个样本可以通过循环命令批量处理。线程数要结合电脑配置设置,过高未必更快。一般来说,合理分配线程能明显提升运行效率。
3.3 批量质控更适合真实项目
真实项目里,样本数往往不止一个。对于成对样本、多个分组或公共数据库下载的数据,建议批量运行质控。这样能快速发现某个样本是否明显异常。
如果只有某一个样本质量显著偏低,先不要急着进入下游分析。 应先判断是测序问题、样本污染,还是文库构建异常。
4. 质控报告到底看什么
4.1 先看基本信息,再看核心质量图
FASTQC报告第一页通常会给出基本信息,包括:
- 文件名。
- 文件类型。
- 编码方式。
- 序列长度。
- GC含量。
对于人类样本,GC含量通常在50%左右波动,轻微偏离并不一定异常。真正需要重点看的是碱基质量分布图。如果大部分碱基质量保持在Q30以上,通常说明数据较可靠。
4.2 绿色通过不代表所有项都完美
FASTQC里常见的绿色代表通过。红色或黄色提示不一定都要处理。比如:
- sequence duplication levels,常常不通过。
- Adapter content,有时会出现。
- 某些长度分布项,也可能不理想。
其中,sequence duplication levels未通过在RNA-seq里并不少见。 因为某些高表达基因本来就会被重复测到。不要把所有warning都当成严重问题。
4.3 重点是找影响分析的异常
真正要警惕的是这些情况:
- 大段低质量碱基集中在read末端。
- N碱基比例偏高。
- Adapter污染明显。
- 不同样本之间质量差异过大。
- 某个样本整体偏离其他样本。
这些问题会直接影响比对、定量和差异分析。质控的目标不是追求“全绿”,而是确保数据足够可靠。
5. 从质控到清洗,如何把raw data变成clean data
5.1 QC和filter是连续动作
测序数据质控通常分两层。第一层是QC,用来检查质量。第二层是filter,用来清理低质量片段。只有完成QC和filter,才算真正进入clean data阶段。
清洗通常会去掉:
- 低质量序列。
- 带有过多N的序列。
- 接头污染序列。
- 长度过短的无效片段。
这些过滤操作会减少噪音,但也会让可用reads数量下降。因此,必须在“保留足够数据”和“去除明显错误”之间平衡。
5.2 不同项目的过滤阈值不完全一样
不同测序平台、建库方法和研究目的,对过滤标准的要求并不完全相同。比如,单细胞、转录组和外显子测序,对read质量和长度分布的关注点就不同。
但有一点是共通的。如果基础质控不通过,后续分析再精细也难以补救。 所以清洗规则应建立在质控结果基础上,而不是先设想下游结论。
5.3 清洗后的数据才适合进入核心分析
clean data生成后,才能进入比对、组装、定量、差异表达、功能富集和注释。这个顺序不能颠倒。否则,下游结果虽然“看起来完整”,但可信度会大幅下降。
对于科研项目,建议保留原始FASTQ、质控HTML报告和清洗后的结果文件。这样便于复现,也方便投稿时回应审稿人问题。
6. 质控结果如何判断是否达标
6.1 看碱基质量是否稳定
最实用的判断标准,是看质量曲线是否稳定。如果主要碱基区域保持在Q30附近或以上,通常可以接受。 若末端明显下滑,可以考虑修剪低质量尾端。
质量曲线波动很大的样本,往往更值得进一步排查。因为这类数据在比对和定量时更容易产生噪音。
6.2 看异常样本是否需要单独处理
在TCGA或其他大队列数据中,常会遇到少数异常样本。数据评估时,除了FASTQ质控,还可以结合箱线图、密度图、PCA图和聚类图观察整体分布。
如果一个样本在多个维度都明显偏离群体,它很可能不是“正常生物学差异”,而是技术异常。 这类样本是否剔除,需要结合研究设计谨慎判断。
6.3 结合项目目标做最终决策
不同研究的容忍阈值不同。基础探索性分析和临床验证研究,对数据严格程度并不一样。关键原则是:质控结论要服务于研究问题,而不是只为了满足工具报告。
对于需要高可信度结论的项目,建议把质控标准定得更严格。对于大样本探索性研究,则更强调样本一致性和批次可控。
7. 高质量分析的最后一步,离不开专业工具和规范流程
7.1 质控不是附属步骤,而是分析起点
很多人把质控当成“跑工具、看报告”这么简单。实际上,测序数据质控决定的是整条分析链的可信度。 只要这一步做扎实,后面的比对、表达定量和差异分析会更稳。
特别是在论文写作和项目汇报中,质控结果往往也是最容易被追问的部分。数据是否干净,直接影响结果是否站得住。
7.2 规范保存报告,便于复现和交付
建议统一保存以下内容:
- 原始FASTQ文件。
- FASTQC HTML报告。
- 清洗后的clean data。
- 关键参数记录。
- 样本异常说明。
这样做的好处很直接。后期复现更方便,团队协作更顺畅,数据交付也更专业。
7.3 用解螺旋提高质控与分析效率
如果你希望把测序数据质控、清洗和下游分析串成标准流程,解螺旋 可以帮助你更高效地完成文献学习、数据整理和方法落地。它适合需要快速上手RNA-seq和生信分析的医学生、医生和科研人员,把复杂步骤拆成可执行流程,减少试错成本。
总结Conclusion
测序数据质控不是可选项,而是高质量分析的起点。 从FASTQ结构、Q值判断,到FASTQC报告解读,再到QC和filter生成clean data,每一步都在决定后续结果是否可靠。对于科研项目来说,先把数据看懂,再进入比对和差异分析,才是稳妥路径。
如果你正在做RNA-seq或其他测序项目,建议把质控流程标准化,保留完整报告,并在团队中形成统一规范。想更高效地完成这一步,可以进一步了解解螺旋 提供的生信学习与分析支持,帮助你把测序数据质控真正做对、做稳。
- 引言Introduction
- 1. 为什么测序数据质控是第一道门槛
- 2. 先读懂FASTQ文件,再谈质控
- 3. FASTQC怎么做,质控流程怎么跑
- 4. 质控报告到底看什么
- 5. 从质控到清洗,如何把raw data变成clean data
- 6. 质控结果如何判断是否达标
- 7. 高质量分析的最后一步,离不开专业工具和规范流程
- 总结Conclusion