11
 分享
引言Introduction
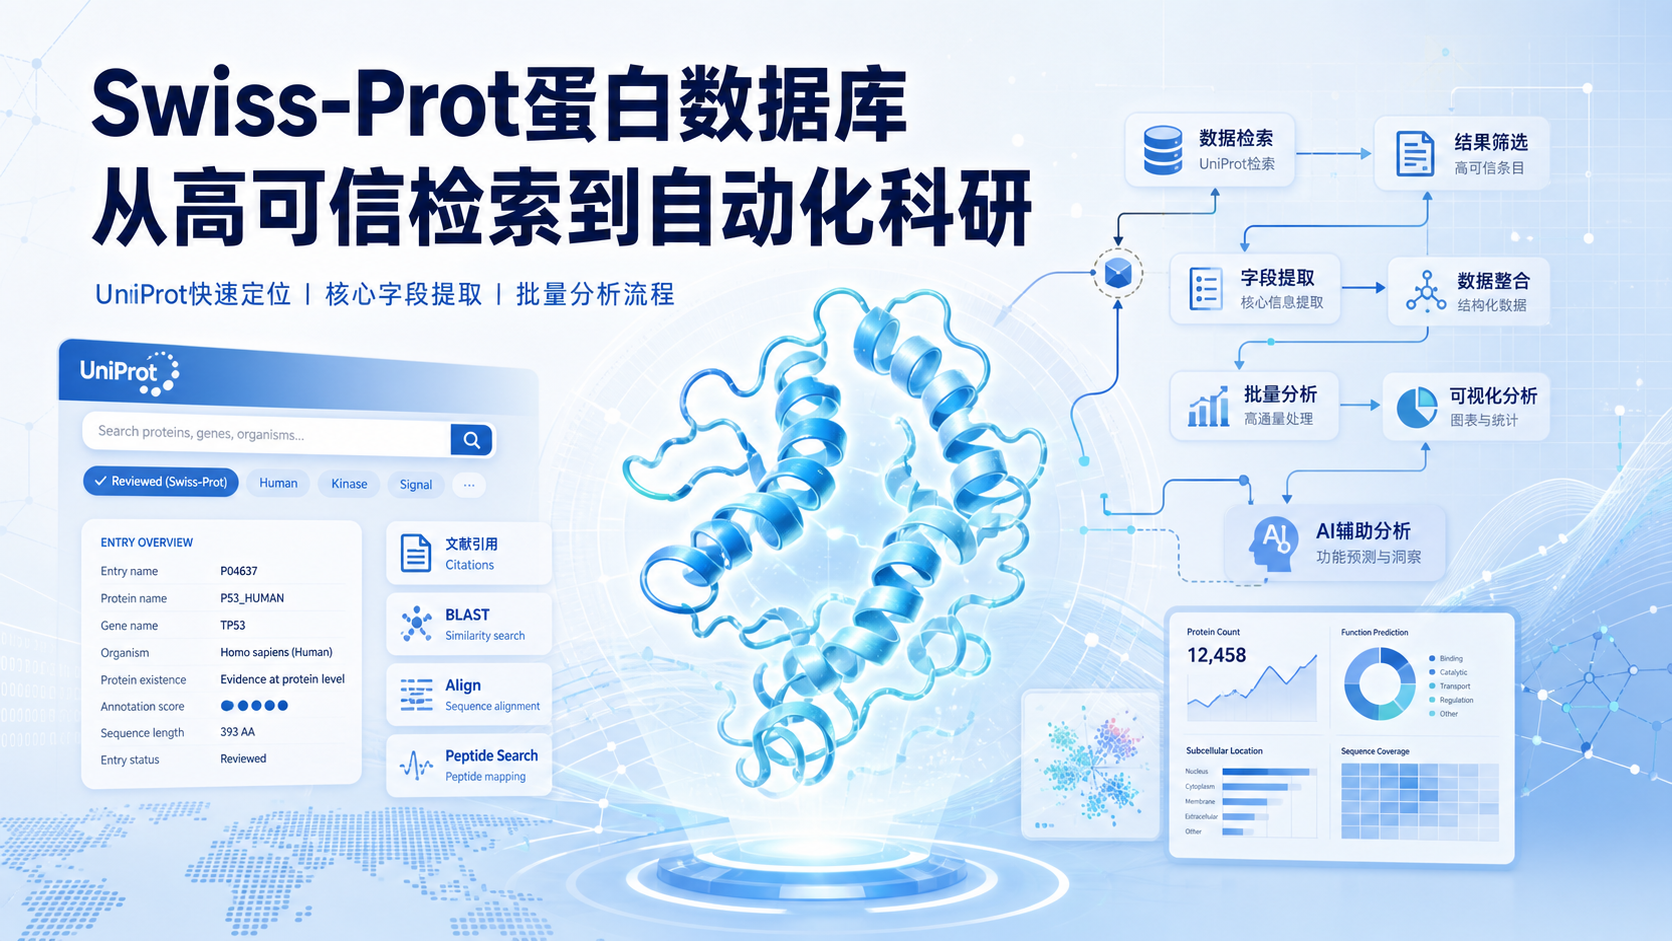
在蛋白质研究中,最耗时的往往不是实验本身,而是从海量数据库里准确提取、整理和比对蛋白信息 。Swiss-Prot 因为人工审核、注释规范,常被视为蛋白功能查询的高可信来源。对医学生、医生和科研人员来说,掌握它的检索逻辑,能明显提升文献整理、靶点筛选和自动化分析效率。
1. Swiss-Prot数据库为什么是蛋白研究的高可信入口
1.1 人工审核决定了它的“可用性”
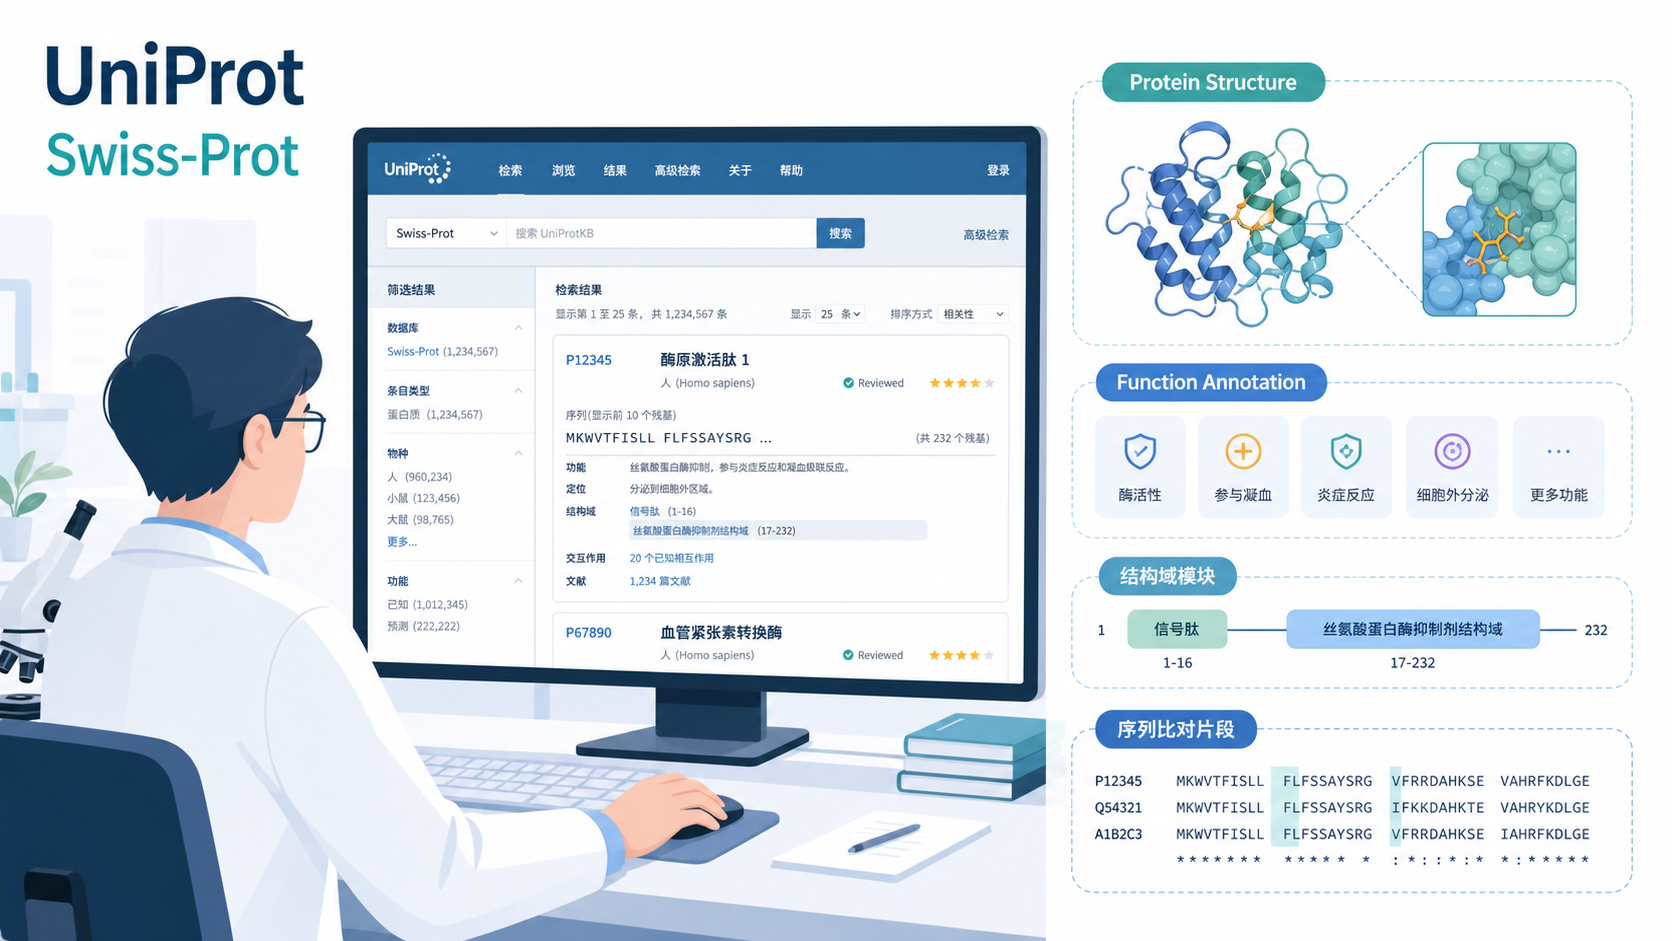
Swiss-Prot 是 UniProtKB 的人工审核子库。它的核心价值,不只是“数据多”,而是注释经过专家核对,信息更稳定、更适合直接用于研究决策 。
对于需要快速判断蛋白功能、亚细胞定位、疾病关联和文献证据的场景,这一点非常关键。相比只看自动注释结果,Swiss-Prot 更适合做第一轮高质量筛选。
1.2 它适合哪些研究场景
Swiss-Prot 常用于以下任务。
- 查询目标蛋白的标准名称和别名。
- 获取功能描述、结构域、修饰位点和亚细胞定位。
- 查看疾病相关蛋白与已知变异。
- 结合文献和交叉数据库做后续验证。
对自动化科研而言,Swiss-Prot 的意义在于:它提供的是可被程序抓取、结构化调用的高质量蛋白知识。 这使它不仅能服务人工检索,也能进入脚本化、批量化的分析流程。
1.3 与自动化科研的衔接点
自动化科研强调两件事。
- 数据源可靠。
- 信息可批量处理。
Swiss-Prot 恰好满足这两个条件。它可以通过 UniProt 的检索、ID 映射、API 和下载功能进入分析管线。研究者不必手工一个个查表,而是可以把蛋白信息直接纳入标准化流程中,减少人工误差。
2. 如何在UniProt中快速定位Swiss-Prot蛋白
2.1 新版界面与旧版界面的切换
UniProt 在 2022 年更新后,界面逻辑发生了变化。习惯旧版操作的用户,可以直接切换到 legacy 页面继续使用。
新版界面的核心入口包括。
- 数据库选择。
- 检索框。
- ID 转换。
- Search 按钮。
- 下载与引用入口。
实际使用中,先选对数据库,再输入关键词,比盲目搜索更高效。 这一步能显著减少无关结果。
2.2 常用检索方式
Swiss-Prot 检索支持多种输入方式。常见包括。
- 蛋白名,如 insulin。
- 基因名,如 APP。
- 物种名,如 Human。
- UniProt ID,如 P05067。
- 物种限定表达式,如 organism_id:9606。
还支持布尔运算符。
- and。
- or。
- not。
这对做精准筛选很重要。例如你可以同时限定蛋白名和物种,避免把不同物种的同名蛋白混在一起。
2.3 检索时最容易忽略的细节
Swiss-Prot 结果质量高,但前提是检索策略准确。常见问题有三类。
- 只输入模糊关键词,导致结果过多。
- 不限定物种,跨物种同源蛋白混入。
- 把基因名和蛋白名混用,造成理解偏差。
基因不等于蛋白。 这一点在自动化科研中尤其重要。基因层面的信息并不总能直接代表蛋白层面的功能、修饰和定位。Swiss-Prot 的价值之一,就是帮助研究者把“基因”转回“蛋白”这个真正的功能执行单位。
3. Swiss-Prot蛋白信息提取的核心字段
3.1 功能、结构与定位信息
Swiss-Prot 页面最常见、也最有价值的字段包括。
- Protein names,蛋白名称。
- Function,功能描述。
- Subcellular location,亚细胞定位。
- Domain and regions,结构域与区域。
- PTM/Processing,翻译后修饰。
这些字段对实验设计很实用。比如亚细胞定位可以帮助判断抗体、标记物和靶向药物是否合理。结构域信息则常用于构建设计、截短体构建和突变分析。
3.2 疾病、文献和交叉引用
Swiss-Prot 还会提供与疾病、文献和外部数据库的交叉信息。
- Literature citations,帮助追溯原始证据。
- Human diseases,适合疾病靶点研究。
- Cross-referenced databases,可跳转到结构库、通路库和化学库。
这类交叉引用是自动化分析的关键桥梁。 它让一个蛋白条目不再只是单点信息,而是一个可以连接文献、结构和通路的知识节点。
3.3 审核信息与证据等级
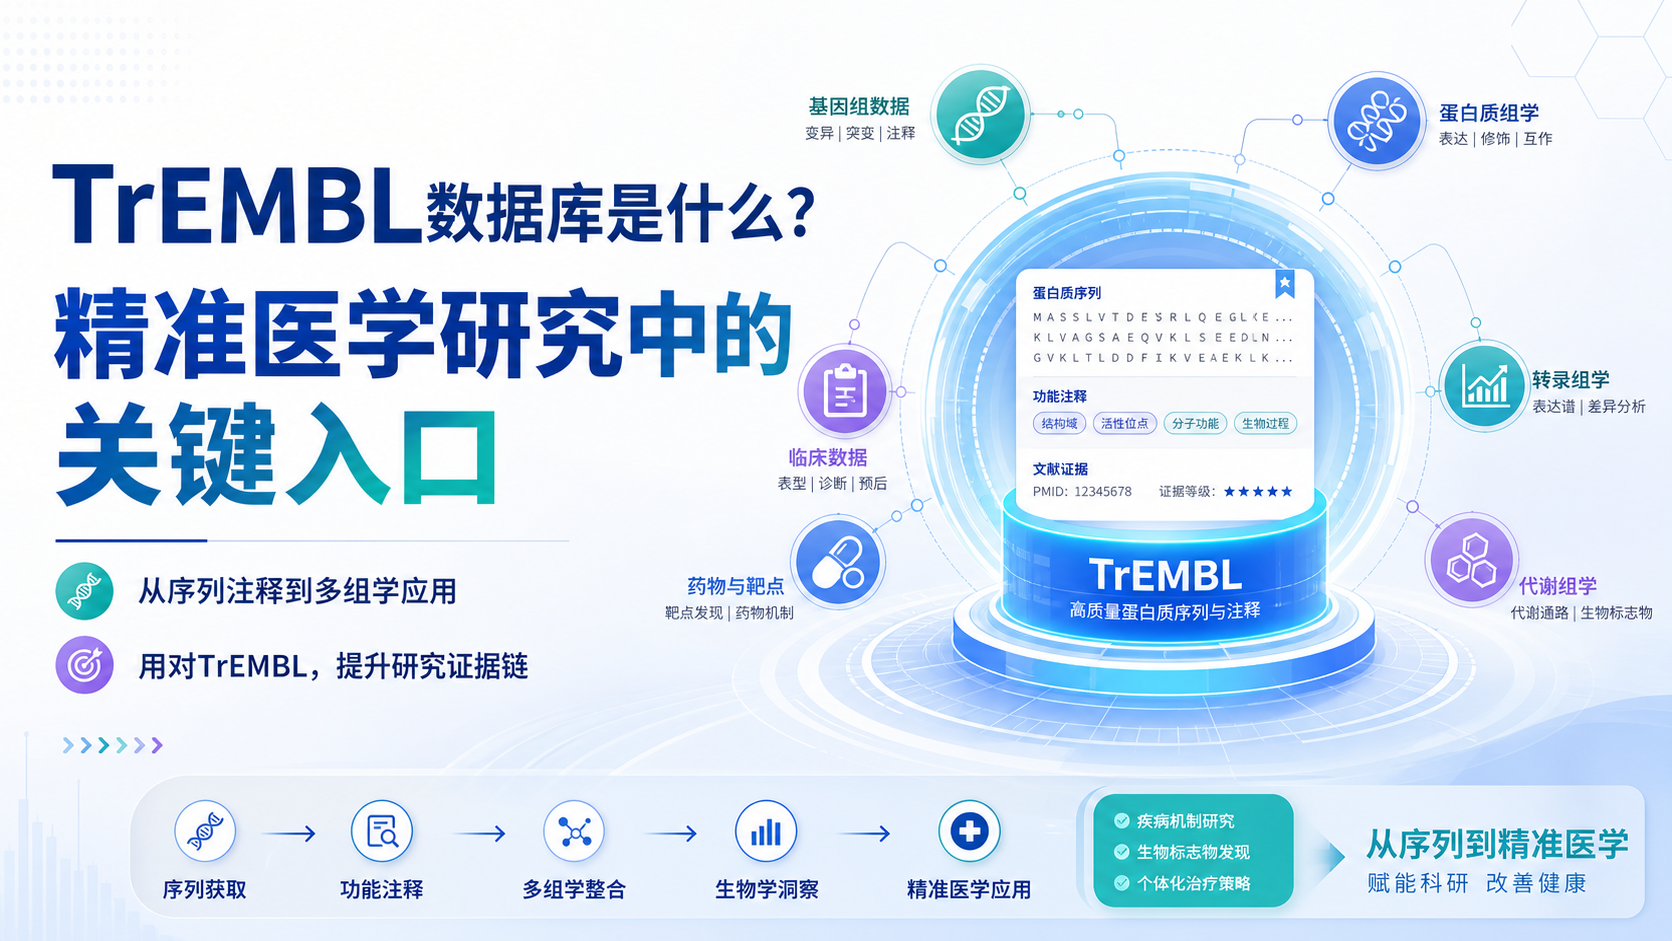
Swiss-Prot 与 TrEMBL 的区别,主要在于是否经过人工审核。Swiss-Prot 条目通常带有更完整的注释和更清晰的证据链。
在写论文、做课题和整理综述时,这种证据层级很重要。因为研究者常常需要说明某个蛋白功能是基于实验验证,还是基于自动注释推断。
4. Swiss-Prot在自动化科研中的实际用法
4.1 批量查询比单点查询更有价值
自动化科研的效率提升,往往来自批量处理。比如你有一组候选基因,需要快速拿到对应蛋白的综合信息。
传统做法是逐个打开数据库、复制名称、核对功能、再整理成表格。这个过程慢,而且容易漏项。
更高效的方式是。
- 先完成 ID 统一。
- 再批量映射到 UniProt。
- 提取 Swiss-Prot 注释。
- 汇总为结构化表格。
这个流程能把“人工查找”变成“标准化数据提取”。
4.2 BLAST、Align、Peptide Search的辅助价值
UniProt 还提供多个实用功能。
- BLAST,可快速寻找同源序列。
- Align,可比对多个蛋白序列。
- Peptide Search,可根据短肽序列找可能包含它的蛋白。
- ID mapping,可做标识符转换。
这些工具和 Swiss-Prot 配合使用,能显著提升分析效率。
例如在设计多肽时,先用 Peptide Search 确认短肽是否具有特异性,再结合 BLAST 观察潜在同源性,是比较稳妥的流程。
4.3 为什么“信息提取”比“单纯检索”更重要
很多研究停留在“查到蛋白名字”这一步,但真正有价值的是把字段提取出来,用于后续分析。
常见用途包括。
- 构建候选靶点表。
- 整理疾病相关蛋白清单。
- 做通路富集前的蛋白标准化。
- 为自动化注释或机器学习建模准备输入数据。
换句话说,Swiss-Prot 的真正价值,不在于网页本身,而在于它能否被转化为可计算的数据。
5. 从手工整理到自动化调用,如何提升效率
5.1 传统流程的瓶颈
手工使用数据库时,问题主要集中在三个方面。
- 数据分散,多个页面来回切换。
- 格式不统一,后续整理成本高。
- 人工复制容易出错。
尤其是多基因、多蛋白项目,这种低效会迅速放大。一个 10 个基因的任务,人工可能需要半天;如果是上百个条目,时间成本会成倍增加。
5.2 自动化流程的核心思路
比较成熟的自动化流程通常包括。
- 输入基因或蛋白 ID。
- 统一映射到 UniProt 标识符。
- 抓取 Swiss-Prot 优先条目。
- 导出功能、定位、疾病和文献字段。
- 生成可直接用于统计分析的表格。
这类流程把数据库查询从“重复劳动”变成“可复用流程”。 对科研团队来说,长期收益非常明显。
5.3 适合科研团队的落地方式
如果团队经常处理蛋白功能注释、候选靶点筛选或疾病机制分析,建议建立统一的数据提取模板。
模板里至少应包含。
- UniProt ID。
- Swiss-Prot/TrEMBL 标记。
- 蛋白名称。
- 功能注释。
- 亚细胞定位。
- 文献引用。
- 疾病关联。
这样后续做统计、可视化和报告撰写时,就不需要重复返工。
6. 结语:让Swiss-Prot真正服务自动化科研
Swiss-Prot 的优势很明确。它注释质量高、字段结构清晰、适合批量提取,也适合与其他数据库联动 。对于医学生、医生和科研人员来说,掌握它,不只是会查一个蛋白,更是学会把蛋白知识转成可用数据。
如果你的工作涉及蛋白功能整理、ID 映射、靶点筛选或批量注释,建议把 Swiss-Prot 纳入标准流程。想进一步提高效率,可以借助 解螺旋 的数据库调用和自动化整理能力,把原本分散的蛋白信息提取、汇总和分析,变成更稳定、更省时的科研工作流。
当数据提取更标准,后续分析、写作和转化就会更快一步。
- 引言Introduction
- 1. Swiss-Prot数据库为什么是蛋白研究的高可信入口
- 2. 如何在UniProt中快速定位Swiss-Prot蛋白
- 3. Swiss-Prot蛋白信息提取的核心字段
- 4. Swiss-Prot在自动化科研中的实际用法
- 5. 从手工整理到自动化调用,如何提升效率
- 6. 结语:让Swiss-Prot真正服务自动化科研