


资讯
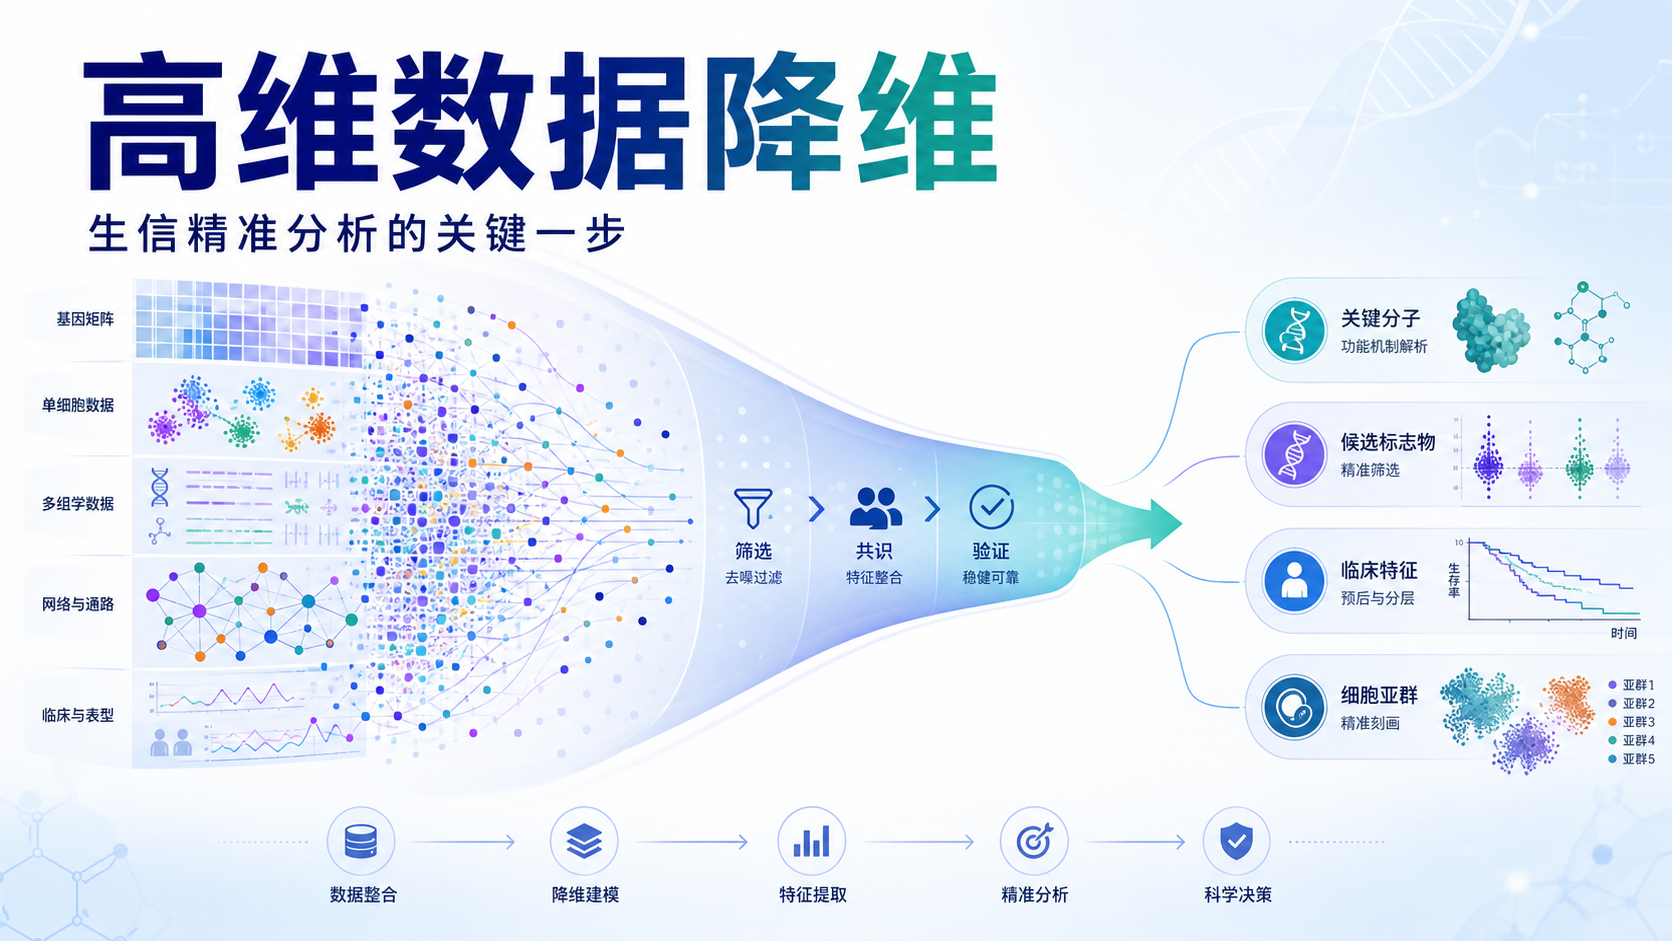 高维生物数据常让研究者陷入两难。变量太多,噪声也多。信号容易被淹没,模型也容易过拟合。对医学生、医生和科研人员来说,真正的难点不是“有没有数据”,而是如何把高维数据降维到可解释、可验证、可转化的层面。阅读163 · 点赞0生信Dr.Xin 于2026-07-21发布
 无监督聚类是生信中最常见、也最容易被重复劳动拖慢的分析环节。很多人会做单个热图,却难以把数据清洗、降维、聚类、作图、结果解释串成完整流程。真正的痛点,不是不会做,而是每一步都要重新开始。阅读87 · 点赞0生信Dr.Xin 于2026-07-21发布
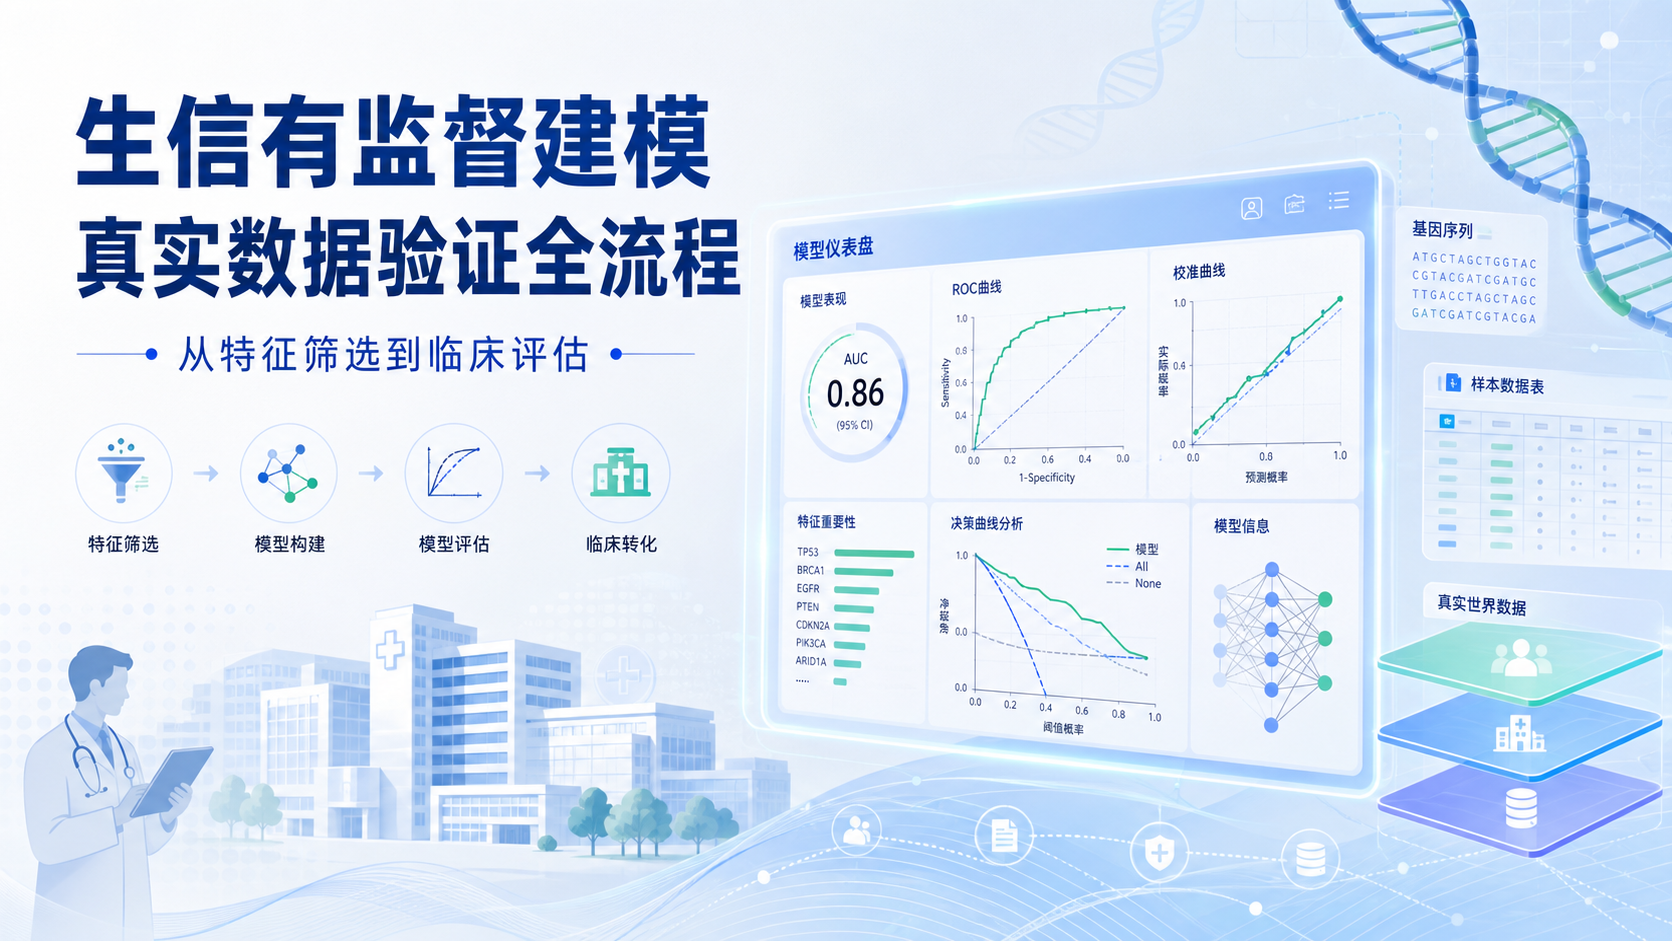 生信有监督建模看起来流程清晰,但真正难的是效能评估。训练集表现好,不代表真实数据也好。很多模型卡在过拟合、外部验证失败、临床解释弱这三关。如何用真实数据判断模型是否能用,才是决定文章质量的关键。阅读103 · 点赞0生信Dr.Xin 于2026-07-21发布
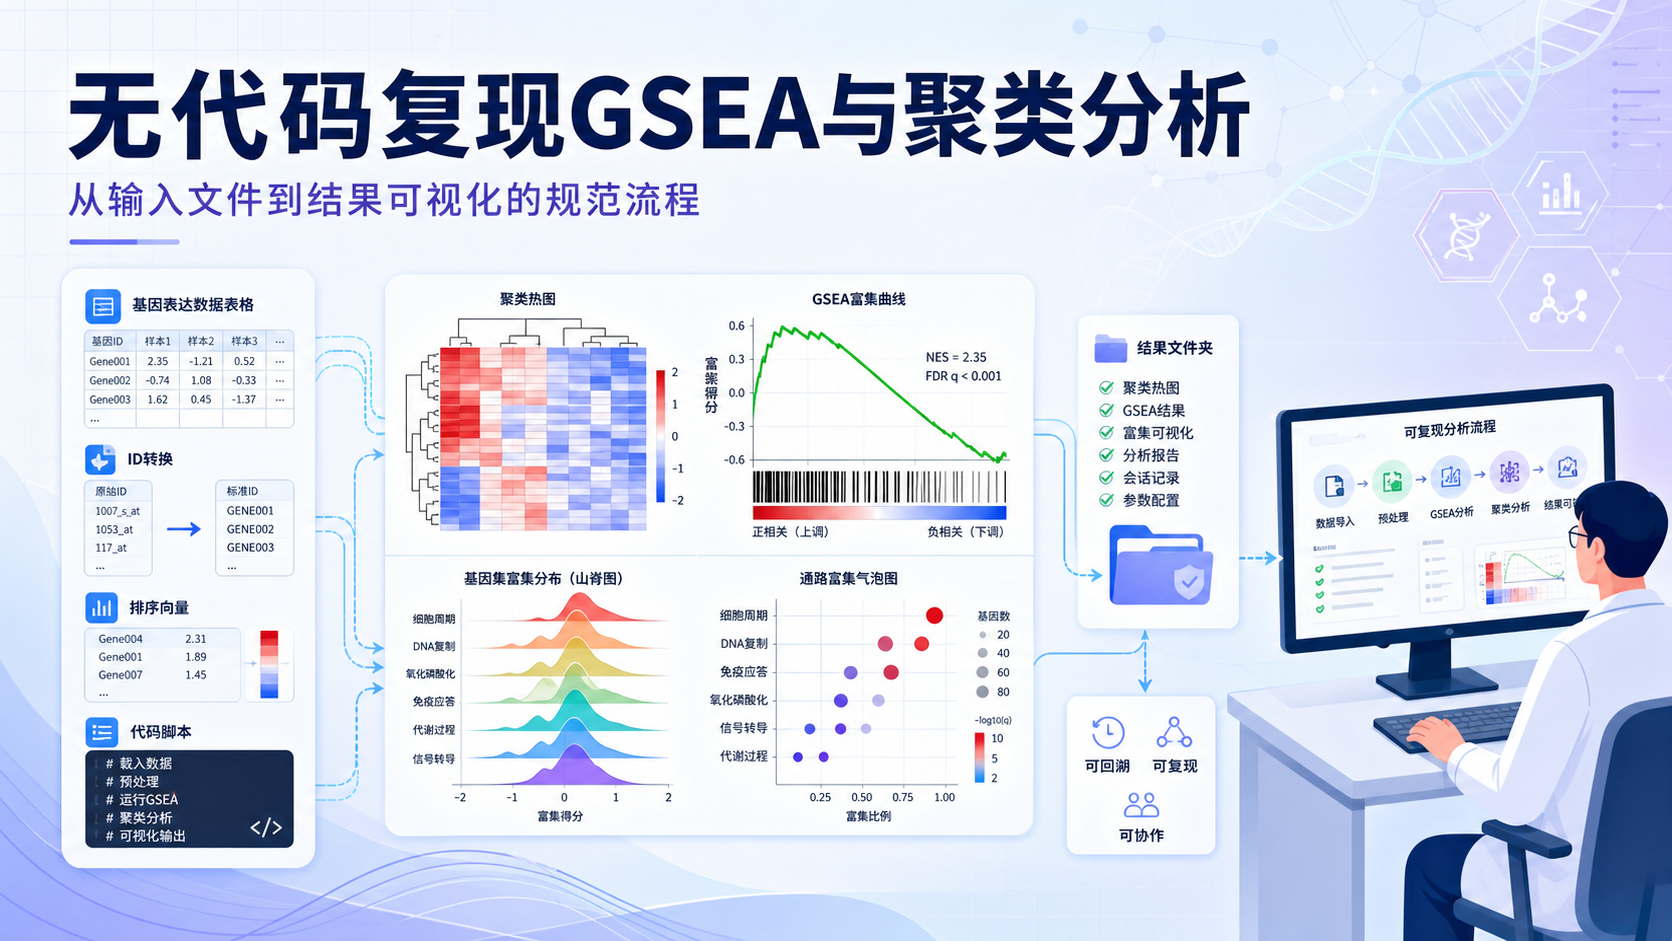 在生信分析里,很多人卡在两件事。第一,GSEA结果看得懂,但复现不稳定。第二,聚类图能画出来,却不知道如何把分析流程串起来。如果你希望用更少代码复现一套可追溯、可视化完整的生信流程,这篇文章会直接帮你理清思路。阅读170 · 点赞0生信Dr.Xin 于2026-07-21发布
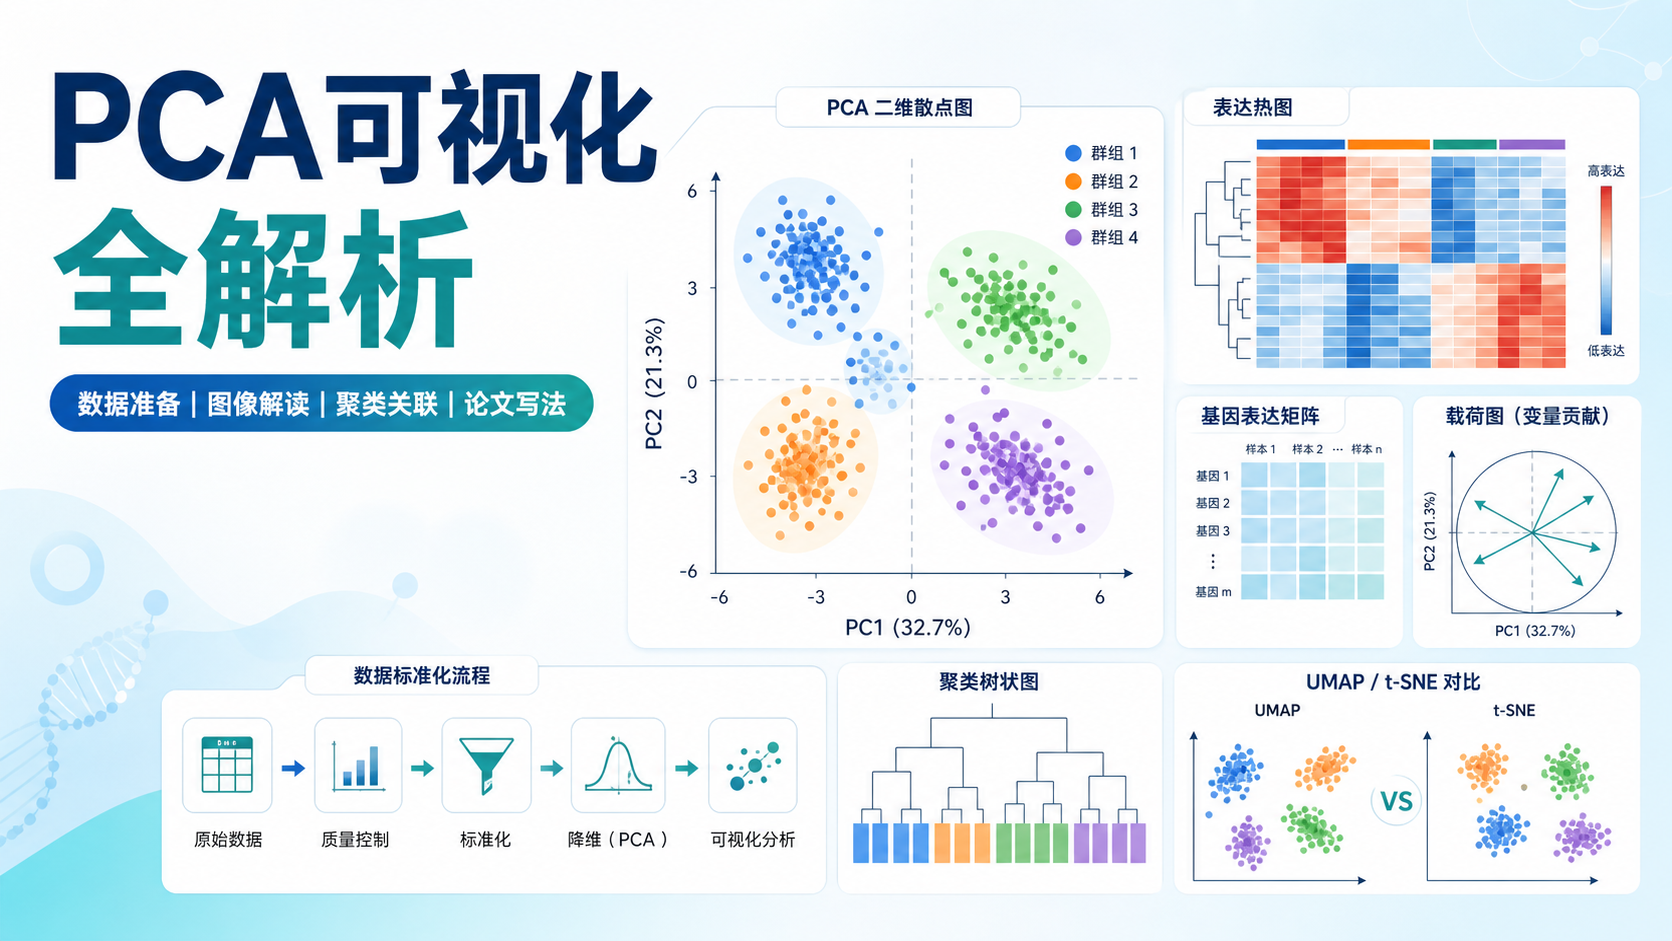 单细胞和转录组数据常见的问题是维度高、噪音大、样本关系复杂。直接看表达矩阵,很难判断样本是否分群、批次是否干扰、主变化来自哪里。PCA可视化正是把复杂数据压缩成可解释结构的关键一步。阅读203 · 点赞0生信Dr.Xin 于2026-07-21发布
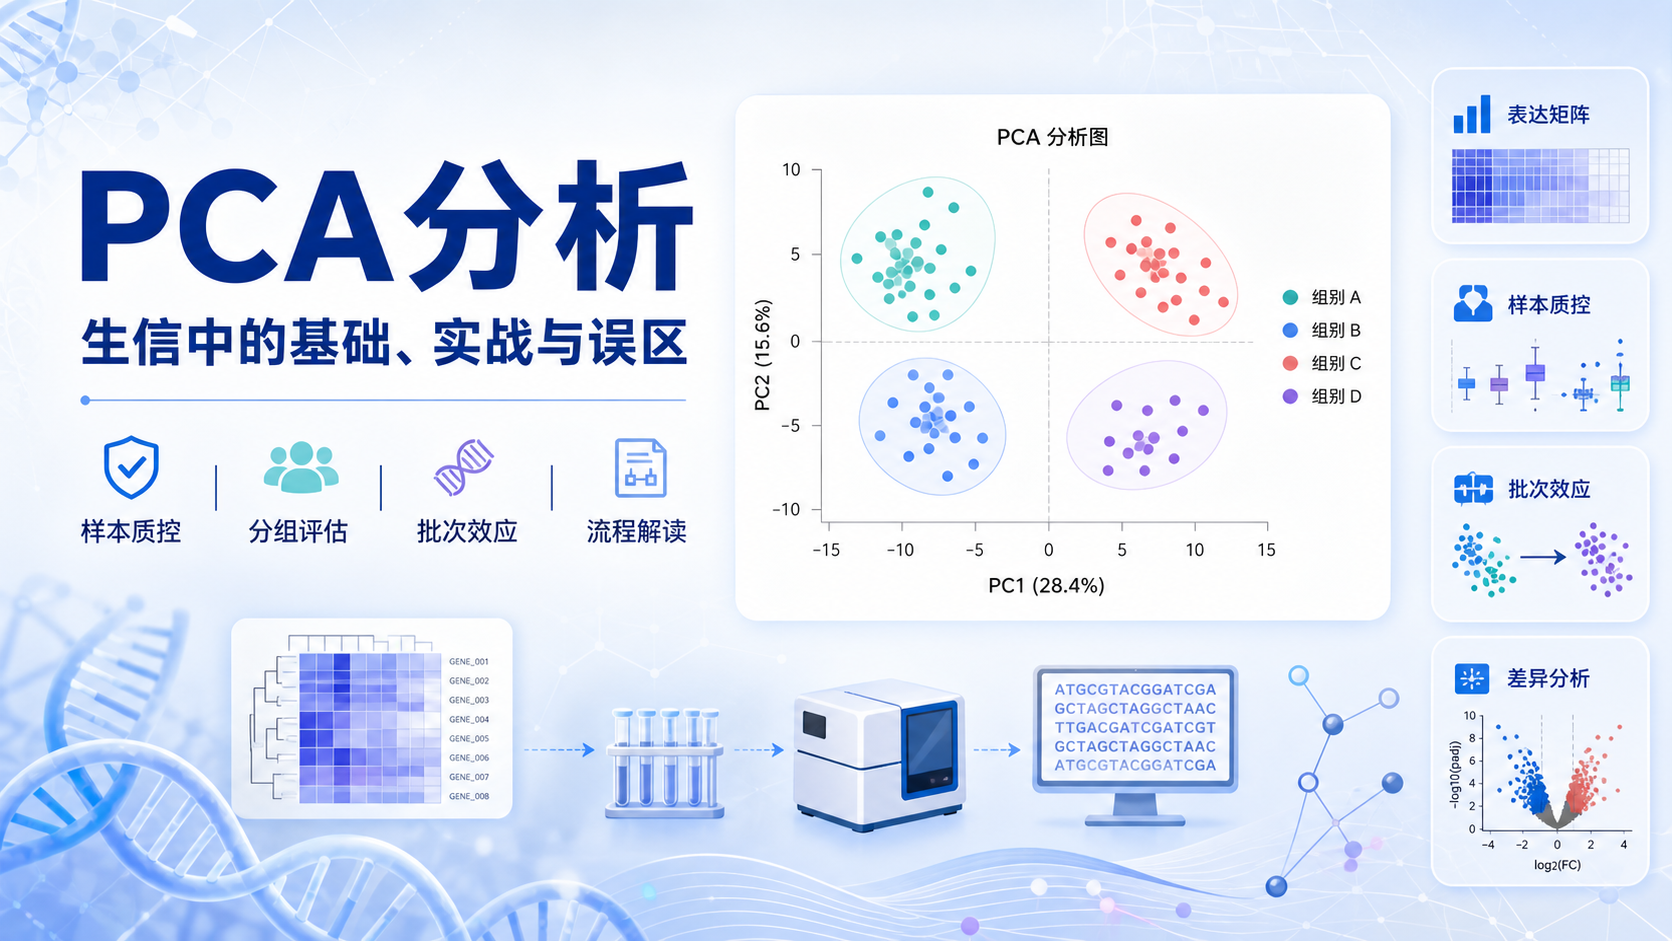 PCA分析是生信数据质控和降维的第一步。很多人拿到表达矩阵后,最先卡住的不是差异分析,而是样本是否可靠,分组是否清晰,批次效应是否明显。如果PCA图都不稳定,后续差异分析、聚类和模型构建往往会失真。阅读195 · 点赞0生信Dr.Sheng 于2026-07-20发布
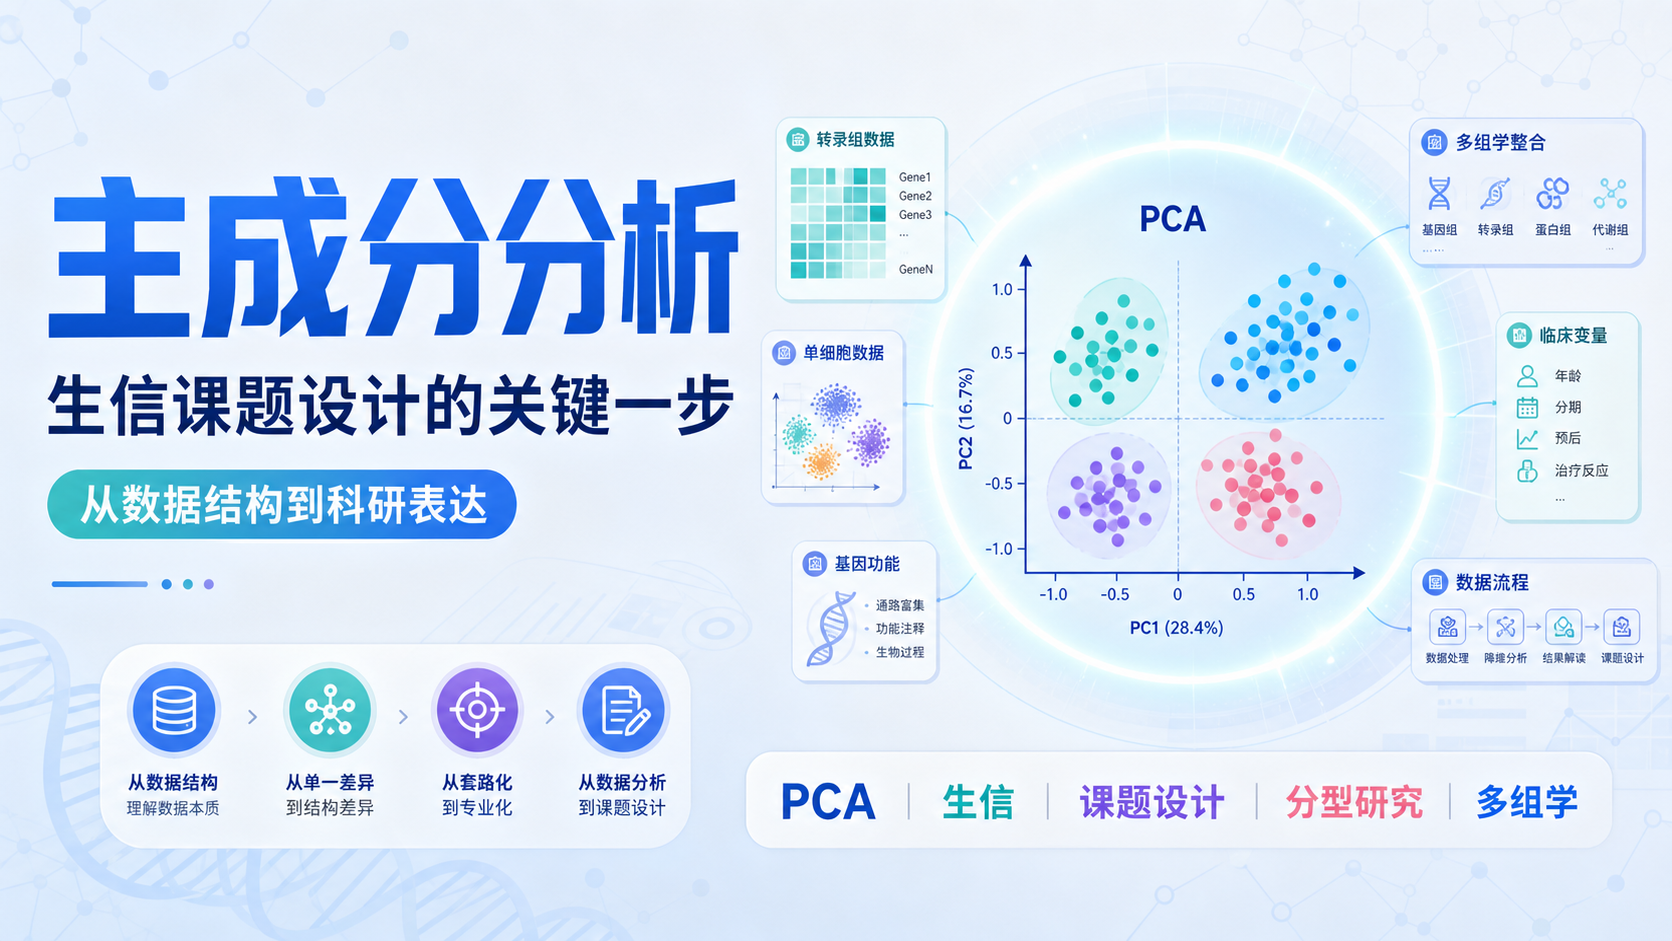 生信研究越来越容易“撞题”。只做差异分析、富集分析、PPI网络,结论往往同质化。主成分分析提供了另一条路。它能先判断样本是否分群、变量是否聚类,再帮助你更快锁定真正有信息量的维度。阅读102 · 点赞0生信Dr.Sheng 于2026-07-20发布
 聚类分析是生信数据挖掘中最常见,也最容易被误用的步骤之一。很多人拿到表达矩阵后急于画图,却忽略了数据预处理、距离度量和结果解释,导致分群不稳定、结论不可靠。想把聚类分析真正用在生信研究中,必须先理解它的适用场景、输入数据和常见陷阱。阅读138 · 点赞0生信Dr.Sheng 于2026-07-20发布
 K-means聚类是生信中最常用的无监督分型方法之一。它适合从高维、噪声多、标签缺失的肿瘤数据里,先把“可能的亚型”找出来。但很多人只会跑算法,不会解释结果,也不会把分型和免疫微环境、预后、临床变量串起来。阅读87 · 点赞0生信Dr.Sheng 于2026-07-20发布
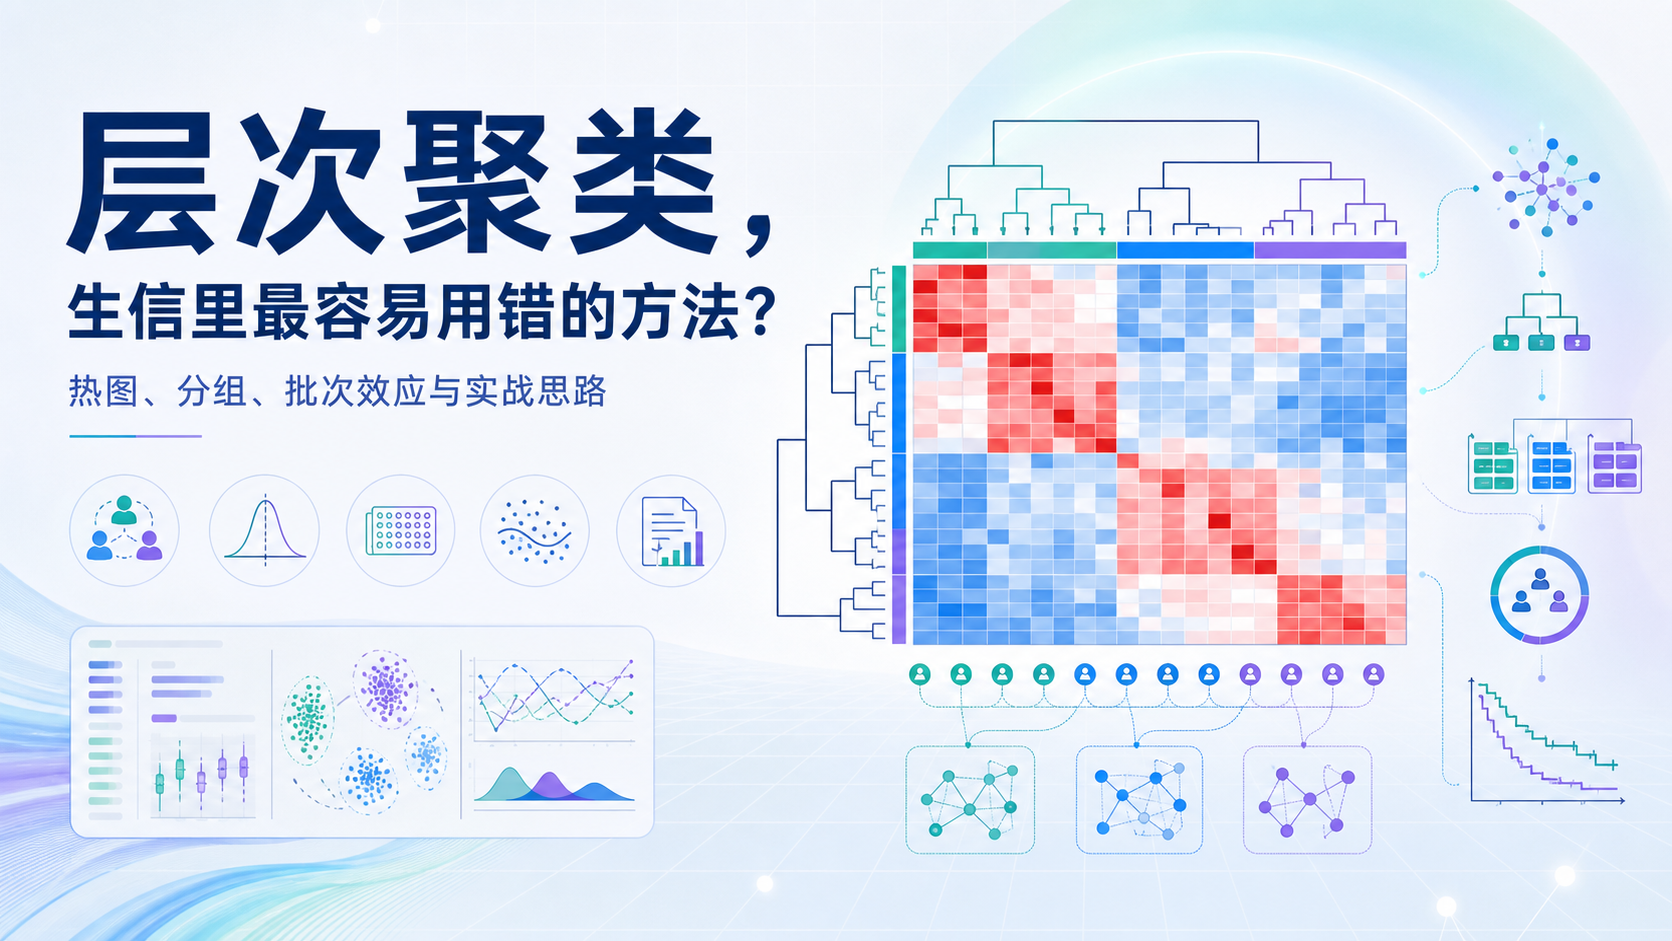 层次聚类是生信分析里最常用的无监督方法之一。很多人会做热图,却不清楚它为什么能把样本分成不同分支,也不知道结果能否解释疾病亚型、通路差异或样本异质性。如果你想把“看图”变成“读图”,就必须先理解层次聚类。阅读115 · 点赞0生信Dr.Sheng 于2026-07-20发布
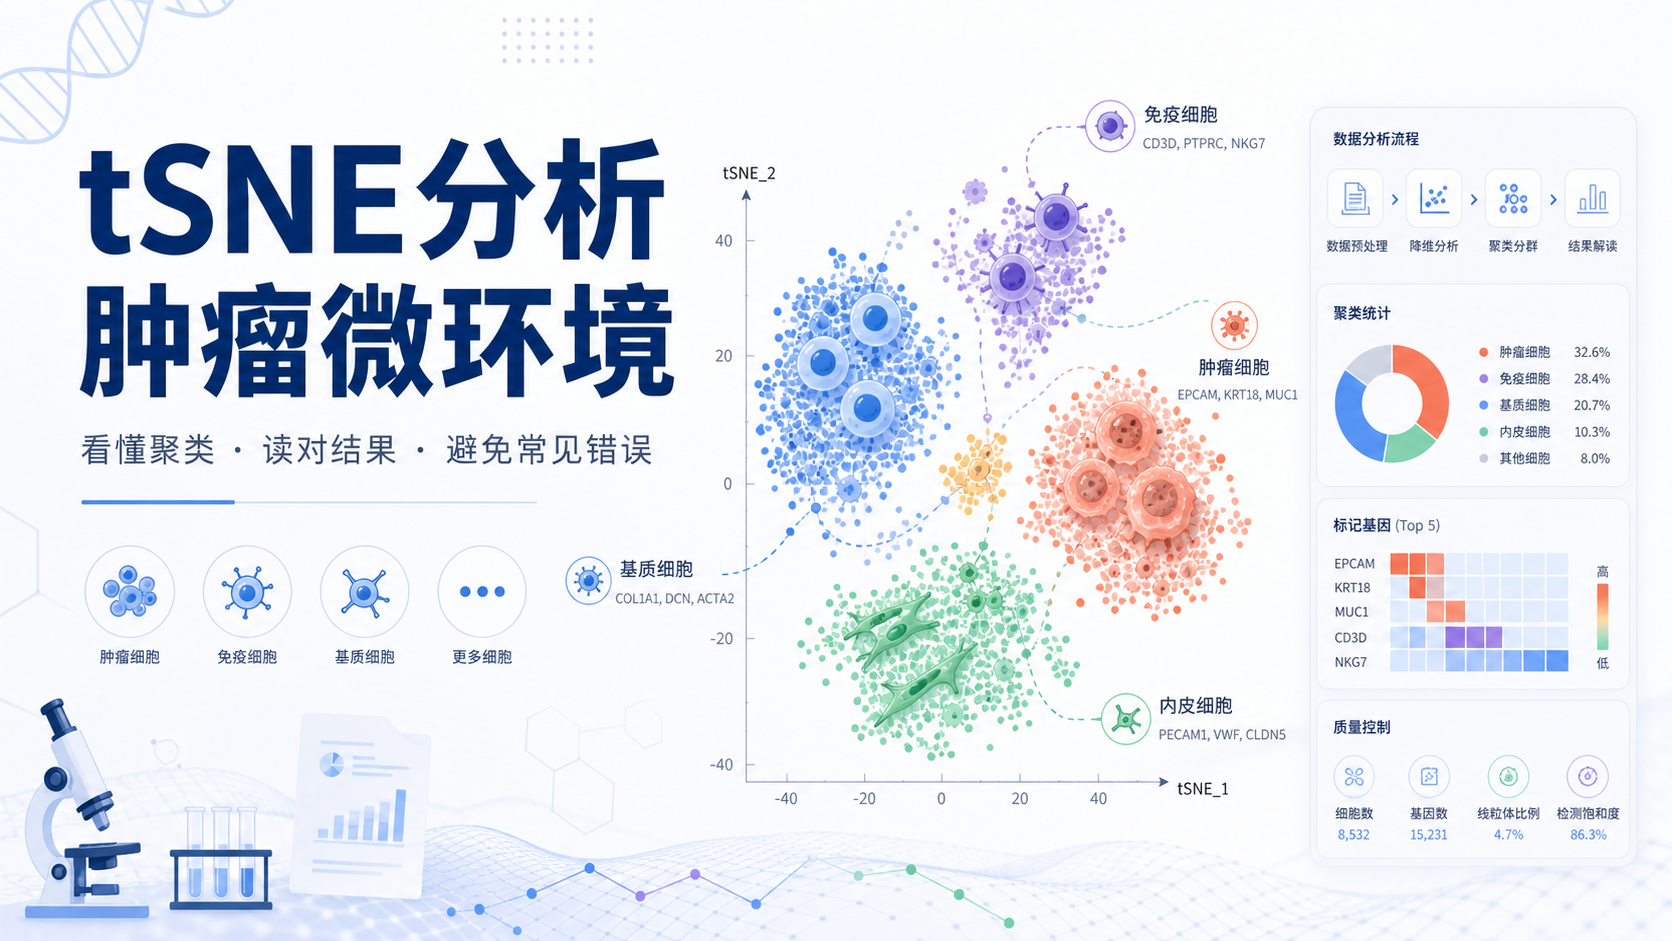 tSNE常被用于单细胞和高维组学数据可视化,但很多人只会“跑图”,不会解释图,更不会把结果和肿瘤微环境异质性联系起来。真正有价值的不是图形本身,而是图背后的细胞分群、空间分离和生物学解释。阅读115 · 点赞0生信Dr.Sheng 于2026-07-20发布
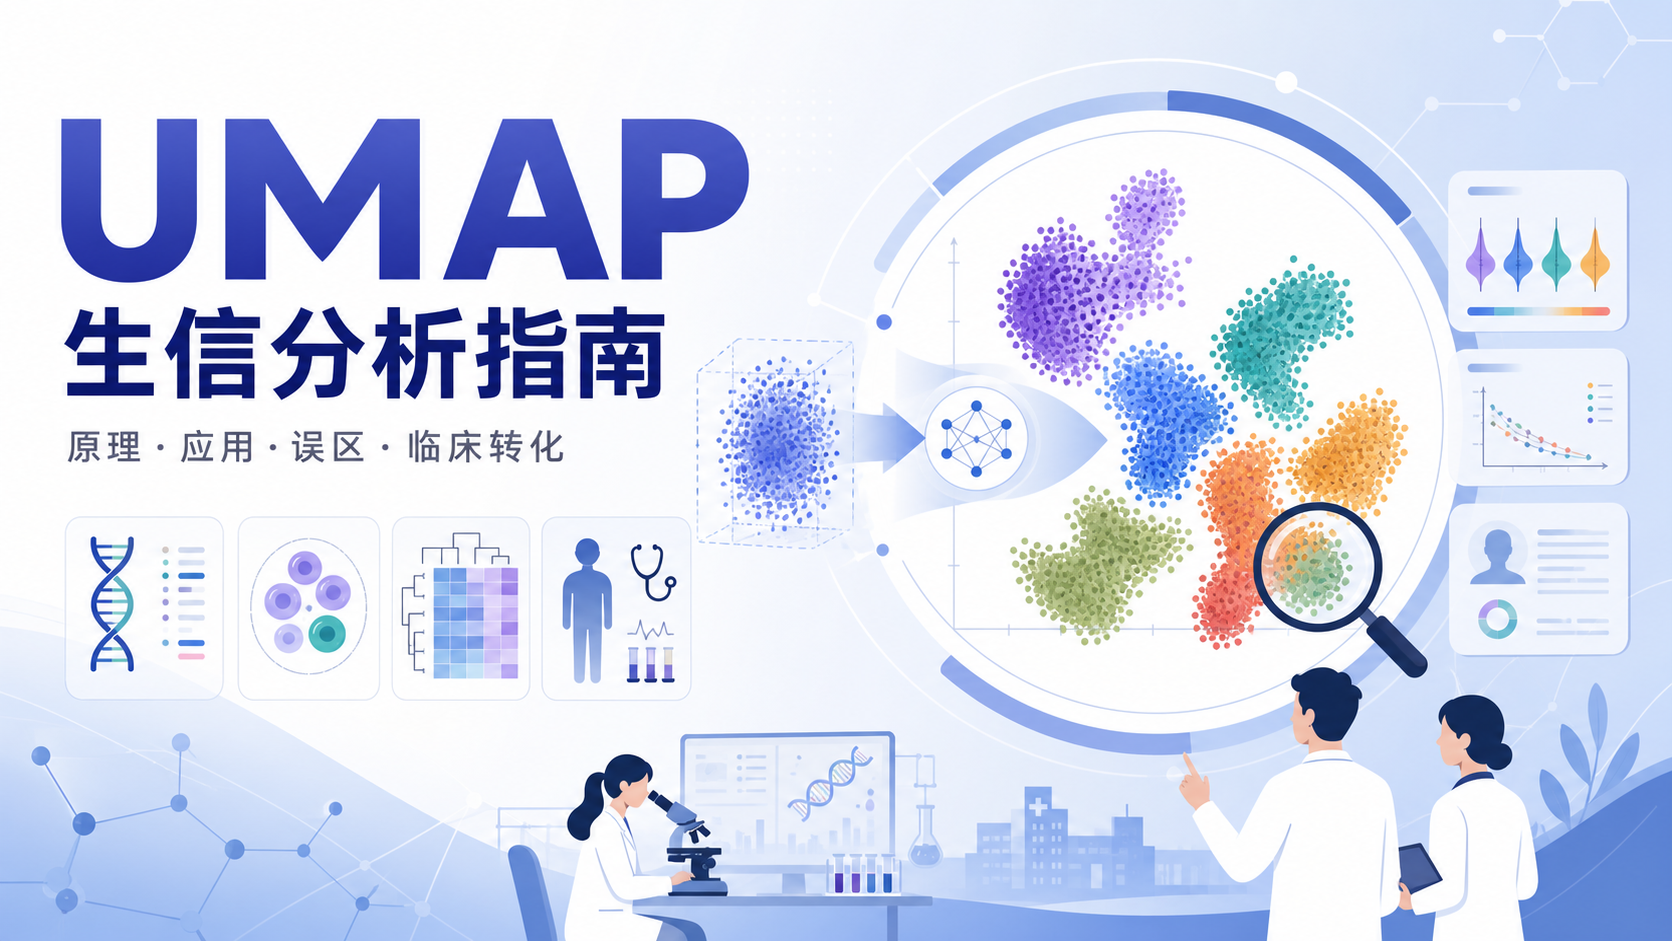 UMAP降维是生信分析里最常见、也最容易被误用的步骤之一。很多人会画图,却说不清它和PCA、t-SNE的差别,更不知道结果能否用于临床解释。如果你正在处理单细胞、组学或高维临床数据,这一步做错,后面整套分析都可能失真。阅读146 · 点赞0生信Dr.Sheng 于2026-07-20发布
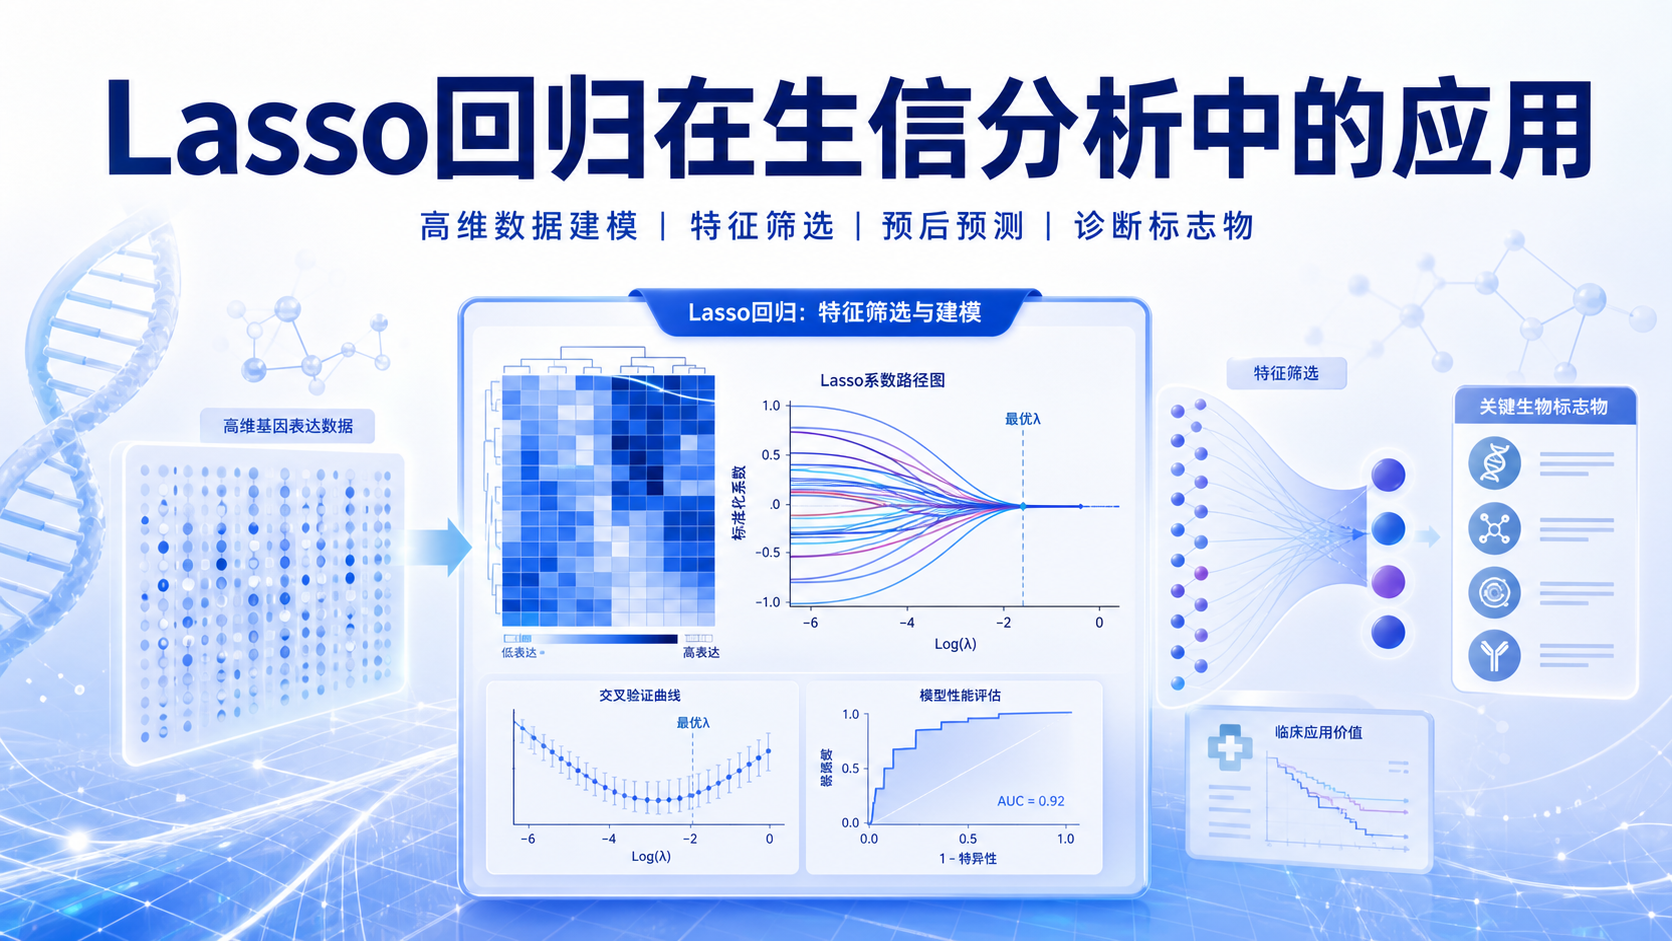 在生信研究里,变量多、样本少几乎是常态。基因表达、蛋白质、临床表型一起进模型,结果常常是过拟合、共线性、难解释。Lasso回归建模正是解决这类问题的常用工具,它能在高维数据中筛出更稳、更少、更可解释的候选特征。阅读170 · 点赞0生信Dr.Sheng 于2026-07-20发布
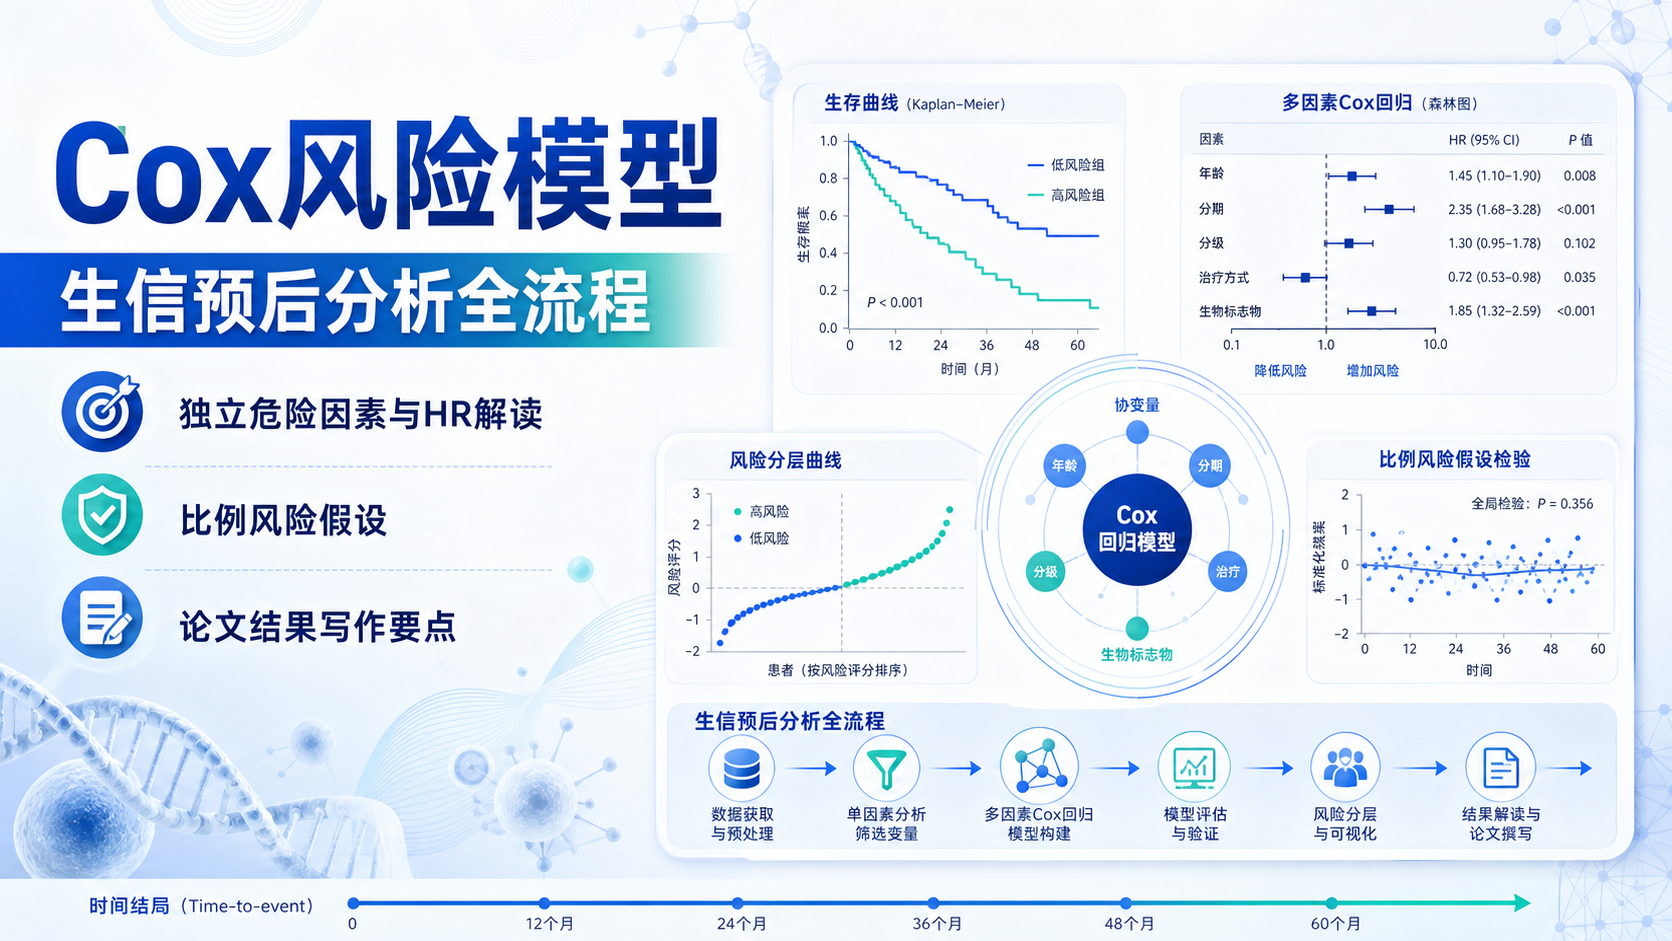 在生信预后研究里,很多人能做出生存曲线,却难以回答“哪些因素是独立危险因素”和“风险到底高多少”这两个核心问题。Cox风险模型正是把时间结局、协变量和风险比统一起来的关键工具。阅读180 · 点赞0生信Dr.Sheng 于2026-07-20发布
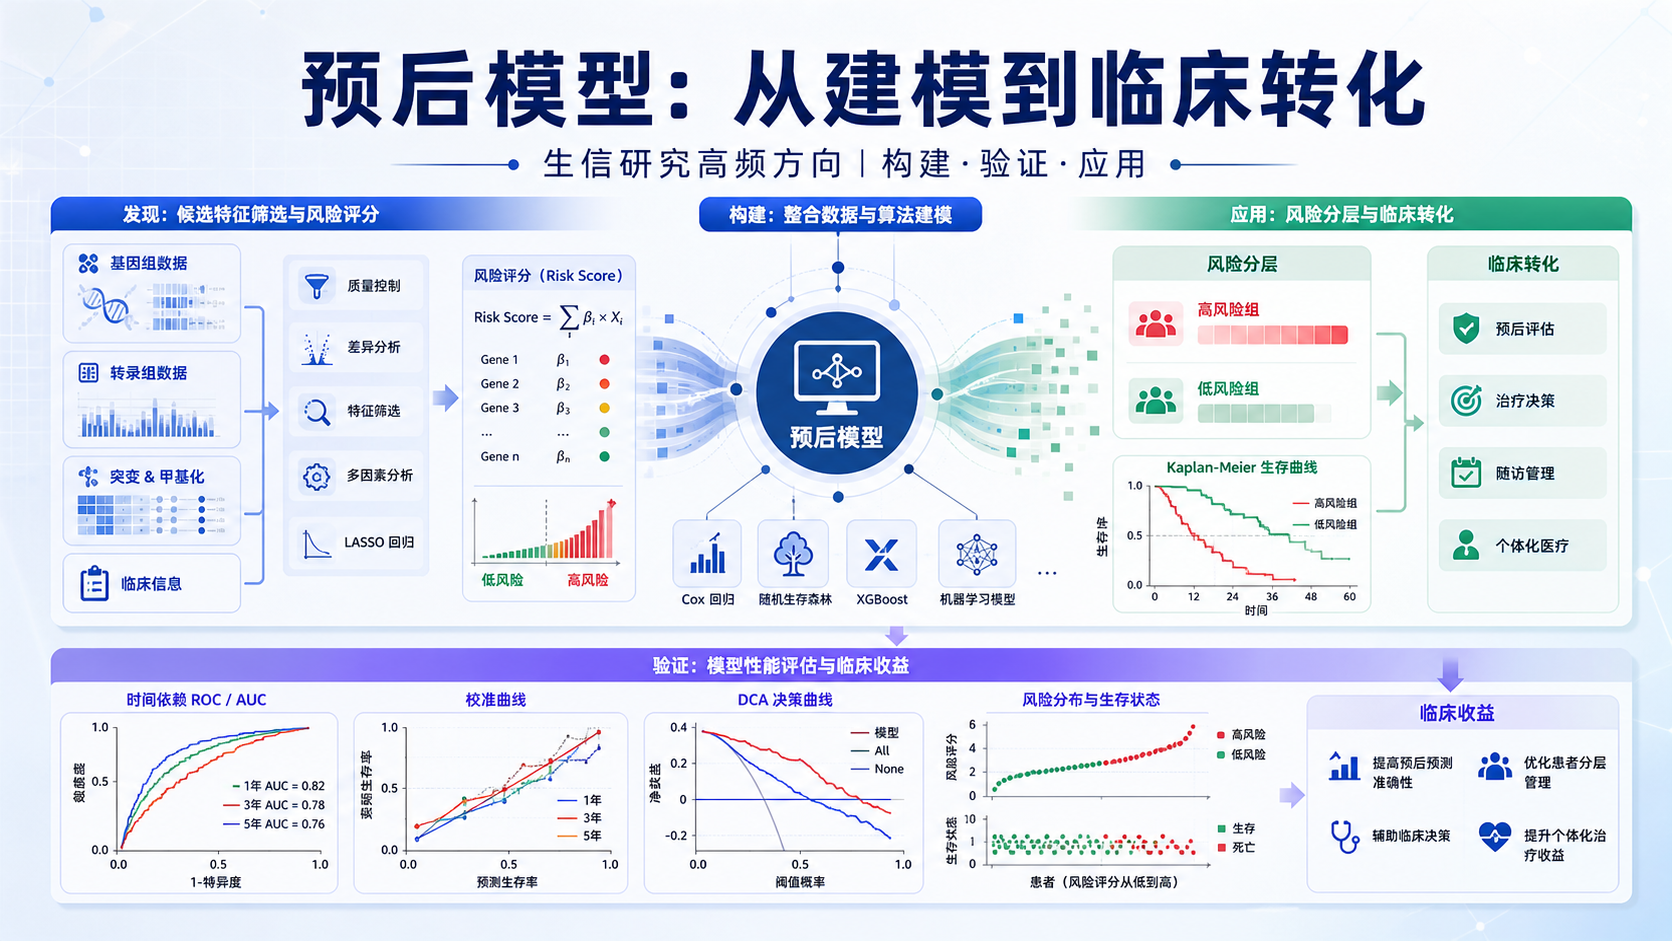 生信预后模型看起来“套路成熟”,但真正难的是把数据挖掘结果做成可验证、可解释、可转化的模型。很多研究停在Lasso筛基因或画出列线图,后续的校准、区分和临床获益分析却不完整,导致模型很难进入临床视野。阅读151 · 点赞0生信Dr.Sheng 于2026-07-20发布
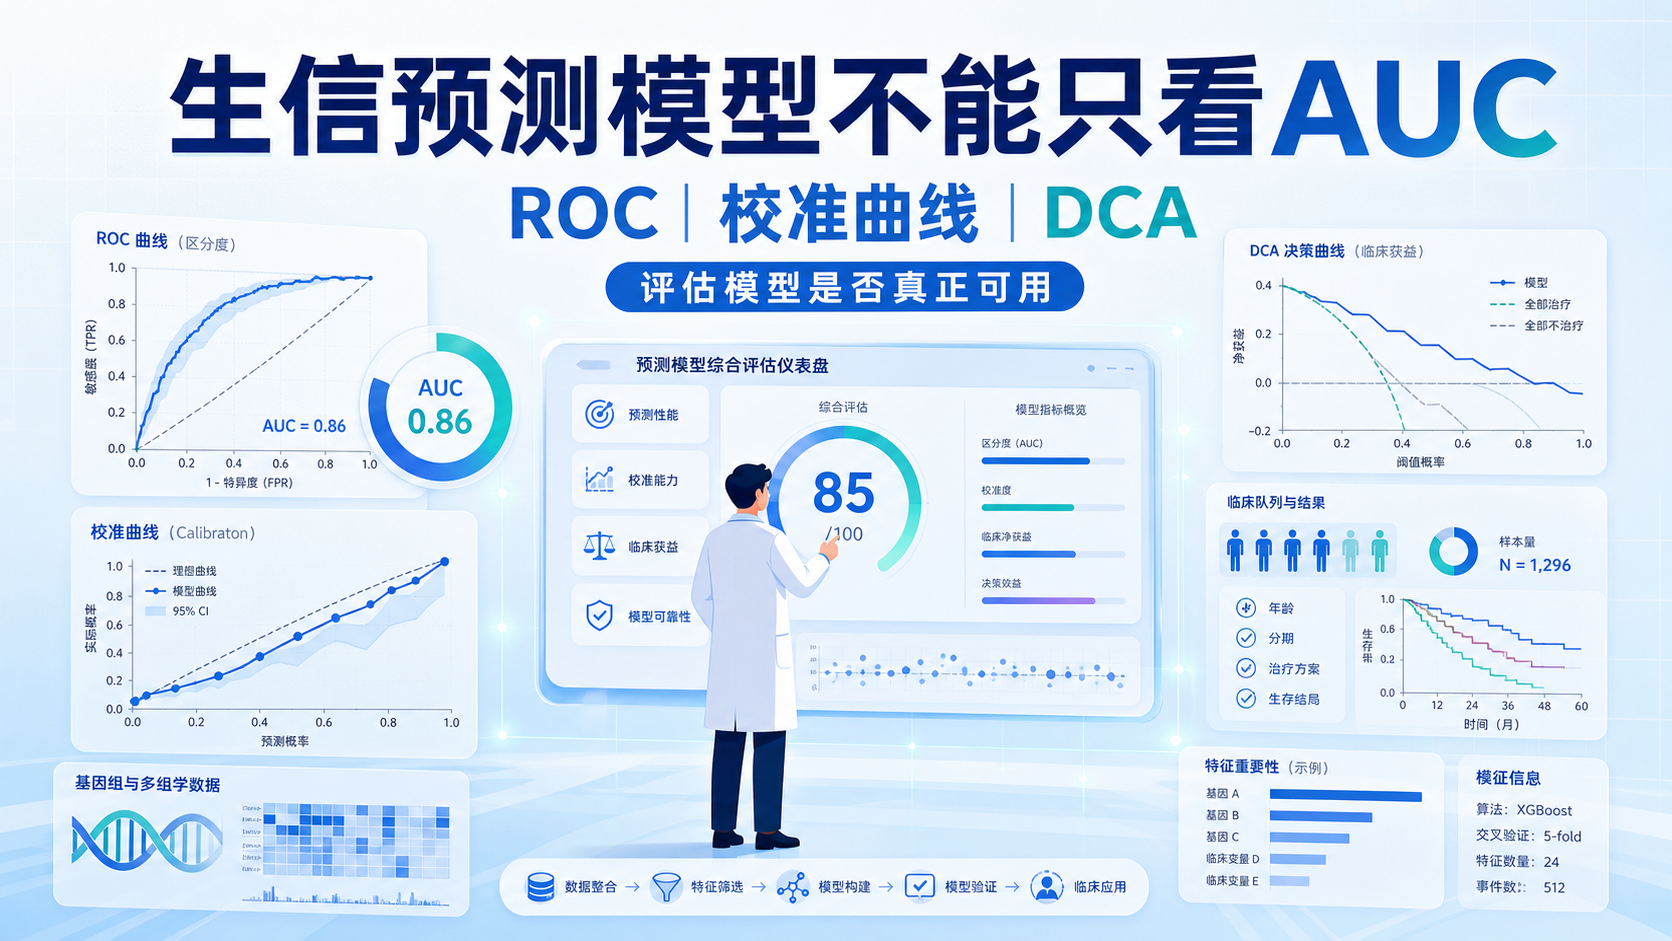 生信预测模型看似复杂,真正拉开差距的,往往不是算法名字,而是指标选得对不对。很多研究卡在“能建模”,却难以做到“能验证、能发表、能转化”。构建高质量生信预测模型,核心是看模型是否稳、是否准、是否能用于临床解释。阅读107 · 点赞0生信Dr.Sheng 于2026-07-20发布
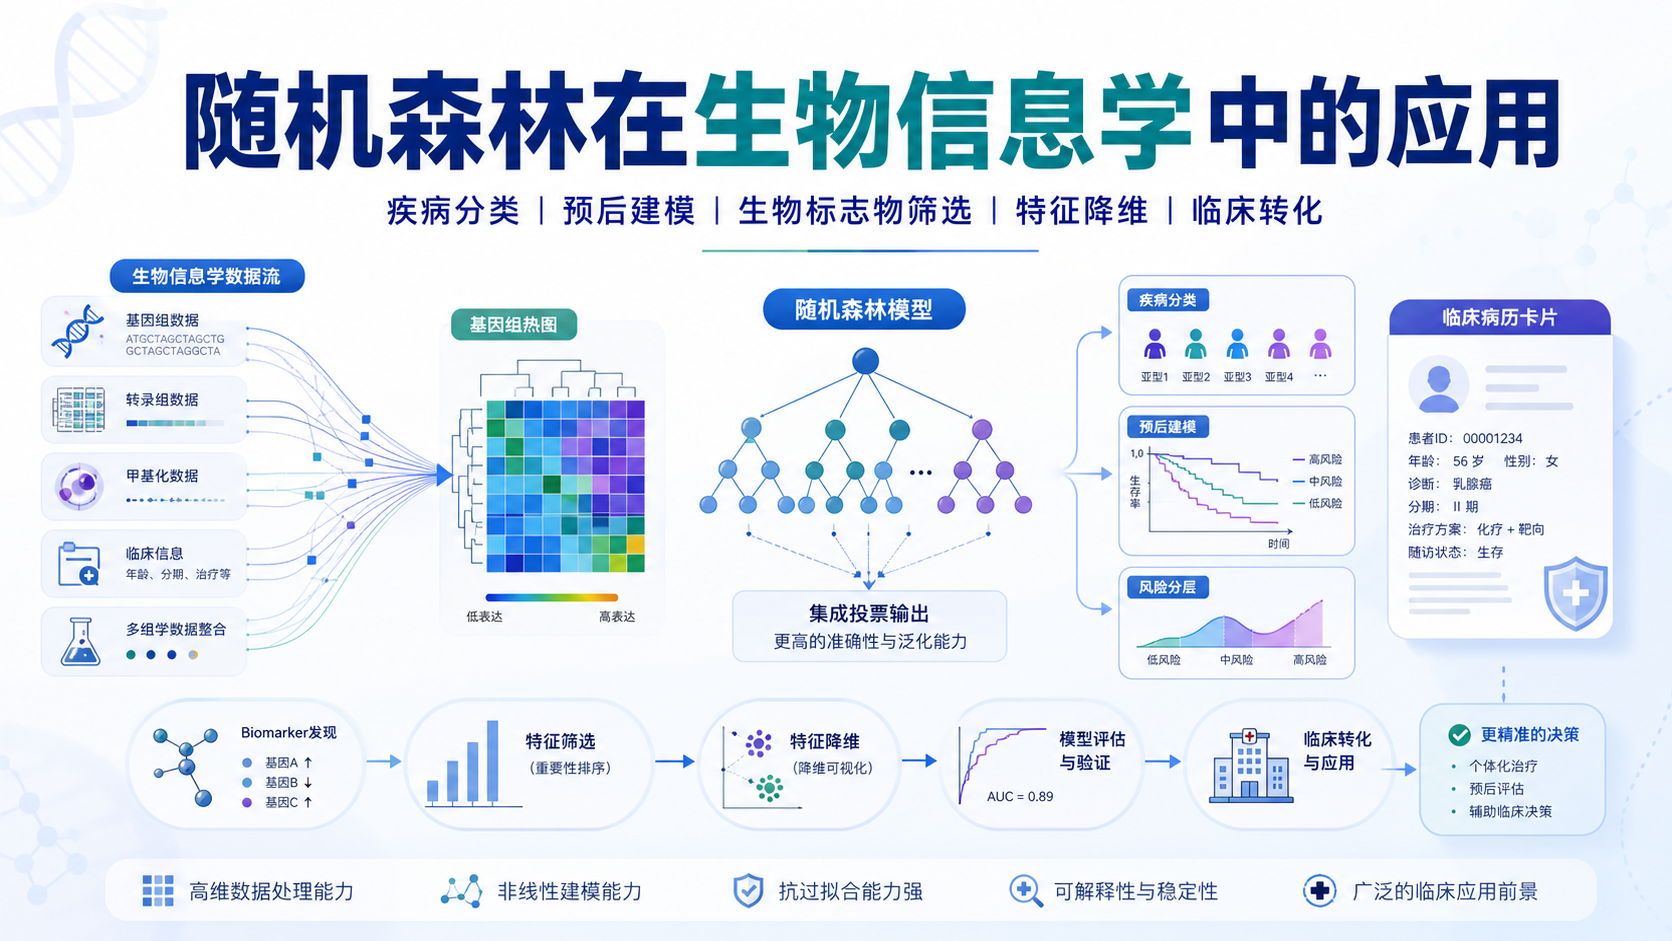 随机森林在生信里很常见,但很多人只会“跑模型”,不会选场景,也不会解读结果。如果你想把高维组学数据真正用起来,就必须知道它适合解决什么问题,哪些地方最容易踩坑。阅读109 · 点赞0生信Dr.Sheng 于2026-07-20发布
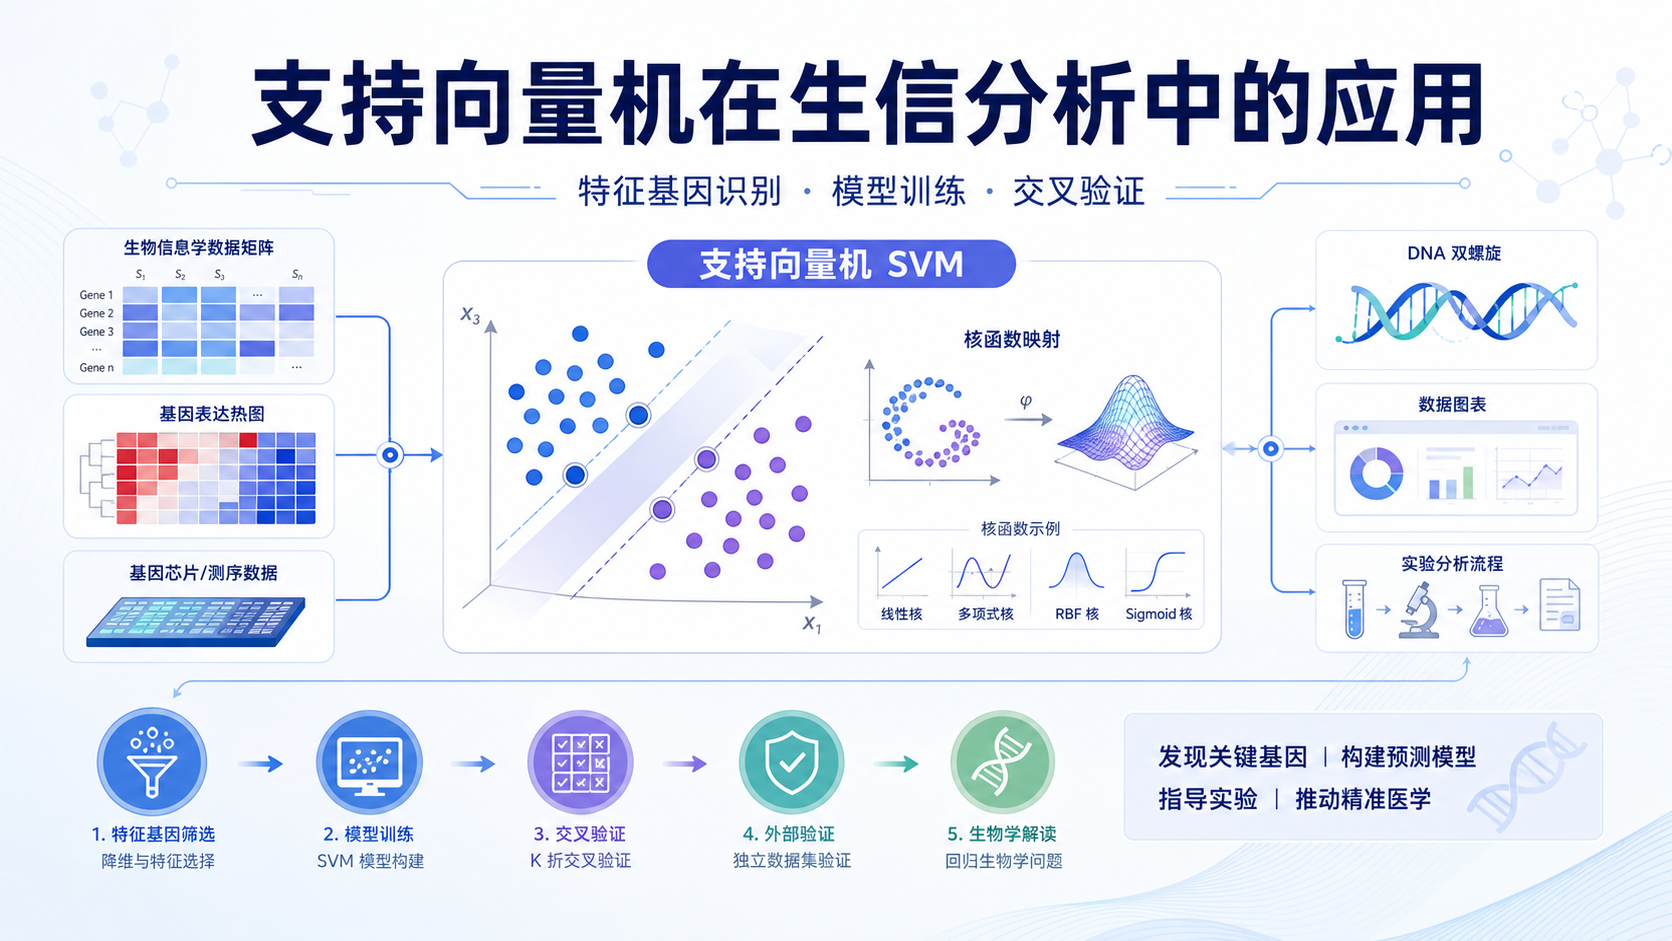 在生信分析中,特征很多,噪音也很多。如何从海量基因里筛出真正有价值的特征基因,是很多医学生和科研人员最常见的难题。支持向量机因其适合高维、小样本数据,常被用于构建稳定的分类模型和筛选关键分子。阅读108 · 点赞0生信Dr.Sheng 于2026-07-20发布
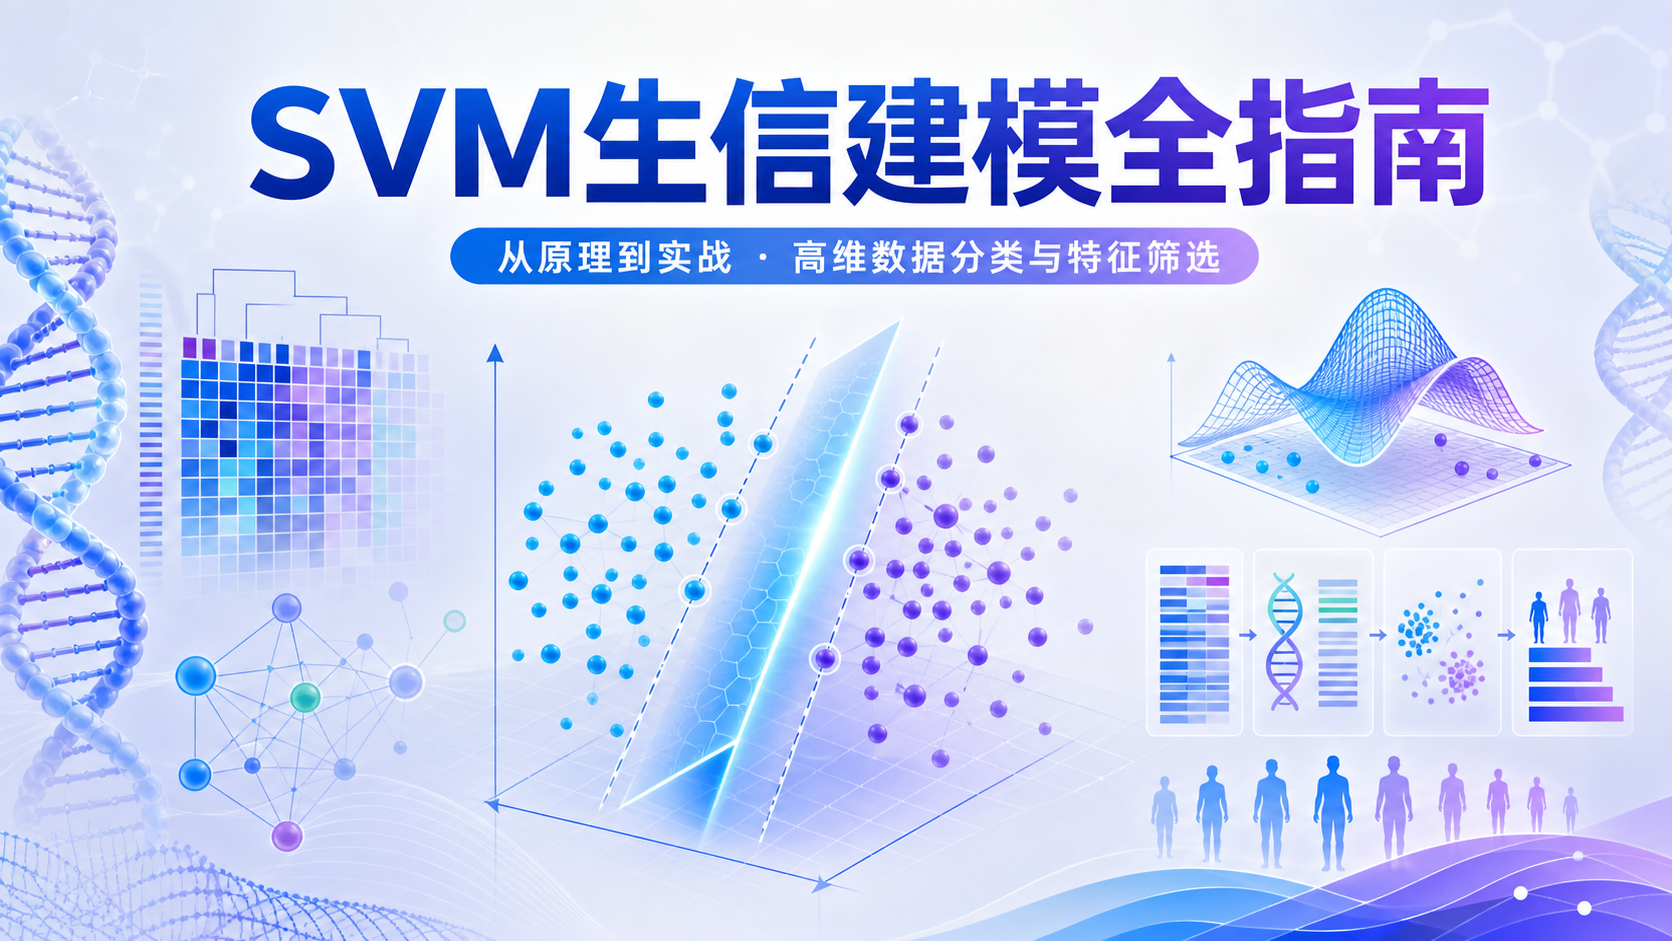 在生信分析中,样本少、特征多、噪声大,是很多研究者都会遇到的难题。传统模型常出现过拟合,分类边界也不够稳健。SVM在这类场景里常被用来做分类、筛选和建模,因为它更关注边界与泛化能力。阅读100 · 点赞0生信Dr.Sheng 于2026-07-20发布
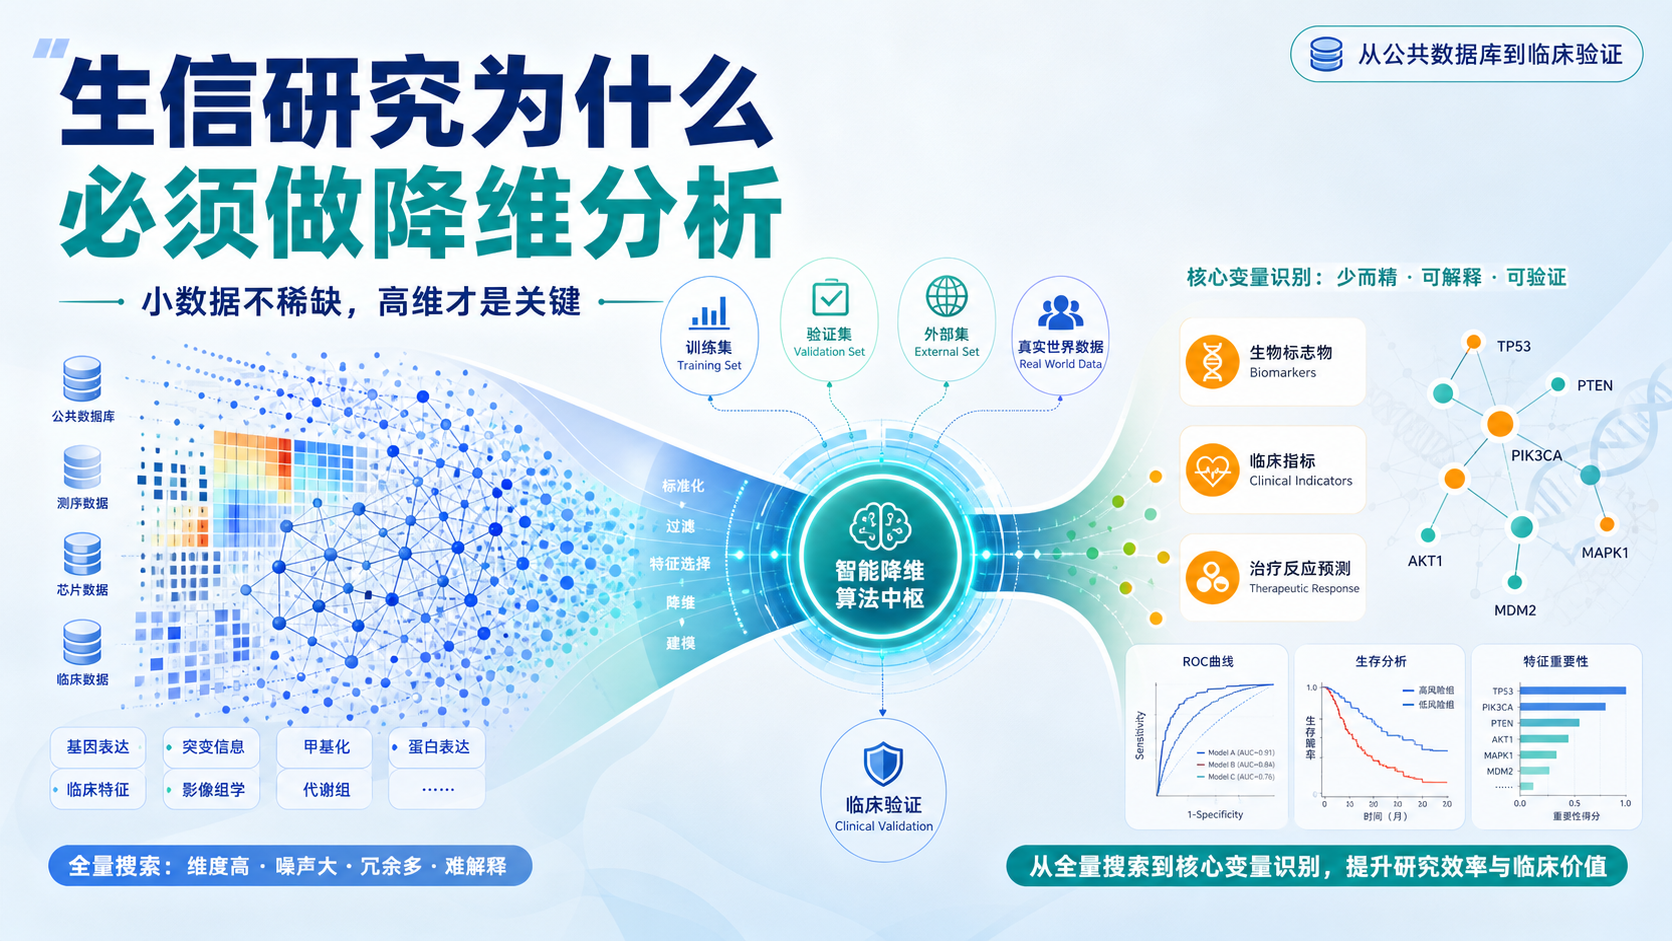 公共数据库很大,但真正能落地的信号很少。很多生信项目卡在“数据很多,结论很弱”,也常陷入“会做分析,不会讲故事”的困境。降维分析的价值,就是把复杂数据压缩成可验证、可解释、可转化的临床问题。阅读127 · 点赞0生信Dr.Sheng 于2026-07-20发布
热门文章
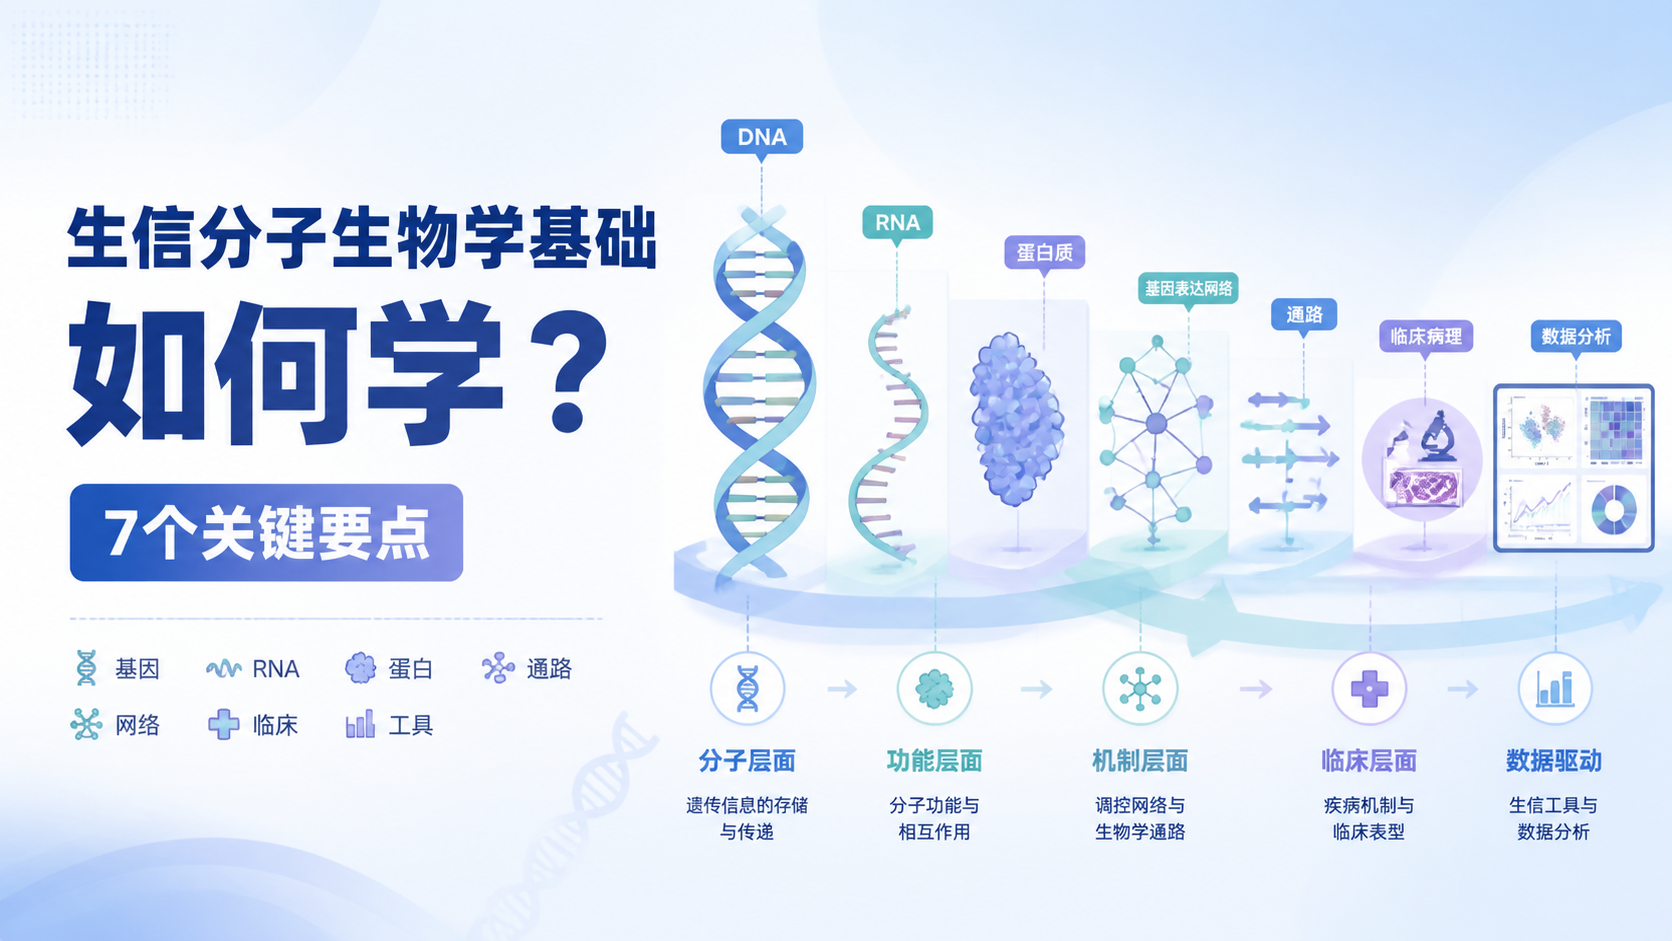
生信分子生物学基础如何学?7个关键要点
阅读1500 · 点赞6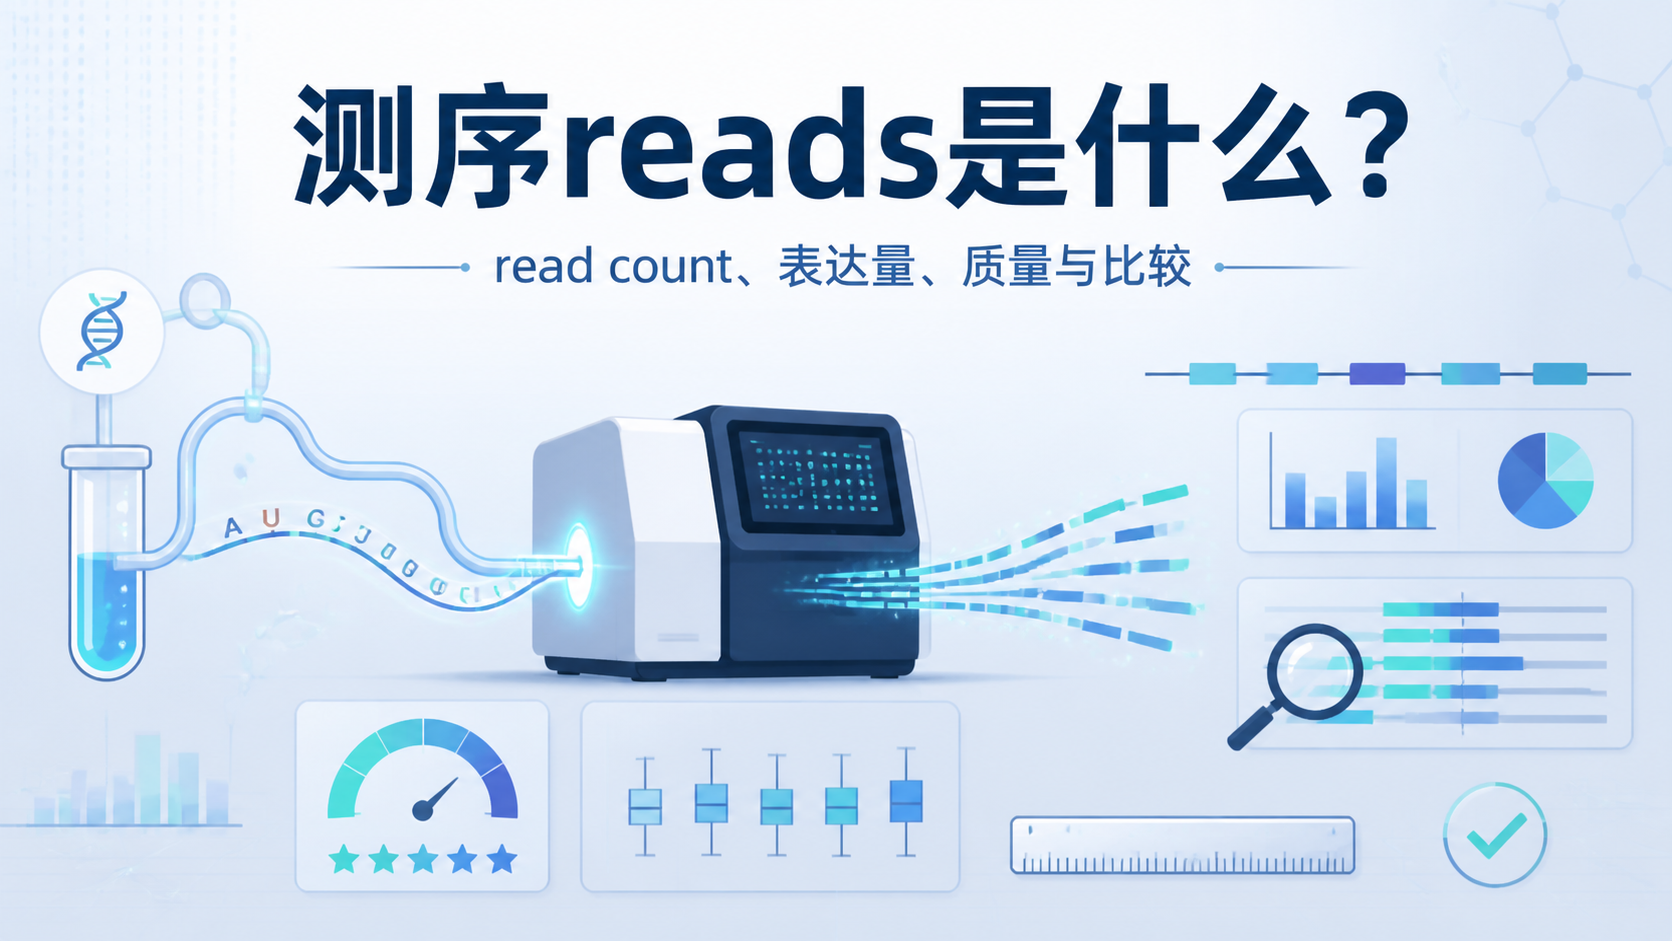
测序reads是什么?5个核心要点解析
阅读1429 · 点赞0
每日资讯速递2026/6/25-2026国自然函评全面收官,会评7月启动
阅读1294 · 点赞0