45
 分享

引言Introduction
K-means聚类是生信中最常用的无监督分型方法之一。它适合从高维、噪声多、标签缺失的肿瘤数据里,先把“可能的亚型”找出来。 但很多人只会跑算法,不会解释结果,也不会把分型和免疫微环境、预后、临床变量串起来。
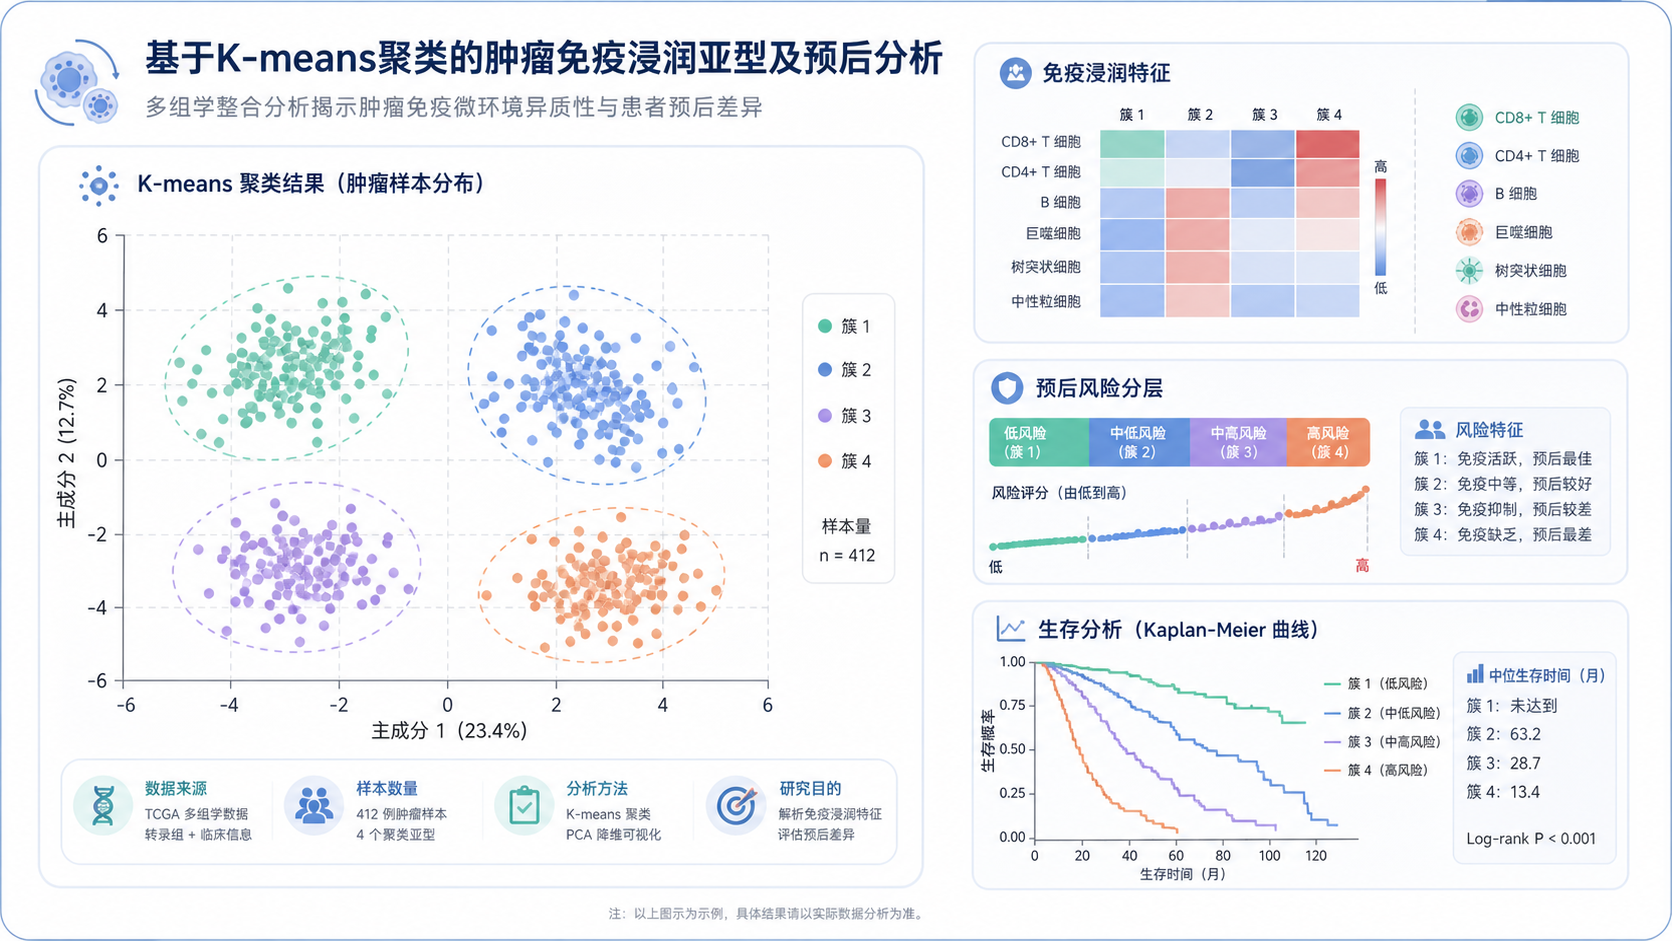
1. K-means聚类在生信中的核心价值
1.1 为什么生信研究离不开聚类
在转录组、甲基化、单细胞和多组学数据里,样本往往没有现成标签。此时,聚类的作用不是“证明什么”,而是先把数据里的结构挖出来 。这一步很关键,因为后续的差异分析、通路分析、免疫分析和预后分析,通常都建立在分组基础上。
对肿瘤研究来说,分型的意义尤其大。不同亚型可能对应不同的免疫浸润水平、突变负荷、治疗反应和生存结局。如果分型本身不稳,后面的所有分析都会被放大偏差。
1.2 K-means适合什么场景
K-means本质上是把样本分到K个中心最近的簇中。它的优势很直接。
- 计算快,适合中等到大样本量。
- 结果直观,便于后续可视化。
- 适合连续型特征矩阵,如表达量、评分、通路活性。
但它也有局限。K-means默认簇近似球形,且对初始中心、异常值和尺度非常敏感。 这意味着在生信里,不能直接把原始矩阵丢进去就结束,通常要先做标准化、降维和稳定性评估。
1.3 先分型,再讲故事
很多高质量生信文章的套路都很清晰。先用聚类把样本分组,再围绕分组展开:
- 差异表达分析。
- 功能富集分析。
- 免疫浸润比较。
- 临床相关性分析。
- 生存分析和模型构建。
真正决定文章质量的,不是“用了什么算法”,而是“这个分组是否能解释疾病生物学”。
2. K-means聚类在肿瘤免疫分型中的标准流程
2.1 数据准备要先做对
在肿瘤免疫分型中,常见输入可以是基因表达矩阵、免疫相关评分矩阵,或经筛选后的特征集。这里最重要的是一致性。
需要先处理三件事。
- 去除低质量样本和缺失严重样本。
- 对表达矩阵做标准化或Z-score转换。
- 控制批次效应,否则聚类结果可能主要反映平台差异,而不是生物学差异。
如果数据来自多个队列,合并前一定要先评估可比性。 这是很多分型研究容易出问题的地方。
2.2 K值不能拍脑袋定
K-means最常见的问题,不是不会跑,而是不知道K取多少。生信里通常会结合多种指标一起判断。
常用思路包括:
- 肘部法,看SSE下降是否明显放缓。
- 轮廓系数,评估组内紧密度和组间分离度。
- Gap Statistic,比较真实数据和参考分布。
- 共识聚类稳定性,判断不同重采样下分型是否一致。
如果K值过小,会把不同生物学亚型混在一起。K值过大,又会把噪声当成亚型。 对肿瘤免疫分型来说,稳定性通常比“分得更多”更重要。
2.3 降维图不是结论,只是证据
PCA、t-SNE、UMAP常用于展示K-means结果。它们的作用是帮助读者快速理解样本分离情况,但不能替代定量判断。
建议这样理解:
- PCA适合看整体方差结构。
- t-SNE更强调局部邻域。
- UMAP在保持局部结构上也常用,视觉效果更清楚。
图上分开,不代表分型就一定成立。图上挤在一起,也不代表没有生物学差异。 最终还是要看下游分析是否一致。
3. 肿瘤免疫分型里,K-means后面该接什么
3.1 先看免疫微环境差异
既然主题是肿瘤免疫分型,分完组后第一步就应该看免疫特征。常见做法包括比较不同亚型的免疫细胞浸润、免疫评分、HLA相关基因表达、免疫检查点表达。
可以重点关注这几类结果:
- 炎症型还是免疫抑制型。
- T细胞浸润高还是低。
- 巨噬细胞、Treg、MDSC是否偏高。
- PD-1、PD-L1、CTLA-4等检查点是否差异明显。
如果一个分型能稳定对应不同免疫生态位,这个分型就有了生物学解释。 这也是后续转化价值的基础。
3.2 再做差异表达和功能富集
分组后通常要找亚型间差异基因,再做GO、KEGG或GSEA分析。这里的目标不是堆图,而是回答一个问题,这些亚型背后的核心通路是什么。
常见方向包括:
- 免疫激活相关通路。
- 炎症因子信号。
- 抗原加工和呈递。
- 细胞周期和增殖。
- 代谢重编程。
如果某个亚型同时表现出免疫抑制和细胞周期增强,就要考虑它是否代表更侵袭性的肿瘤状态。
3.3 预后和治疗反应要联动
肿瘤免疫分型的价值,最终要落到临床上。常见验证包括:
- Kaplan-Meier生存曲线。
- 单因素和多因素Cox分析。
- 分层分析,如年龄、分期、分级。
- 药物敏感性或免疫治疗响应推断。
能解释预后差异的分型,才更接近可发表、可转化的生信结果。
4. K-means聚类在生信研究中的常见误区
4.1 误区一,K越多越高级
不是。分型数量增加,不等于研究深度增加。 如果每一组样本量太小,后续统计功效会迅速下降,结果也更不稳定。
4.2 误区二,只看可视化,不看稳定性
很多人喜欢直接放PCA图或热图,但分型稳定性更重要。尤其是多队列分析时,建议检查:
- 重复聚类的一致性。
- 不同随机种子下结果是否稳定。
- 外部队列能否复现相同趋势。
4.3 误区三,把聚类当终点
聚类只是起点。真正的生信文章不是“分了几组”,而是“分组后解释了什么生物学问题”。 这也是很多稿件能否进入核心审稿环节的分水岭。
5. 让K-means分型真正服务于肿瘤免疫研究
5.1 研究设计要先想清楚输入和输出
在做K-means之前,先明确四件事。
- 输入变量是什么。
- 研究主要问题是什么。
- 期望得到什么分组。
- 分组后用什么方法验证。
先设计,再聚类。不要倒过来。 这是避免“跑完一堆图却讲不清故事”的关键。
5.2 把分型和其他分析模块串起来
一个成熟的免疫分型研究,通常是有逻辑链条的。
- K-means聚类得到亚型。
- 差异分析得到核心基因。
- 富集分析解释功能机制。
- 免疫浸润分析定位微环境特征。
- Cox和列线图验证临床价值。
- 外部队列验证稳健性。
这套链条本身就是一篇完整文章的骨架。
5.3 工具和服务的价值在于提效
对医学生、医生和科研人员来说,最耗时间的往往不是跑算法,而是选数据、定K值、做验证和讲故事。如果前期方案不清晰,后面会反复返工。
这也是很多团队会借助成熟平台的原因。像解螺旋这类服务,更适合在项目设计、分型思路整理、结果解释和文章结构搭建上提供支持,帮助你把K-means聚类真正用到生信研究中,而不是停留在“会画图”的层面。
总结Conclusion
K-means聚类在生信中的价值,不在于算法本身有多复杂,而在于它能否帮助研究者从无标签数据中提炼出稳定、可解释、可转化的肿瘤免疫亚型 。做好标准化、K值选择、稳定性验证,再串联免疫微环境、差异通路和临床结局,才能把聚类结果变成真正有说服力的生信故事。
如果你正在做肿瘤免疫分型,或者卡在分组设计、结果解释和文章组织上,可以考虑借助解螺旋,把方法做稳,把故事讲清。
- 引言Introduction
- 1. K-means聚类在生信中的核心价值
- 2. K-means聚类在肿瘤免疫分型中的标准流程
- 3. 肿瘤免疫分型里,K-means后面该接什么
- 4. K-means聚类在生信研究中的常见误区
- 5. 让K-means分型真正服务于肿瘤免疫研究
- 总结Conclusion