14
 分享
引言Introduction
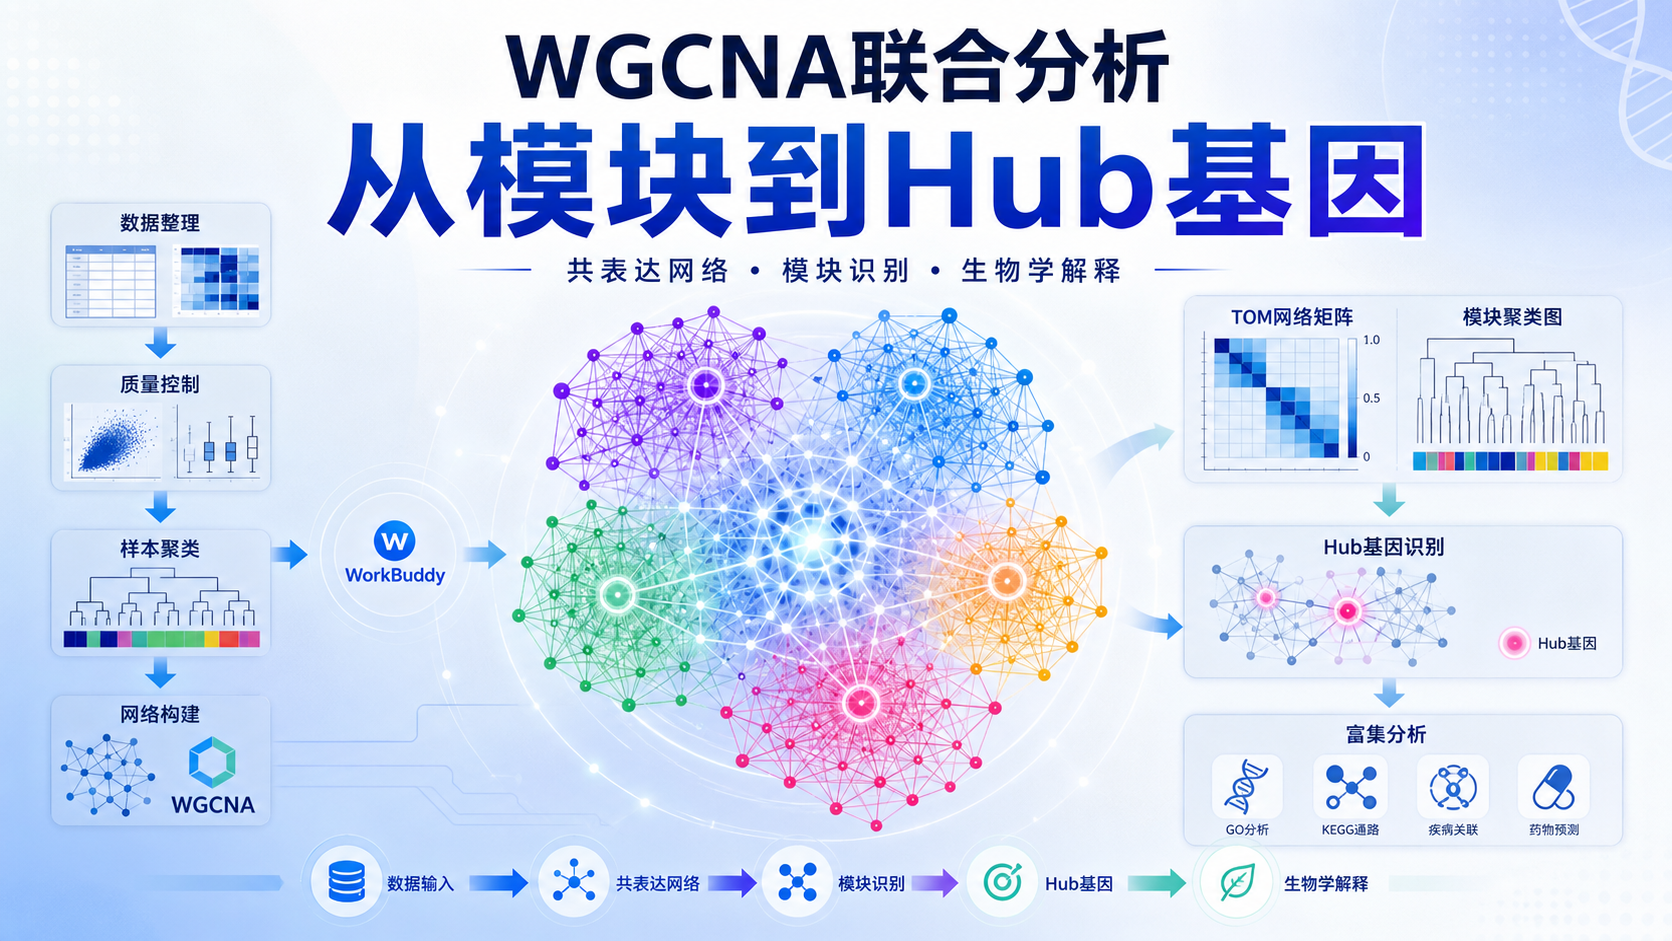
WGCNA常用于从高维转录组数据中找出共表达基因模块,但很多人卡在数据整理、软阈值选择和模块解释上。若缺少规范流程,结果容易不稳定,后续也难落到临床或科研问题上。WorkBuddy与WGCNA联合分析,可以把表达矩阵处理、网络构建和结果解读串成一条清晰路径。 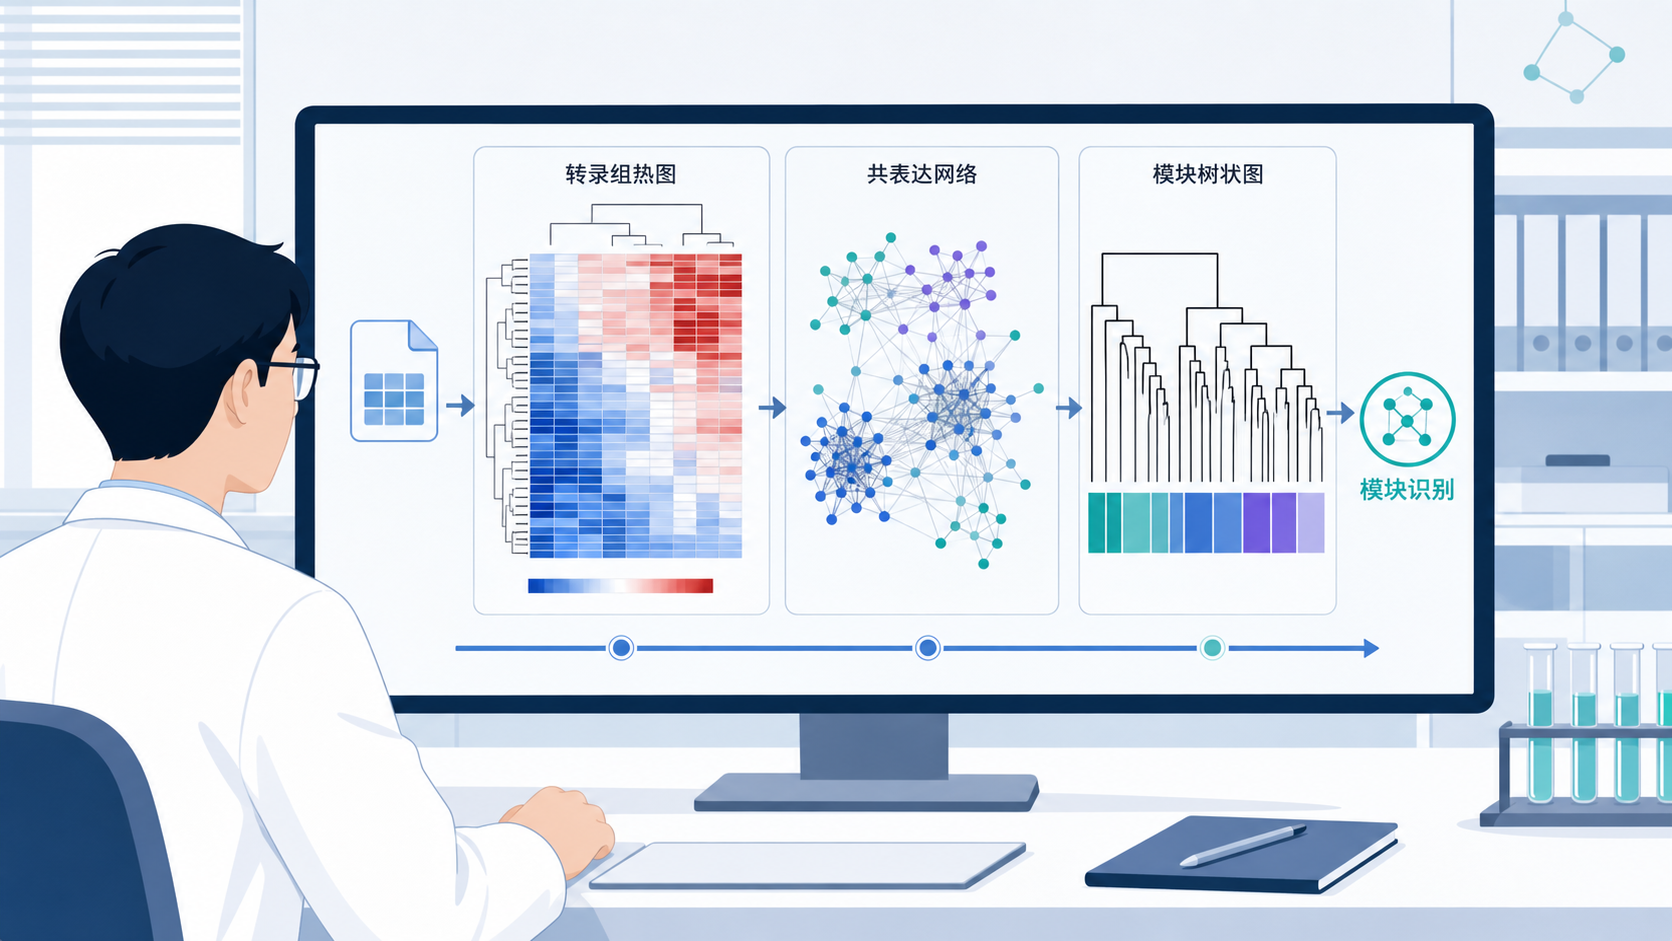
1. 先理解WGCNA为什么适合做共表达网络
1.1 WGCNA研究的不是单个基因,而是基因模块
WGCNA,全称是加权基因共表达网络分析。它的核心思想很直接。如果一组基因在不同样本中呈现相似变化趋势,它们可能受相近的调控机制控制。
与只看差异表达不同,WGCNA更关注基因之间的协同关系。这样更容易从复杂数据中找到功能模块。
在实际研究中,这种方法常用于转录组、芯片和其他高维表达数据。特别是样本数不算很多,但基因数很多的场景,WGCNA很有价值。它能把2万左右基因压缩成若干模块,再进一步关联临床表型、分型或药物反应。
1.2 共表达网络的本质是“相关性 + 网络化”
WGCNA先计算基因两两之间的相关性,常用的是皮尔森相关系数。随后通过软阈值加权,把相关性矩阵转成邻接矩阵,再构建拓扑重叠矩阵。
这一步的关键,不是简单设一个硬阈值,而是让网络更接近无尺度分布。 无尺度网络的典型特征是少数节点连接很多,也就是hub基因。
这也是WGCNA比普通相关分析更适合生物学解释的原因。它不只是告诉你“相关”,还告诉你“谁更核心,哪个模块更重要”。
2. WorkBuddy如何提升WGCNA分析效率
2.1 先把输入数据整理对,后面的网络才可靠
WGCNA对输入数据要求比较高。表达矩阵必须规范,样本名、基因名、重复值、缺失值都要提前处理。
如果输入文件混乱,再好的网络算法也会输出不可信结果。
在联合分析中,WorkBuddy的价值主要体现在前处理环节。它适合把原始表达数据、分组信息、临床表型和样本注释统一管理。这样可以减少手工整理造成的错误,也能让分析流程更可追踪。
常见需要检查的内容包括:
- 表达矩阵是否为行基因、列样本。
- 样本信息是否与表达矩阵一一对应。
- 是否需要去除低表达或低变异基因。
- 是否存在明显离群样本。
2.2 用规范流程减少“模块不稳定”的问题
WGCNA不是一键出结果就结束。软阈值选择、模块识别、模块合并、模块与表型相关性分析,每一步都会影响最终结论。
WorkBuddy的意义在于把这些步骤标准化,减少重复操作和人为偏差。
对于科研人员来说,这一点尤其重要。因为共表达模块是否稳定,直接决定后续hub基因筛选和机制推断是否可信。若没有统一流程,同一批数据在不同时间、不同人手里,结果可能会出现差异。
3. 联合分析的标准流程怎么走
3.1 第一步,筛选合适的输入基因
WGCNA并不建议把所有基因都直接丢进去。虽然理论上可以,但计算开销大,噪音也多。
更常见的做法是先筛选变异较大的基因,比如按方差、MAD或中位绝对偏差排序,取前5000个左右基因作为输入。这个数量不是固定值,但要保证足够多,避免网络过稀。
如果基因筛得太少,模块会不稳定。
如果筛得太多,低信息量基因会稀释信号。
所以输入基因的选择,本质上是在稳定性和计算效率之间找平衡。
3.2 第二步,选择软阈值并验证无尺度拓扑
软阈值β是WGCNA的核心参数。它决定相关性被放大或衰减的程度。
常规做法是测试一系列β值,观察无尺度拓扑拟合指数R²。一般会希望R²达到较高水平,同时保证平均连接度不过低。教学和实战中,常见会根据图形和函数自动推荐结果共同判断。
经验上,软阈值不是越大越好。 太大会让网络过度稀疏,模块间联系下降。太小则网络过于密集,难以区分模块。
因此,软阈值的选择要结合数据特征,而不是机械套用固定数字。
3.3 第三步,构建TOM并识别模块
有了邻接矩阵后,WGCNA会进一步计算拓扑重叠矩阵TOM。TOM反映的是两个基因与其他基因连接模式的相似程度。
与单纯相关性相比,TOM更能体现网络邻域结构。 这也是WGCNA模块识别更稳健的重要原因。
随后通过层次聚类和动态剪切树算法识别模块。每个模块通常用不同颜色表示。模块内部的基因表达趋势更一致,往往也更可能参与同一生物过程。
3.4 第四步,做模块合并和表型关联
初步识别出的模块往往还可以继续合并。
如果两个模块的特征向量相关性很高,说明它们可能属于同一生物学过程。一般会设置模块间相异度阈值,再进行合并,减少后续解释复杂度。
接下来是最关键的一步。把模块特征向量与外部表型、临床信息或实验分组做相关性分析。
真正有价值的模块,不只是内部基因相关性高,还要能与研究问题建立明确联系。
4. 如何从模块走向hub基因和生物学解释
4.1 hub基因不是“最显著”,而是“最核心”
在共表达网络中,hub基因通常指连接度高、处在模块核心位置的基因。它们不一定是差异倍数最大的基因,但往往更能代表模块功能。
这也是WGCNA与单纯差异分析的区别。
常见的筛选思路包括:
- 看模块内连接度。
- 看基因模块成员度。
- 结合基因显著性与表型相关性。
- 再用GO和KEGG进行功能验证。
如果一个模块和疾病表型显著相关,同时其内部hub基因也有明确的功能富集,这个模块的可信度就会更高。
4.2 富集分析是验证网络生物学意义的关键步骤
WGCNA只是把共表达关系提出来,不能直接证明机制。
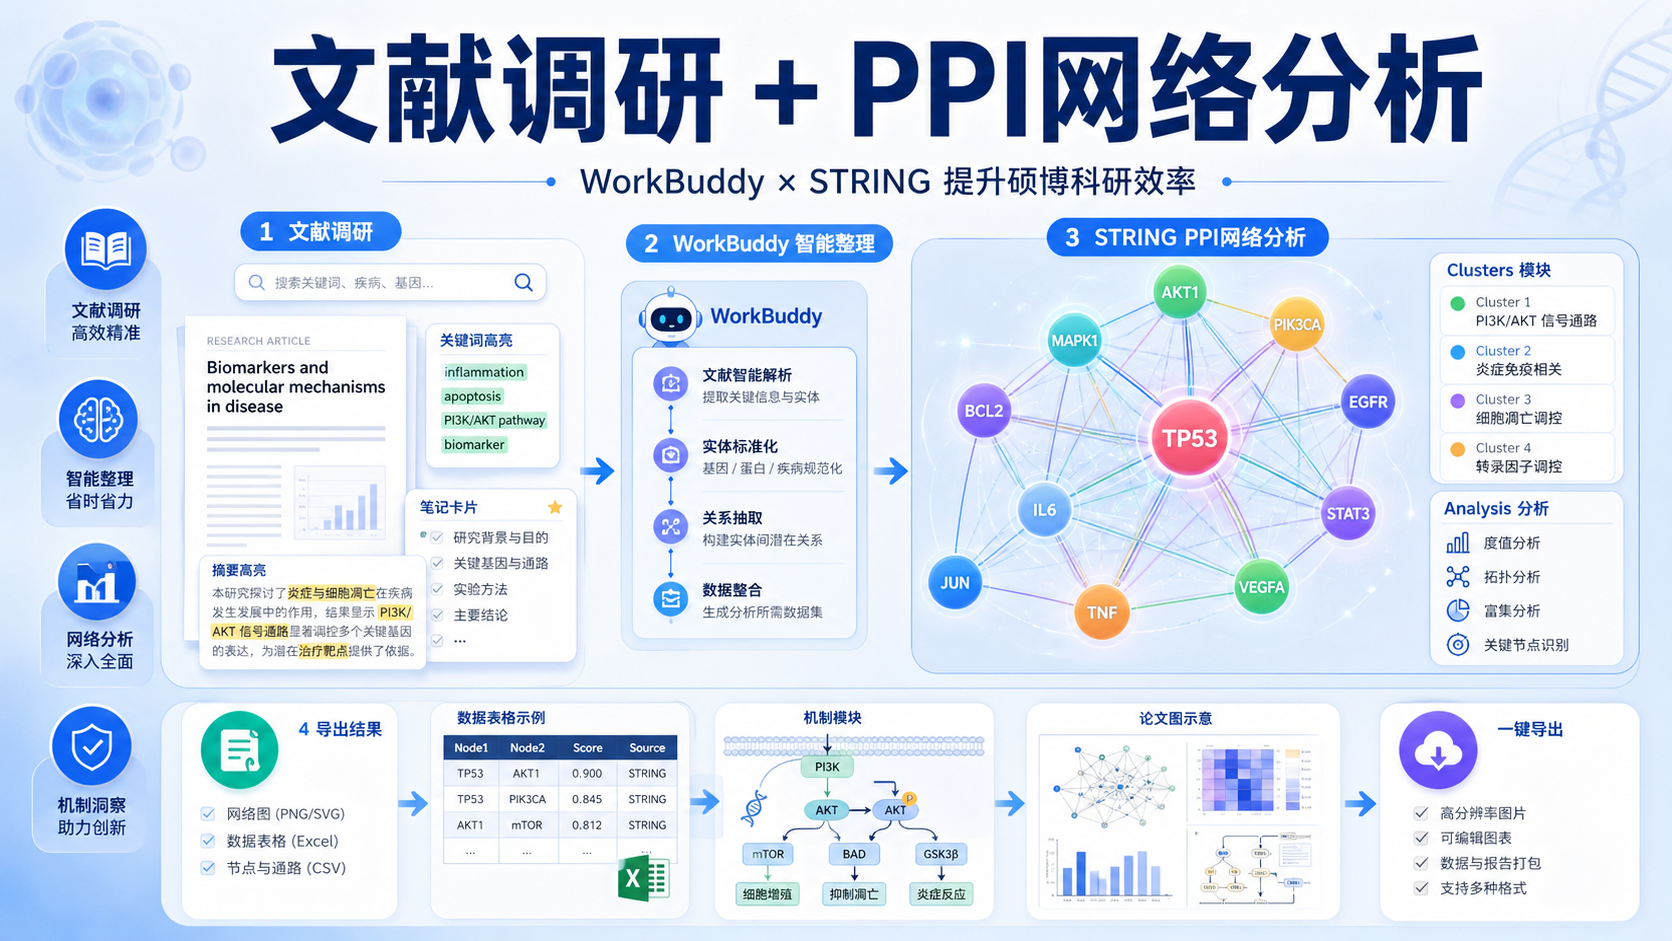
因此后续通常要接GO、KEGG,或结合PPI、单细胞、外部队列验证。这样才能说明模块不是随机聚出来的,而是与真实生物过程相关。
在医学生和科研人员的实际研究里,这一步非常重要。因为最终目标不是“得到一张网络图”,而是找到可解释、可验证、可转化的候选基因或模块。
5. 联合分析的常见问题与实战建议
5.1 结果不稳定,多半出在前处理
很多WGCNA失败,不是算法本身的问题,而是输入数据不标准。常见原因包括:
- 样本顺序错配。
- 批次效应未处理。
- 离群样本未剔除。
- 低质量基因过多。
先保证数据干净,再谈网络生物学。 这是最重要的原则。
5.2 不要把“模块多”误解为“结果好”
模块数量不是越多越好。模块太碎,说明网络可能过度分割。
模块太少,又可能失去分辨率。合理的结果应该是在模块稳定性、可解释性和与表型的关联强度之间取得平衡。
5.3 结果展示要兼顾审稿和复现
建议保留完整分析记录,包括:
- 输入基因筛选标准。
- 软阈值选择依据。
- 模块识别参数。
- 模块合并阈值。
- 与表型相关性的统计结果。
这不仅有助于论文撰写,也有助于后续复现和答辩说明。
总结Conclusion
WorkBuddy与WGCNA联合分析的核心价值,在于把数据整理、网络构建、模块识别和结果解释串联成规范流程。对于医学生、医生和科研人员来说,这种方法能更高效地从高维表达数据中找到与表型相关的共表达模块,并进一步筛选hub基因。如果你想让WGCNA分析更标准、更高效、更适合发表,建议借助解螺旋的WorkBuddy相关方案,把复杂流程变成可复现的分析路径。
- 引言Introduction
- 1. 先理解WGCNA为什么适合做共表达网络
- 2. WorkBuddy如何提升WGCNA分析效率
- 3. 联合分析的标准流程怎么走
- 4. 如何从模块走向hub基因和生物学解释
- 5. 联合分析的常见问题与实战建议
- 总结Conclusion