23
 分享
引言Introduction
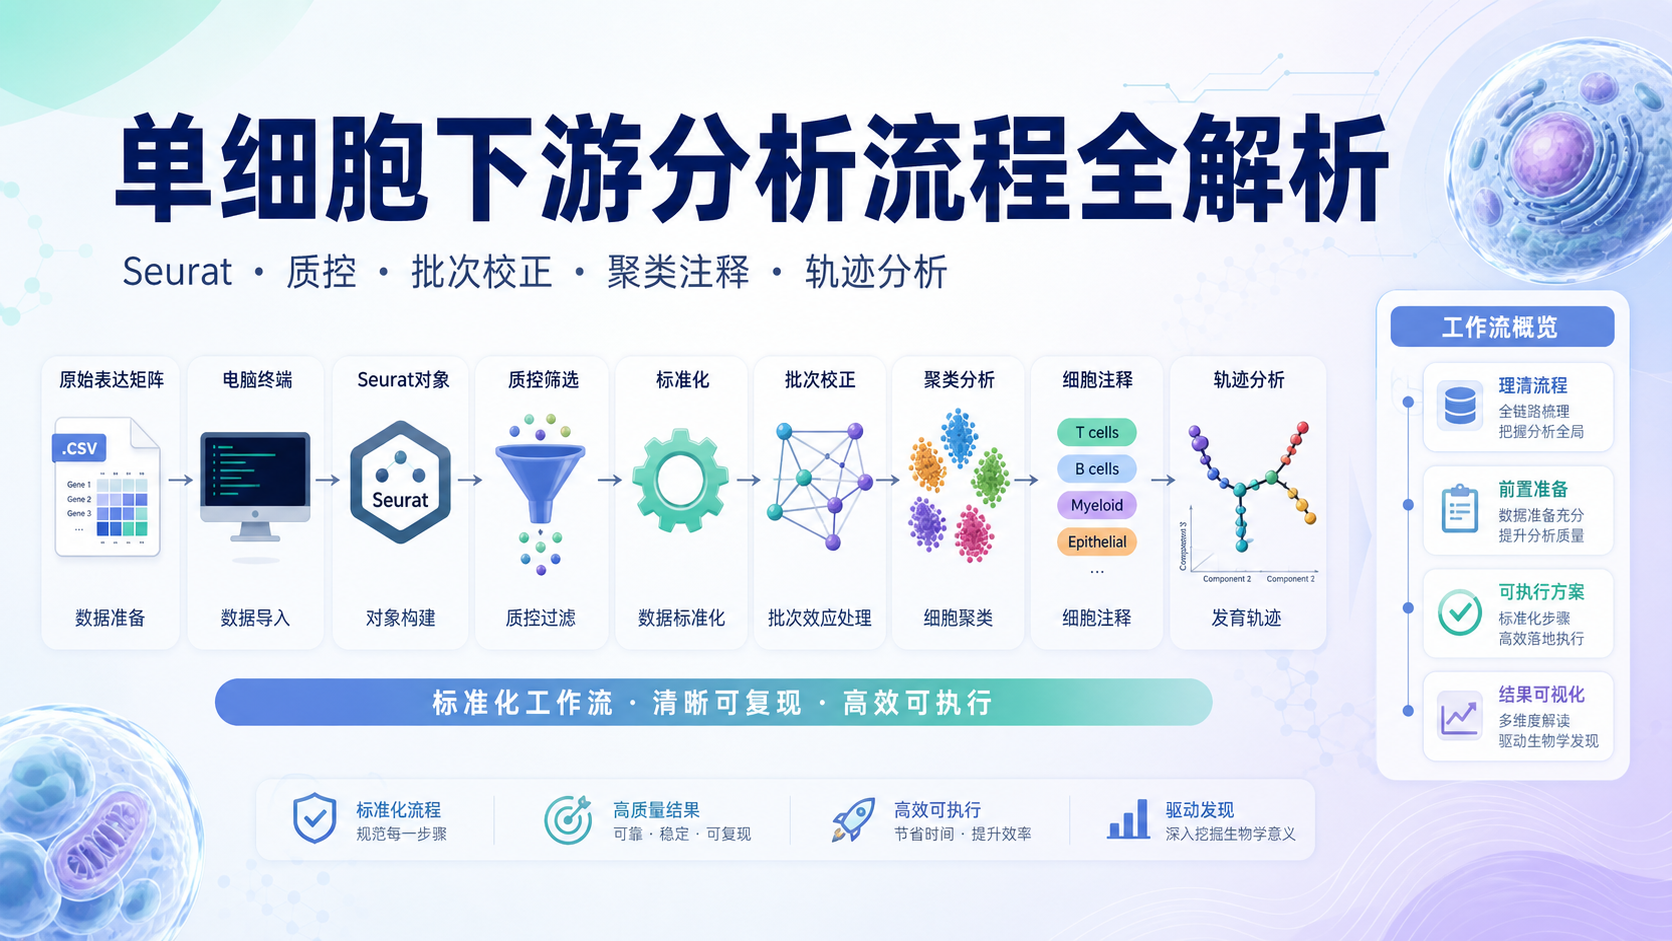
单细胞下游分析最常见的痛点,是流程碎、步骤多、结果难复现。Seurat、Monocle、批次校正、轨迹分析,每一步都可能卡住。对医学生、医生和科研人员来说,真正需要的是一套可落地、可重复的实战流程。本文用 WorkBuddy 的思路,梳理单细胞下游分析的核心全流程。
1. 单细胞下游分析前,先把数据和环境准备好
1.1 明确输入数据类型
单细胞下游分析通常从公司或平台输出结果开始。常见输入有三类。
- 表达矩阵 ,行是基因,列是细胞 barcode。
- 基因注释信息 ,如 ENSG 编号与 gene symbol 对应关系。
- 细胞注释信息 ,通常先包含 barcode,后续再补充分组结果。
如果输入不完整,后面的质控、聚类和注释都会受影响。 这是很多新手最容易忽略的一步。
1.2 环境初始化要规范
正式分析前,建议先清空环境,再加载需要的包。这样能减少对象冲突,也更利于复现。
通常至少要包含三类包:
- 数据整理包。
- 单细胞分析包。
- 辅助分析包。
规范的环境初始化,是保证结果可重复的第一步。 这点对课题组协作和论文补充材料尤其重要。
1.3 WorkBuddy 的价值在于把流程前置
很多人只看最终图,不看分析套路。WorkBuddy 的优势是能把单细胞下游分析的思路拆成可执行步骤,帮助你在读入数据后快速进入分析状态。它更适合做流程组织、步骤提炼和分析路径梳理。
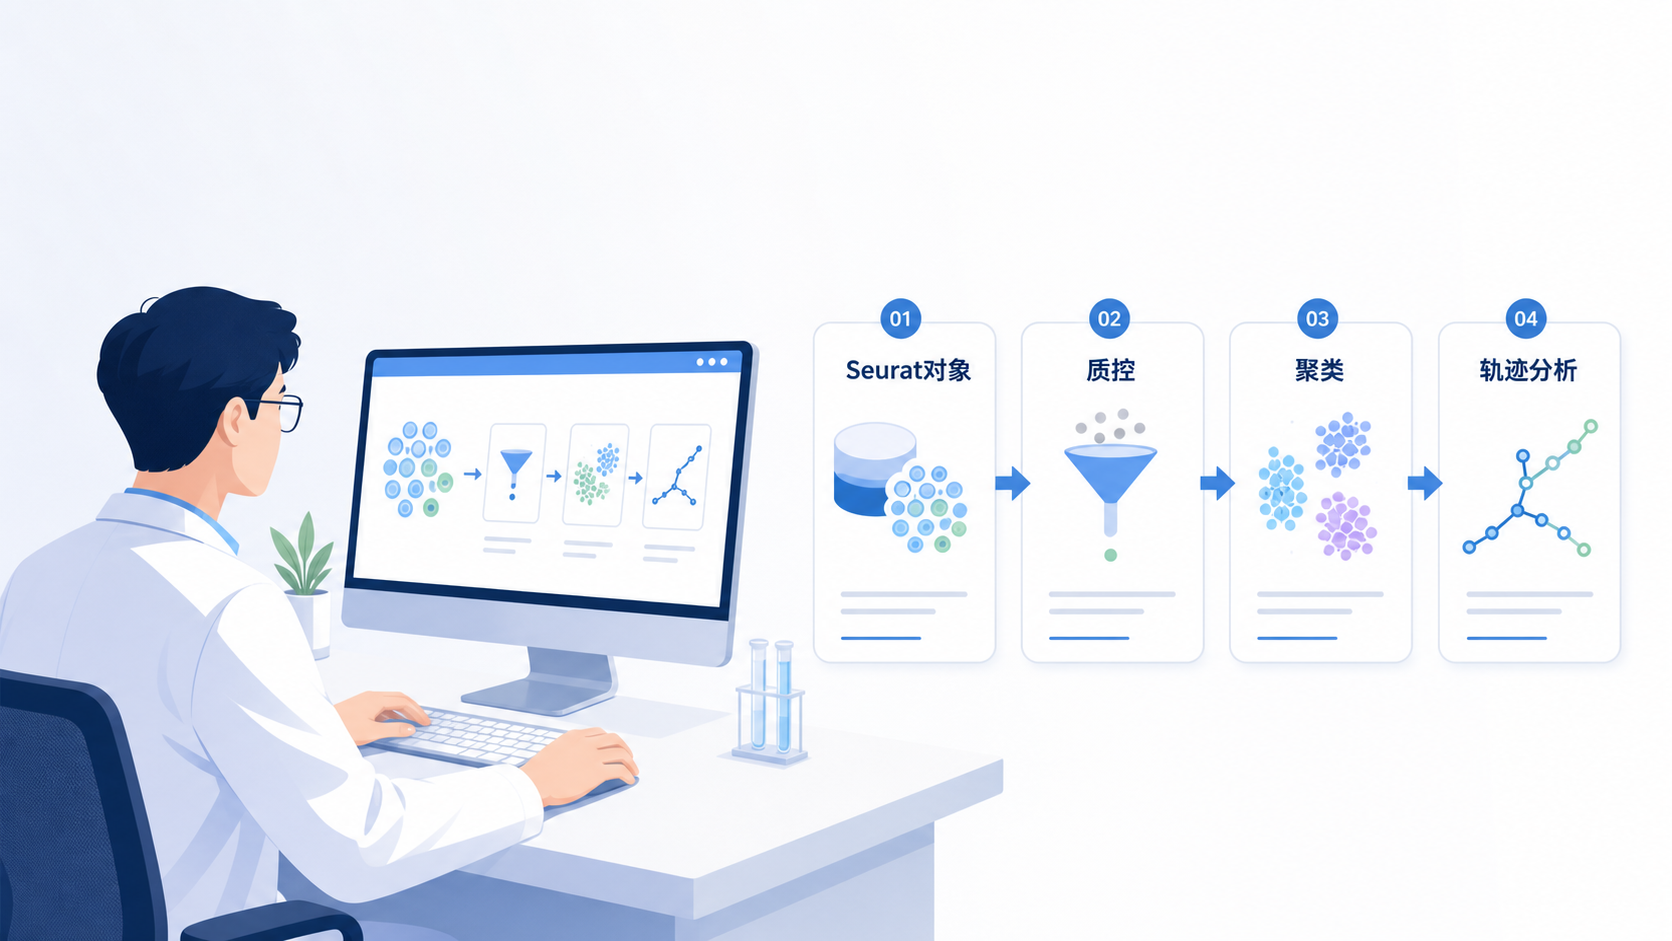
2. Seurat对象构建是单细胞下游分析的起点
2.1 读取不同格式的表达矩阵
在实战中,常见的文件格式包括 RDS、CSV,以及不同软件的定量结果。课程中展示了几种典型场景。
- 使用
readRDS读取 Seurat 生成的结果。 - 使用
read.csv读取 CSV 格式表达矩阵。 - 读取 Cellman、STAR solo 等软件输出。
不同格式的核心目标一致,都是先把原始计数导入到统一的数据结构中。
2.2 创建 Seurat 对象
导入数据后,下一步是构建软件所需对象。常见做法是将 counts 作为输入,并设置基础过滤条件。
例如:
- 每个细胞至少包含 200 个特征。
- 至少在 3 个细胞中表达的基因才保留。
在课程示例中,构建后对象包含 18,604 个基因 和 ** 3,000 余个单细胞样本**。这类对象是后续质控、标准化、降维和聚类分析的基础。
2.3 多样本合并要提前规划
如果是多样本项目,建议先批量读取,再统一合并。课程里演示了通过 dir 获取文件路径,再用 lapply 批量创建对象的做法。
这种方法有两个好处:
- 减少重复代码。
- 便于后续做批次效应处理。
多样本分析的关键,不是先合并,而是先保证每个样本的结构都正确。
3. 质控、标准化与特征筛选决定后续结果质量
3.1 质控要先处理低质量细胞
单细胞数据里最常见的问题,是空滴、双细胞和受损细胞。课程提到的质控思路很典型。
常规过滤对象包括:
- 不包含细胞的油滴。
- 包含多个细胞的油滴。
- 线粒体基因比例异常高的细胞。
线粒体基因比例过高,常提示细胞受损。 如果不提前过滤,后面聚类和差异分析都可能被噪音干扰。
3.2 标准化是保证可比性的前提
Count 值不能直接用于比较。需要先做标准化,降低测序深度差异带来的偏差。
在单细胞分析中,标准化的目标很明确:
- 让不同细胞之间更可比。
- 为高变基因筛选和降维提供基础。
- 减少技术噪音对生物学信号的掩盖。
没有标准化,就很难谈可靠的聚类和下游注释。
3.3 高变基因筛选决定信息密度
高变基因通常是后续分析的重点。课程里提到,推荐保留 1,000 到 5,000 个高变基因 。
为什么重要?
- 它们更能反映细胞间差异。
- 可以降低无关基因的干扰。
- 提高降维和聚类的稳定性。
高变基因筛选不是简单删减,而是把分析焦点放到最有信息量的基因上。
4. 批次效应与协变量处理是多样本分析的关键
4.1 批次效应必须正视
多样本设计在单细胞项目中很常见,但也最容易引入批次效应。不同批次的测序时间、文库构建、上机状态,都会影响表达矩阵。
常见表现包括:
- 同一细胞类型被分散到不同批次。
- 聚类结果更像批次而不是生物学分组。
- 差异基因被技术偏差放大。
如果不处理批次效应,后续结论可能失真。
4.2 常见处理方式是统一校正
课程提到可使用 Seurat 做批次效应处理。实战中,核心是让不同样本在同一分析空间中对齐,再进行联合降维和聚类。
建议关注三点:
- 每个样本质控是否一致。
- 合并后是否出现明显批次分离。
- 校正后是否仍保留真实生物学差异。
4.3 协变量回归能减少干扰
在下游分析中,细胞周期、UMI 数目等常作为协变量处理。其目的不是删除信息,而是减少非研究重点变量对结果的影响。
协变量回归的原则是保留生物学信号,尽量剔除技术波动。 这一点在肿瘤、免疫和发育研究中都很关键。
5. 从聚类到注释,再到发育轨迹分析
5.1 聚类是细胞类型发现的基础
完成降维后,下一步通常是聚类。聚类结果可以帮助识别潜在细胞群。
在实际分析中,可以:
- 用不同颜色标记聚类。
- 在聚类基础上叠加细胞类型注释。
- 对比不同样本的细胞组成。
聚类不是终点,而是细胞类型识别的入口。
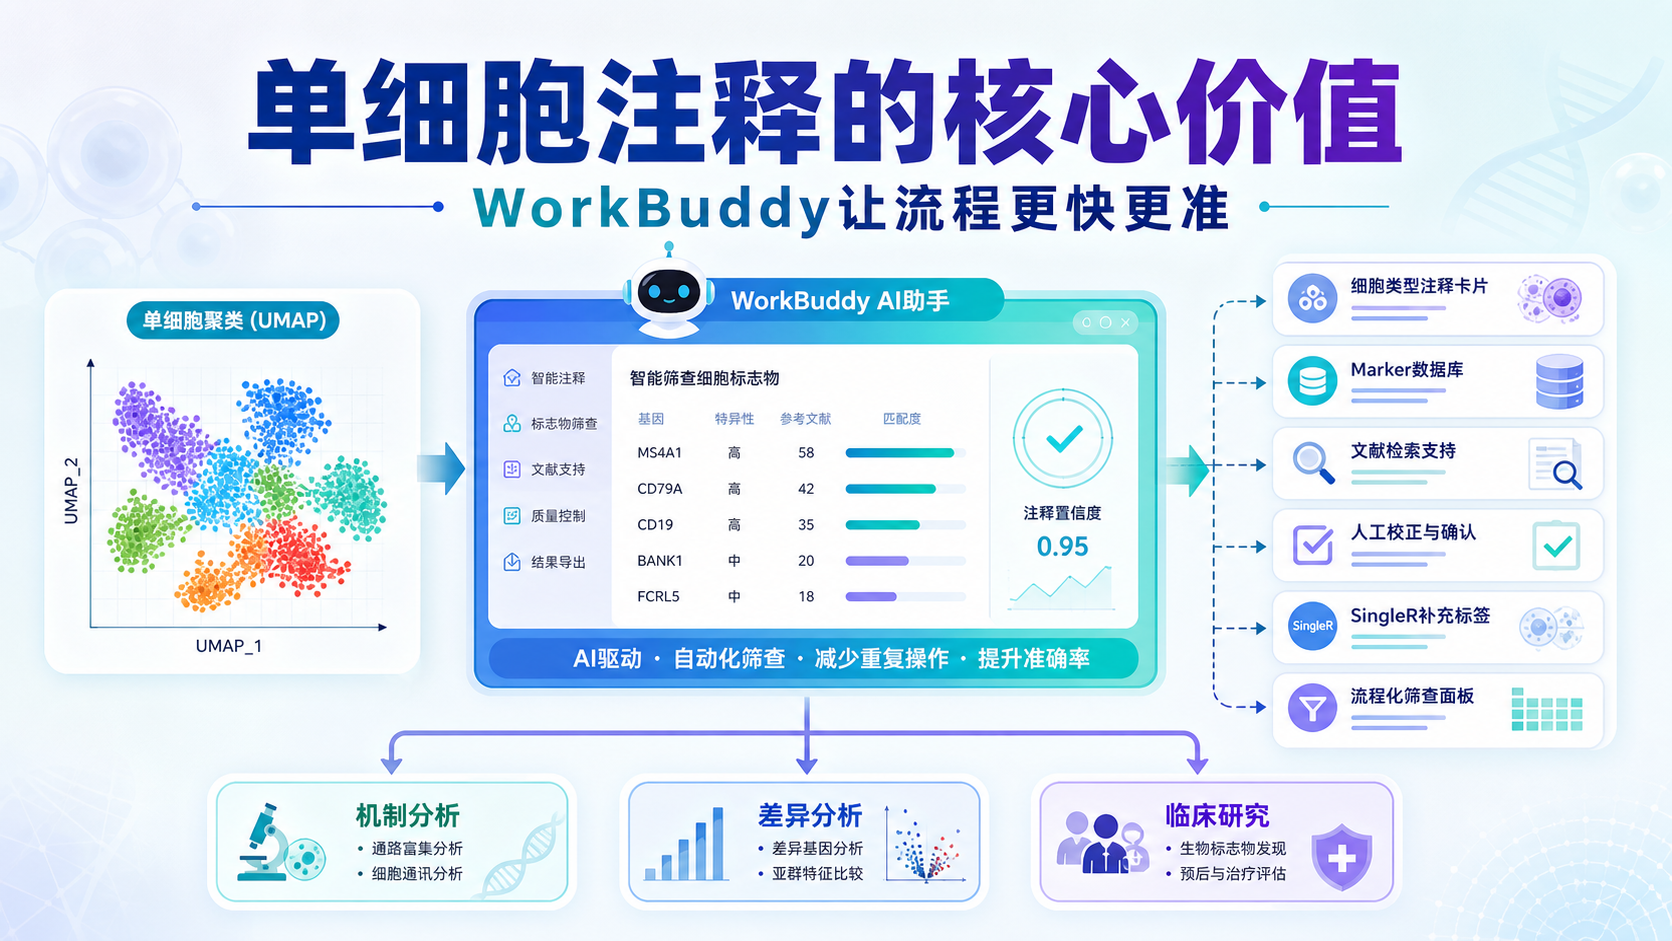
5.2 细胞注释要结合已知标记
单细胞分析的价值,在于把无监督聚类转化为可解释的细胞类型。注释时应结合已知 marker、文献和生物学背景。
建议流程:
- 先看差异 marker。
- 再对照经典细胞类型标记。
- 最后结合研究场景确认命名。
注释越依赖证据链,结论越稳健。
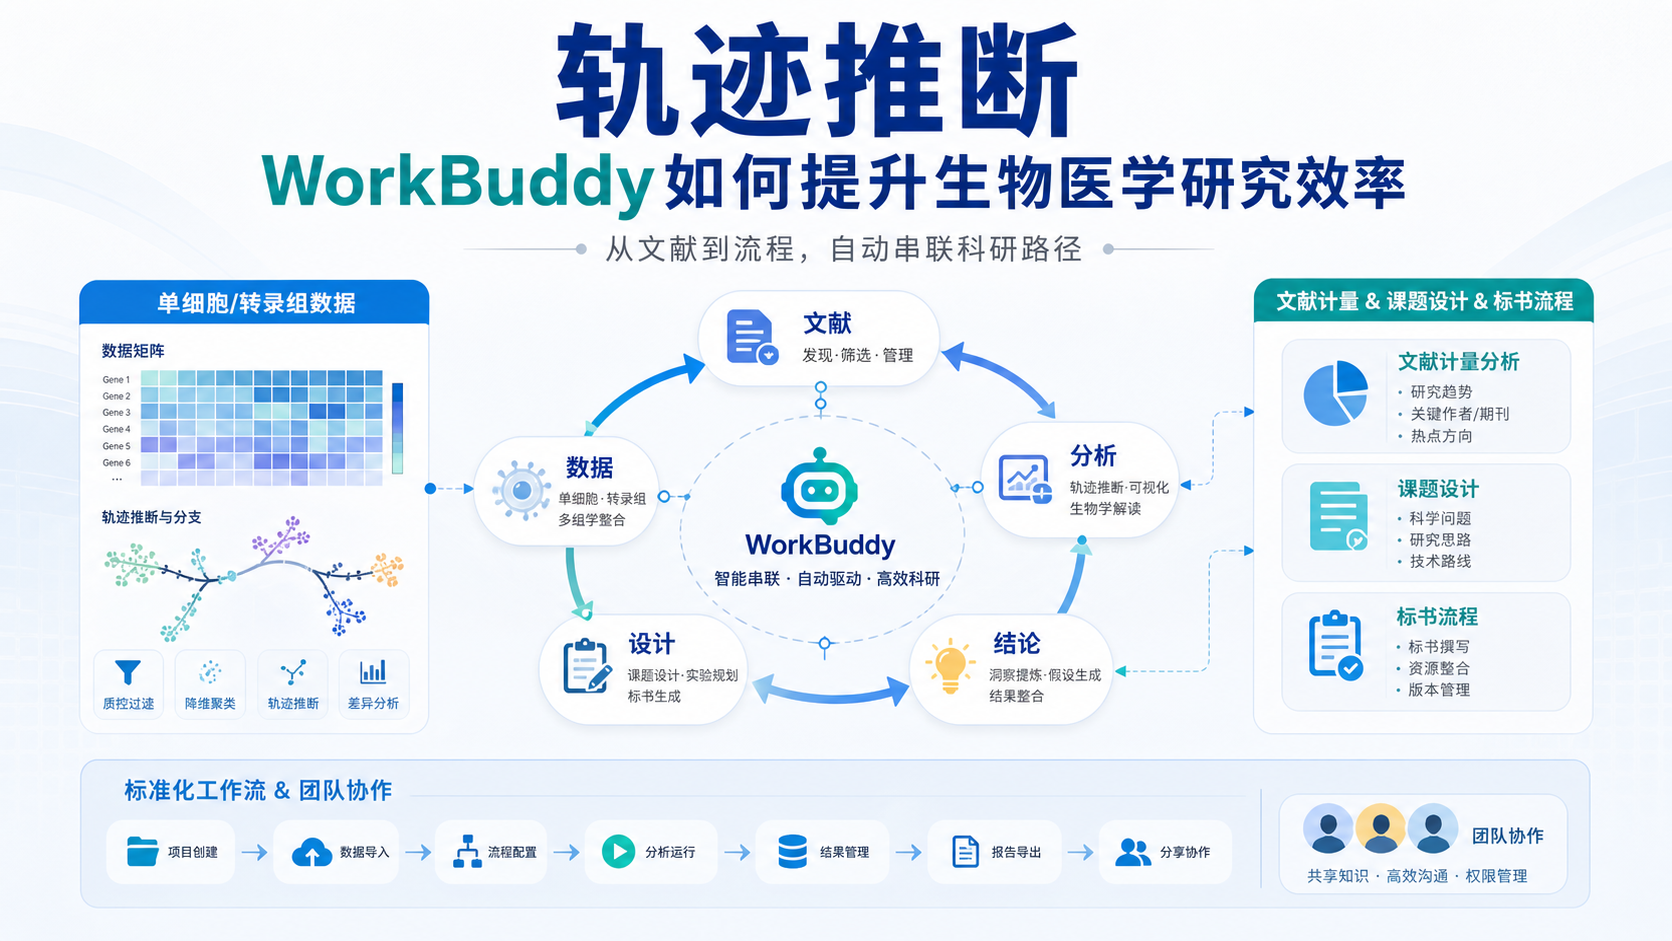
5.3 Monocle 适合做发育轨迹分析
在完成细胞类型注释后,可以进一步分析细胞发育轨迹。课程中展示了先提取表达矩阵,再构建 CDS 对象的标准思路。
轨迹分析通常需要:
- 表达矩阵。
- 基因名称。
- 样本注释信息。
- 细胞类型信息。
构建成功后,可进行 PCA 预处理、降维和轨迹绘制。轨迹图的意义在于帮助研究者理解细胞状态如何沿时间或分化方向变化。
5.4 3D轨迹图适合展示复杂分支
课程中还提到 3D 发育轨迹图,可从多个角度观察细胞状态变化。对于存在多分支分化的系统,这种展示方式更直观。
但要注意:
- 3D 图更适合展示,不等于更强证据。
- 轨迹推断必须结合生物学背景验证。
- 最好与 marker、功能富集和实验结果交叉印证。
6. WorkBuddy 适合把分析流程变成可执行方案
6.1 它解决的不是“算不出”,而是“理不清”
很多科研人员不是不会做单细胞,而是不知道先后顺序。是先质控,还是先合并。是先找高变基因,还是先做批次校正。是先注释,还是先轨迹分析。
WorkBuddy 的优势,是把这些步骤组织成清晰的分析路线。 这对新手尤其重要,对需要快速产出方案的团队也很实用。
6.2 更适合学习计划、研究方案和分析模板
从上游知识库看,WorkBuddy 不只是输出结果,更像是一个流程组织工具。它能帮助你:
- 提炼单细胞分析套路。
- 生成可执行的研究步骤。
- 将分析过程转成学习或项目框架。
对于单细胞下游分析,这种“先搭架子,再做细化”的方式更高效。
6.3 用解螺旋,可以把复杂流程变成标准化工作流
如果你正在做单细胞下游分析,却卡在对象构建、批次校正、轨迹分析和结果整理上,解螺旋可以帮助你把零散步骤整理成标准流程。 无论是学习、科研,还是课题汇报,都能更快形成可复现的分析框架。
总结Conclusion
单细胞下游分析的核心,不只是会跑软件,而是要把数据读取、Seurat对象构建、质控、标准化、高变基因筛选、批次校正、聚类注释和轨迹分析串成完整闭环。谁能把流程做规范,谁就更容易得到可信结果。 如果你希望更高效地梳理单细胞分析思路,建议结合 WorkBuddy 和解螺旋,把复杂流程变成可执行、可复现、可交付的方案。
- 引言Introduction
- 1. 单细胞下游分析前,先把数据和环境准备好
- 2. Seurat对象构建是单细胞下游分析的起点
- 3. 质控、标准化与特征筛选决定后续结果质量
- 4. 批次效应与协变量处理是多样本分析的关键
- 5. 从聚类到注释,再到发育轨迹分析
- 6. WorkBuddy 适合把分析流程变成可执行方案
- 总结Conclusion