14
 分享
引言Introduction
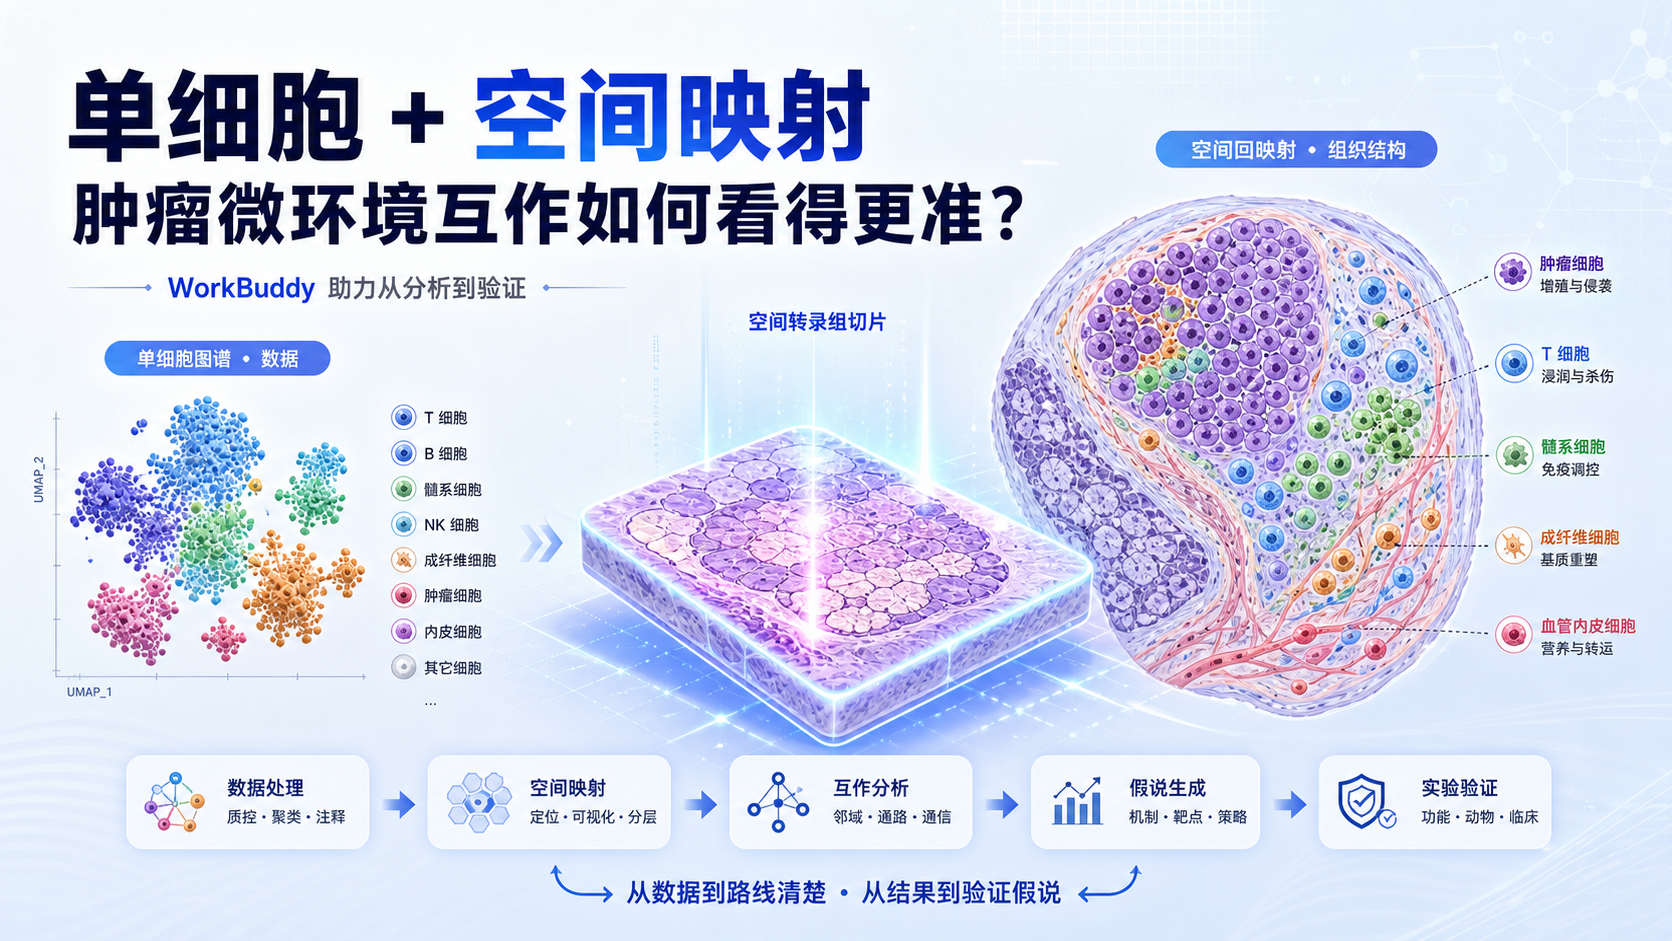
单细胞测序能看到上万个细胞,但真正难的是把这些细胞准确分群并完成注释。一旦注释错误,后续差异分析、功能解释和机制推断都会偏离方向。 对医学生、医生和科研人员来说,最耗时的不是画图,而是反复核对标志物、文献和亚群边界。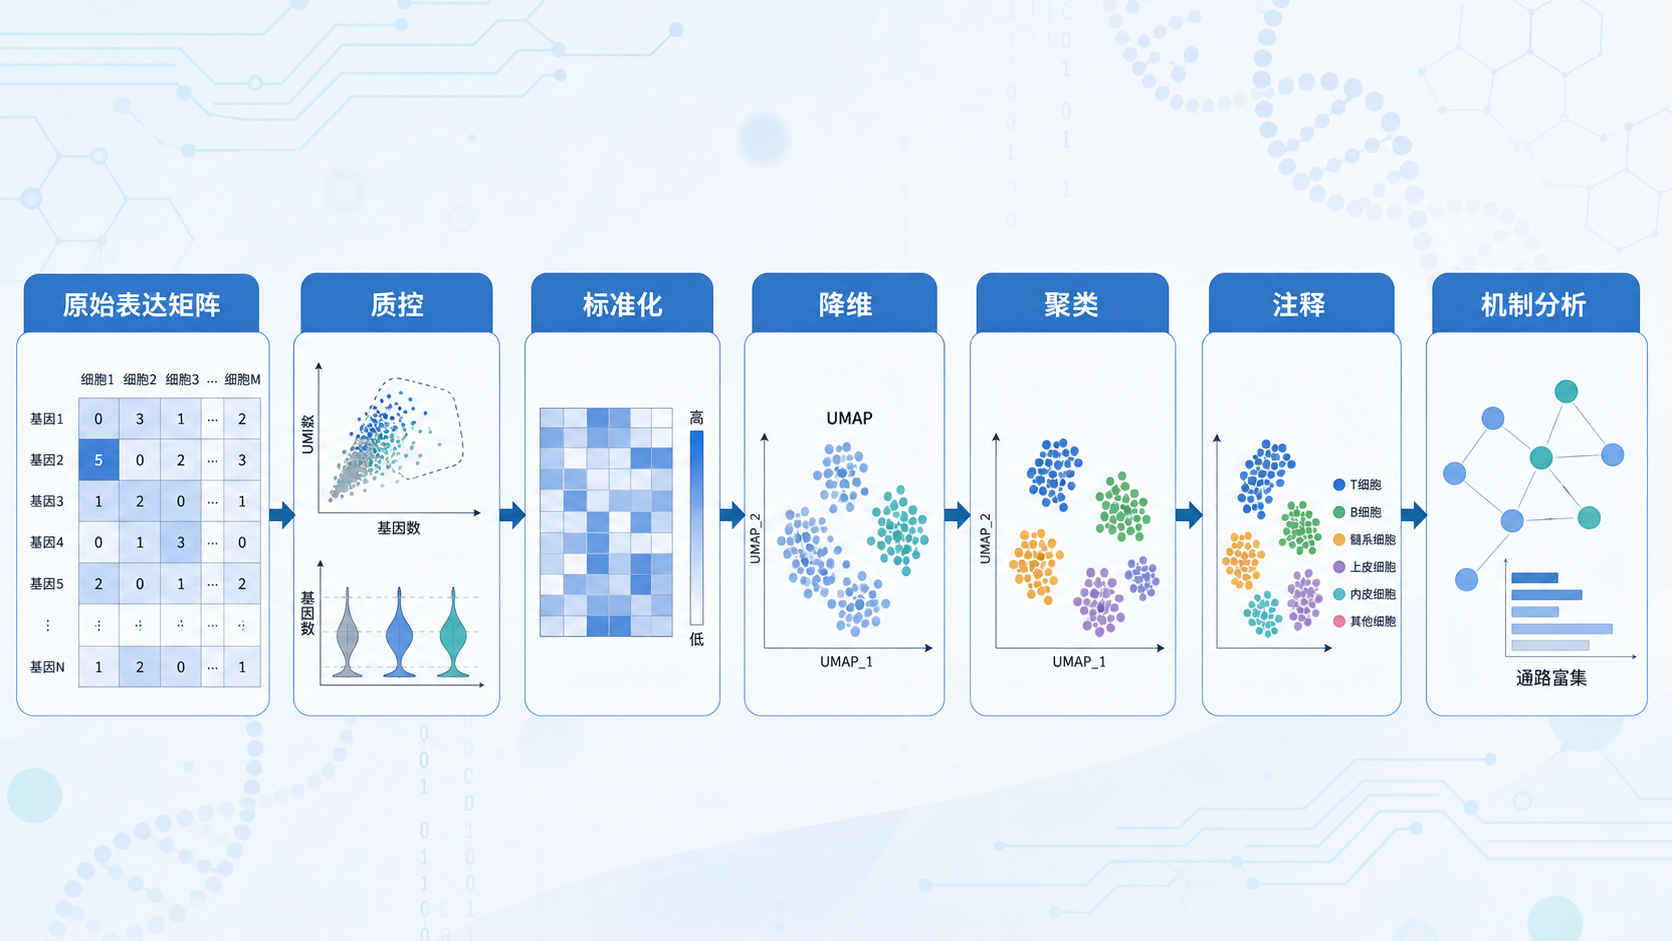
1. 单细胞注释为什么是下游分析的核心
1.1 先聚类,再注释,才能看清细胞群体结构
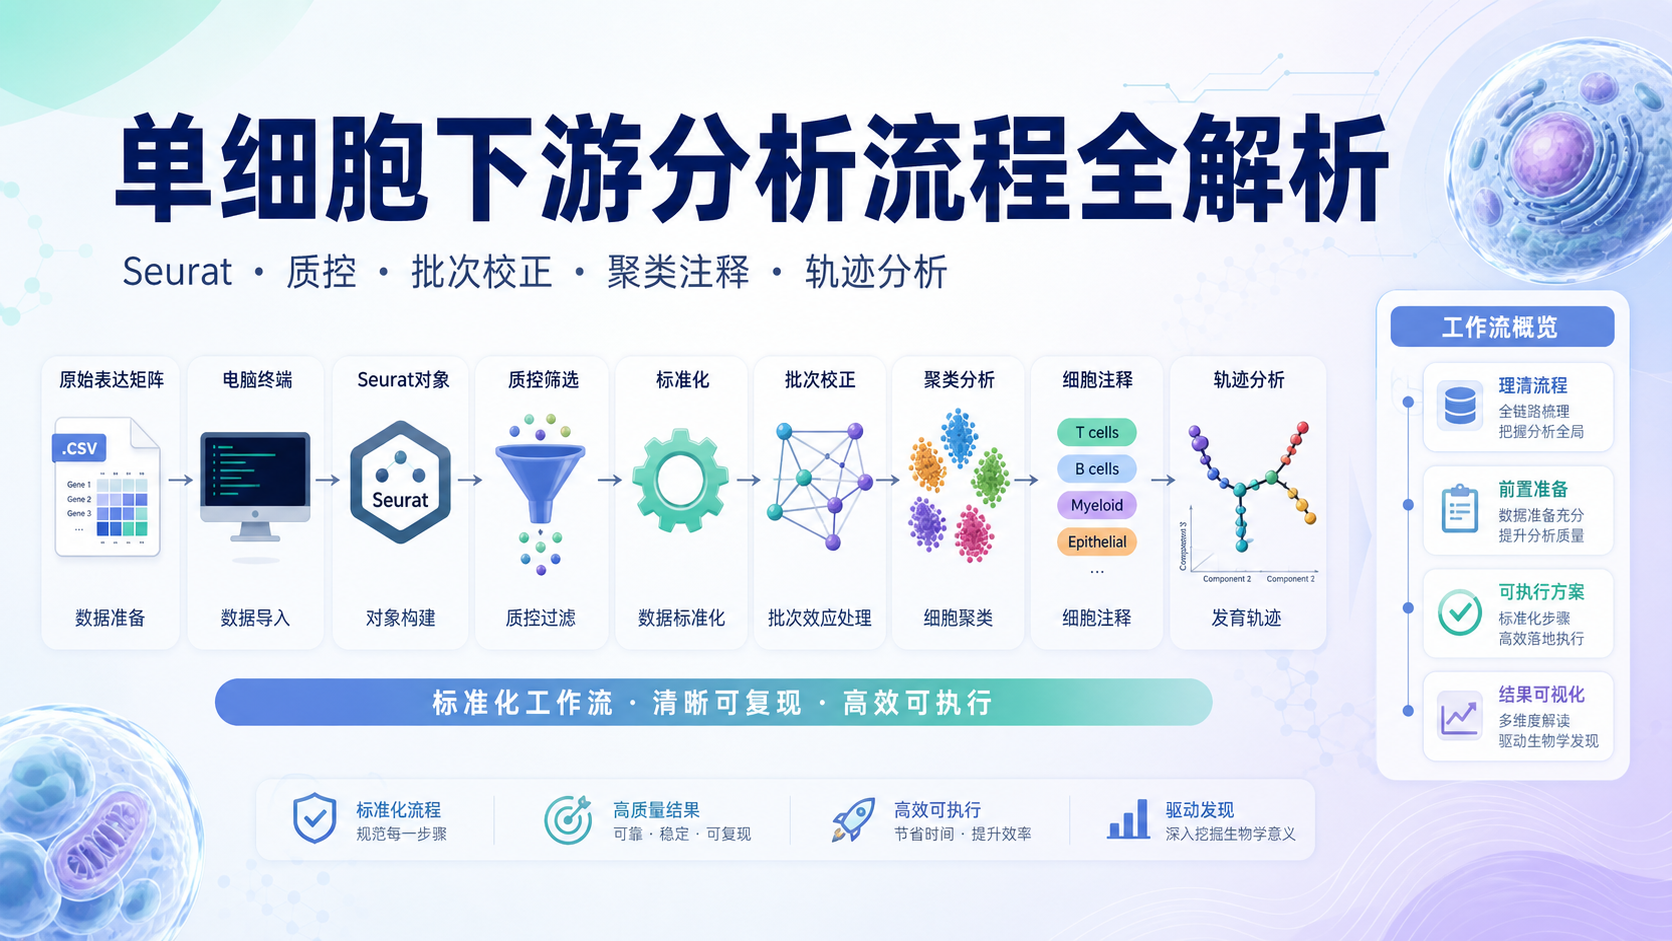
单细胞数据的基础思路很明确。先根据表达谱相似性,把细胞聚成若干cluster,再判断每个cluster对应什么细胞类型。这一步不是简单贴标签,而是决定研究对象的生物学含义。
如果直接逐个细胞比较,数据维度高,噪声大,且解释效率低。更合理的方法是先把相似细胞归并,再比较群体间差异。比如肿瘤组织里常见的肿瘤细胞、免疫细胞、基质细胞,往往具有不同的表达模式。聚类后再注释,逻辑更清楚,也更符合生物学实际。
1.2 降维图不是终点,而是注释入口
PCA、tSNE、UMAP的作用,是把高维表达信息压缩到二维或三维,方便观察细胞间关系。降维图展示的是结构,注释才赋予结构意义。
常见做法是先看cluster分布,再结合marker基因定位细胞身份。例如,CD79A、MS4A1常用于提示B细胞,CD8A常用于提示T细胞。对科研人员来说,图上看到“分得开”只是第一步。真正重要的是“为什么分开,分开的群是什么”。
2. WorkBuddy在单细胞注释中的价值
2.1 从“人工找标志物”到“流程化筛查”
传统单细胞注释依赖大量手工操作。研究者要查文献、比marker、看不同数据库,再结合自己的项目背景逐一判断。这个过程准确,但成本高,且容易在重复劳动中消耗时间。
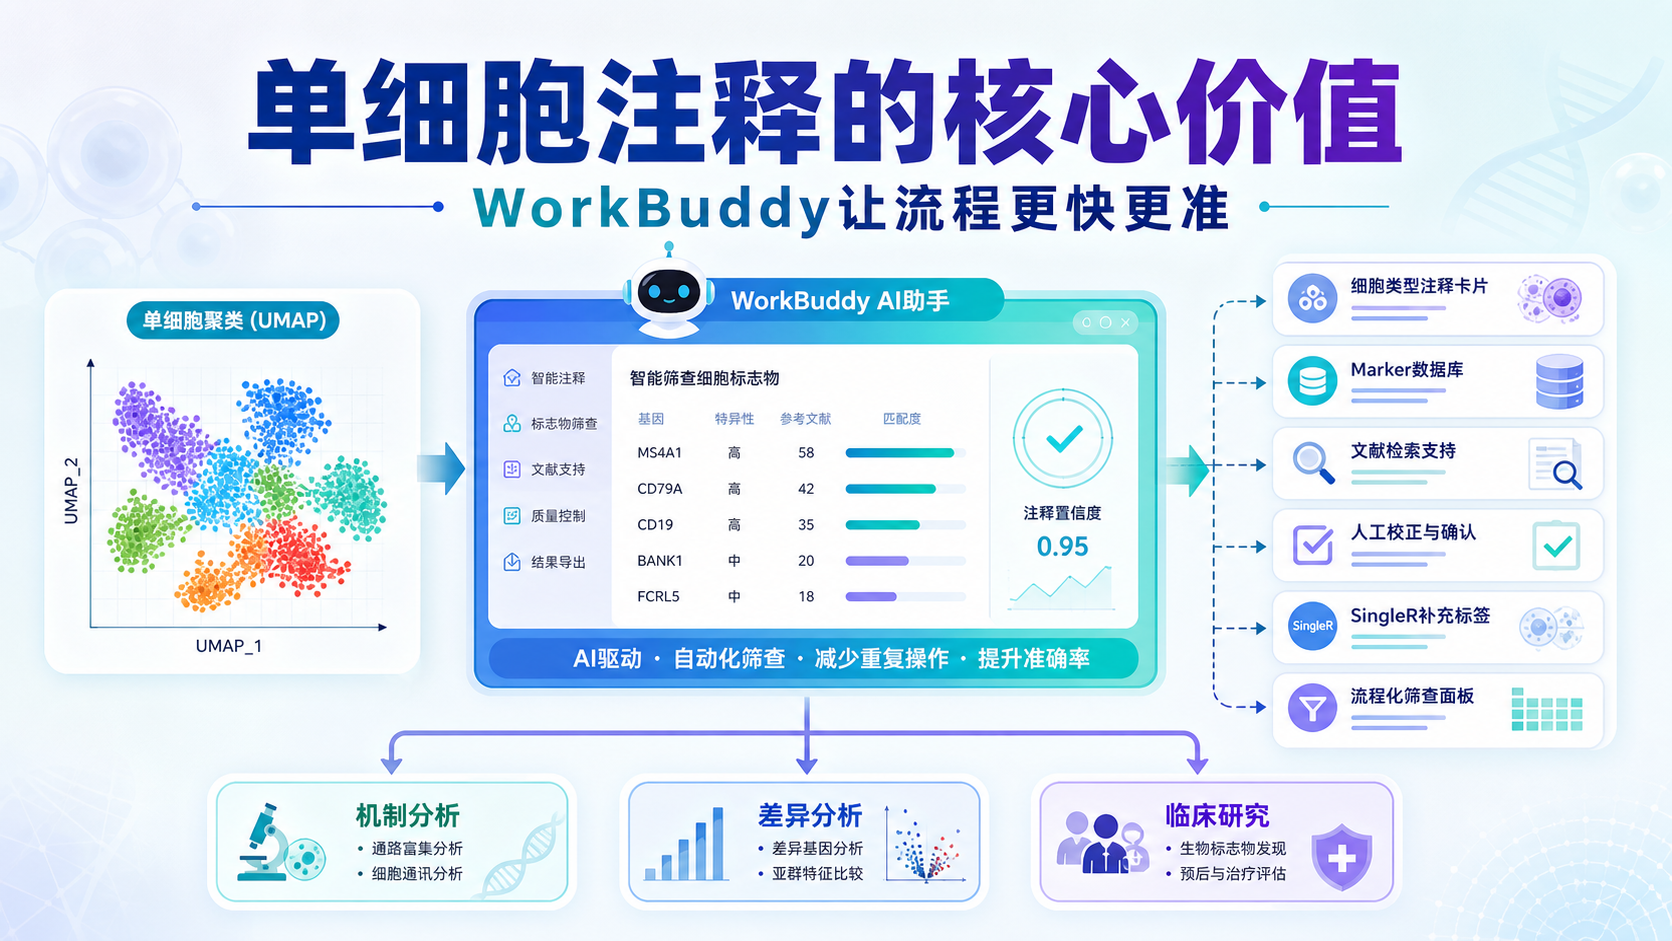
WorkBuddy的意义,不是替代专业判断,而是把重复性的整理、比对和流程执行前移。 对于已经有基础分析经验的人,它更适合作为辅助工具,帮助快速归纳候选细胞类型,减少来回切换工具和文件的时间。
2.2 适合哪些场景
WorkBuddy更适合下面几类任务:
- 初步整理cluster对应的候选细胞类型。
- 归纳marker基因和注释结果。
- 辅助生成后续需要人工复核的分析线索。
- 在多轮注释后统一整理meta.data和结果图。
它解决的是“信息多、步骤多、容易漏”的问题。 对单细胞研究而言,这一点很实际。因为真正做项目时,注释往往不是一次完成,而是要反复修正。
3. 单细胞注释的标准思路:数据库、文献和人工校正
3.1 先用已知marker建立第一轮注释
第一轮注释通常从数据库入手。常见资源包括CellMarker、cellkb和SingleR相关参考库。它们的优势是起点明确,能快速给出大类方向。
但要注意,数据库注释不是绝对答案。 不同组织、不同疾病状态、不同物种,marker表达可能变化。尤其在肿瘤样本中,同一细胞群可能出现异质性,经典marker并不总是“单一且纯粹”。
3.2 注释不清时,必须回到文献
如果某个cluster在数据库中没有清晰匹配,不要强行贴标签。更稳妥的方式是:
- 先看该cluster高表达的几个核心marker。
- 根据这些marker判断大致谱系。
- 再检索相关领域文献,补充亚型信息。
- 必要时结合差异基因和富集分析做二次确认。
单细胞注释的关键不是“找一个答案”,而是“让答案经得起复核”。 这也是为什么医学背景对注释特别重要。研究者越了解组织来源和疾病机制,判断就越可靠。
3.3 SingleR适合做补充,不适合替代全部判断
SingleR的优势是适用范围较广,能提供参考标签。但它通常偏向较粗粒度的注释。也就是说,它适合帮你缩小范围,却未必能精细区分某些亚群。
实际项目中更稳妥的做法是:
- 先用CellMarker等方法完成初轮细分。
- 再用SingleR交叉验证。
- 对冲突结果进行人工复核。
- 必要时补充marker和文献证据。
交叉验证,比单一工具更可靠。
4. 从细胞到机制,注释之后才进入真正的生物学解释
4.1 注释完成,才能谈差异分析
只有知道cluster属于哪类细胞,后续差异分析才有意义。比如同样是高表达基因,在肿瘤细胞中和在免疫细胞中,其解释完全不同。前者可能提示增殖、侵袭或代谢重编程,后者可能提示免疫激活或耗竭。
因此,细胞注释不是终点。它是进入机制分析的门槛。没有可靠注释,富集分析、轨迹分析和细胞通讯分析都可能失真。
4.2 机制推断要建立在“可解释的亚群”上
当cluster被准确注释后,研究者可以进一步追问:
- 哪些亚群在疾病组显著扩增。
- 哪些亚群表达了关键通路基因。
- 哪些细胞亚型可能参与炎症、免疫抑制或肿瘤进展。
- 哪些marker可以作为后续验证的候选靶点。
这一步的价值在于把“数据现象”转化为“机制假设”。单细胞分析真正的科研价值,不是画出漂亮的UMAP,而是提出可以验证的生物学问题。
4.3 对临床研究尤其重要的三个检查点
对于临床样本分析,建议重点检查:
- 注释是否符合样本来源组织的生理常识。
- 疾病状态下是否存在异常表达或表型漂移。
- 是否有足够证据区分相近亚群,而不是粗暴合并。
这三个检查点能显著降低误注释风险。尤其在肿瘤、免疫和发育研究中,亚群边界常常并不清晰,更需要谨慎。
5. 用WorkBuddy提升单细胞注释效率的实际思路
5.1 把重复任务交给工具,把判断留给研究者
单细胞注释中最耗时的环节,往往不是“判断”,而是“整理”。例如整理每个cluster的marker、汇总数据库结果、更新meta信息、重新生成可视化图。
WorkBuddy适合承担这类结构化工作。 它能帮助研究者更快梳理结果、缩短整理周期,并让你把精力集中在真正关键的生物学判断上。
5.2 建议的使用方式
比较稳妥的使用方式是:
- 先完成标准预处理、聚类和降维。
- 提取每个cluster的marker基因。
- 用数据库和文献进行初轮注释。
- 用WorkBuddy辅助整理候选标签和结果。
- 人工复核冲突项。
- 更新meta.data并重新绘图确认。
这个流程的核心原则是,可复核、可回溯、可修正。 这样得到的注释结果更适合论文、课题和后续实验验证。
5.3 为什么这类工具能降低错误率
单细胞分析常见错误,不在算法本身,而在流程管理。比如:
- cluster标签未同步更新。
- 某个样本的注释版本和最终图不一致。
- marker表格与结果图对应不上。
- 多轮修改后忘记保留中间版本。
WorkBuddy的价值就在于减少这些流程性失误。 对需要兼顾临床、实验和数据分析的研究者来说,这种效率提升非常实际。
总结Conclusion
单细胞注释决定了后续分析是否可靠。先聚类、再降维、后注释,是单细胞研究最基础也最关键的路径。数据库、文献和人工判断三者缺一不可。真正高质量的注释,不是依赖单一工具,而是依赖标准流程和可验证证据。
如果你希望把复杂的单细胞注释工作做得更快、更稳、更可复核,可以借助 解螺旋 的工具和服务,帮助你提升整理效率,减少重复劳动,把更多时间留给机制解释和科研产出。
- 引言Introduction
- 1. 单细胞注释为什么是下游分析的核心
- 2. WorkBuddy在单细胞注释中的价值
- 3. 单细胞注释的标准思路:数据库、文献和人工校正
- 4. 从细胞到机制,注释之后才进入真正的生物学解释
- 5. 用WorkBuddy提升单细胞注释效率的实际思路
- 总结Conclusion