14
 分享
引言Introduction
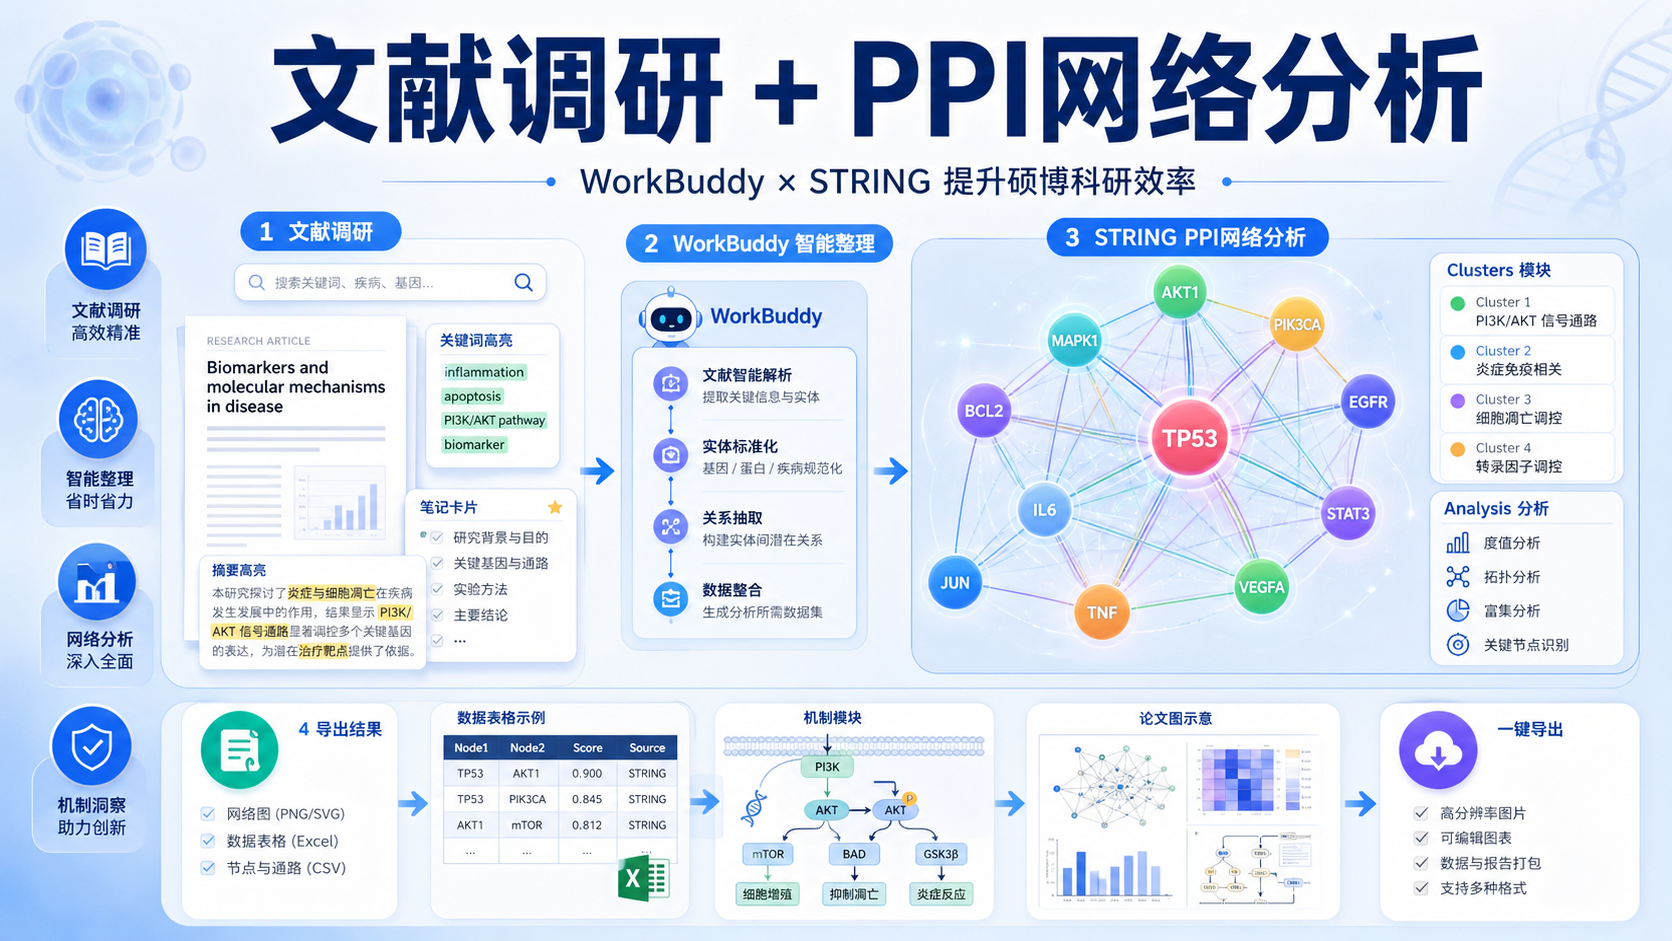
硕博阶段做文献调研,最耗时的不是“找文献”,而是把零散基因、蛋白和通路线索串成一条逻辑链。如果没有标准化流程,PPI网络很容易做得慢、乱、不可复现。
1. 为什么硕博生需要把文献调研和PPI网络分析连起来
1.1 从“读文献”到“提炼机制”
文献调研的核心,不只是总结已有结论,而是提炼可验证的机制假设。对医学生、医生和科研人员来说,常见痛点有三个。
- 关键词多,证据分散。
- 基因或蛋白名单长,人工梳理效率低。
- 机制链条不清晰,写作时容易停留在描述层面。
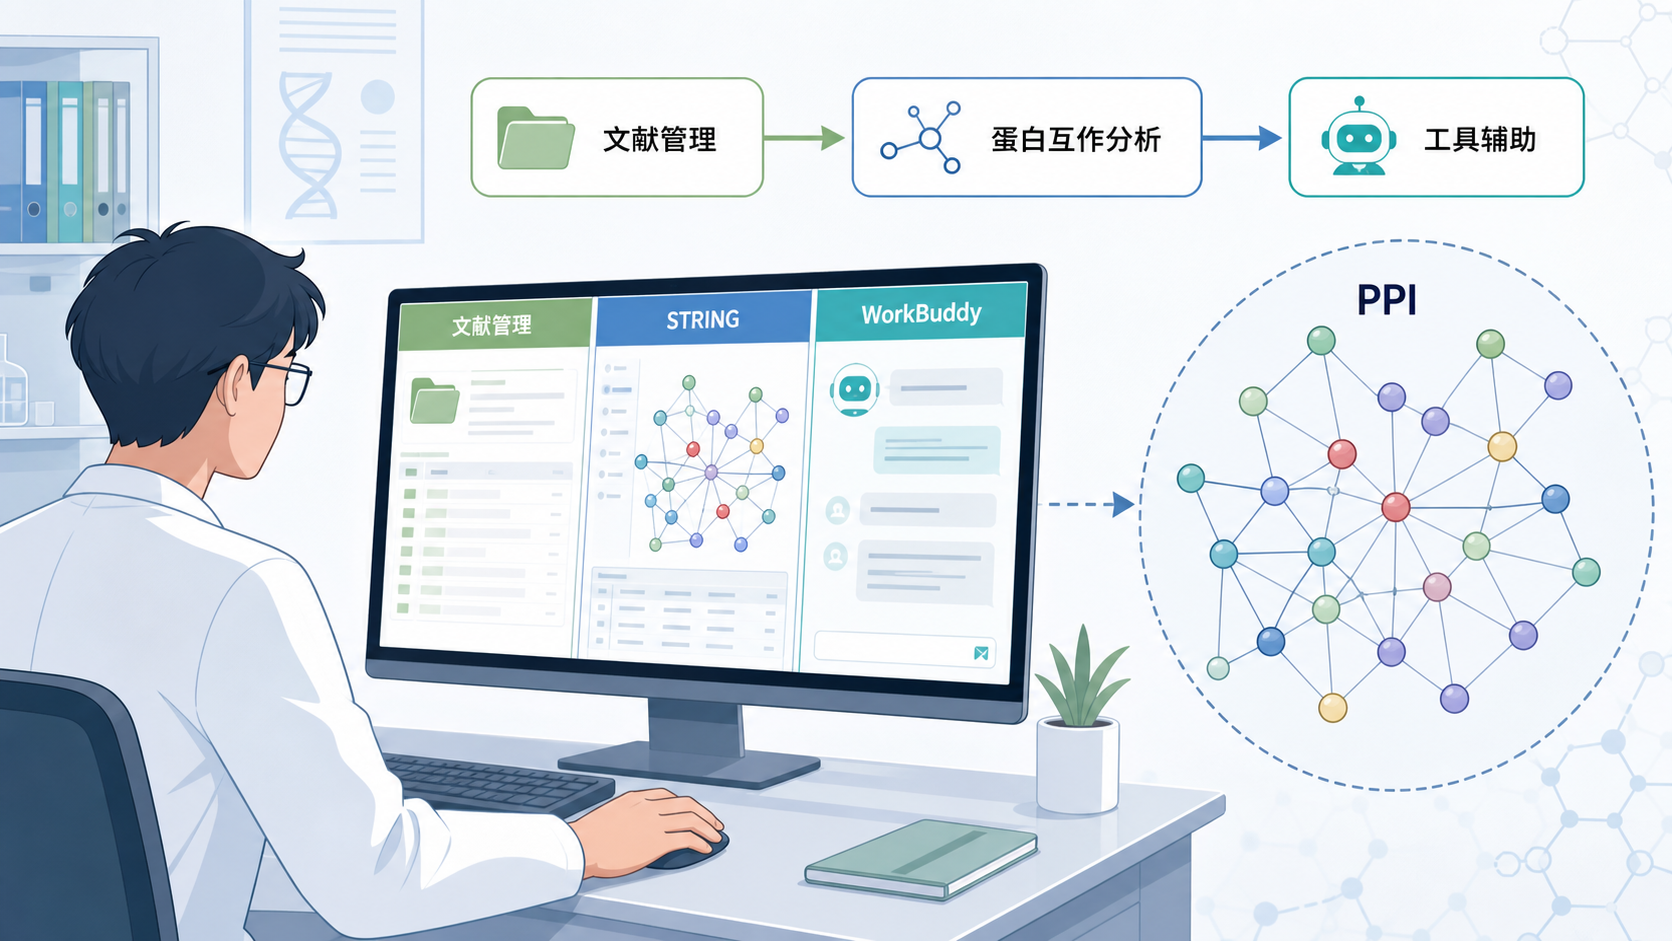
PPI网络的价值在于,把孤立的分子关系变成结构化证据。 它能帮助你判断某些蛋白是否处于同一功能模块,是否可能参与同一信号通路,是否适合作为后续实验验证对象。
1.2 WorkBuddy适合做什么
从知识库信息看,WorkBuddy并不是单纯的检索工具,而是一个面向科研流程的工具体系。它强调查文献、读文献、做方案、写摘要、写综述、做数据作图等多个环节的衔接。
对硕博生而言,WorkBuddy更适合承担前半段工作。
- 快速整理研究问题。
- 归纳文献中的候选基因或蛋白。
- 辅助形成分析思路。
- 将调研结果转化为后续可执行的任务。
这意味着,WorkBuddy负责“提速”,STRING负责“验证和可视化”。 两者结合,能明显减少从文献到机制图的时间损耗。
2. STRING PPI网络的核心作用与适用场景
2.1 STRING能解决什么问题
STRING,全称为 search tool for the retrieval of interacting genes/proteins。它的核心功能是构建蛋白质-蛋白质相互作用网络,也就是PPI网络。
根据数据库概览,STRING整合了多来源证据,包括:
- 实验数据,Experiments。
- 已有数据库信息,Databases。
- 文本挖掘结果,Textmining。
- 计算预测信息,如共表达、共现、基因邻近和融合等。
STRING最大的优势,是把多种证据统一为可视化、可评分的互作网络。 这对文献调研尤其重要,因为研究者可以快速判断一个候选蛋白是否真的是“网络节点”,而不是孤立出现的单一结果。
2.2 适合哪些研究阶段
STRING尤其适合下面几类任务。
- 差异基因后的功能初筛。
- 文献中候选蛋白的机制聚类。
- 通路假设的建立。
- 综述写作中机制图的构建。
对于只有少量候选蛋白的场景,单蛋白检索更合适。若你已经整理出一组候选蛋白,多蛋白检索更适合直接看输入蛋白之间是否存在互作关系。 这一步对硕博论文的“结果-讨论”部分尤其有帮助。
2.3 多蛋白检索与文献调研的关系
多蛋白检索不是单纯画图,它更像一个“证据筛网”。
你可以把文献调研得到的蛋白名单输入 STRING,观察以下内容:
- 哪些蛋白彼此直接相连。
- 哪些节点是局部中心。
- 哪些蛋白形成紧密模块。
- 哪些蛋白可能需要继续补证据。
如果多个蛋白在网络中形成高密度簇,往往提示它们可能参与同一功能轴。 这一点对于构建机制假说非常实用。
3. WorkBuddy+STRING的标准化工作流
3.1 先用WorkBuddy做前期信息整理
建议先用 WorkBuddy 完成文献调研的基础整理,再进入 STRING 分析。这样做的逻辑是先“筛”,再“证”。
可按以下步骤推进。
- 明确研究主题。
- 汇总相关文献中的候选基因或蛋白。
- 统一命名格式,优先使用标准 symbol。
- 按研究物种整理名单。
- 输出可直接用于后续分析的文本表格。
标准化命名非常关键。 如果前期命名混乱,后面在 STRING 中容易出现匹配偏差,增加人工确认时间。
3.2 在STRING中进行多蛋白检索
知识库给出的流程很明确。多蛋白检索一般按以下顺序进行。
3.2.1 输入候选蛋白列表
进入 STRING 后,选择 Multiple proteins,将蛋白名称直接粘贴到输入框。也可以上传表格。随后选择物种。
如果物种不确定,可以先选择能匹配到蛋白数目最多的物种,再继续确认。
3.2.2 确认映射结果
点击 CONTINUE 后,STRING 会自动匹配输入蛋白。系统默认选中最可能的蛋白,并显示匹配信息。
这一步必须逐项核对。 尤其是输入蛋白较多时,要确认页面是否已全部加载完毕,避免漏检或误配。
3.2.3 获取PPI网络
确认无误后,STRING 会展示输入蛋白之间的 PPI 网络图。多蛋白检索默认展示的是输入蛋白间的互作关系,不会像单蛋白检索那样自动扩展大量预测互作蛋白。
这对文献调研很友好。因为你更关心的是“这批候选蛋白之间是否存在已知联系”,而不是先被大量外围节点干扰。
3.3 解读网络时要看什么
PPI图出来后,不要只看“有没有线”。建议重点看四个层面。
- 节点数量,反映候选集合大小。
- 连线密度,反映蛋白间关联强弱。
- 局部模块,提示可能的功能分区。
- confidence,提示互作证据强弱。
线越粗,通常代表互作置信度越高。 但高置信度不等于因果关系成立。它只是说明数据支持更强,仍需结合文献和实验背景判断。
4. 用Analysis、Clusters和导出功能提升调研效率
4.1 Analysis适合快速回答“这些蛋白在做什么”
在多蛋白检索中,Analysis 是非常实用的功能。知识库指出,它常用于分析输入基因集合的 GO 和 KEGG 通路。
这一步的价值在于把“名单”变成“主题”。
例如你输入一组差异蛋白后,Analysis 可能会提示其富集到某些通路。这样你在写文献综述或结果讨论时,就能直接围绕通路组织语言,而不是逐个解释每个蛋白。
如果某个模块没有出现,通常表示该条目没有富集到。 这也是一种有效信息,不必强行解读。
4.2 Clusters帮助你找到机制模块
在写硕士或博士论文时,研究者最缺的往往不是数据,而是结构。Clusters功能可以把网络中的紧密相连区域提取出来,帮助你看到模块化特征。
常见用途包括:
- 识别功能子网络。
- 辅助筛选关键节点。
- 支持后续实验设计。
- 为论文图表提供机制框架。
模块化结果比零散节点更适合写进论文主线。 这也是为什么很多高质量论文都强调“网络-通路-靶点”三层结构。
4.3 导出结果,方便写作和复现
知识库中提到,STRING可以导出相应结果,进一步与Cytoscape联用。对于科研写作来说,导出功能至少有三层价值。
- 保留原始分析结果。
- 方便后续补图和改图。
- 提升论文复现性。
如果你后续要用 Cytoscape 进行更精细的网络美化,可以先从 STRING 导出网络文件,再导入软件继续处理。
对于重视论文质量的硕博生来说,图的可复现性和可追溯性,同样是科研规范的一部分。
5. 从文献调研到论文图:如何把流程跑顺
5.1 一个更稳妥的执行顺序
如果目标是提高文献调研效率,建议按下面顺序执行。
- 用 WorkBuddy 整理主题与文献。
- 提取候选蛋白或基因。
- 统一物种和命名。
- 输入 STRING 做多蛋白检索。
- 看网络、看Analysis、看Clusters。
- 导出结果,补充到写作框架中。
这个顺序的好处是减少返工。先用工具整理信息,再用数据库验证关系,最后回到写作。
5.2 需要避免的常见错误
硕博生在做PPI网络时,常见问题主要有以下几类。
- 只看图,不看证据来源。
- 蛋白命名不规范,导致映射错误。
- 物种选择错误。
- 过度依赖低置信度扩展网络。
- 把相关性直接写成因果性。
尤其要注意,调低 confidence 虽然能增加节点和连线,但假阳性也会增加。 这意味着网络更“热闹”,但未必更可信。
5.3 为什么WorkBuddy和STRING适合联用
WorkBuddy擅长把文献调研流程前移,STRING擅长把候选分子关系可视化并量化。两者的联用,本质上是在解决同一个问题。
也就是,如何把零散证据快速变成可写、可画、可解释的机制框架。
如果你在做课题设计、综述写作或组会汇报,这种组合能明显减少反复查找和手工整理的时间。 对需要高频产出的小组和个人研究者尤其适用。
5.4 结合解螺旋,进一步压缩调研成本
如果你希望把文献检索、信息整理、PPI分析和写作衔接成一条更完整的科研流程,可以考虑使用解螺旋的相关资源与工具体系。它适合把文献、课程、数据分析和AI工具串联起来,帮助你更快完成主题梳理、候选蛋白筛选和结果表达。对于需要高效率推进课题的硕博生来说,这类整合型工具能直接减少重复劳动。
总结Conclusion
WorkBuddy适合前期文献调研和信息整理,STRING适合把候选蛋白转化为可视化的PPI网络。两者结合,能把“读文献、找机制、画网络、写讨论”串成一条高效率工作流。 对硕博生而言,这不仅节省时间,也能提升机制分析的规范性和可复现性。
如果你希望进一步把这套流程落地,可以结合解螺旋的工具与资源体系,把文献调研、网络分析和写作衔接得更紧密。
- 引言Introduction
- 1. 为什么硕博生需要把文献调研和PPI网络分析连起来
- 2. STRING PPI网络的核心作用与适用场景
- 3. WorkBuddy+STRING的标准化工作流
- 4. 用Analysis、Clusters和导出功能提升调研效率
- 5. 从文献调研到论文图:如何把流程跑顺
- 总结Conclusion