17
 分享
引言Introduction
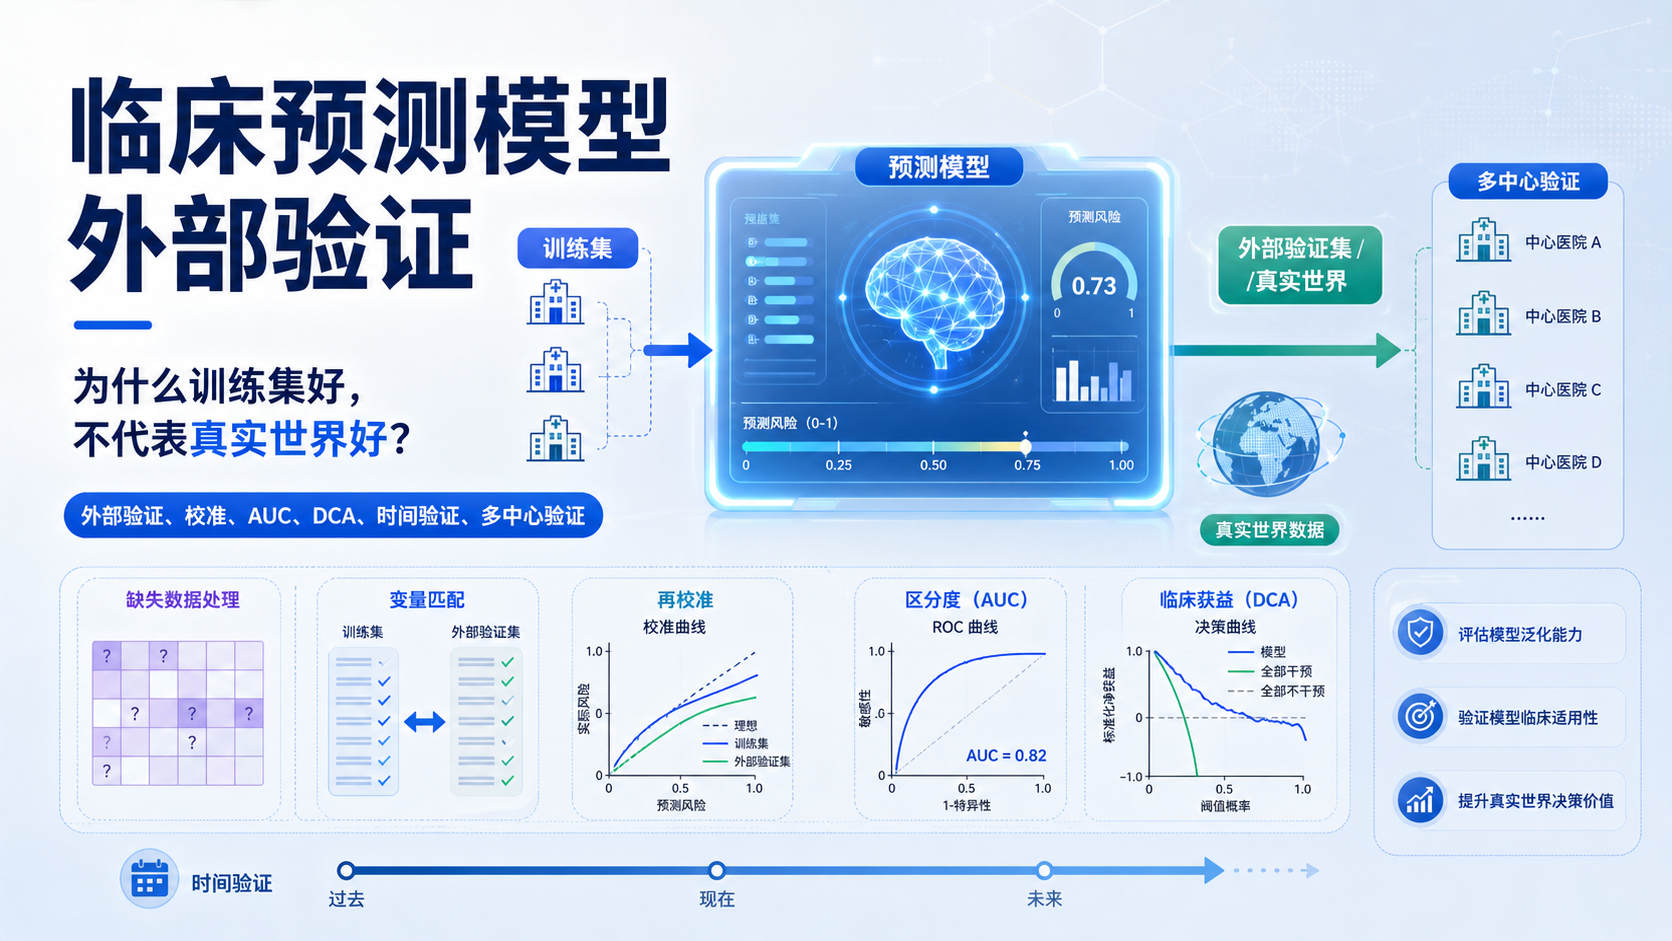
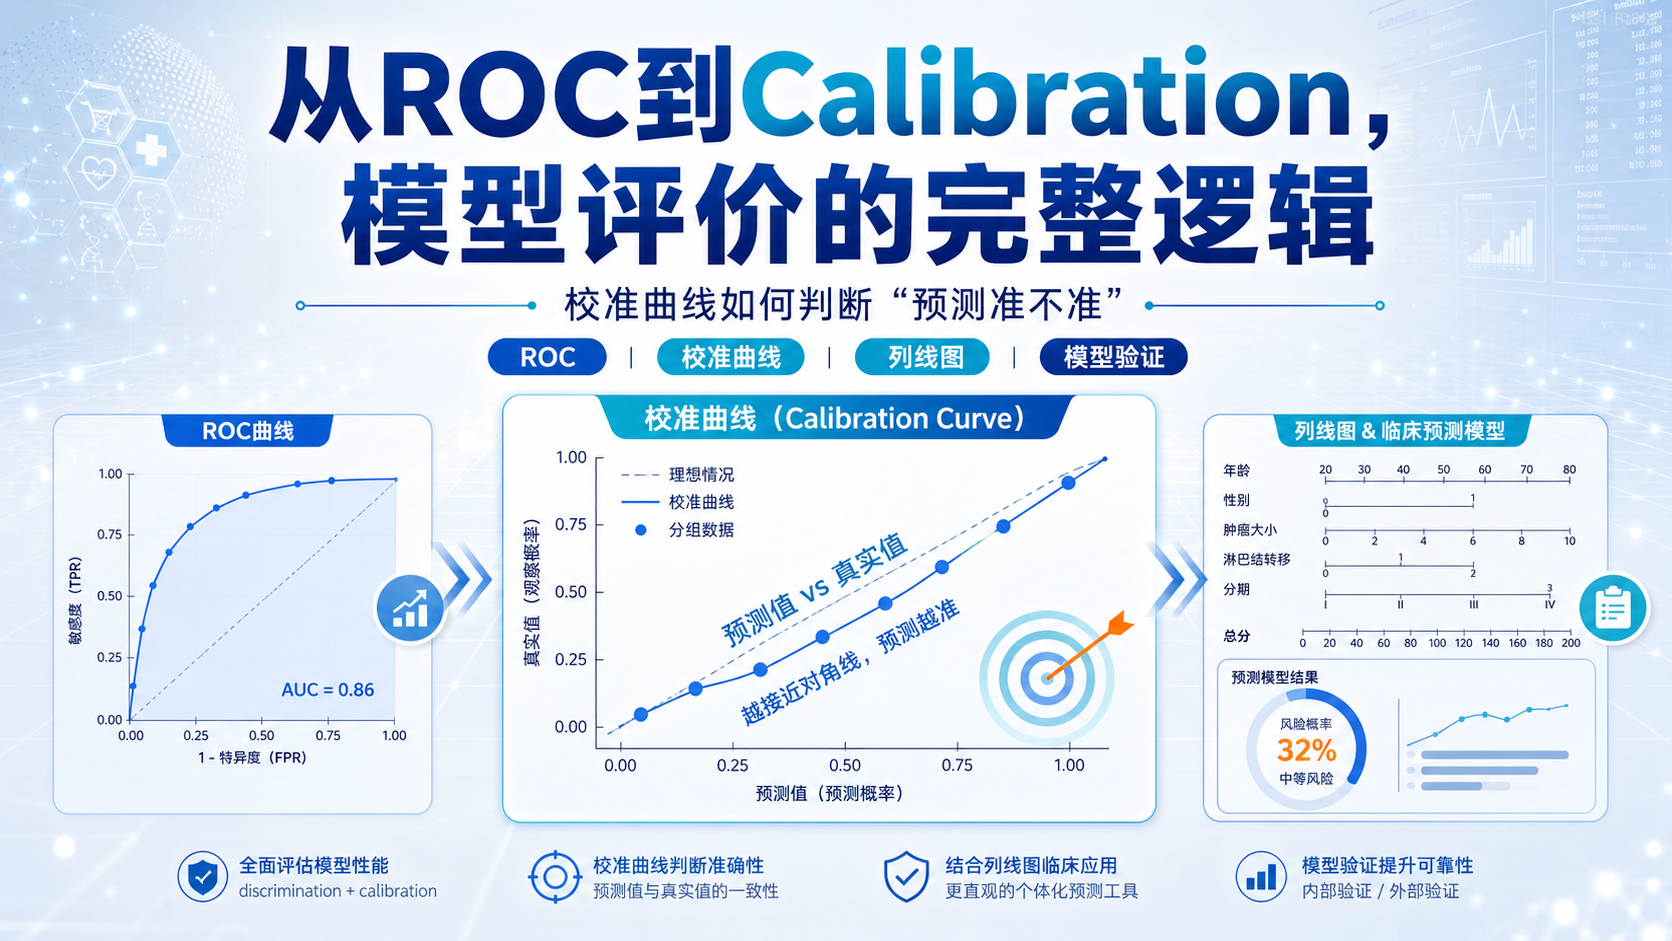
ROC能告诉你模型“分得开”,但不能证明它“算得准”。很多临床预测模型AUC很高,实际应用却偏差明显,问题往往出在校准不够好。区分度高,不等于临床可用。
1. 为什么临床预测模型不能只看ROC
1.1 ROC回答的是“能不能区分”
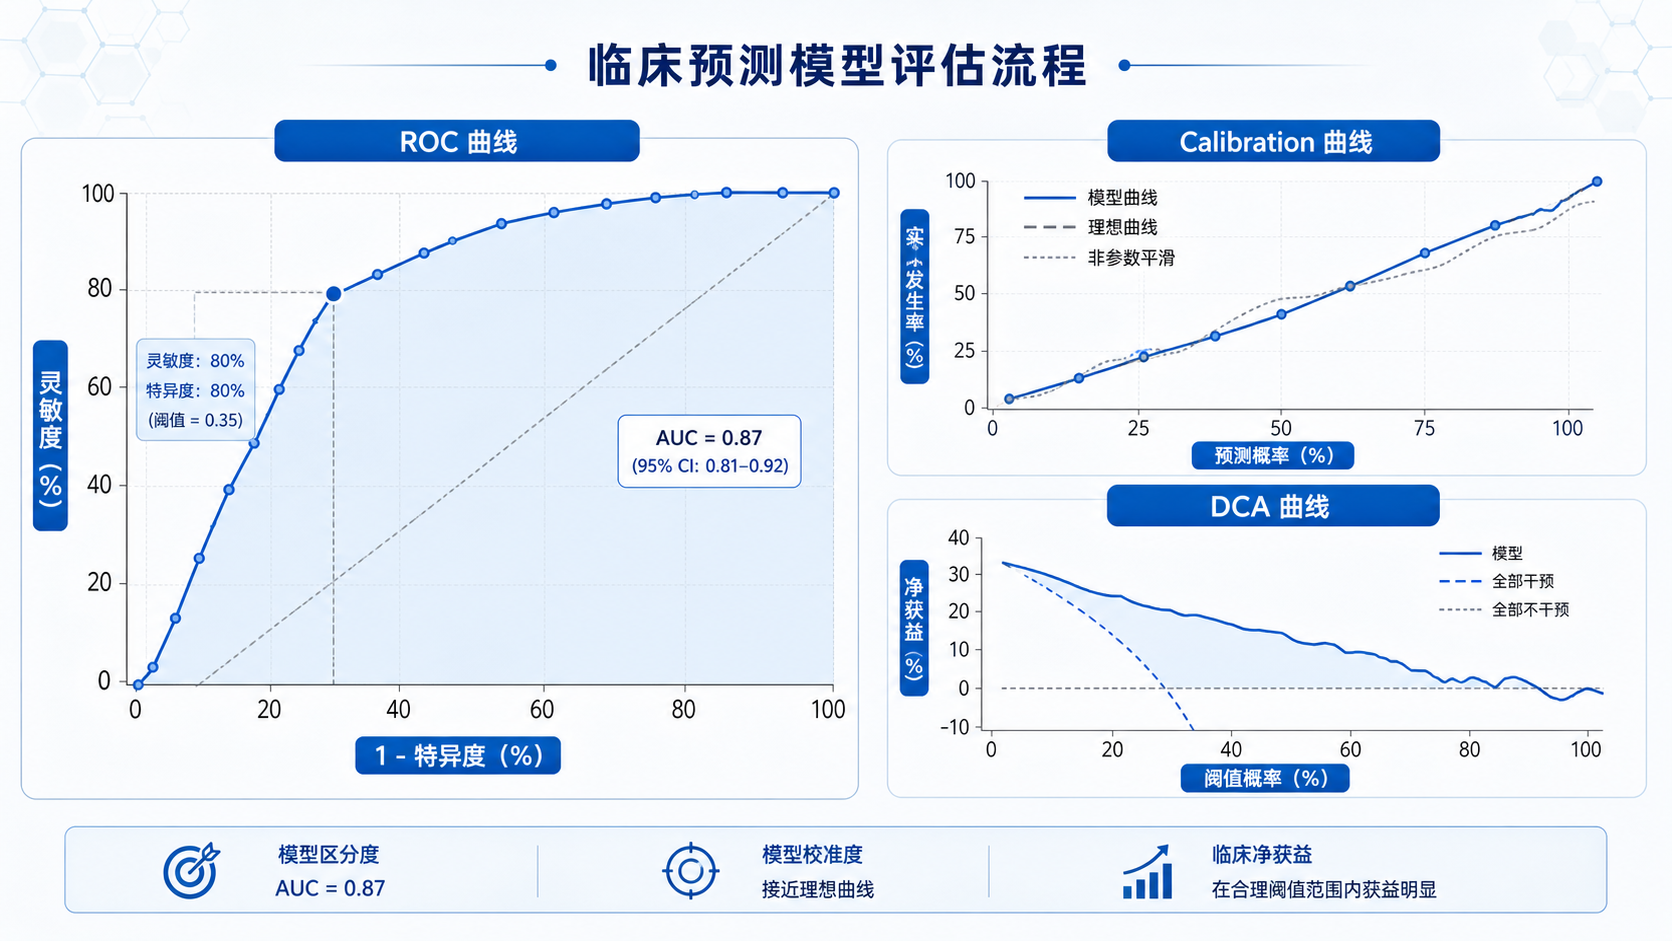
ROC曲线评估的是模型的区分能力。横坐标是1减特异度,纵坐标是真阳性率,也就是灵敏度。它关注的是不同阈值下,模型对阳性和阴性的分类效果。
ROC和AUC适合回答一个问题:模型能不能把高风险和低风险人群分开。
在二分类场景里,AUC越接近1,说明模型区分能力越强。通常AUC在0.5附近接近随机,0.7以上有一定价值,0.8以上通常可认为表现较好。
但这里有一个常见误区。AUC高,只说明排序能力好,不代表预测概率准确。
比如模型预测某患者5年生存率为80%,实际可能只有40%。这时模型虽然能把人分层,但概率本身是失真的。
1.2 临床更关心“预测值准不准”
临床决策并不只依赖排序。医生还要看模型给出的绝对风险值是否可信。
如果一个模型总是高估风险,患者会被过度干预。若总是低估风险,又可能延误治疗。
这就是Calibration曲线出现的原因。Calibration曲线用于评估模型预测概率与真实发生概率的一致性。
它关注的不是“谁更高”,而是“预测多大,现实多大”。
2. Calibration曲线到底怎么理解
2.1 横轴是预测值,纵轴是真实值
Calibration曲线的横坐标通常表示模型预测的OS概率、复发概率或事件发生概率。纵坐标表示实际观察到的概率。
理想情况下,两者完全一致,曲线应贴近45度对角线。
如果曲线靠近对角线,说明模型校准良好。
如果曲线明显偏离对角线,说明模型存在系统性偏差。比如预测值普遍高于真实值,表示模型高估风险。反之则表示低估风险。
在预后模型中,Calibration常用于OS、PFS、DFS等结局的预测验证。常见时间点包括1年、3年、5年。不同时间点可以分别绘图,观察模型在不同随访阶段的稳定性。
2.2 校准曲线看的是“概率一致性”
可以把Calibration曲线理解成一种“概率纠偏图”。
它不是单纯看分类对不对,而是看模型输出的概率是否可信。
例如,某组患者模型预测3年生存率为70%,实际观察为68%。这说明该区间校准较好。
但如果模型预测70%,实际只有50%,就说明存在明显过估计。
对于临床预测模型,区分度和校准度必须同时考虑。
只看ROC,容易得到“会区分但不会预测”的模型。
3. 校准曲线在论文和模型评估中的位置
3.1 它通常和C-index、ROC、DCA一起出现
在临床预测模型文章中,常见的评价组合是:
- C-index,用于总体区分能力评价。
- ROC/AUC,用于分类性能或不同时间点表现。
- Calibration曲线,用于校准度验证。
- DCA曲线,用于临床净收益评估。
这四类指标分别回答不同问题。
ROC看能不能分开。
Calibration看准不准。
DCA看值不值得用。
C-index则更偏向总体一致性。
3.2 列线图后面一定要接校准验证
如果文章构建了nomogram,也就是列线图,通常不能只展示它长什么样。必须说明它预测性能如何。
上游知识库中的案例就很典型。列线图是基于病理信息和基因表达等变量计算总分,再映射到生存概率。这个过程本身并不难,关键在于验证。
列线图的核心不是“能不能算分”,而是“算出来的概率是否靠谱”。
因此,校准曲线几乎是预测模型论文的标配。
4. 如何阅读一张Calibration曲线
4.1 先看是否贴近对角线
阅读校准曲线时,第一步看模型曲线是否接近理想对角线。
如果整体贴近,说明预测概率与实际概率一致性较好。
通常图中会有三条信息:
- 理想线,对角线,表示完全一致。
- 模型预测线,表示模型校准结果。
- 置信区间或平滑带,表示不确定性范围。
曲线越贴近对角线,模型越可信。
如果偏离较大,尤其在高风险区或低风险区偏离明显,提示模型在某些人群中校准不足。
4.2 再看不同时间点的一致性
对生存模型来说,1年、3年、5年校准可能并不一致。
有些模型短期预测好,长期就偏差明显。也有些模型在高危人群中表现更稳定,低危人群误差较大。
因此,校准不能只看一个时间点。
如果研究目标是长期预后,至少要报告多个时间点的Calibration结果。
4.3 注意样本量和分层
校准曲线的稳定性和样本量有关。样本过少时,局部波动会更明显。
如果事件数不足,曲线的平滑度也会受到影响。
此外,不同风险分层可能有不同的校准表现。
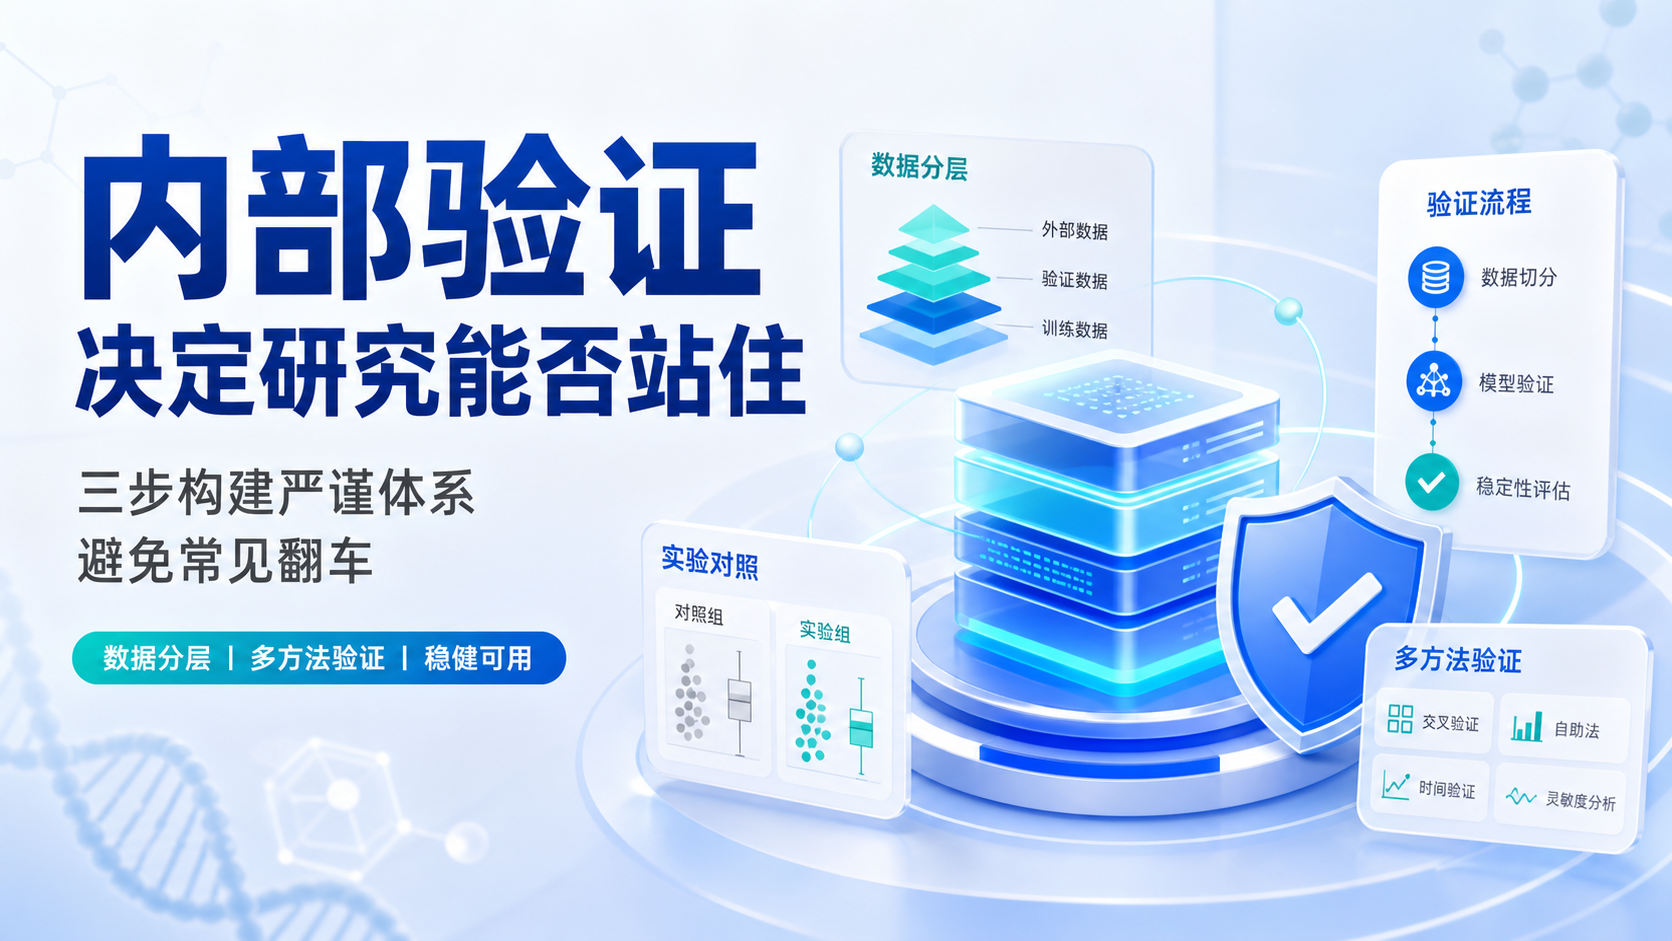
这也是为什么很多研究会结合风险分组、训练集和验证集分别绘图。训练集校准好,不代表外部验证也好。
5. 统计实现和常见误区
5.1 R中常用校准评估方法
在R环境下,校准曲线通常用于预测模型评估和模型改进。
常见流程是先建立模型,再生成预测概率,然后把预测概率与真实结局进行对比绘图。
对于生存结局,通常会在特定时间点做校准,如5年OS。
图中横坐标是预测OS,纵坐标是实际OS。蓝色曲线常用于表示模型在某时间点的预测表现。只要看曲线是否尽量贴近对角线,就能快速判断校准情况。
5.2 不要把“拟合好”误解为“能临床应用”
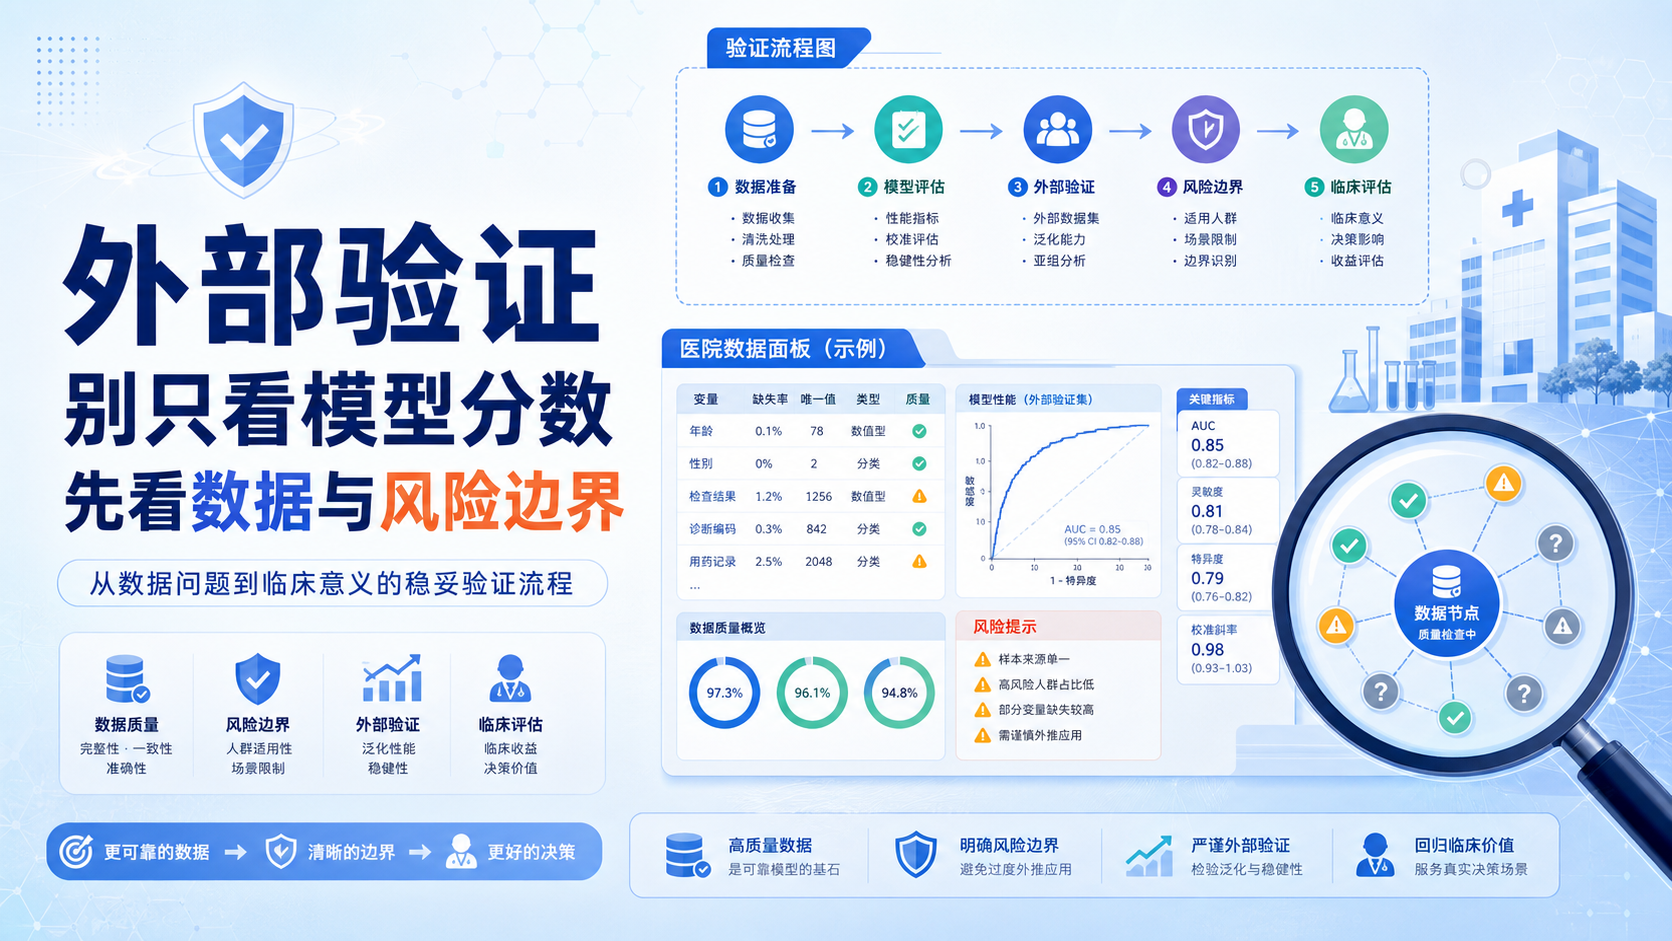
很多研究在训练集里表现很好,但外部队列一验证就下降。
这是因为模型可能过拟合,或样本分布不同。校准曲线能帮助发现这个问题。
常见误区包括:
- 只报AUC,不报校准曲线。
- 只看训练集,不做验证集。
- 只看总体曲线,不看关键风险区间。
- 只谈统计显著,不谈临床可解释性。
一个真正可用的临床模型,必须同时具备区分度和校准度。
6. 从ROC到Calibration:模型评价的完整逻辑
6.1 ROC是第一步,校准是第二步
可以把模型评价理解成三层:
- 先看ROC,判断模型有没有区分能力。
- 再看Calibration,判断概率是否准确。
- 最后看DCA,判断临床是否真正有收益。
如果只做第一步,模型可能只是“看起来聪明”。
只有把三步补齐,模型才更接近临床转化。
6.2 结合列线图才能落地
列线图的价值在于把多个变量整合成一个可读的风险工具。
但它不是终点。列线图需要通过ROC证明区分力,通过Calibration证明可信度,通过DCA证明临床净收益。
这也是临床预测模型文章的标准结构。
先建模,再验证,再解释,再转化。
7. 用解螺旋把模型评估做完整
7.1 从ROC到校准曲线,最难的是方法串联
很多医学生、医生和科研人员并不是不会画图,而是不知道每张图在论文里该放什么位置,怎么解释,怎么和前后结果衔接。
ROC、C-index、Calibration、DCA,这些指标分散看都不难,难的是形成一套完整的模型评价逻辑。
解螺旋的价值就在于把这些方法串成一条清晰路径。
从数据整理,到模型构建,到ROC分析,再到Calibration曲线和DCA解读,能帮助你少走弯路,更快完成高质量结果输出。
7.2 让模型从“能算”走向“能用”
对临床研究来说,真正有价值的不是一张漂亮图,而是一套经得起验证的预测模型。
如果你正在做列线图、ROC分析或校准曲线评估,建议把“区分度、校准度、临床净收益”放在同一框架下考虑。这样写出来的结果更完整,也更符合E-E-A-T要求。
总结Conclusion
ROC曲线解决的是模型能不能分开人群,Calibration曲线解决的是模型预测准不准。 两者不是替代关系,而是互补关系。对于临床预测模型,尤其是列线图和预后模型,只有同时验证区分度、校准度和临床收益,结果才更可信。
如果你正在整理论文、构建预测模型或准备模型验证部分,建议系统学习这些方法。想把ROC、Calibration曲线、DCA和列线图一次性理清,可以关注解螺旋 ,帮助你更高效地完成临床研究写作与分析。
- 引言Introduction
- 1. 为什么临床预测模型不能只看ROC
- 2. Calibration曲线到底怎么理解
- 3. 校准曲线在论文和模型评估中的位置
- 4. 如何阅读一张Calibration曲线
- 5. 统计实现和常见误区
- 6. 从ROC到Calibration:模型评价的完整逻辑
- 7. 用解螺旋把模型评估做完整
- 总结Conclusion