9
 分享
引言Introduction
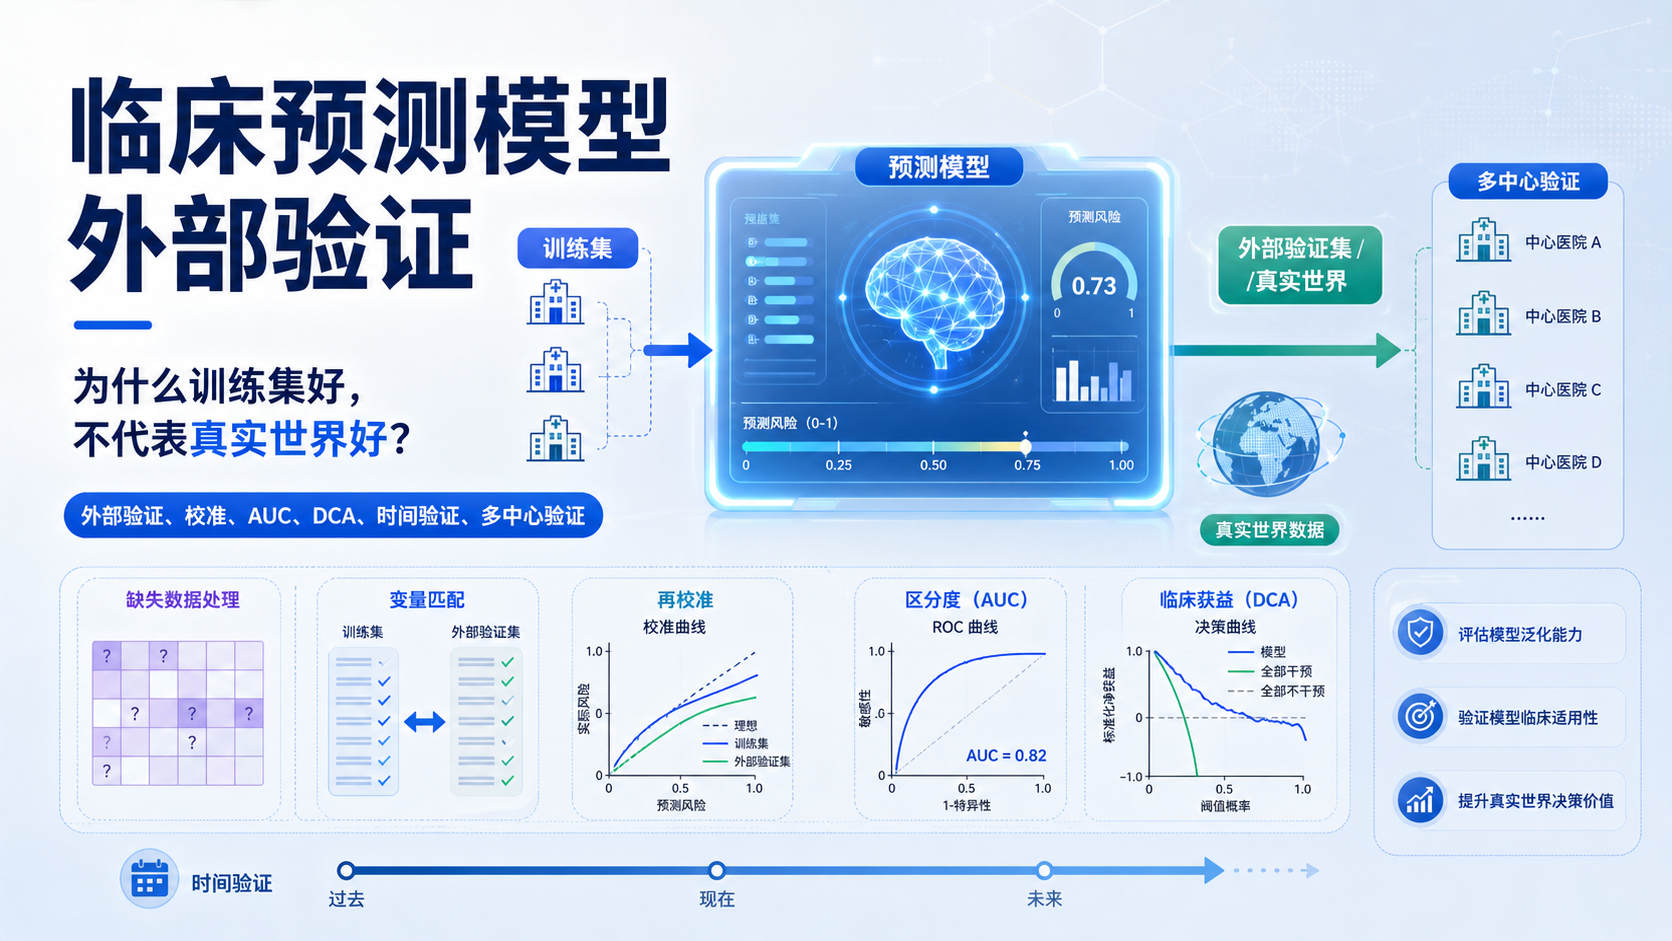
临床预测模型做出来,不等于能用。很多模型在训练集表现很好,一到外部数据就掉分,根源往往在于没有做好外部验证。 对医学生、医生和科研人员来说,真正决定模型可信度的,不是AUC有多高,而是它能否在新中心、新人群、新时间段中稳定成立。
1. 为什么外部验证是临床预测模型的关键一步
1.1 训练集好,不代表真实世界好
预测模型最常见的问题,是过拟合 。模型在开发数据上学到了噪声,也学到了数据集特有的结构。结果就是,内部AUC可能很漂亮,但换到外部中心后,区分度明显下降。
这不是偶然,而是模型开发的常见规律。外部验证的价值,就是检验模型是否真的具有泛化能力。
临床研究中,外部验证至少回答三个问题:
- 模型能否在独立人群中维持性能。
- 模型是否受中心差异、检测平台差异影响。
- 模型是否需要重新校准后再应用。
1.2 外部验证比内部验证更接近临床落地
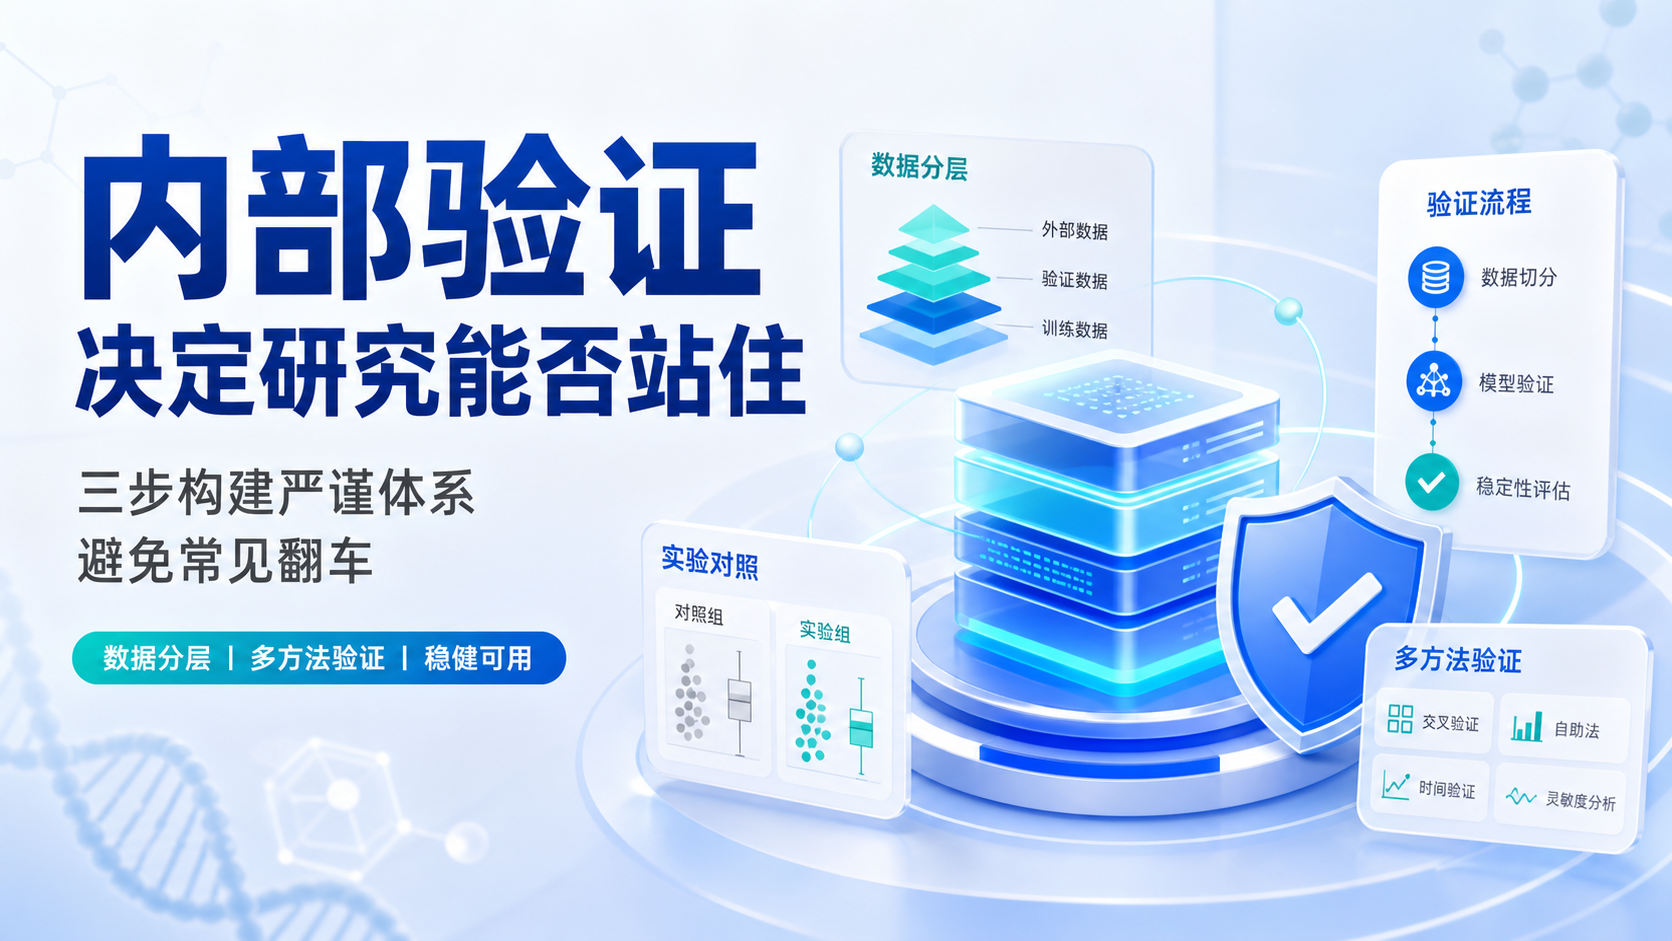
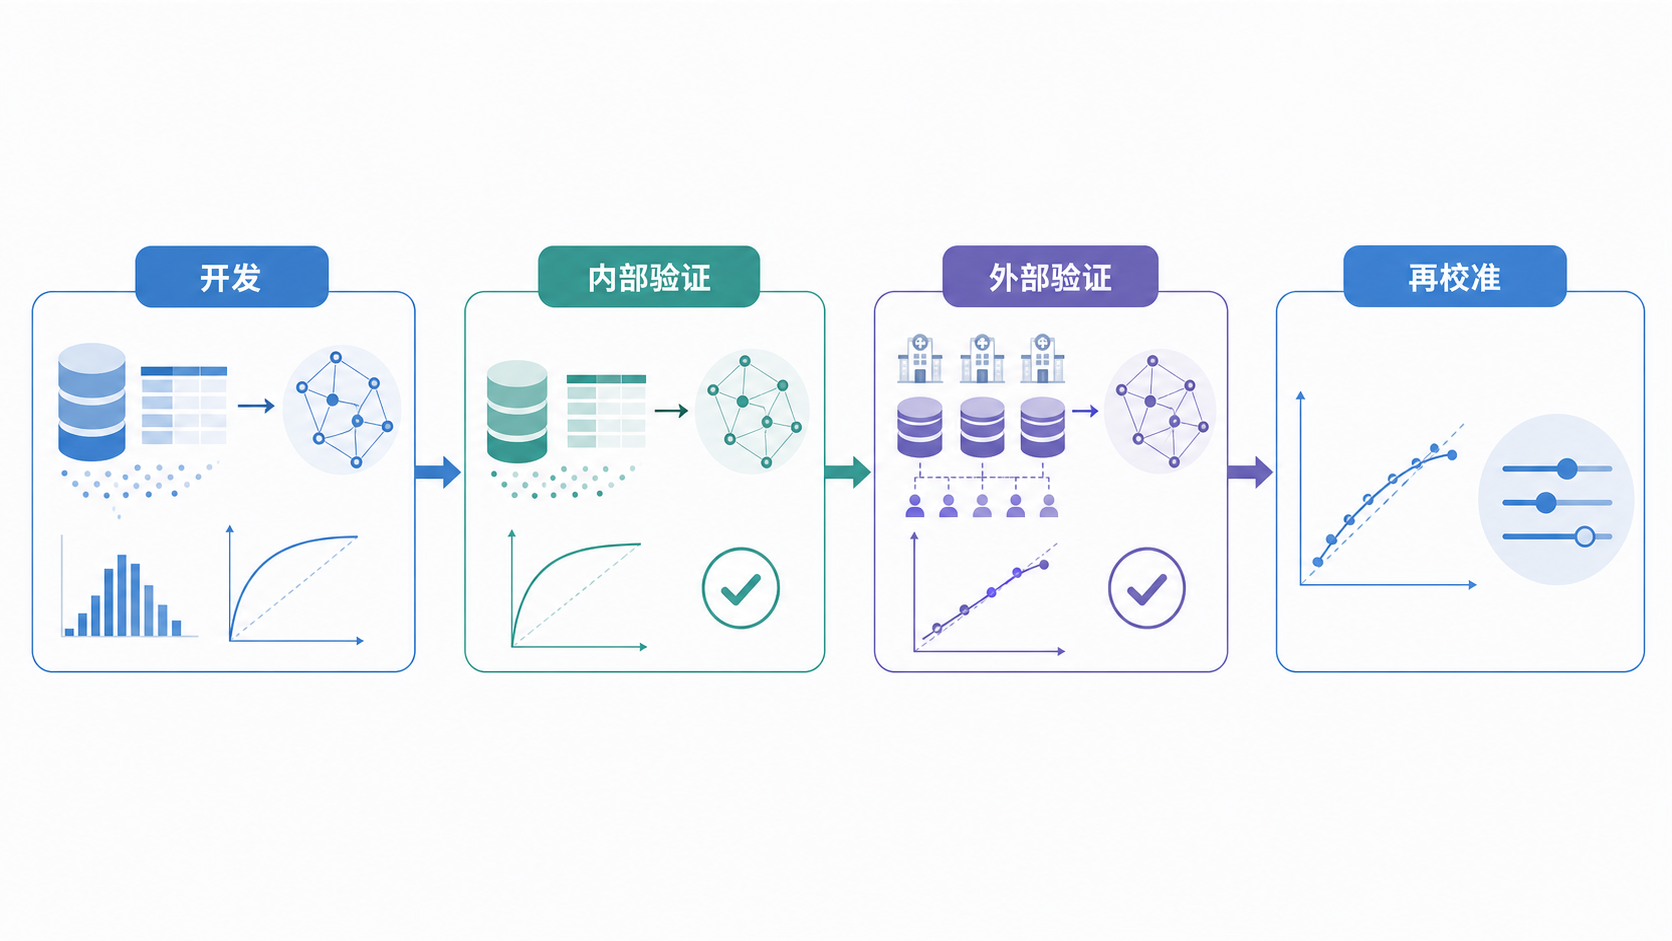
内部验证常用交叉验证、bootstrap重抽样或训练集和验证集随机拆分。它们能评估模型稳定性,但本质上仍在同一数据来源内完成。
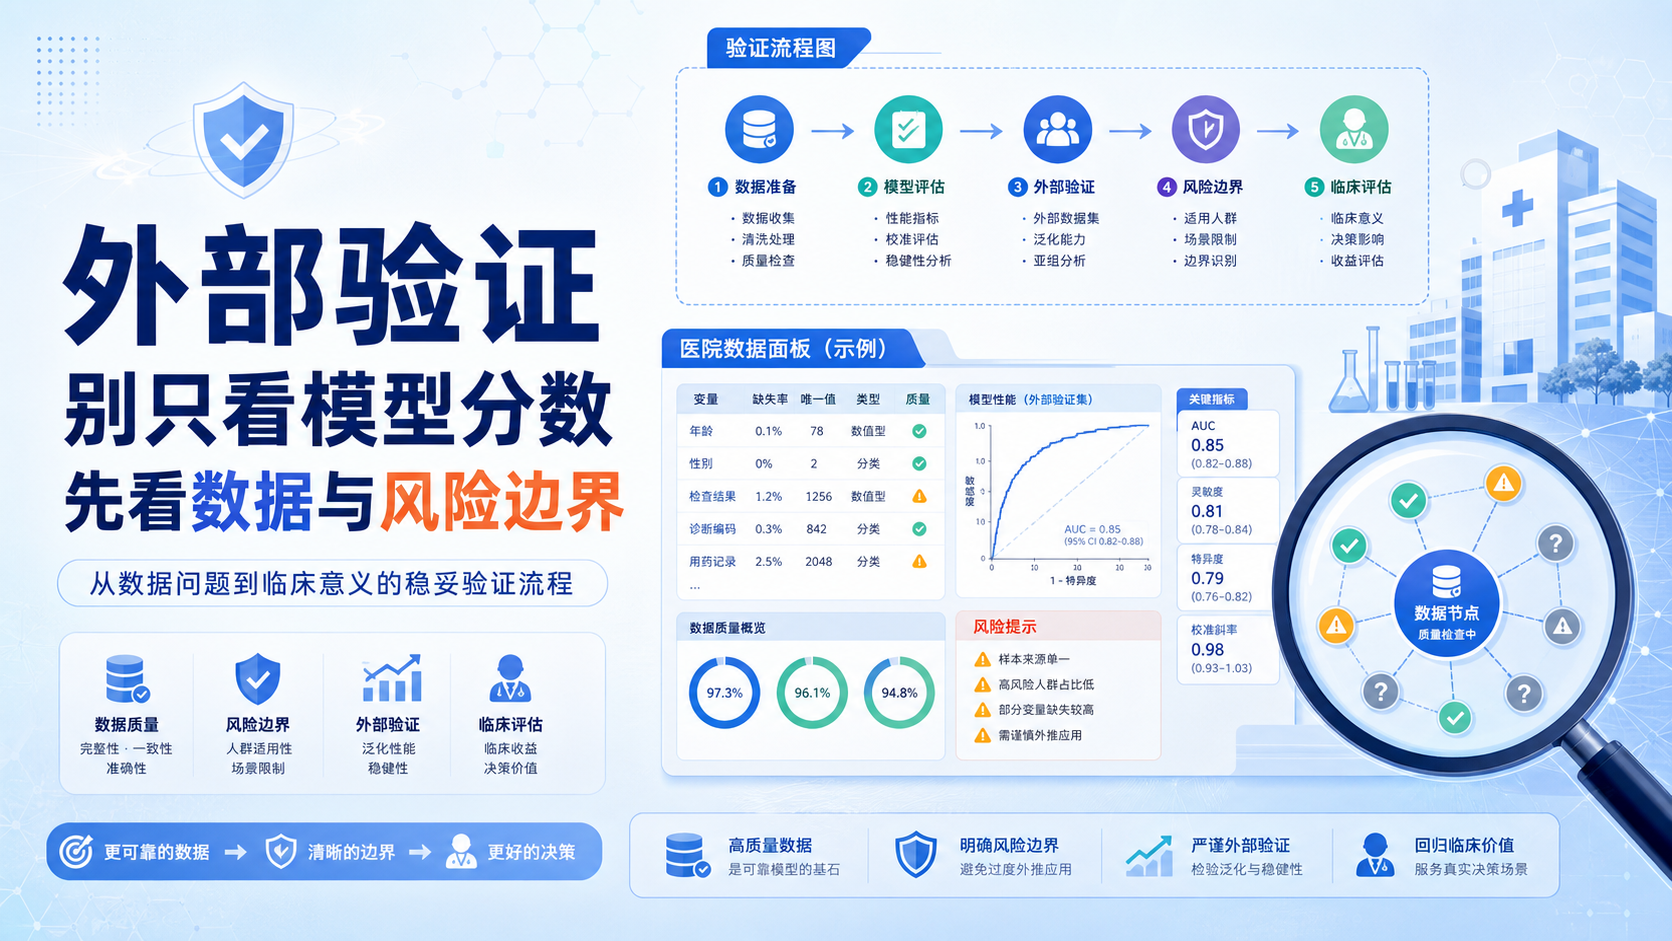
外部验证才是对模型“出门考试”。 如果模型只能在本院数据里好用,临床价值就有限。尤其在多中心研究、转化医学和临床决策支持场景中,外部验证几乎是发表和应用的前提。
1.3 不是所有“外部”都一样
外部验证并不只有一种。按数据来源可分为:
- 时间外部验证 。同一中心,不同时间段。
- 空间外部验证 。不同中心,不同地区。
- 谱系外部验证 。不同人群构成或疾病谱。
- 平台外部验证 。不同检测平台、不同实验流程。
验证层级越高,模型的可信度越强。 但难度也越大。研究设计时要根据资源、样本量和临床问题选择合适的外部数据。
2. 外部验证前,先把模型开发阶段做扎实
2.1 模型问题要清楚,终点要明确
外部验证不是独立存在的。它建立在前期模型开发质量之上。
如果终点定义模糊,或者结局时间不统一,外部验证再漂亮也没有意义。对于预后模型,要先明确:
- 结局事件是什么。
- 随访时长是否足够。
- 是否存在删失。
- 终点是否具有临床意义。
终点定义越清晰,外部验证越可靠。
2.2 特征选择要控制复杂度
特征过多,是外部失效的重要原因。开发阶段建议优先保留稳定、可重复、可解释的变量。
常见策略包括:
- 单因素分析初筛。
- LASSO降低冗余特征。
- 多因素回归保留独立变量。
- 避免把过多相关变量同时放入模型。
临床预测模型不是“变量越多越好”。变量越多,越容易在外部数据中失稳。
2.3 样本量决定模型上限
开发阶段样本太少,外部验证通常不理想。预测模型常提到EPV,即每个参数对应的事件数。实践中常用经验是:EPV尽量达到20 ,尤其在Cox回归和Logistic回归中更稳妥。
如果开发集本身事件数不足,模型很可能在外部数据中表现不佳。此时问题不在验证,而在模型基础不牢。
3. 外部验证的核心方法学要点
3.1 验证前要保证变量可比
外部验证最常见的失败原因之一,是变量口径不一致。
比如开发集中使用的是实验室A的检测方法,外部集中换成实验室B;开发集中定义的“高表达”阈值,在外部数据里并不适用。
所以,验证前必须核对:
- 变量名称是否一致。
- 单位是否一致。
- 编码方式是否一致。
- 缺失值规则是否一致。
- 结局定义是否一致。
变量不可比,模型就不可比。
3.2 缺失数据不能随意删除
外部数据集常见缺失值更多。直接删除缺失样本,会带来选择偏倚。
更稳妥的做法包括:
- 先分析缺失机制。
- 评估是否为随机缺失。
- 采用多重插补或合理的缺失处理策略。
- 对关键变量缺失较多的数据集,谨慎进入验证。
对于临床研究来说,缺失处理不当,会比模型本身更严重地损害结果可信度。
3.3 先看区分度,再看校准度
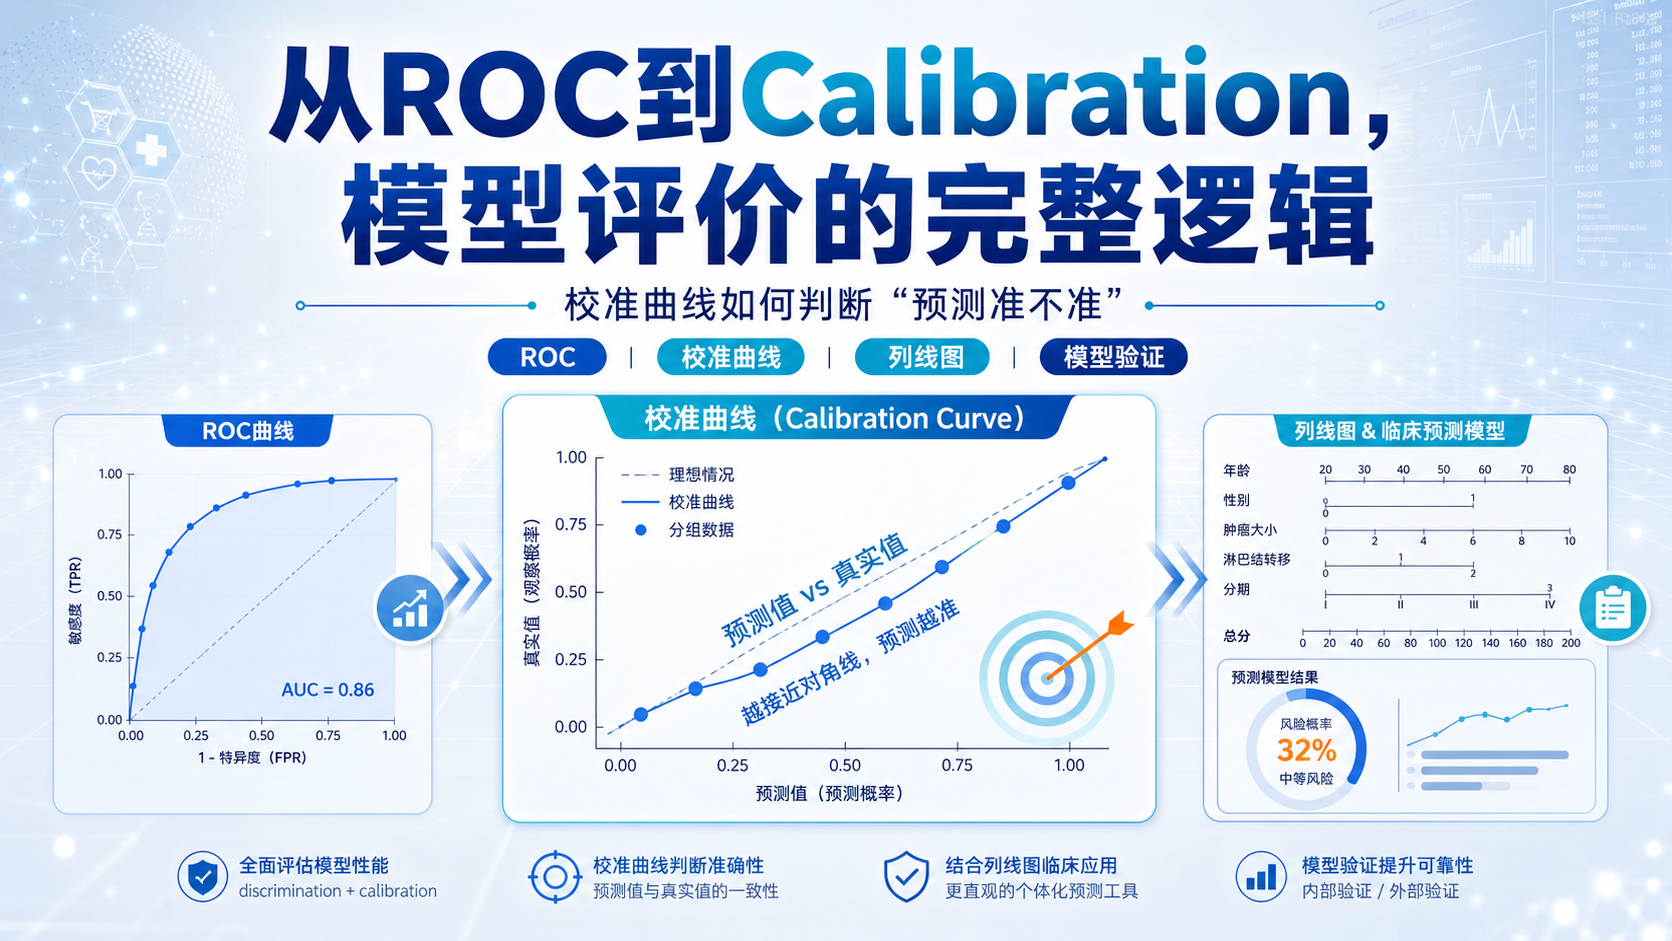
外部验证时,不能只盯着AUC。模型是否能区分高低风险,只是第一步。还要看它预测的概率是否接近真实发生率。
常规评估至少包括:
- 区分度 。如AUC、C-index。
- 校准度 。如校准曲线、Hosmer-Lemeshow检验。
- 临床净获益 。如决策曲线分析DCA。
AUC高,不代表校准好。 很多模型区分度尚可,但预测概率明显偏高或偏低,临床上仍不可直接使用。
3.4 不同验证指标回答不同问题
可以这样理解:
- AUC/C-index 回答“能不能分开”。
- 校准曲线 回答“准不准”。
- DCA 回答“值不值得用”。
这三者缺一不可。
如果模型在外部验证中AUC下降不大,但校准严重偏离对角线,就提示需要再校准。
如果AUC和校准都不错,但DCA净获益不明显,那模型的临床实用性仍需谨慎判断。
4. 外部验证的实战策略
4.1 优先做时间外部验证
如果资源有限,建议先做时间外部验证。也就是用较早时期建模,用较晚时期验证。
这种方式的优点是:
- 数据相对容易获取。
- 变量体系通常一致。
- 能初步检验模型的时间稳定性。
对于单中心科研团队来说,这是最容易启动的外部验证路径。
4.2 多中心验证更有说服力
如果目标是发表高质量临床预测模型,多中心外部验证更有价值。
它可以帮助研究者识别模型对不同地区、不同检测流程、不同病例结构的适应性。
尤其在肿瘤、心血管和神经退行性疾病研究中,多中心数据往往更能体现模型的真实泛化能力。
4.3 发现性能下降时,先考虑再校准
很多人看到外部AUC下降,就急着否定模型。其实未必。
如果模型排序能力还在,但预测概率不准,可以先做再校准。常见方式包括:
- 调整截距项。
- 调整回归系数。
- 重新拟合校准曲线。
- 必要时采用分层修正。
外部验证的目的,不只是判断对错,也是在判断模型是否需要修正。
4.4 报告时要透明
外部验证结果写作时,要完整报告以下内容:
- 外部数据来源与纳入标准。
- 与开发集的异同。
- 缺失值处理方法。
- 验证指标及其置信区间。
- 模型是否再校准。
- 是否存在亚组差异。
透明报告能显著提升文章可信度,也更符合TRIPOD等报告规范的精神。
5. 常见误区与纠偏
5.1 把验证集当成外部验证
很多文章把训练集拆成验证集后,直接称为外部验证。严格来说,这通常只是内部验证。
真正的外部验证必须来自独立数据来源。
5.2 只报AUC,不报校准和DCA
这是非常常见的问题。
如果只展示AUC,读者无法判断模型预测概率是否靠谱,也无法判断临床是否值得使用。
完整的外部验证,至少应包含区分度、校准度和临床效用。
5.3 外部样本太小
外部样本过少,会导致置信区间很宽,结果不稳定。
验证不是“有样本就行”,而是要有足够的事件数支撑结论。事件太少,AUC和校准曲线都可能失真。
5.4 忽视人群异质性
外部数据和开发数据差异过大时,模型失效并不奇怪。
如果疾病分期、治疗方式、检测平台差异显著,就需要先评估可比性,再决定是否适合直接验证。
验证前的同质性检查,是结果可信的前提。
6. 从方法到发表:外部验证如何提升文章质量
6.1 让模型更像“临床工具”
一个有外部验证的模型,比只有内部验证的模型更接近临床应用。
尤其当模型还能进一步做列线图、网页计算器或评分表时,文章的可用性会明显增强。
这类设计更容易被临床读者接受,也更符合转化研究逻辑。
6.2 配合机制分析,提高说服力
如果模型来自生信研究,建议在外部验证之外,再补充机制证据,例如:
- 差异表达分析。
- 富集分析。
- PPI网络。
- 免疫浸润分析。
- 药物预测分析。
这样可以让模型从“统计上成立”进一步走向“生物学上合理”。
6.3 解螺旋可帮助把验证链条补完整
如果你正在做临床预测模型,最容易卡住的往往不是建模本身,而是外部验证数据怎么找、怎么处理、怎么写得规范 。
解螺旋可以在数据整合、图表呈现、验证流程梳理和文章结构优化上提供支持,帮助你把“模型能跑”升级为“模型能发表、能说服、能落地”。
总结Conclusion
模型外部验证是临床预测模型从“可发表”走向“可应用”的关键门槛。 它不仅检验区分度,更检验校准度和临床净获益。对医学生、医生和科研人员来说,真正高质量的模型,必须经得起独立人群的考验。
如果你正在准备临床预测模型文章,建议从开发阶段就同步规划外部验证。需要进一步打磨研究设计、结果呈现和文章表达时,欢迎关注解螺旋,让你的模型更稳、更准,也更容易落地。
- 引言Introduction
- 1. 为什么外部验证是临床预测模型的关键一步
- 2. 外部验证前,先把模型开发阶段做扎实
- 3. 外部验证的核心方法学要点
- 4. 外部验证的实战策略
- 5. 常见误区与纠偏
- 6. 从方法到发表:外部验证如何提升文章质量
- 总结Conclusion