9
 分享
引言Introduction
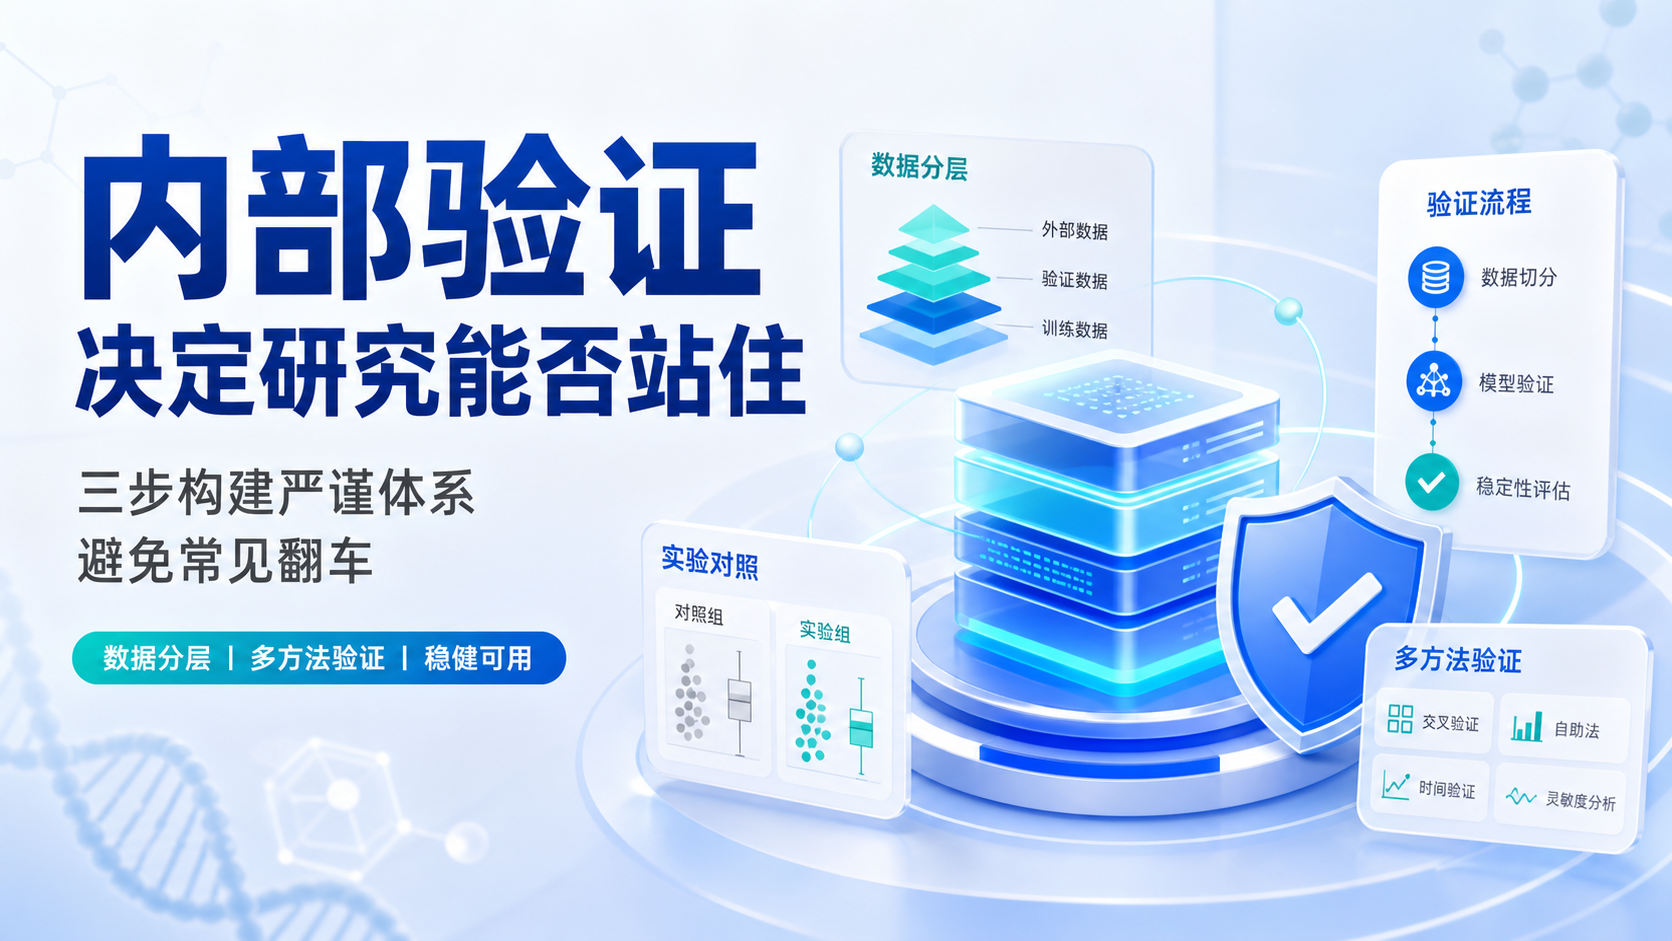
很多研究不是败在假设,而是败在验证。模型做出来了,结果看似漂亮,却经不起重复、分层和外部审视,最后只能停在“故事完整,证据不足”。内部验证缺失,往往是研究翻车的第一道裂缝。

1. 为什么内部验证决定研究能否站住
1.1 内部验证不是形式,而是研究可信度的底座
在基础和临床研究中,内部验证的核心任务,是确认你的结论不是偶然结果,也不是单一模型、单一批次、单一数据集造成的偏差。没有内部验证,模型只能说明“这一次看起来成立”,不能说明“这个结论稳定成立”。
对医学生、医生和科研人员来说,这一点尤其重要。因为研究输出最终要面对的是同行评审、课题答辩和后续转化。若模型只在训练集里表现很好,到了验证集就明显下滑,说明研究结论的泛化能力不足。若只做了一个细胞系或一组病例,也很难支撑更高层级的推断。
1.2 翻车常见于三类问题
内部验证缺失,常见问题大致有三类。
-
样本切分不规范。
训练集、验证集、测试集混用,或者同一来源样本重复进入不同集合,导致结果虚高。 -
只看单一指标。
只报AUC,不看校准曲线、决策曲线、敏感度、特异度和置信区间,模型“看上去很强”,但临床意义不清楚。 -
缺少重复与稳健性检验。
没有交叉验证,没有Bootstrap,没有不同批次、不同条件下的重复验证,研究结果容易被批次效应或偶然波动击穿。
一句话总结,内部验证不是附加项,而是决定结论能否成立的必要条件。
2. 三步构建严谨的内部验证体系
2.1 第一步,先把数据分层和切分做对
内部验证的第一步,不是急着建模,而是先把数据结构理清。对于回顾性数据,建议优先明确来源、时间段、纳入排除标准和缺失值处理方式。对实验研究,则要先明确批次、重复、对照和随机化原则。
可执行的基本要求包括:
- 训练集与验证集严格隔离。
- 同一患者、同一动物、同一实验批次不能跨集合重复出现。
- 缺失值处理要在分组前完成,并保留原始记录。
- 若样本量有限,优先使用交叉验证而不是简单一次切分。
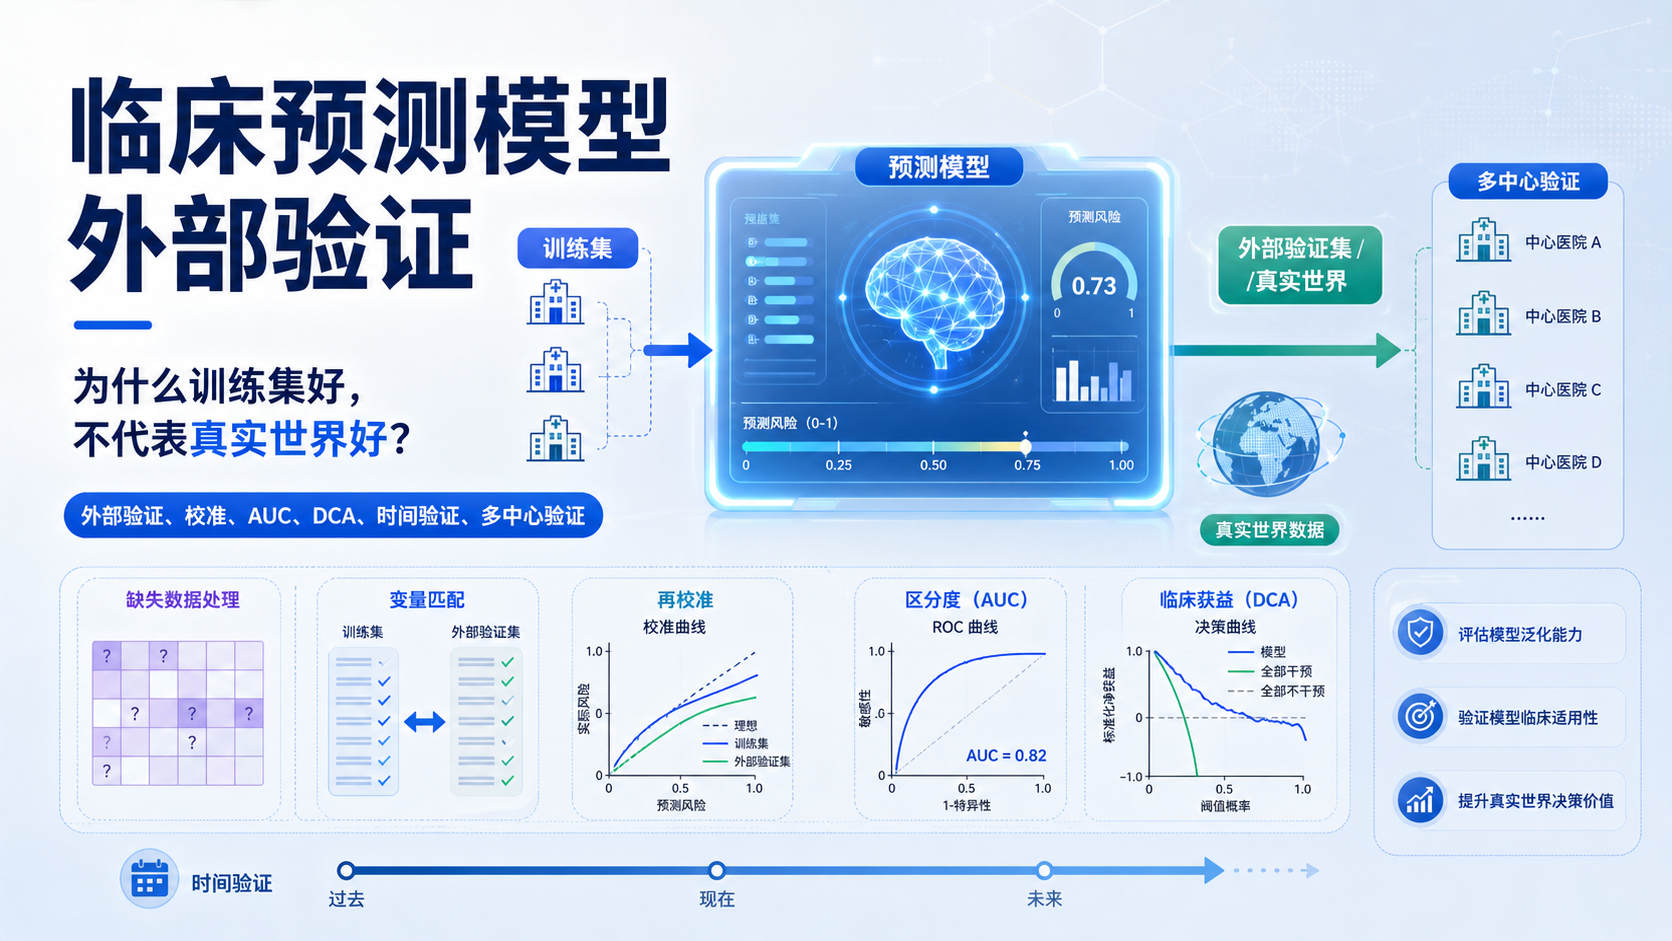
如果是临床预测模型,常见做法是采用7:3或8:2切分,但前提是样本量足够。若样本总量偏小,单次切分会让结果波动较大。此时,K折交叉验证更适合做内部稳定性评估。
2.2 第二步,用多方法验证稳定性
内部验证不能只靠一次“复现成功”。更稳妥的做法,是同时用不同方法观察模型是否稳定。
常用方法包括:
-
K折交叉验证。
适合评估模型在不同子集上的稳定性,能减少单次随机切分带来的偏差。 -
Bootstrap重抽样。
适合估计模型性能的置信区间,尤其适用于样本量不大的研究。 -
重复实验或重复建模。
适合基础研究和机制研究,检查关键结论是否在不同批次、不同重复中一致。 -
亚组分析。
适合临床研究,观察模型在不同性别、年龄、病程或分层人群中的表现是否一致。
如果一个模型只在总体上表现良好,但在关键亚组中性能明显下降,说明内部稳定性仍然不足。
2.3 第三步,把“好看”变成“可用”
很多研究只追求统计学显著,却忽略临床或生物学可解释性。真正严谨的内部验证,不只是证明模型“能区分”,还要证明它“能用”。
建议至少补齐以下四类指标:
-
区分度。
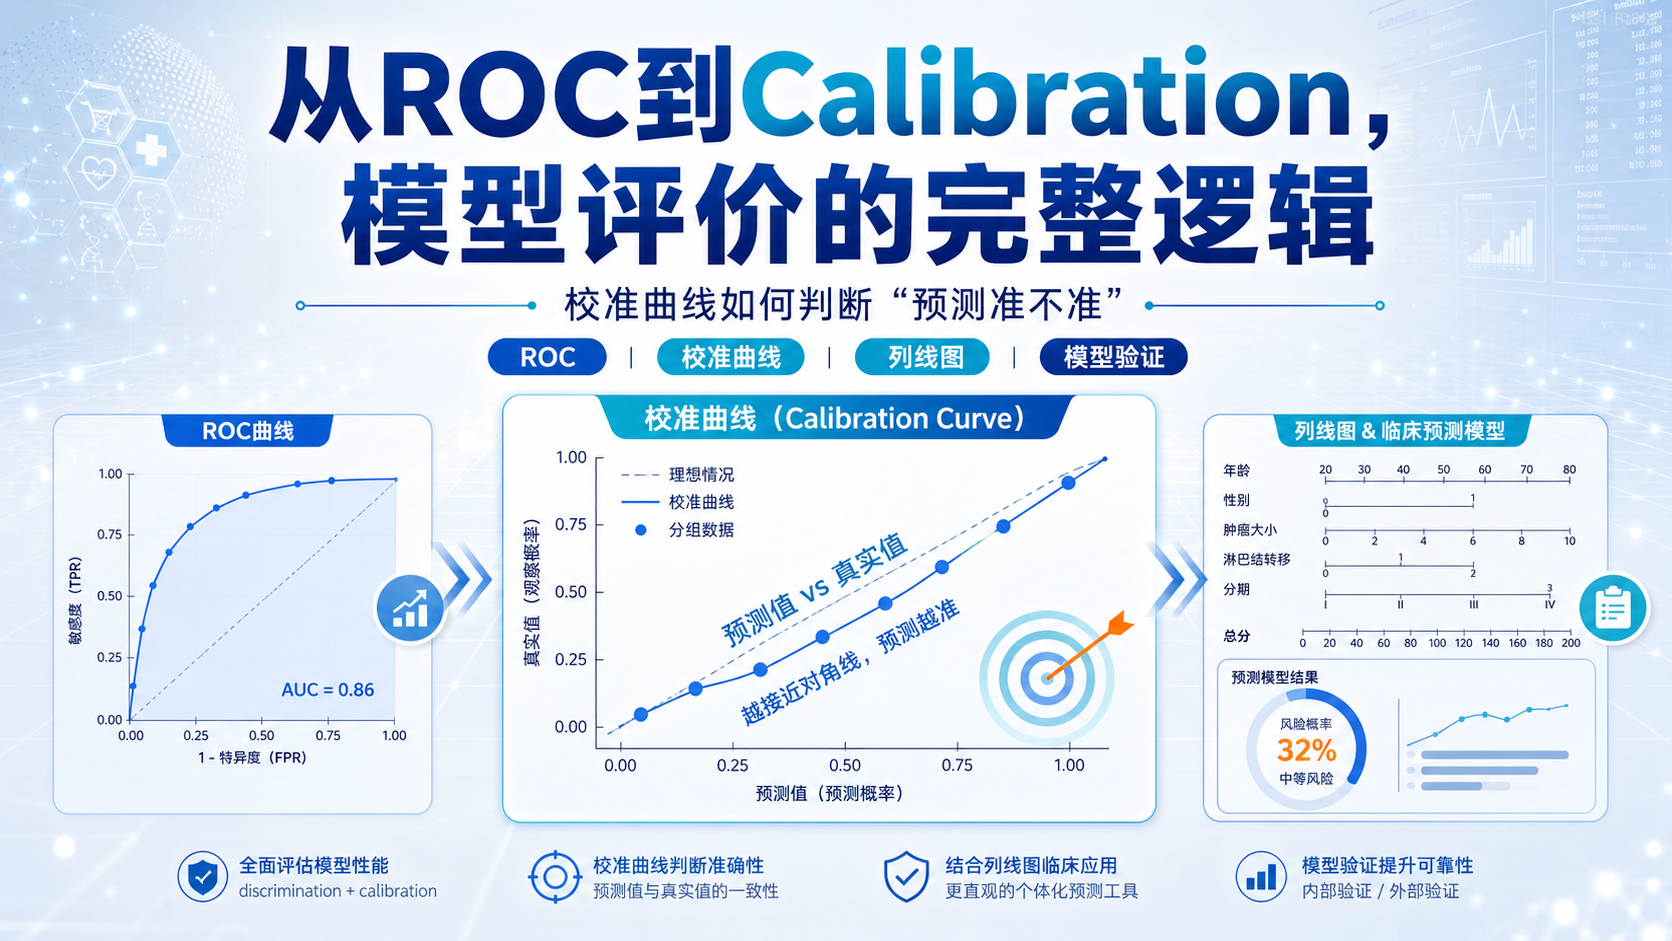
如AUC、C-index、准确率、灵敏度、特异度。 -
校准度。
预测概率是否与真实发生率一致。校准曲线比单纯准确率更能说明模型是否可靠。 -
临床净获益。
决策曲线分析可以帮助判断模型是否真的有实际使用价值。 -
稳健性。
看结果是否受不同阈值、不同批次、不同参数设置影响。
一个能发表的模型,不等于一个能应用的模型。内部验证的价值,就在于把“可发表”推进到“可使用”。
3. 不同研究类型,内部验证重点不同
3.1 预测模型更重视统计稳健性
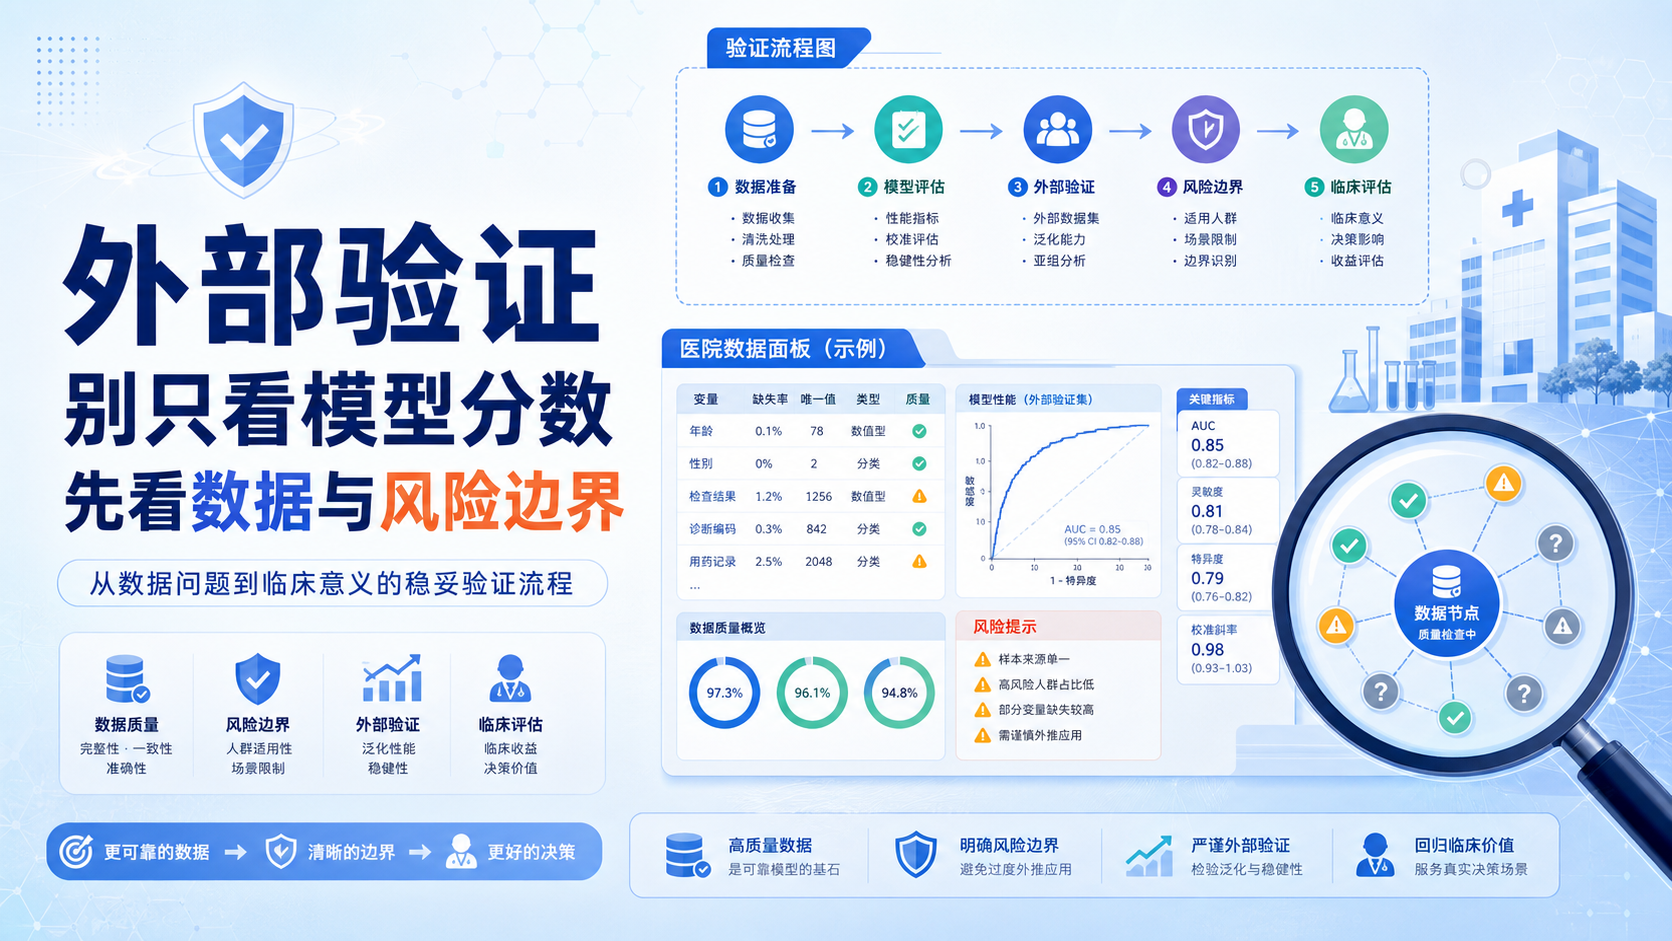
预测模型最怕过拟合。变量太多、样本太少、选择过程太随意,都会导致模型在训练集中很强,在外部场景中迅速失效。对于这类研究,内部验证应重点关注:
- 变量筛选是否合理;
- 是否存在信息泄漏;
- 是否做了过拟合控制;
- 是否报告了置信区间;
- 是否能在重复抽样中保持稳定。
如果研究目标是构建列线图、风险评分或机器学习模型,内部验证至少要说明模型在多次重抽样或交叉验证中的表现是否一致。
3.2 机制研究更重视重复性和对照完整性
基础研究里,内部验证不一定体现为“验证集”,但一定体现为重复性和对照体系。比如:
- 同一结果是否在不同细胞系中复现;
- 干预是否有阴性对照和阳性对照;
- 效应是否能被rescue实验逆转;
- 关键结论是否在体外、体内两个层面保持一致。
对于机制研究,内部验证的本质是证明因果链条完整,而不是只得到一个单点阳性结果。
3.3 临床研究更重视流程一致性
临床研究中的内部验证,往往体现在数据采集、终点定义和随访一致性上。最常见的问题不是没有数据,而是数据不统一。比如不同医生记录标准不一致,检查时间点不一致,终点判断标准不一致,都会导致内部偏倚。
因此,临床研究必须提前定义:
- 主要终点和次要终点;
- 统一的纳排标准;
- 固定的随访窗口;
- 预设的统计分析方案。
没有流程标准化,就没有真正意义上的内部验证。
4. 常见错误与可直接落地的修正方案
4.1 三个高频错误
很多研究者在内部验证上容易犯三个错误。
- 先看结果,再倒推分组。
- 只做一次验证,不看波动范围。
- 把“模型有效”误写成“模型稳定”。
这些问题会直接削弱文章可信度,也容易在审稿环节被质疑。
4.2 三个实用修正动作
你可以直接按以下思路修正。
-
先注册分析流程或固定分析脚本。
至少在内部版本里锁定变量筛选和建模顺序,避免事后选择偏倚。 -
补齐重复验证。
采用交叉验证、Bootstrap或重复实验,把性能波动写清楚。 -
补上解释性证据。
用校准曲线、决策曲线、亚组分析或机制回补实验,让结论更完整。
只要研究逻辑清楚,内部验证就不是负担,而是提升文章层级的关键一步。
5. 让验证体系更高效,关键在于工具链
对于很多科研人员来说,难点不在理念,而在执行。数据整理、分组、统计、作图、结果描述,任何一步出错,都可能让内部验证失真。尤其在时间紧、任务重的情况下,验证流程最容易被压缩。
这时,借助成熟的科研工具和规范化流程,会明显提高效率。比如使用解螺旋的研究设计与写作支持服务,可以帮助你更快完成数据结构梳理、验证方案搭建、统计图表输出和论文框架整理。把内部验证前置、标准化、可追溯,才能真正减少研究翻车风险。
总结Conclusion
内部验证不是论文里的“补充步骤”,而是研究能否成立的核心防线。对于预测模型,它决定泛化能力。对于机制研究,它决定因果链条是否完整。对于临床研究,它决定数据是否可信。三步构建严谨验证体系,分别是数据切分正确、多方法重复验证、性能与可用性并重。
如果你正在做模型、机制或临床研究,不要等到审稿人提醒才补验证。现在就把内部验证做实。若你希望更高效地搭建研究框架、优化验证流程并提升文章质量,可以进一步了解解螺旋 ,让研究少走弯路。
- 引言Introduction
- 1. 为什么内部验证决定研究能否站住
- 2. 三步构建严谨的内部验证体系
- 3. 不同研究类型,内部验证重点不同
- 4. 常见错误与可直接落地的修正方案
- 5. 让验证体系更高效,关键在于工具链
- 总结Conclusion