9
 分享
引言Introduction
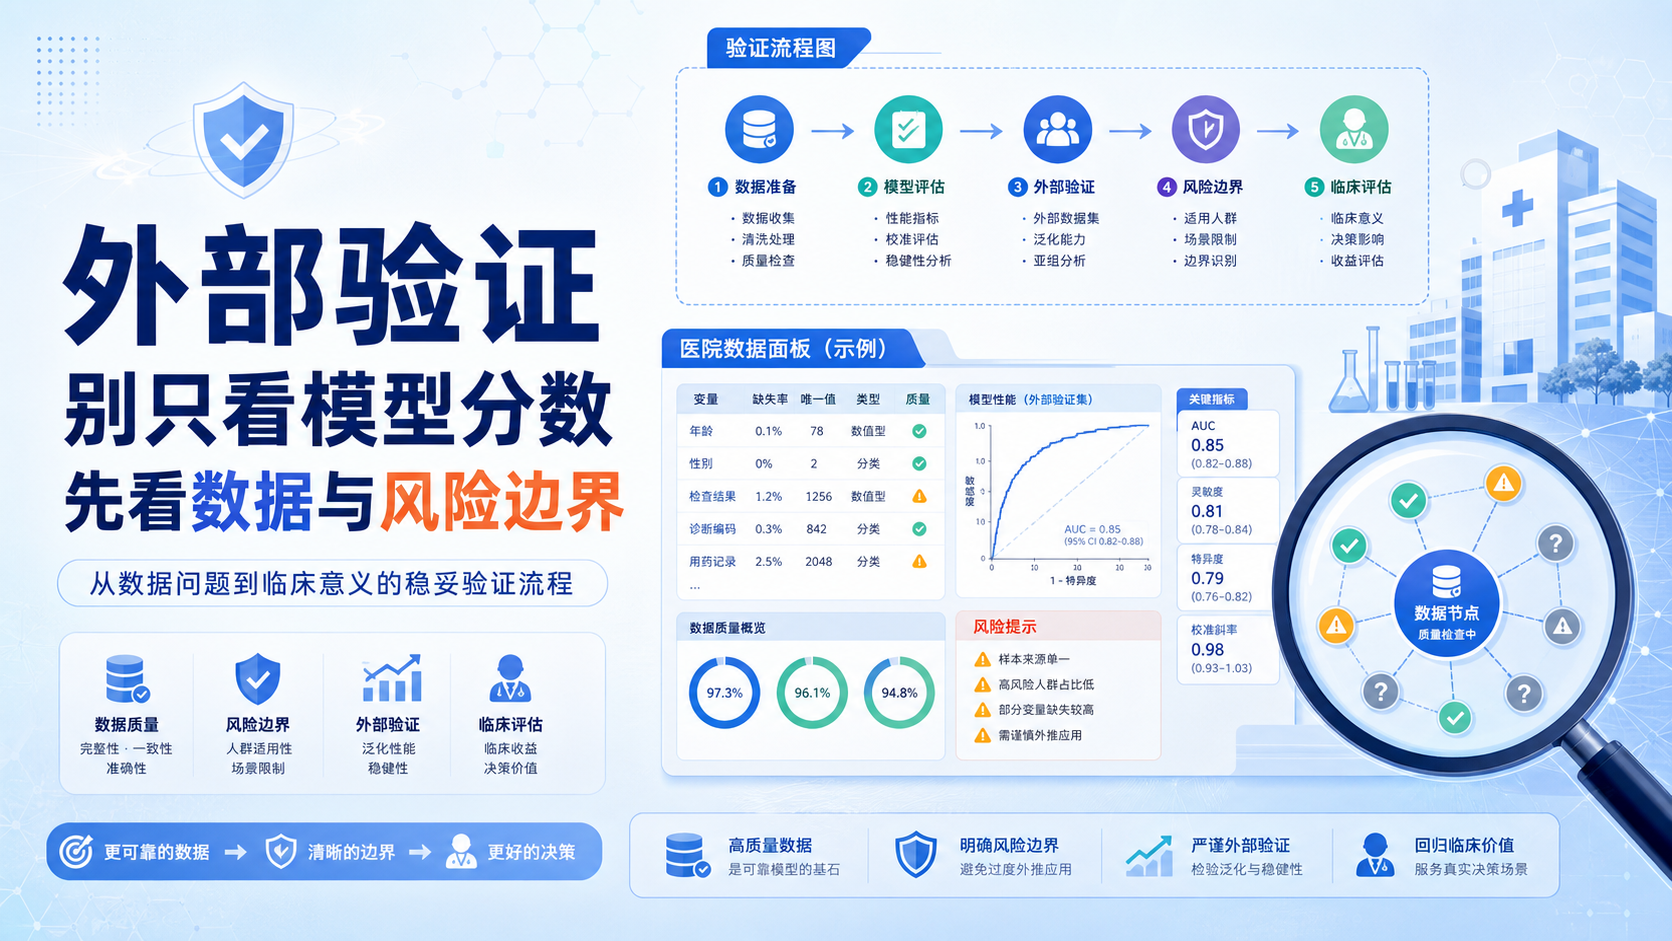
外部验证做得不对,模型看起来“很强”,实际一到新中心就失效。对医学生、医生和科研人员来说,问题往往不是算法本身,而是样本来源、数据结构和安全边界没有理清。真正决定外部验证价值的,是你验证的是否是“真实可迁移”的能力。 
1. 外部验证到底在验证什么
1.1 不是简单再跑一遍模型
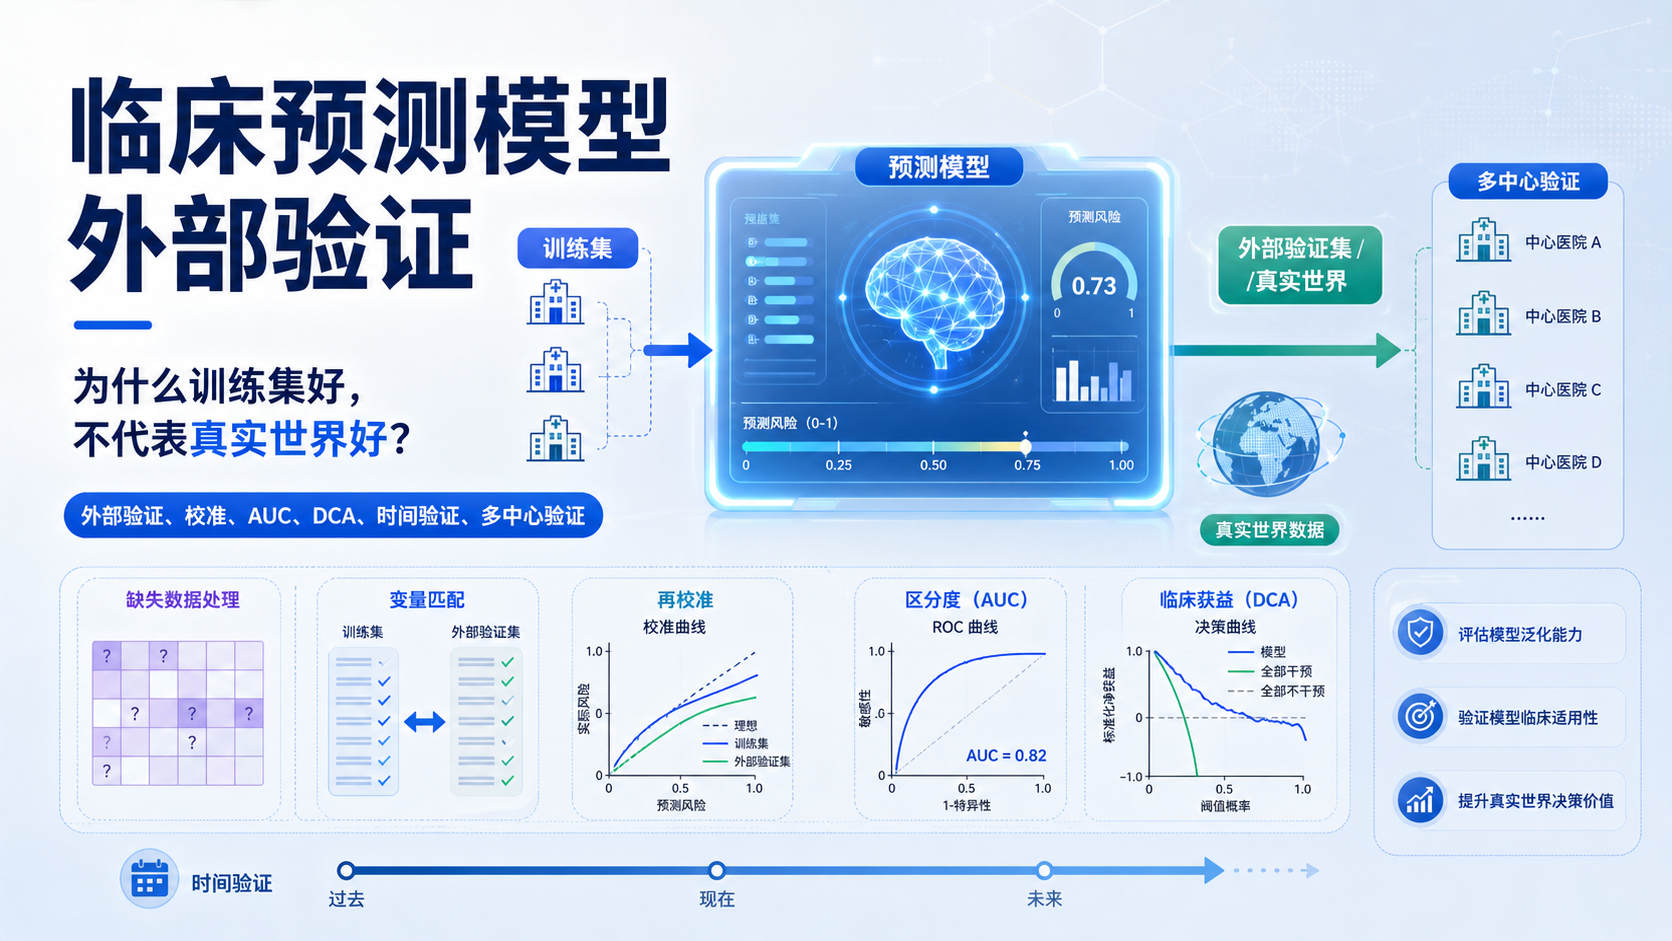
外部验证的核心,不是把训练好的模型换个数据集再算一次AUC。它真正要回答的是,模型在不同人群、不同时间、不同中心、不同设备 下,是否还能保持稳定表现。
如果只是同院不同时间段的数据,这更接近时间验证。如果是同院不同科室,属于院内异源验证。只有在独立来源、独立采集流程、独立样本结构下,模型仍能保持可接受表现,才更接近严格意义上的外部验证。
外部验证的价值,在于检验模型的可迁移性和真实临床适用性。 这也是论文能否被审稿人认可的关键之一。
1.2 外部验证常见指标要看全
很多人只盯着AUC。实际上,外部验证至少要同时关注以下几类结果:
- 区分度 ,如AUC、C-index。
- 校准度 ,如校准曲线、Brier score。
- 临床净获益 ,如决策曲线分析。
- 阈值稳定性 ,如不同cut-off下的敏感度、特异度、PPV、NPV。
如果一个模型在训练集AUC很高,但外部验证时校准明显偏移,就说明它可能“会区分,但不会预测得准”。这在临床上同样是问题。
2. 外部验证最容易踩的几个坑
2.1 误区一,认为“数据越像越好”
很多研究者会下意识选择与训练集最相似的数据做外部验证,结果看起来非常漂亮。问题是,这种验证往往只是重复确认模型在相近环境下能工作,并不能说明它真的具备泛化能力。
更有价值的做法是,尽量覆盖真实世界差异,例如:
- 不同医院等级。
- 不同地区。
- 不同检查设备。
- 不同入排标准。
- 不同疾病谱或治疗策略。
验证集越“有挑战性”,结果越能说明模型的真实边界。 当然,前提是数据质量足够高,变量定义足够一致。
2.2 误区二,把变量不一致当成“正常差异”
外部验证失败,很多时候不是模型差,而是变量定义出了问题。常见情况包括:
- 单位不一致,身高用厘米和米混用。
- 编码不一致,1和2在不同数据库里代表不同含义。
- 时间点不一致,基线值和术后值混在一起。
- 检测方法不同,实验室指标不可直接比较。
- 缺失值处理方式不同,导致样本分布偏移。
只要变量口径不统一,外部验证结果就不具备可解释性。 这类问题在多中心回顾性研究中特别常见。
2.3 误区三,只看统计显著,不看临床意义
有些研究外部验证后,虽然AUC下降了,但仍有统计学意义,于是就直接写“模型具有良好泛化能力”。这并不严谨。
外部验证必须问三个问题:
- 性能下降是否在可接受范围内。
- 下降原因是否可解释。
- 该模型是否仍能支持临床决策。
例如,一个预测模型在训练集AUC为0.90,外部验证为0.78,未必不能用。但如果校准曲线明显偏离、决策曲线净获益很低,就不能简单下结论说“效果良好”。
3. 数据问题比模型问题更常见
3.1 先排逻辑错误,再谈外部验证
在进入外部验证前,数据清洗必须先完成。逻辑错误如果没处理,模型输出再漂亮也没有意义。常见逻辑错误包括:
- 性别变量出现不合理编码,如3、0.1、2.5。
- 年龄出现负数或200多岁。
- 肿瘤分级超出预设范围。
- 吸烟状态为“否”,但每日吸烟量却大于0。
- 收缩压小于舒张压,提示录入颠倒。
- 身高用米录入,却被当成厘米处理。
这些不是“小瑕疵”,而是会直接影响外部验证结论的数据错误。 在真实项目里,先做规则校验,再做异常值筛查,最后再进入建模与验证,是更稳妥的流程。
3.2 异常值不等于脏数据
异常值要分层判断。并不是所有极端值都应该删除。比如某些罕见高龄患者,或者特别高的实验室指标,可能是真实存在的临床事件。
处理异常值时建议按以下顺序:
- 核对原始病历。
- 检查录入单位和时间点。
- 结合临床背景判断是否合理。
- 必要时做敏感性分析。
删除数据前,先确认它是错误,而不是罕见但真实的临床信息。 这一步能显著提高外部验证的可信度。
4. 外部验证中的数据安全边界
4.1 先理解风险,再谈工具
很多科研团队担心把数据上传到云端平台后,研究思路、患者信息或未发表结果被泄露。这个担心并不多余,但要客观看待风险边界。
从实际使用场景看,数据安全主要取决于三层:
- 传输安全 ,数据在上传和下载过程中是否加密。
- 存储安全 ,服务器是否有权限控制和访问审计。
- 使用安全 ,谁能看到原始数据,谁能导出结果。
绝对安全并不存在。 只要数据联网、共享或托管,就存在被访问、被误用或被攻击的可能。风险大小取决于平台机制、权限设置和团队规范。
4.2 研究中更现实的安全策略
对于临床研究和模型验证,更可执行的安全策略包括:
- 只上传脱敏后的数据。
- 不上传可直接识别患者身份的信息。
- 明确团队成员权限,最小化访问范围。
- 采用本地化分析或院内服务器处理敏感数据。
- 记录数据调用和导出日志。
- 对外部协作设立数据使用协议。
如果条件允许,本地部署或院内私有化环境通常更适合处理高敏感度数据。 这样可以把原始信息留在机构内部,把算法或分析流程放到受控环境中执行,降低暴露风险。
4.3 AI辅助科研也要守住边界
现在不少团队会用AI工具辅助整理变量、生成统计思路或检查逻辑错误。这个方向可以提升效率,但前提是要遵循学术规范。
建议记住两条底线:
- 使用AI时要诚实说明。
- 最终作者要对结果负责。
AI可以辅助分析,但不能替代研究者对数据真实性、隐私保护和结论可靠性的判断。 这是外部验证和临床研究中都必须坚持的原则。
5. 做好外部验证的实操建议
5.1 一套更稳妥的验证流程
如果你正在准备外部验证,可以按下面的顺序推进:
- 明确训练集和验证集的来源差异。
- 统一变量定义、单位和时间点。
- 完成数据清洗和逻辑校验。
- 识别并处理异常值。
- 评估区分度、校准度和临床净获益。
- 做敏感性分析,验证结论稳定性。
- 记录所有数据处理步骤,保证可追溯。
这套流程的意义在于,让外部验证从“跑结果”变成“证据构建” 。审稿人更看重的,往往不是单一指标,而是整个流程是否严谨。
5.2 如果结果不理想,先别急着否定模型
外部验证表现下降,并不一定意味着模型失败。它可能提示:
- 样本人群不同。
- 变量分布偏移。
- 检测平台不同。
- 结局事件率变化。
- 训练集过拟合。
这时更合理的做法,是回到数据层面重新定位问题,而不是直接放弃。很多时候,通过重新校准、调整阈值、补充关键变量或做分层分析,模型仍有改进空间。
外部验证的意义,不只是证明模型“能用”,更是帮你找到模型的边界和改进方向。
总结Conclusion
外部验证不是形式步骤,而是检验模型真实价值的关键环节。它要回答的,不只是“模型好不好”,更是“模型能不能跨场景使用”。在这个过程中,变量口径一致、逻辑错误排查、异常值识别、校准评估和数据安全管理,缺一不可。如果你希望把外部验证做得更规范、更高效,解螺旋可以帮助你梳理研究设计、优化数据流程,并提升模型验证的可发表性。
- 引言Introduction
- 1. 外部验证到底在验证什么
- 2. 外部验证最容易踩的几个坑
- 3. 数据问题比模型问题更常见
- 4. 外部验证中的数据安全边界
- 5. 做好外部验证的实操建议
- 总结Conclusion