16
 分享
引言Introduction
诊断试验看似只是在“测一次、判一次”,但误差一旦进入设计、入组、金标准和评估环节,结论就可能明显偏离真实情况。对医学生、医生和科研人员来说,真正难点不是会算敏感度和特异度,而是识别并控制诊断试验误差。 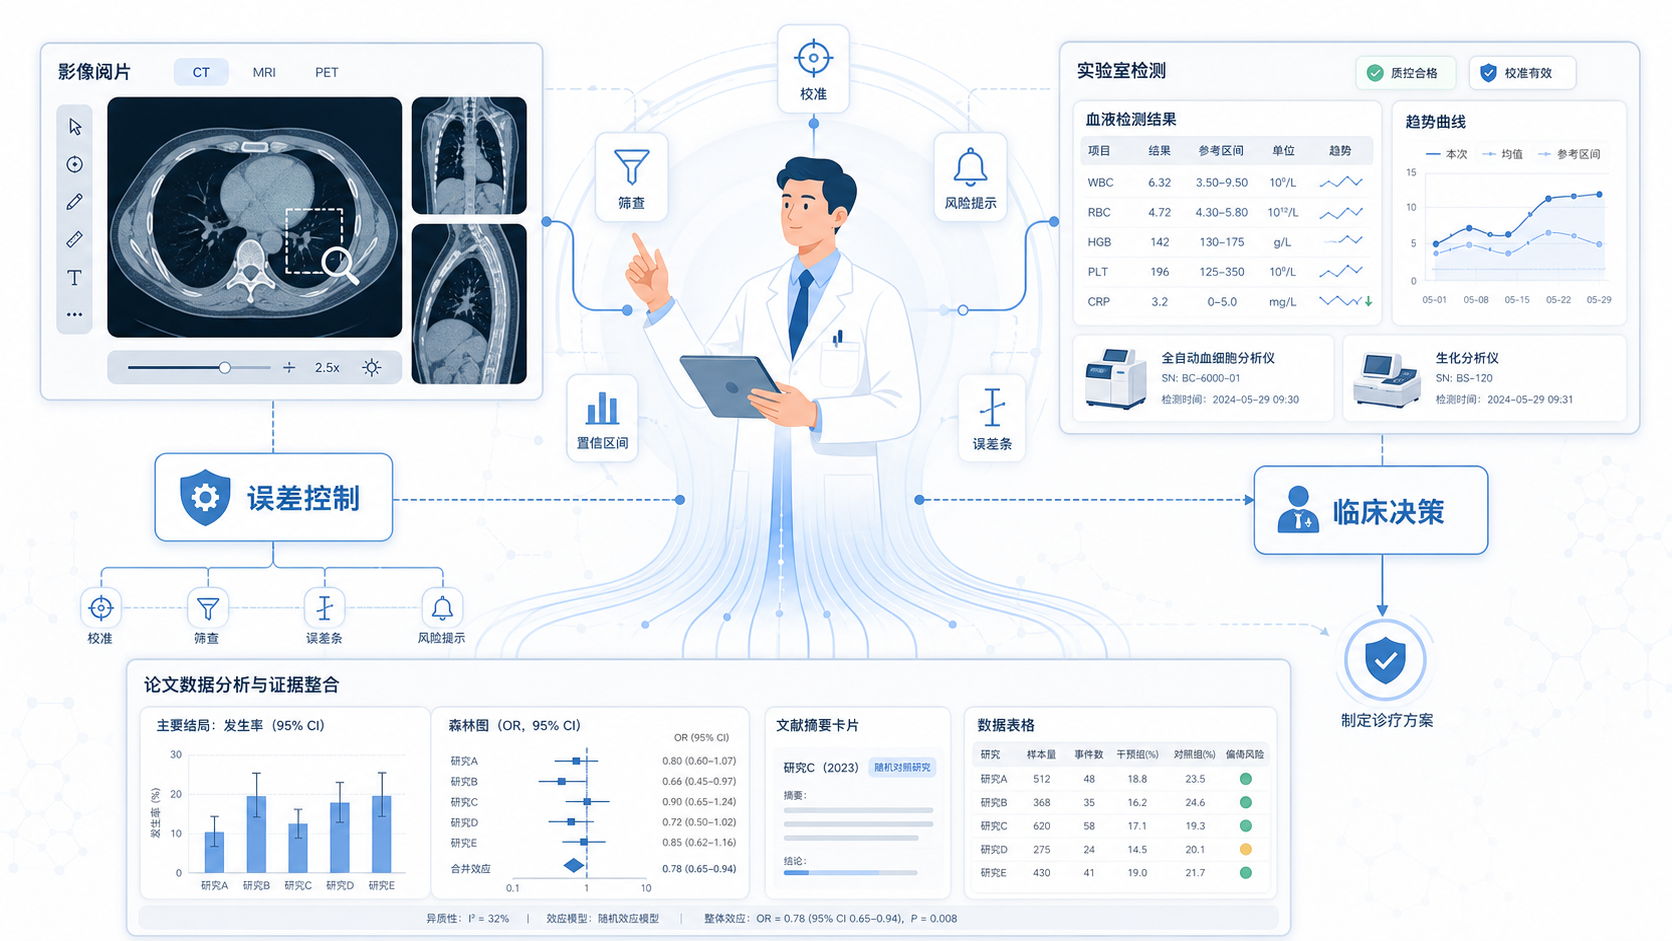
1. 诊断试验误差为什么会直接影响临床决策
1.1 误差不是统计细节,而是结论偏差的来源
诊断试验的目标,是让检测结果尽量接近真实疾病状态。只要设计或执行中出现偏差,灵敏度、特异度、AUC 都可能被高估或低估。这不是单纯的“数据不好看”,而是会直接影响疾病是否被漏诊、误诊,以及后续治疗是否过度或不足。
临床上最常见的问题,是研究结果“看起来很好”,但应用到真实门诊后性能明显下降。原因通常不是检验本身失效,而是研究过程中混入了系统性误差。典型情况包括病例选择不当、金标准不可靠、结果判读不盲法等。
1.2 诊断准确性研究最怕“设计阶段”出错
诊断试验与治疗研究不同。治疗研究更关注随机化和结局,而诊断研究更依赖样本构成、参照标准和测量流程。一旦研究设计本身有偏移,后续再复杂的统计分析也难以完全修正。
上游课程中提到,病例对照设计尤其容易高估诊断效能,部分研究甚至可高估约3倍。也就是说,看上去“非常优秀”的试验,可能只是设计造成的假象。对于准备发文或做系统评价的人,这一点尤其关键。
2. 诊断试验误差的主要来源
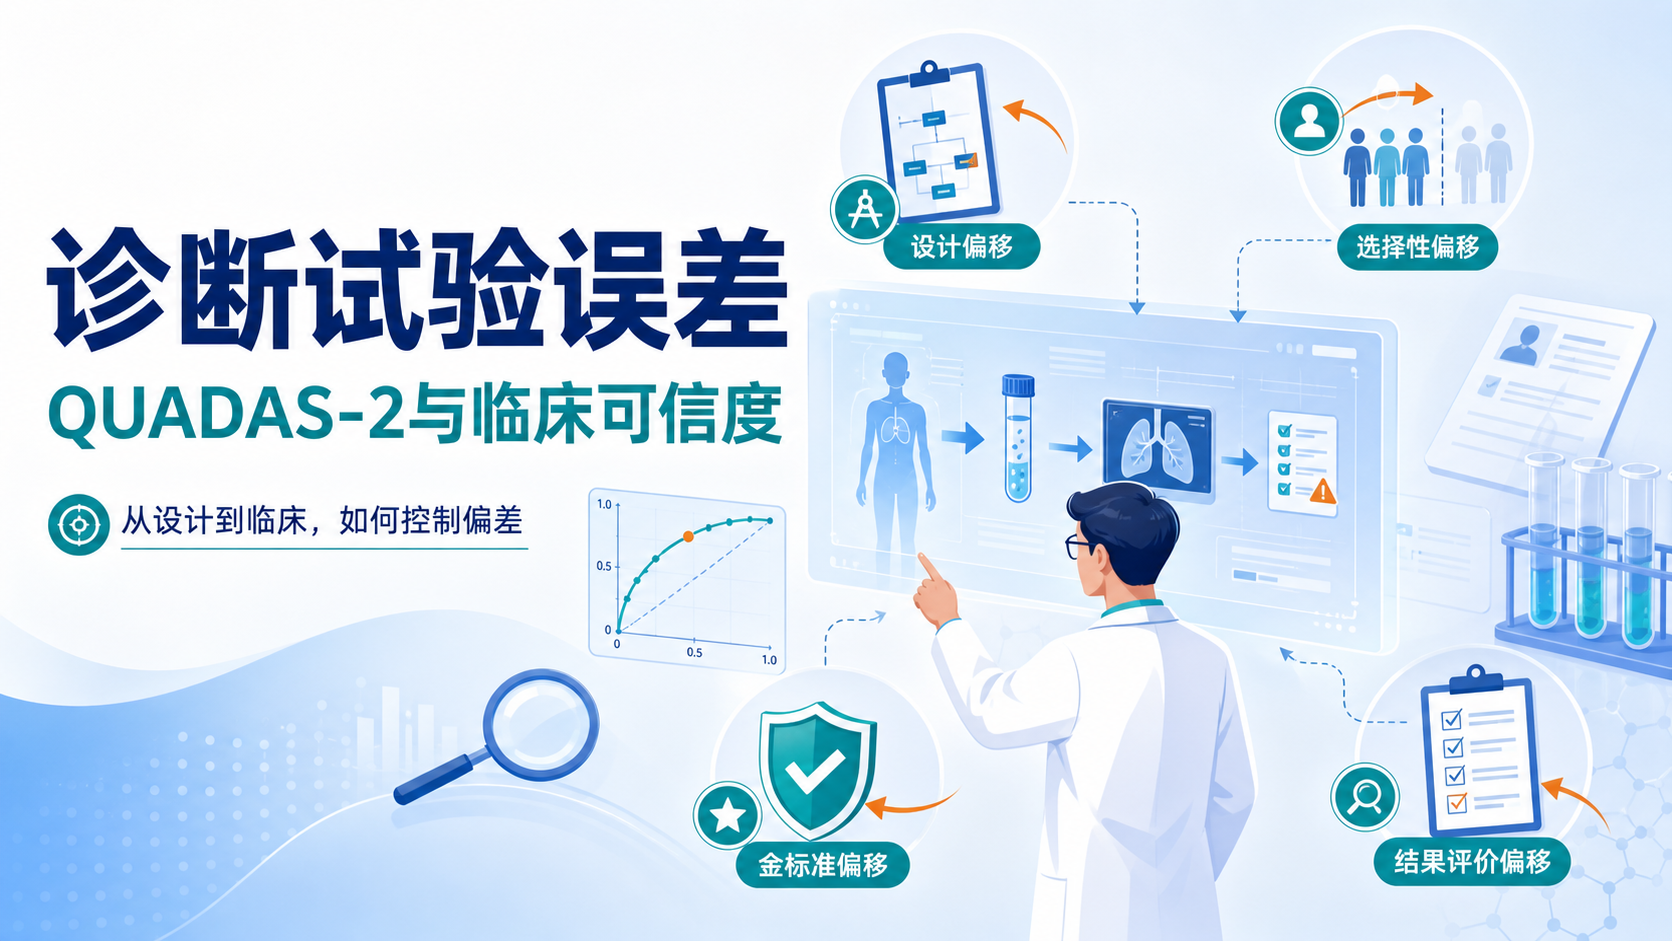
2.1 设计偏移:病例对照设计最容易夸大效能
诊断试验常见设计包括横断面设计、病例对照设计和部分队列式筛查设计。从偏移控制角度看,前瞻性连续入组的横断面设计通常更接近真实临床。 相反,病例对照设计容易把“典型重症病例”和“健康对照”放在一起比较,导致结果过于理想化。
这种偏差的核心问题是疾病谱不真实。真实门诊中的患者,往往是轻重不一、症状不典型、合并症复杂的人群。若样本只包含典型病例,诊断试验的区分度会被人为放大。
2.2 选择性偏移:入组人群不代表真实临床
选择性偏移,也叫疾病谱偏移,是诊断试验中非常常见的问题。它指的是入组人群的疾病严重程度、病程阶段、就诊场景与真实目标人群不一致。当研究对象越“标准化”,结果往往越不真实。
例如,单门设计中如果只纳入高度疑似患者,试验更容易显示出较高价值;但如果应用到基层筛查或早期识别场景,效果可能明显下降。对于科研人员来说,必须明确目标人群是谁,不能用专科住院病例替代真实世界人群。
2.3 金标准偏移:参照标准不准,前面全白做
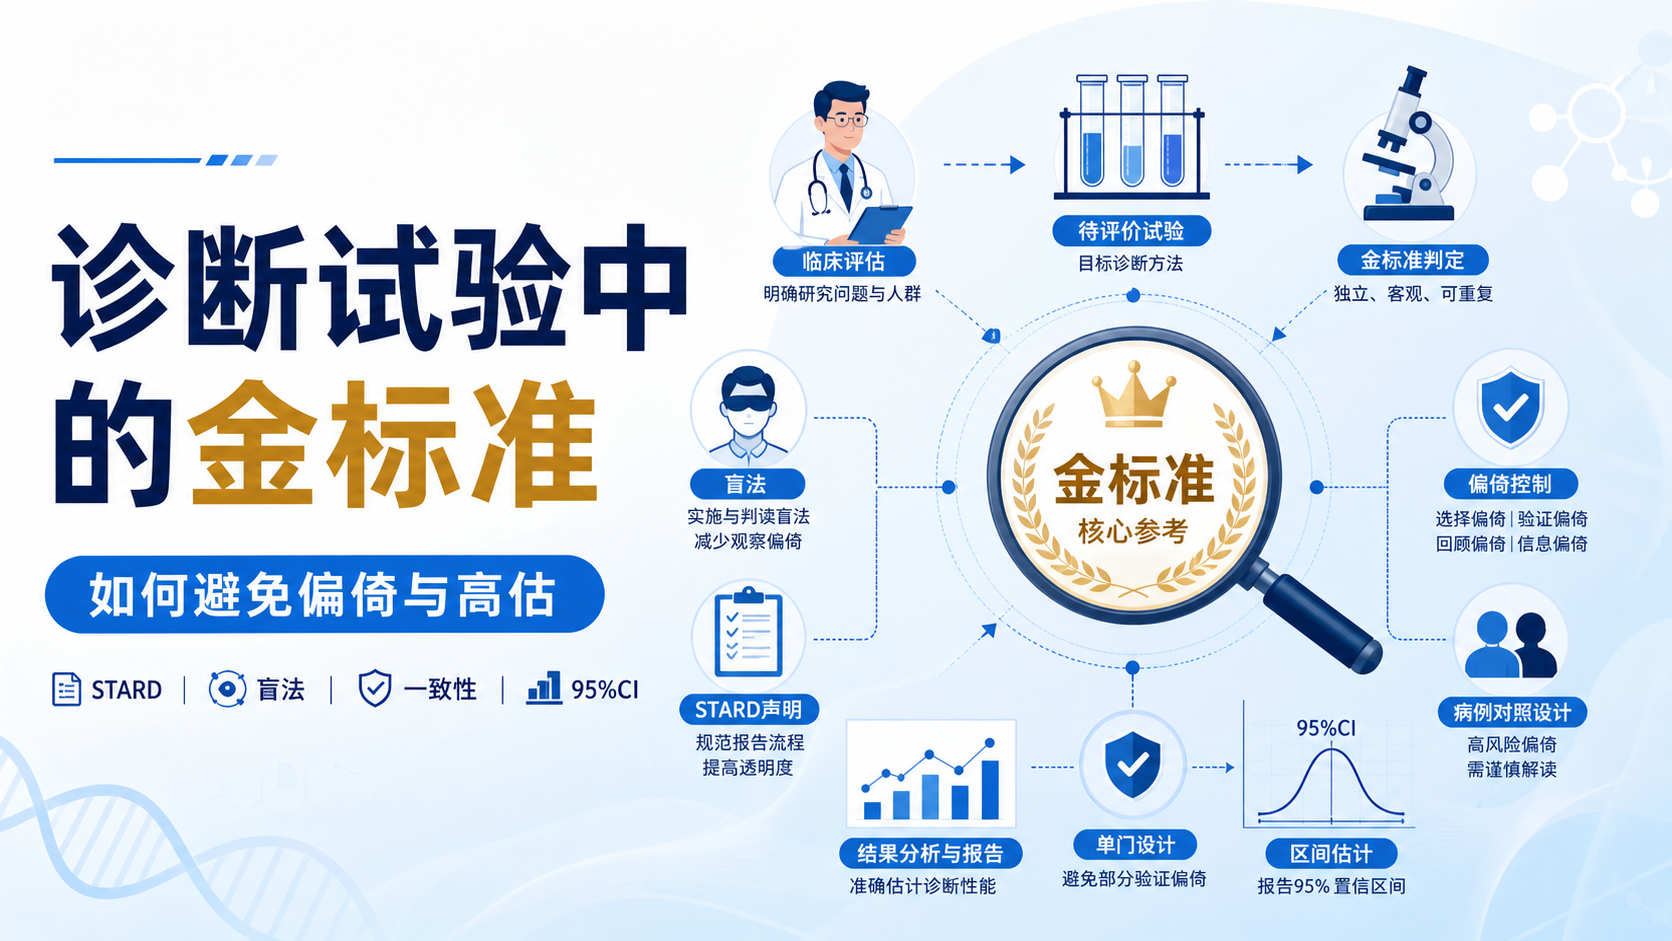
金标准是诊断试验的参照核心。若金标准本身不够准确,所有评价指标都会受到影响。金标准偏移是最危险的误差之一,因为它会让“错误的答案”被当作正确答案。
理想金标准通常应尽量接近病理组织学或明确临床诊断标准。若采用较弱的替代标准,例如仅凭影像印象、单次化验或不完整病历记录,就会引入系统误差。临床研究中,金标准不清晰,往往意味着整项试验可信度不足。
2.4 结果评价偏移:判读者知道分组,结果就可能偏
结果评价偏移,常见于未盲法评估。也就是说,评价者知道受试者属于病例组还是对照组,或知道其他检测结果。这种情况下,主观判读很容易被预期影响。
这一点在影像学、病理学和临床评分中尤为常见。若待评价试验与金标准由同一人完成,或彼此可见结果,偏移风险更高。对科研团队来说,盲法不仅是规范要求,也是保证真实性的核心措施。
3. 诊断试验误差的控制方法
3.1 优先选择前瞻性、连续入组的横断面设计
要控制诊断试验误差,第一步是让样本接近真实临床。优先采用前瞻性连续入组,而不是为了方便只挑“典型病例”。 这样可降低选择性偏移,并使研究结果更有外推价值。
如果研究目标是筛查或早诊,更要关注高危人群的真实分布。纳入标准应尽量清晰,但不能过度收窄,否则会牺牲代表性。研究设计阶段的平衡点,是“标准明确”与“人群真实”同时兼顾。
3.2 确保金标准可靠,并尽量独立完成
金标准越准确,诊断试验的真实性越高。若存在更高等级证据,应优先采用最优参照标准。 例如,病理学在很多肿瘤诊断中仍是重要参照标准。
同时,待评价试验和金标准最好独立实施、独立判读。这样可以减少信息污染,避免一个结果影响另一个结果。对临床研究而言,这一步往往比复杂统计更重要。
3.3 统一操作流程,减少技术性波动
诊断试验误差不只来自设计,也来自操作。标本采集时间、保存条件、检测平台、阈值设定、判读标准,都会改变结果。同一种检测方法,在不同中心之间表现不同,常常不是方法本身差,而是流程不一致。
建议在研究方案中明确以下内容:
- 采样时间点。
- 检测前处理方法。
- 质控标准。
- 阈值来源与依据。
- 异常值处理规则。
这些细节看似琐碎,但它们决定了结果能否重复。
3.4 用四格表和ROC思维检查误差方向
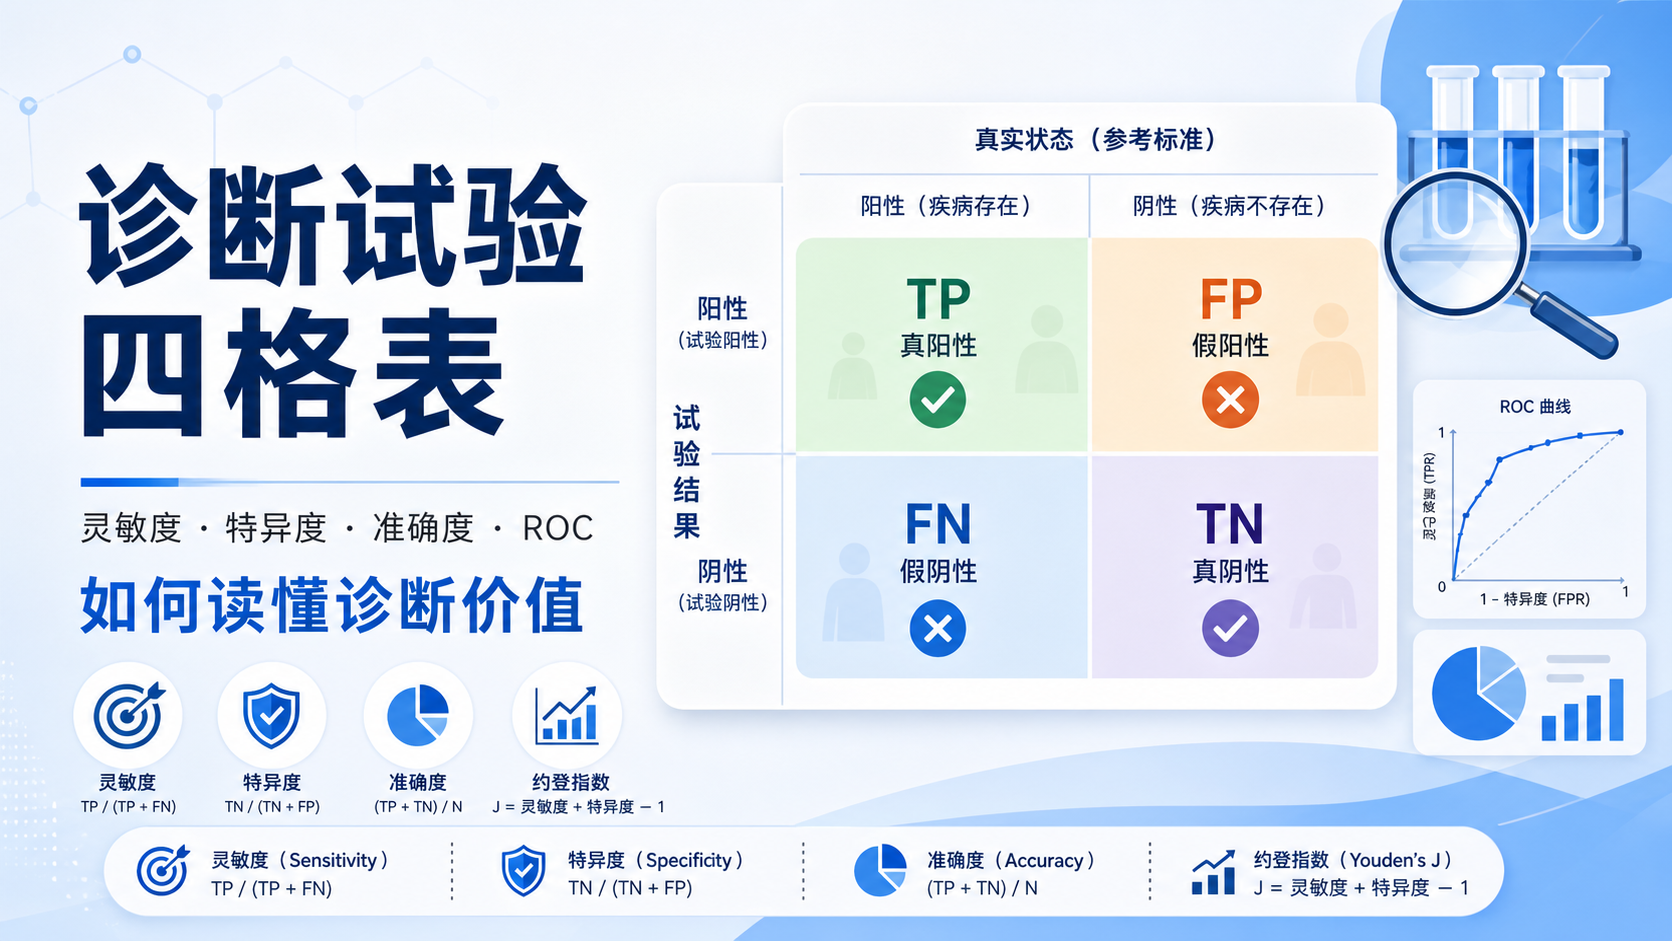
诊断试验的核心统计,通常围绕四格表展开。敏感度对应真阳性发现能力,特异度对应真阴性排除能力。如果一个试验敏感度很高,但特异度低,可能更适合筛查,不适合确诊。
ROC 分析可帮助理解 cut-off 改变后,敏感度和特异度如何此消彼长。临床上没有“万能阈值”,只有“适合目标场景的阈值”。如果阈值选择没有依据,就可能把误差放大成决策偏差。
4. QUADAS-2:评价诊断试验质量的标准工具
4.1 QUADAS-2关注的不是“结果漂亮”,而是“是否可信”
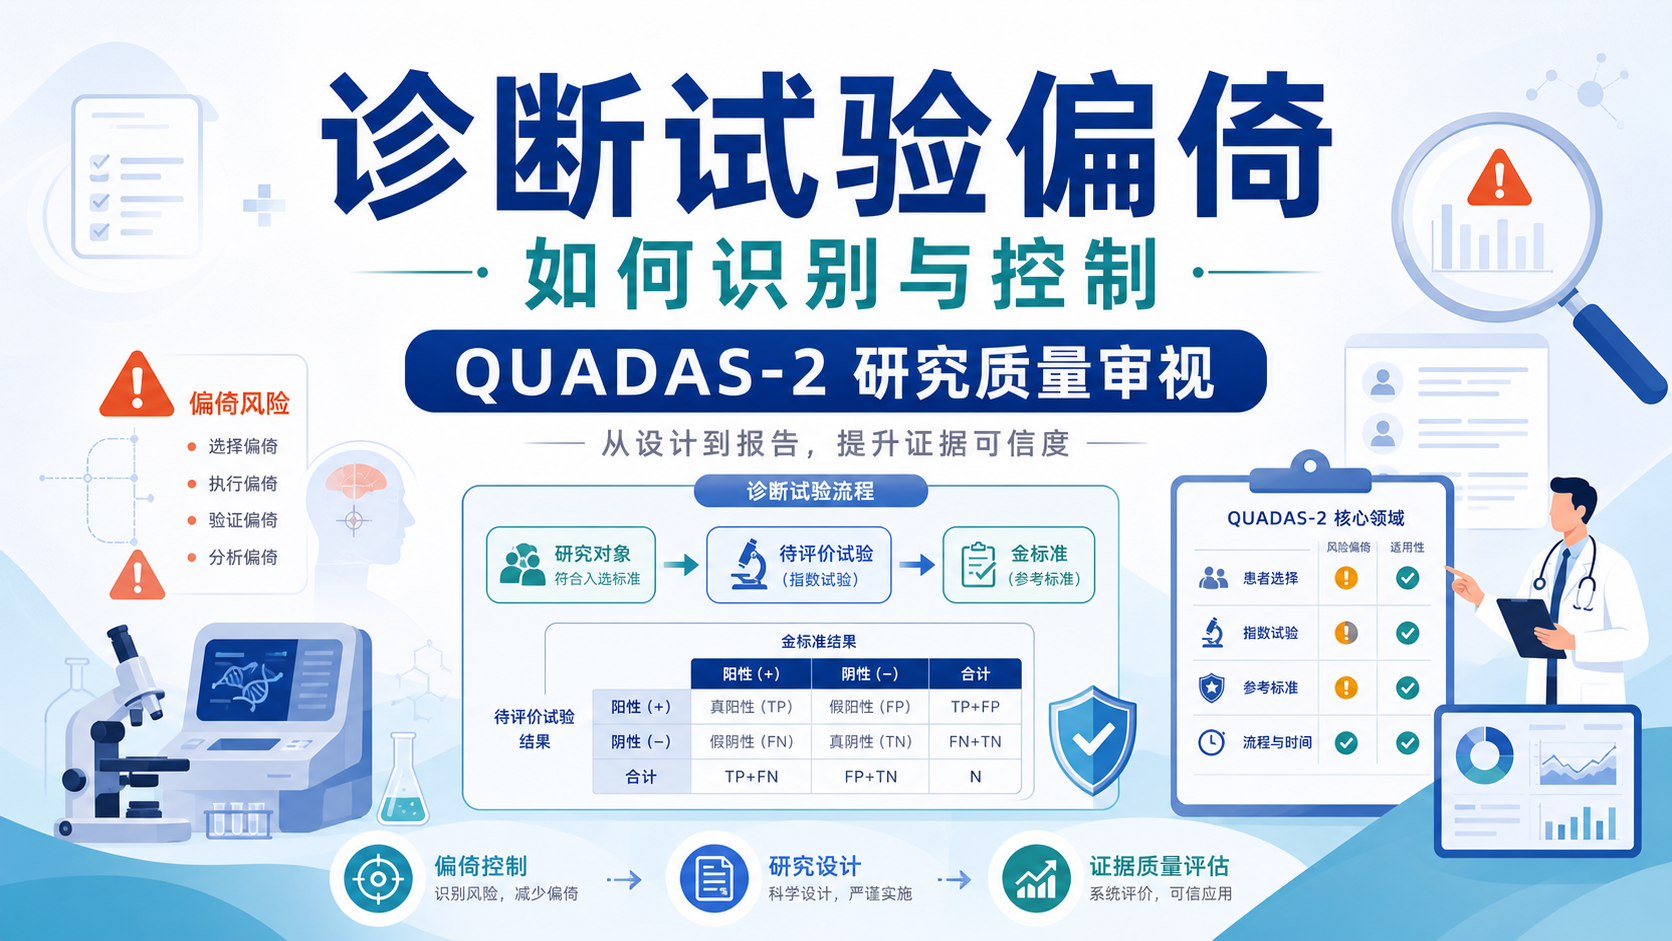
在系统评价和Meta分析中,QUADAS-2 是评价诊断试验偏倚风险和适用性的重要工具。它主要看四个域。不是问研究有没有显著性,而是问研究会不会偏、偏到哪里、能不能用于目标人群。
四个核心维度通常包括:
- 病例选择。
- 指标试验。
- 参照标准。
- 流程与时间。
对于科研人员来说,这套工具的价值在于帮助识别研究是否值得纳入。一个AUC很高的研究,如果偏倚风险过大,仍然不适合直接指导临床。
4.2 系统评价里最常见的“高分低质”问题
很多诊断研究存在这样的情况:样本少、病例清楚、对照简单、结果很好看,但真实世界适用性差。这类研究在系统评价中往往会拉高总体估计,却降低结论可信度。
因此,读文献时不要只看显著性和AUC,还要看是否连续入组、是否盲法、金标准是否可靠、是否存在部分验证偏差。只有这样,才能判断研究结果是真实提升,还是误差造成的表面优势。
5. 从研究到临床,如何把误差控制落到实处
5.1 研究者要先回答“为谁诊断”
不同场景,对诊断试验的要求完全不同。筛查强调高敏感度,确诊强调高特异度,分层管理则看综合效能。如果研究目标不清晰,就很容易在设计、阈值和解释上全部出错。
建议在立项时明确三件事:
- 目标人群是谁。
- 诊断目的是什么。
- 结果将用于筛查、确诊还是鉴别诊断。
这三点决定了你应该优先控制哪类误差。
5.2 临床团队要把“可信度”放在“好看指标”前面
诊断试验的价值,不只在于能不能区分病例和对照,更在于能否稳定服务真实临床。真正优秀的研究,往往不是最炫的数据,而是最少的偏移和最清楚的流程。
对医生而言,这意味着在使用任何新检测方法前,都要先问:样本怎么来的,金标准是什么,盲法做了吗,阈值是否适用于本中心。对科研人员而言,这意味着发文时必须把偏倚控制写清楚,而不是只报告结果。
5.3 借助解螺旋提升诊断研究写作与设计效率
如果你正在做诊断准确性研究,最容易卡住的往往不是统计计算,而是研究设计、偏倚识别和论文写作逻辑。解螺旋可以帮助你系统梳理诊断试验方法、QUADAS-2评估思路和结果呈现框架,让研究从“会做”走向“做对”。
无论是课题设计、数据整理,还是论文撰写与投稿表达,把误差控制前置,都会明显提升研究质量,也更有利于后续发表和临床转化。
总结Conclusion
诊断试验误差不是次要问题,而是决定结果能否用于临床的核心因素。设计偏移、选择性偏移、金标准偏移、结果评价偏移,都会影响敏感度、特异度和最终决策。控制诊断试验误差,关键在于前瞻性连续入组、可靠金标准、独立盲法评估和规范化流程。 如果你希望进一步提升诊断研究设计与论文表达质量,建议结合解螺旋的专业课程和工具支持,系统优化你的研究路径。
- 引言Introduction
- 1. 诊断试验误差为什么会直接影响临床决策
- 2. 诊断试验误差的主要来源
- 3. 诊断试验误差的控制方法
- 4. QUADAS-2:评价诊断试验质量的标准工具
- 5. 从研究到临床,如何把误差控制落到实处
- 总结Conclusion