23
 分享
引言Introduction
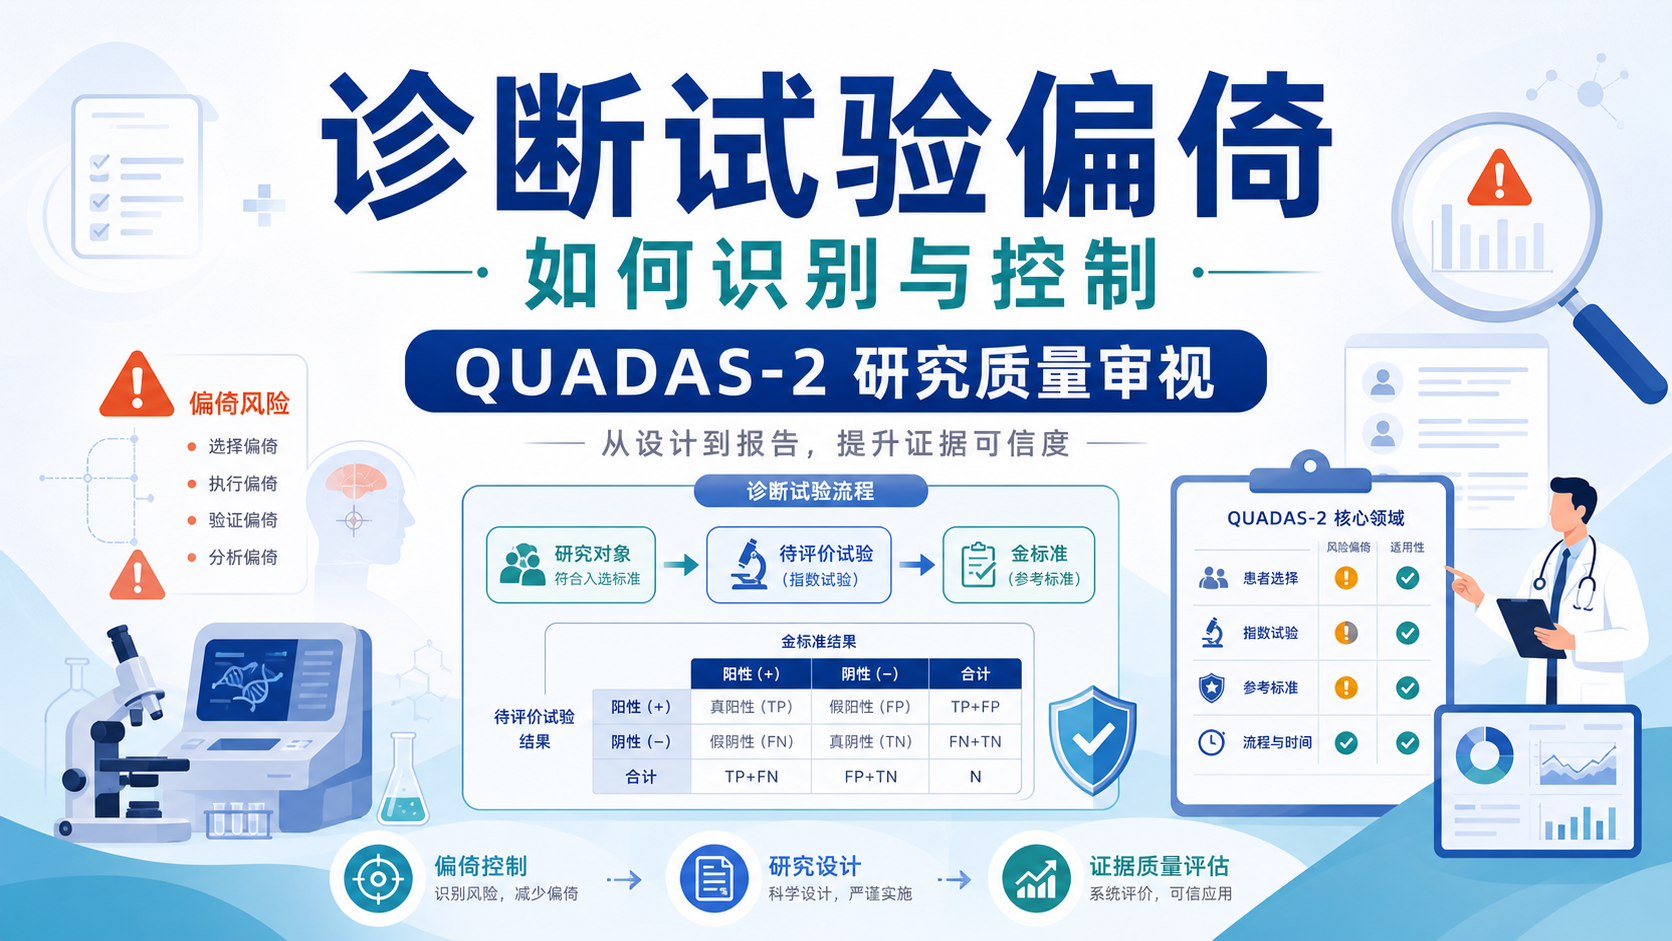
诊断试验看起来只是在算敏感度、特异度,但偏倚一旦进入设计和分析,结果就可能被系统性高估或低估 。对医学生、医生和科研人员来说,真正难的是识别偏倚来源,并在论文中说清楚。
1. 诊断试验偏倚为什么必须重视
1.1 偏倚不是随机误差,而是方向性错误
诊断试验的目标,是判断某项检查能否准确区分“有病”和“无病”。但如果研究设计本身有缺陷,结果就会朝一个方向偏移。这类误差不会因为样本量变大而自动消失。
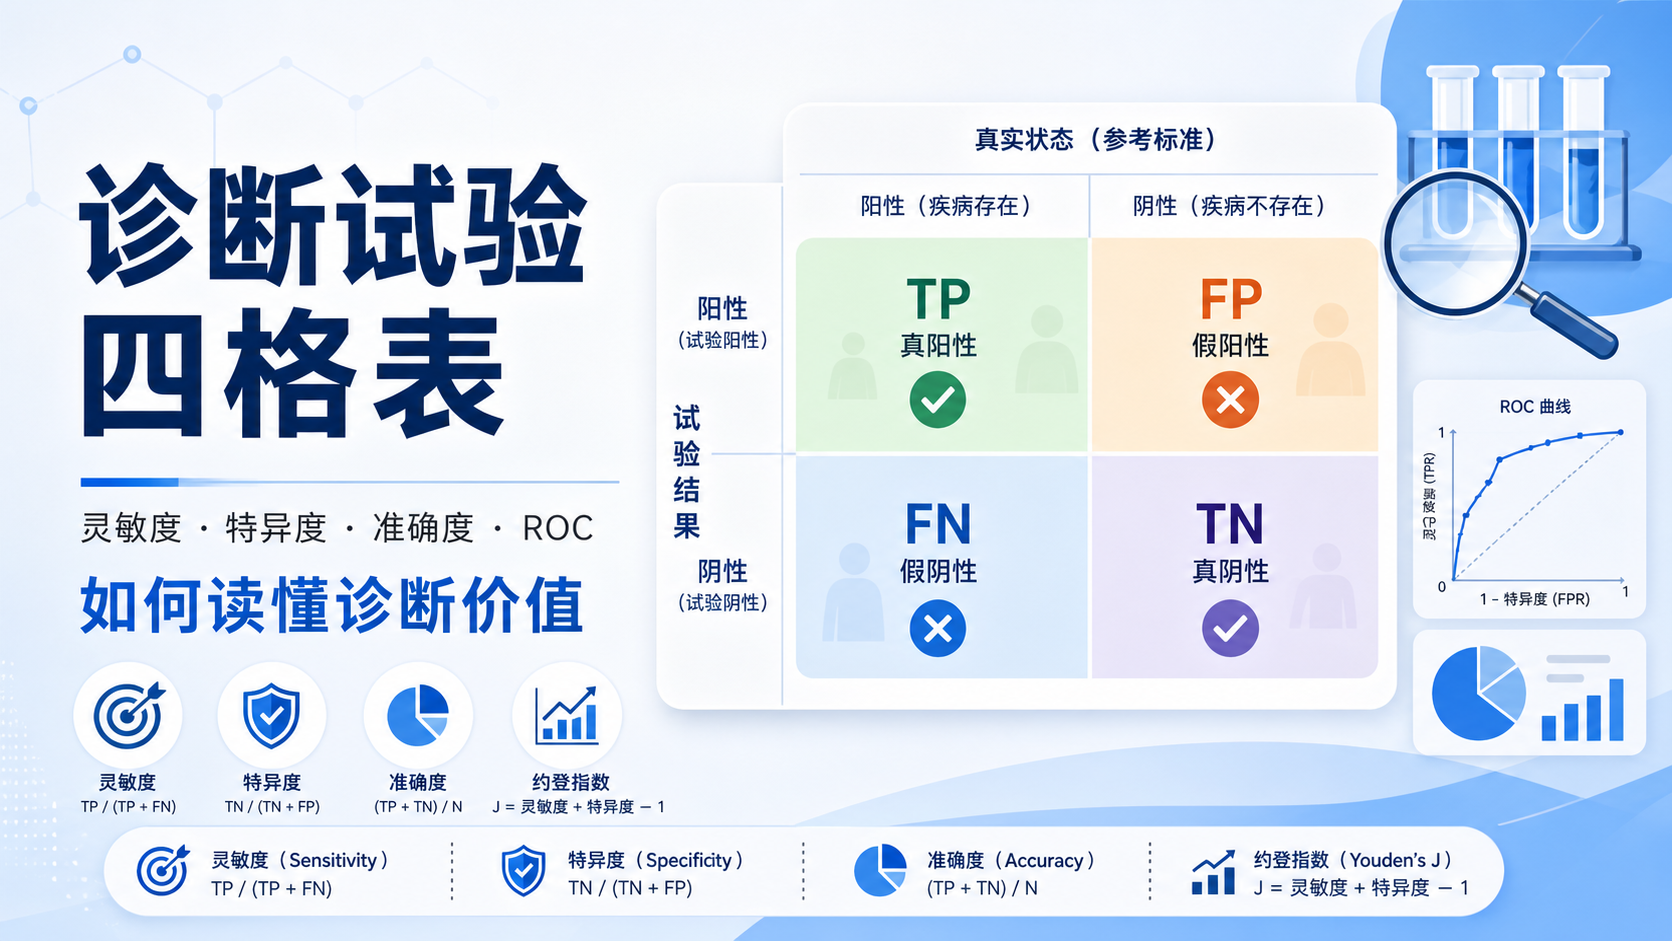
在临床研究中,诊断准确性常用敏感度、特异度、阳性预测值、阴性预测值来描述。但这些指标都依赖研究对象、金标准和测量过程。任何一个环节出问题,都会影响最终结论。
1.2 常见后果是“看起来更好”
诊断试验最危险的地方,在于它常常让结果“变漂亮”。例如,病例对照设计可能把病例和健康人分得过于极端,导致准确度被高估。已有研究提示,这类设计相对横断面或连续入组设计,可能明显高估诊断效能,甚至达到约3倍 。
因此,评价一项诊断技术,不能只看结果数字,更要看这些数字是怎么来的。
2. 诊断试验中最常见的偏倚类型
2.1 领先时间偏倚与前期临床长短偏倚
领先时间偏倚常见于筛检研究。它的核心问题是,试验只是把“发现疾病的时间点”提前了,并不一定真正延长生存期。起点提前,不等于终点延后。
如果某筛检在临床症状出现前就发现疾病,观察到的“生存时间”会变长,但这可能只是从更早的时间开始计时。真正判断获益时,不能只看表面上的生存期延长,还要看死亡时间是否推迟。
前期临床长短偏倚也很容易混淆判断。某些疾病的临床前期更长,更容易在筛检中被检出。这样筛到的病例,天然可能预后更好。这不一定是筛检本身带来的收益,也可能是疾病生物学差异。
2.2 志愿者偏倚与选择性偏倚
志愿者偏倚来自入组人群和真实目标人群不一致。愿意参加筛检或诊断试验的人,往往健康意识更强,经济条件更好,依从性也更高。这样的人群本身结局就可能更好。
这会带来两个问题。
- 研究结果不一定能推广到普通临床人群。
- 观察到的“更好结局”可能被误认为是试验效果。
所以,诊断试验最好采用连续入组或前瞻性入组,减少人为筛选。
2.3 参考试验偏倚,也就是金标准偏倚
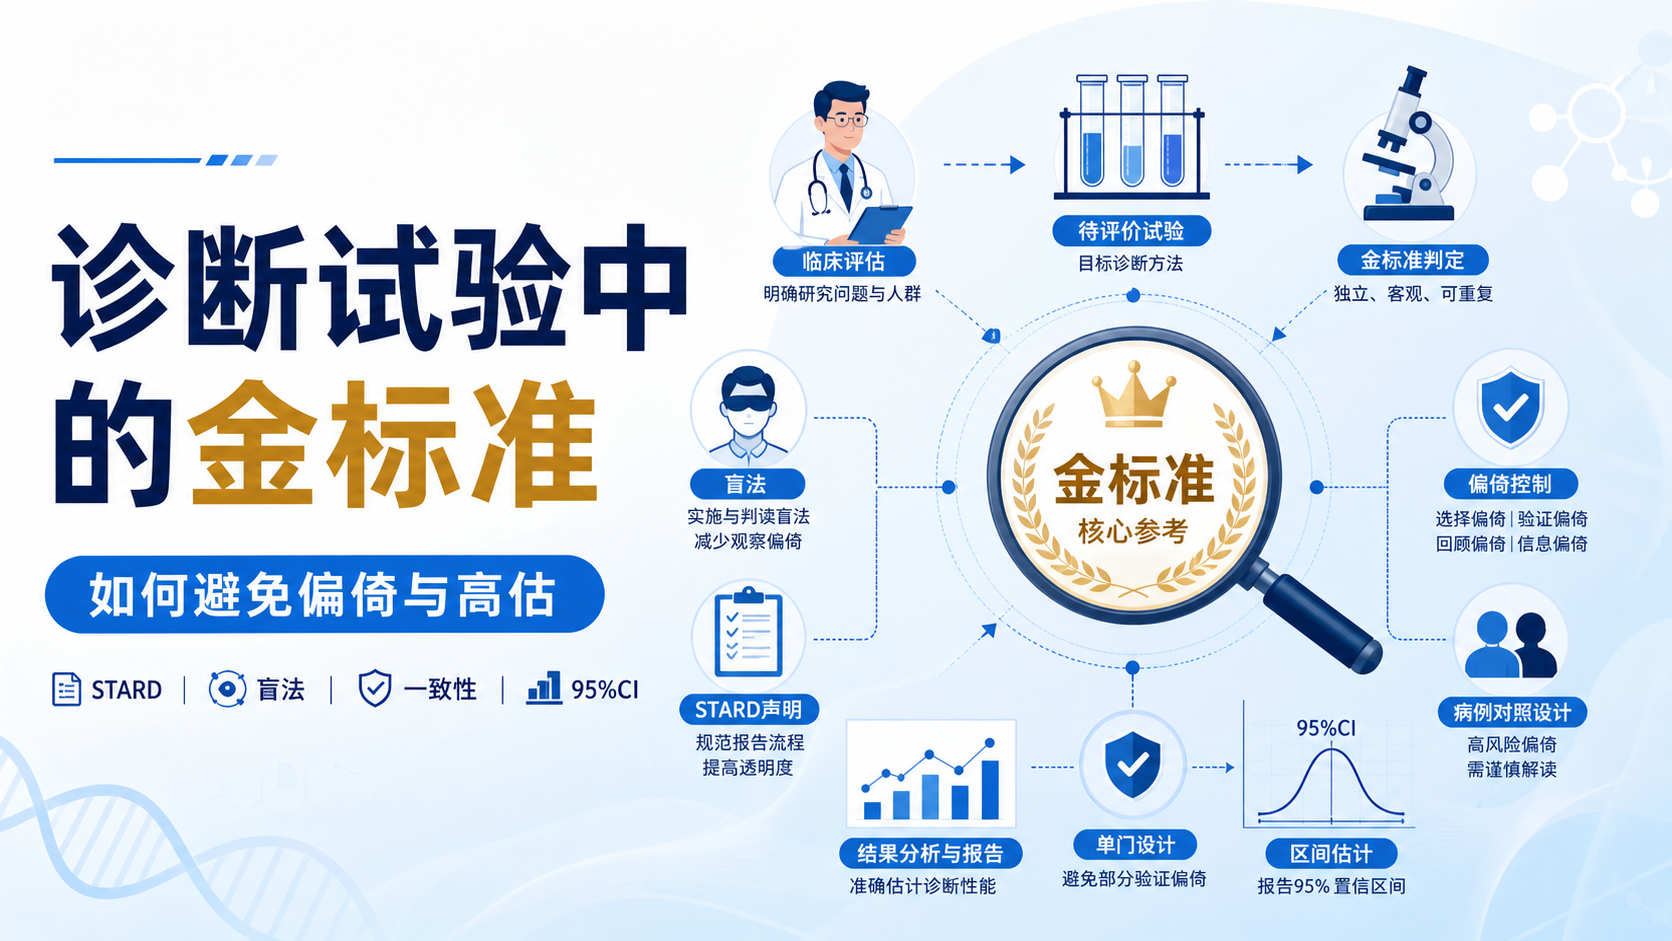
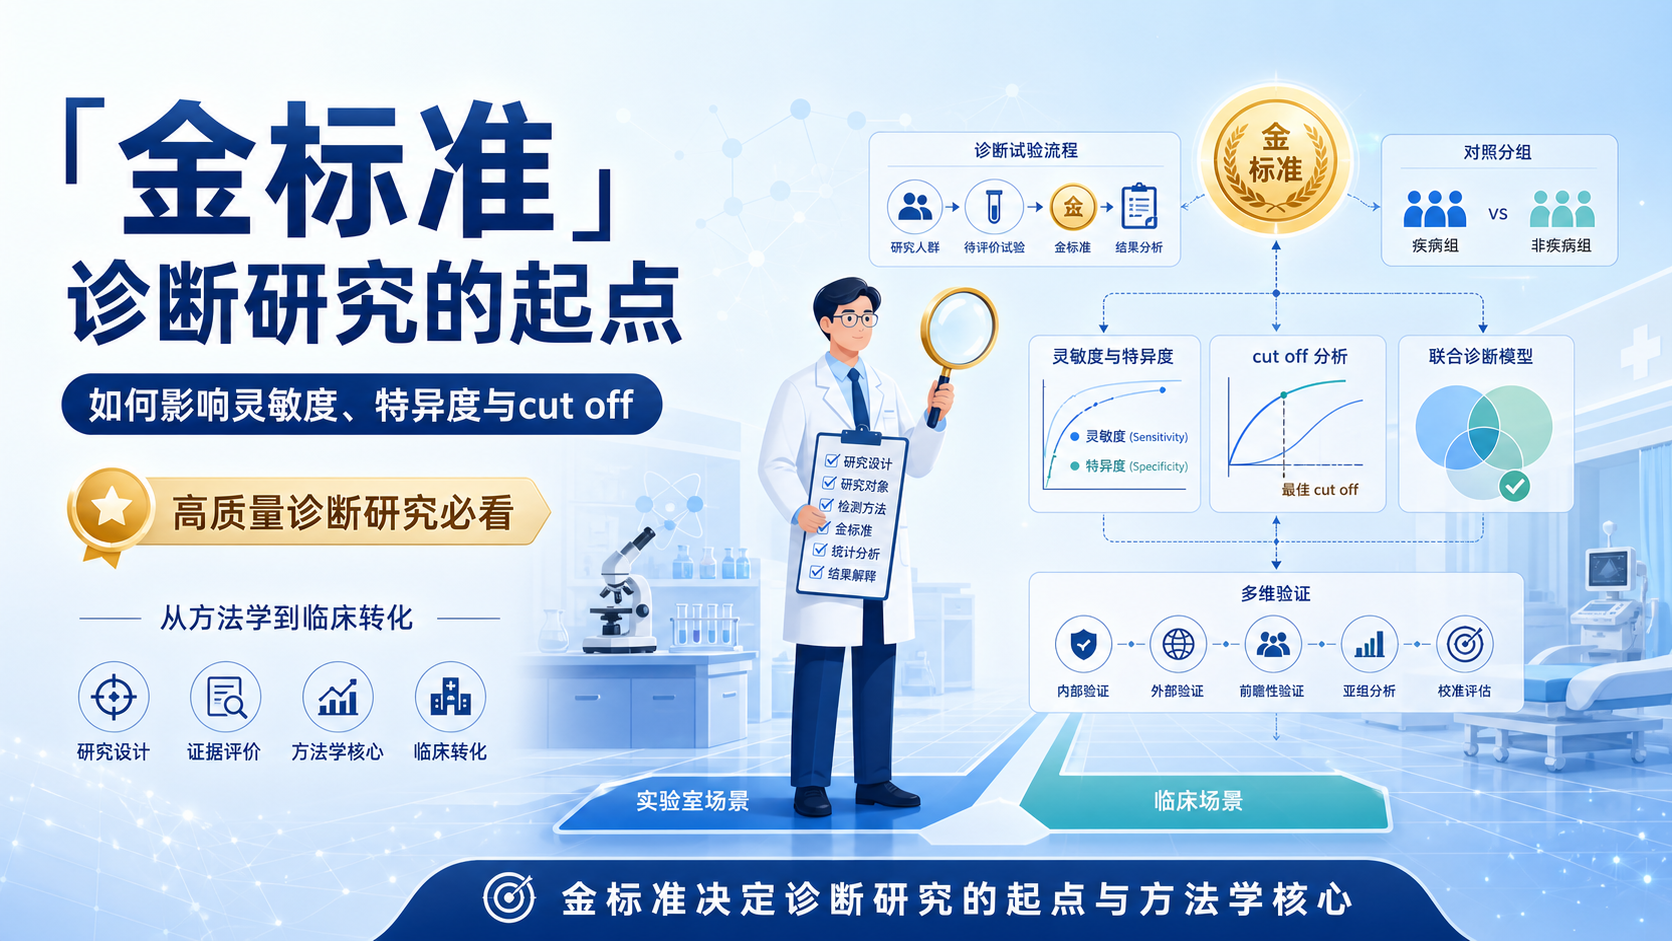
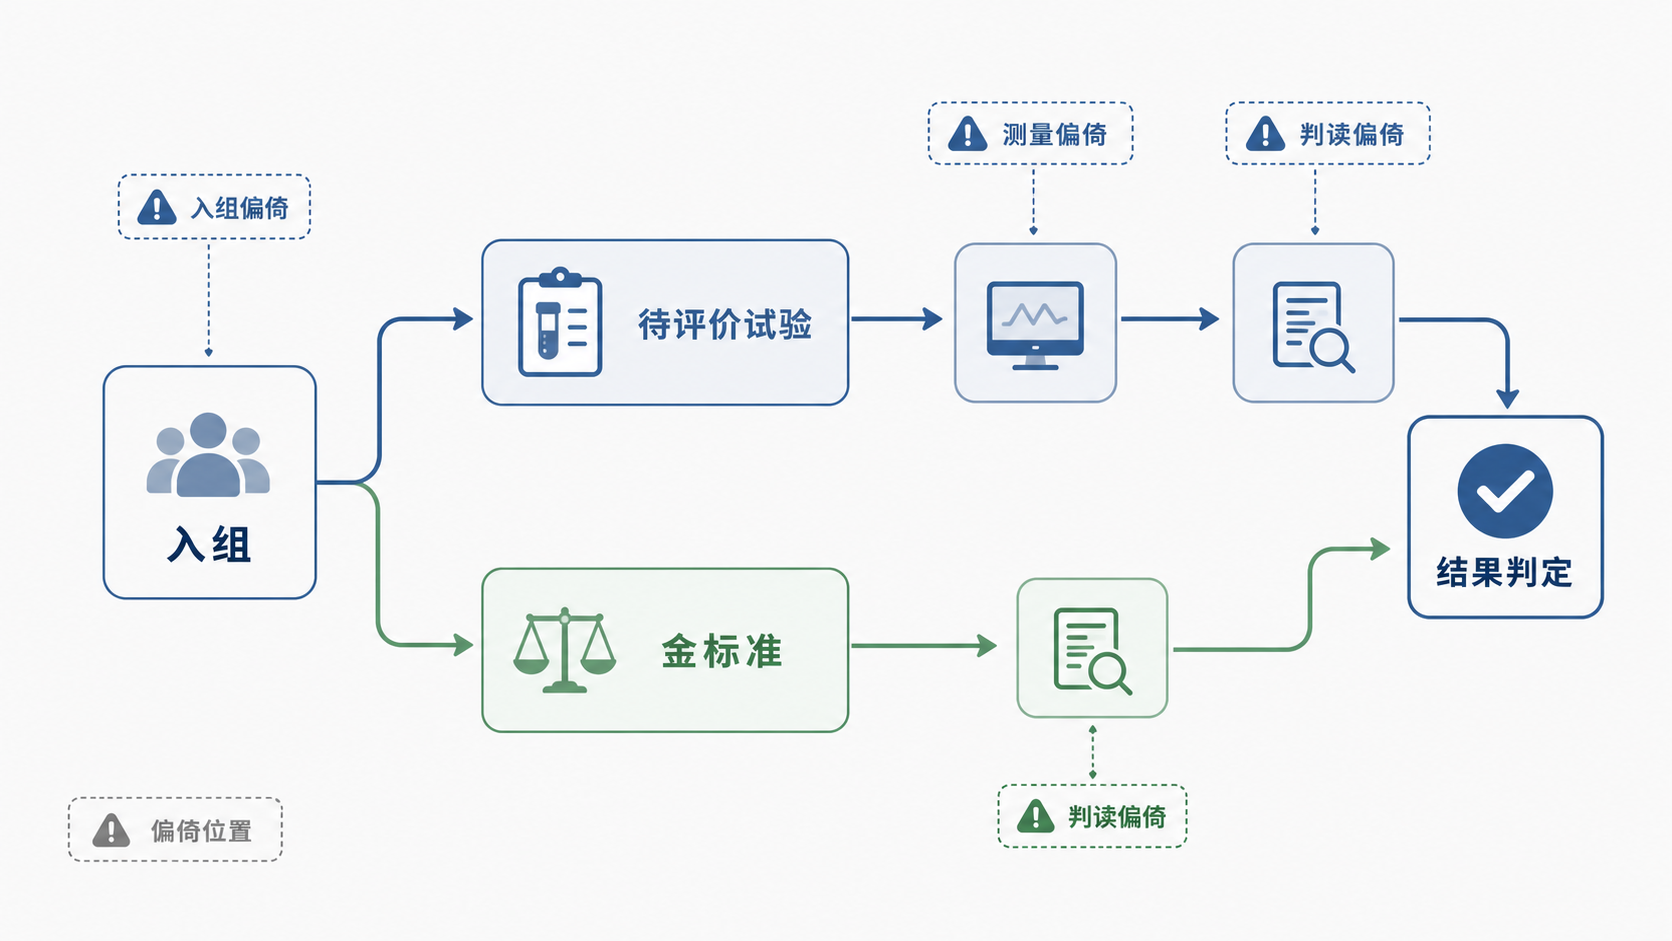
金标准是诊断准确性研究的参照基础。如果金标准本身不够准确,待评价试验的灵敏度和特异度就会被错误估计。
例如,用手术病理作为胆囊结石的参照,通常比用B超更可靠。因为B超本身就可能漏诊或误诊。如果把一个不够“金”的方法当作金标准,新的诊断方法再准确,也可能被低估或高估。
临床研究中,金标准应尽量接近病理组织学、长期随访结局或公认的最佳诊断标准。
2.4 错分偏倚与测量不一致
错分偏倚主要来自检测工具、操作流程或判读标准不统一。比如不同设备、不同操作者、不同阈值,都会让结果产生偏差。
这类偏倚在影像学、实验室检测和分子诊断中都很常见。如果同一检测在不同条件下结果波动大,研究的可重复性就会下降。
2.5 结果评价偏倚与退出研究偏倚
结果评价偏倚常见于判读者知道了金标准或待评价试验结果,导致判断不客观。盲法是控制这一问题的关键。金标准评估者和待评价试验评估者应尽量独立。
退出研究偏倚则发生在随访过程中。若高风险患者更容易退出,最终分析集就不再代表原始样本。这样会影响敏感度、特异度和一致性指标。
3. 研究设计阶段如何尽量控制偏倚
3.1 优先选择横断面或前瞻性连续入组
在诊断准确性研究中,最理想的做法通常是横断面设计,或者连续纳入临床上所有符合条件的疑似患者。这样更接近真实临床场景。
与病例对照设计相比,这种设计更能反映试验在实际应用中的表现。研究对象应来自同一临床路径,且都接受相同的待评价试验和金标准。
3.2 对照选择要贴近真实鉴别场景
如果研究目的是区分目标疾病与临床上容易混淆的疾病,对照组就应来自这些相似疾病,而不是只选健康人。否则,准确度往往会被高估。
例如,评价某肿瘤标志物时,若对照全部是健康人,结果很可能显得“特别好”。但真实临床中,医生面对的通常不是健康人,而是类似症状、类似影像、类似实验室异常的患者。
3.3 金标准、待评价试验和临床信息应独立判读
研究设计中,最好做到以下几点。
- 金标准判读者不知道待评价试验结果。
- 待评价试验判读者不知道金标准结果。
- 若可能,采用统一的判读流程和阈值。
这样可以降低主观判断带来的系统误差。
4. 报告诊断试验时,哪些信息不能省
4.1 必须交代入组流程和样本来源
读者最关心的是,这些病例是怎么来的。是连续入组,还是回顾性筛选?是单中心,还是多中心?是否存在明显的选择性纳入?
如果样本来源不清楚,结果的外推性就值得怀疑。
4.2 必须说明金标准和判读规则
论文中应明确说明金标准是什么,是否足够可靠,是否存在不一致判读。还要说明待评价试验的阳性界值如何确定。
如果阈值是通过ROC曲线确定的,应说明是否存在过拟合风险。若来自既往研究,也要交代其依据。
4.3 必须报告偏倚控制措施
高质量的诊断试验论文,不只是报告准确度数字,还要说明如何控制偏倚。例如:
- 是否前瞻性设计。
- 是否连续入组。
- 是否所有受试者都接受了同一金标准。
- 是否使用盲法。
- 是否有失访或退出,以及如何处理。
这些信息直接影响论文可信度。
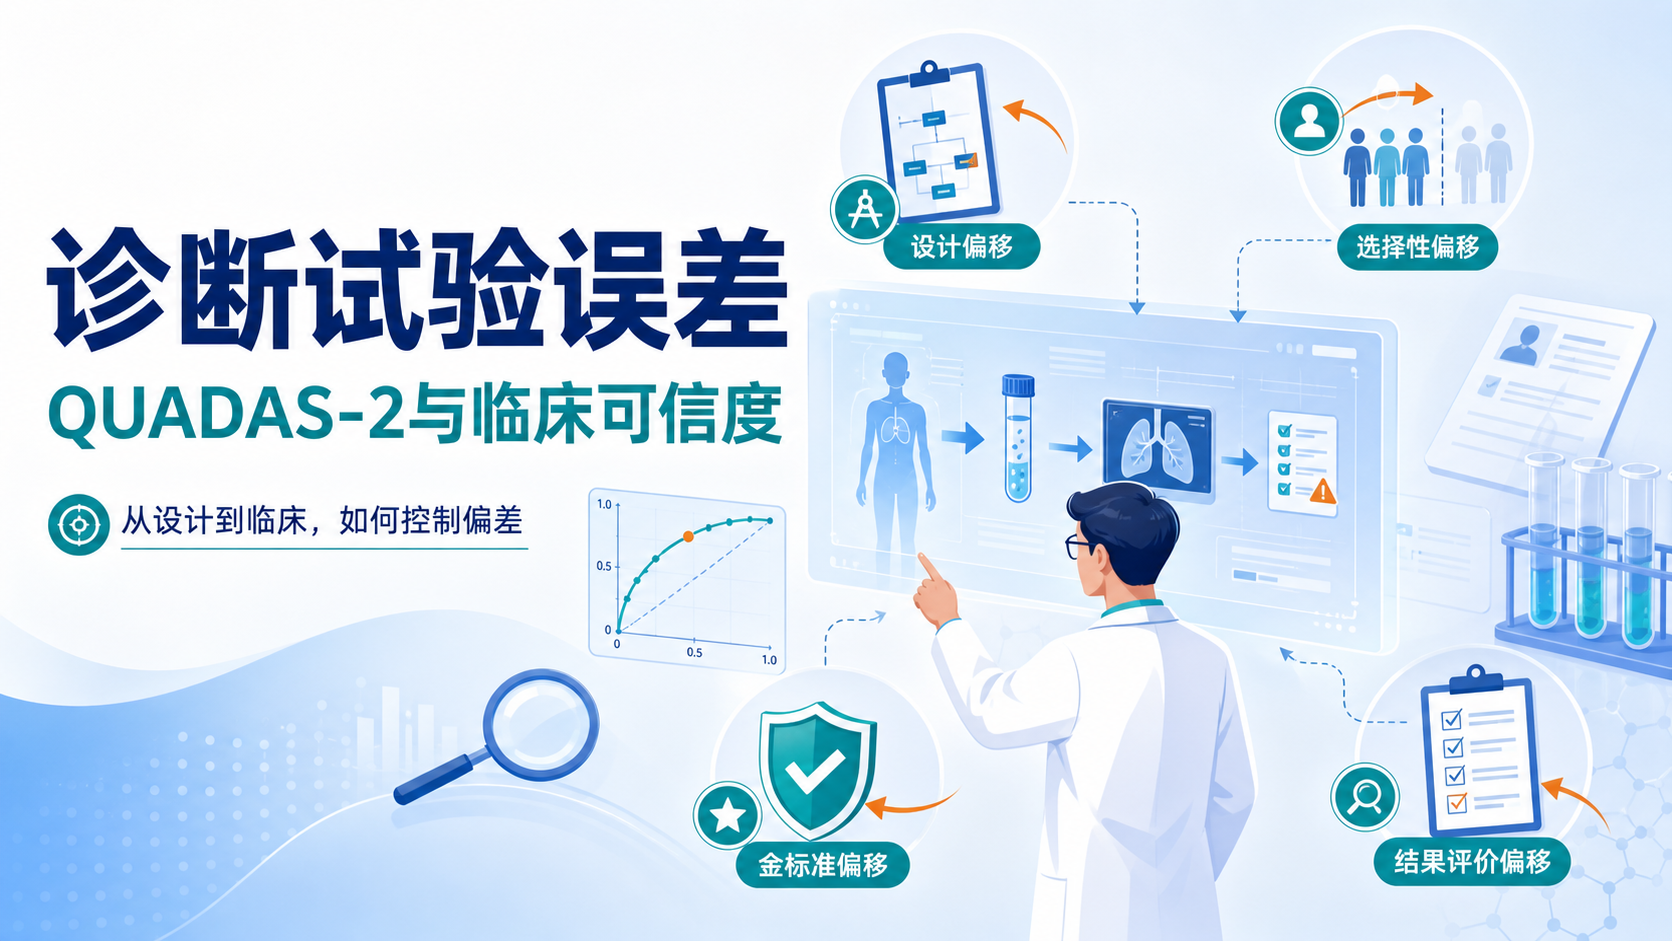
5. 用QUADAS-2思路审视研究质量
5.1 四个核心领域
QUADAS-2是评价诊断准确性研究质量的常用工具。它主要看四个领域。
- 病例选择。
- 待评价试验。
- 参考标准。
- 流程和时间。
这四项本质上都在回答同一个问题:研究结果能否可信地反映真实诊断能力。
5.2 它对写作和审稿都很实用
对于研究者来说,QUADAS-2不仅是系统评价工具,也是一张设计清单。你在设计时先排查这些问题,往往能提前发现偏倚风险。
对于审稿和论文写作来说,它也很有帮助。因为它能帮助作者把“研究怎么做的”说清楚,而不是只给出一组漂亮数字。
6. 从研究到论文,如何写得更严谨
6.1 不要只写准确度,要写解释框架
很多诊断试验论文只写AUC、敏感度、特异度,却不交代样本来源和偏倚控制。这会让读者无法判断结果能否应用到临床。
更好的写法是把结果放回设计背景中解释。比如说明研究对象是疑似患者,金标准是什么,是否存在双门设计,是否可能高估准确度。这类交代越完整,论文越可信。
6.2 结果讨论要主动提偏倚
在讨论部分,作者应主动指出潜在偏倚,而不是回避。常见写法包括:
- 回顾性设计可能带来的选择偏倚。
- 样本量有限,可能造成估计不稳定。
- 单中心研究限制外推性。
- 金标准或判读过程存在局限。
这不是削弱论文,而是在增加可信度。
6.3 让研究设计先行,而不是让统计补救
统计分析可以修正一部分问题,但不能替代设计。诊断试验真正的质量,首先取决于人群、流程和金标准。
如果前期设计不严谨,再漂亮的ROC曲线也难以令人信服。对医学生和科研人员而言,理解这一点非常关键。
7. 结语:把偏倚控制前移到设计阶段
诊断试验偏倚不是写作时才处理的问题,而是从选题、入组、金标准到结果报告都要持续控制的问题。抓住领先时间偏倚、选择偏倚、金标准偏倚、错分偏倚和结果评价偏倚,才能让诊断准确性研究更接近真实临床。
如果你正在准备诊断试验课题、论文或系统评价,建议从设计阶段就引入规范化思路,减少返工和审稿风险。想把诊断试验设计、统计与论文写作做得更稳,可以进一步借助解螺旋的专业内容与研究支持,让偏倚控制真正落到实处。
总结Conclusion
诊断试验的核心,不只是“测得准”,而是“测得是否可信”。偏倚一旦进入设计和报告,结果就可能被系统性扭曲。
从研究对象选择、金标准设定,到盲法、连续入组和QUADAS-2评估,每一步都决定了结论的可靠性。对科研人员而言,真正高质量的诊断研究,必须把偏倚控制前移到设计阶段。
如果你希望在诊断准确性试验、论文写作和研究规范上进一步提升,可以关注并使用解螺旋 的专业支持,让研究从一开始就更严谨、更可发表。
- 引言Introduction
- 1. 诊断试验偏倚为什么必须重视
- 2. 诊断试验中最常见的偏倚类型
- 3. 研究设计阶段如何尽量控制偏倚
- 4. 报告诊断试验时,哪些信息不能省
- 5. 用QUADAS-2思路审视研究质量
- 6. 从研究到论文,如何写得更严谨
- 7. 结语:把偏倚控制前移到设计阶段
- 总结Conclusion