19
 分享
引言Introduction
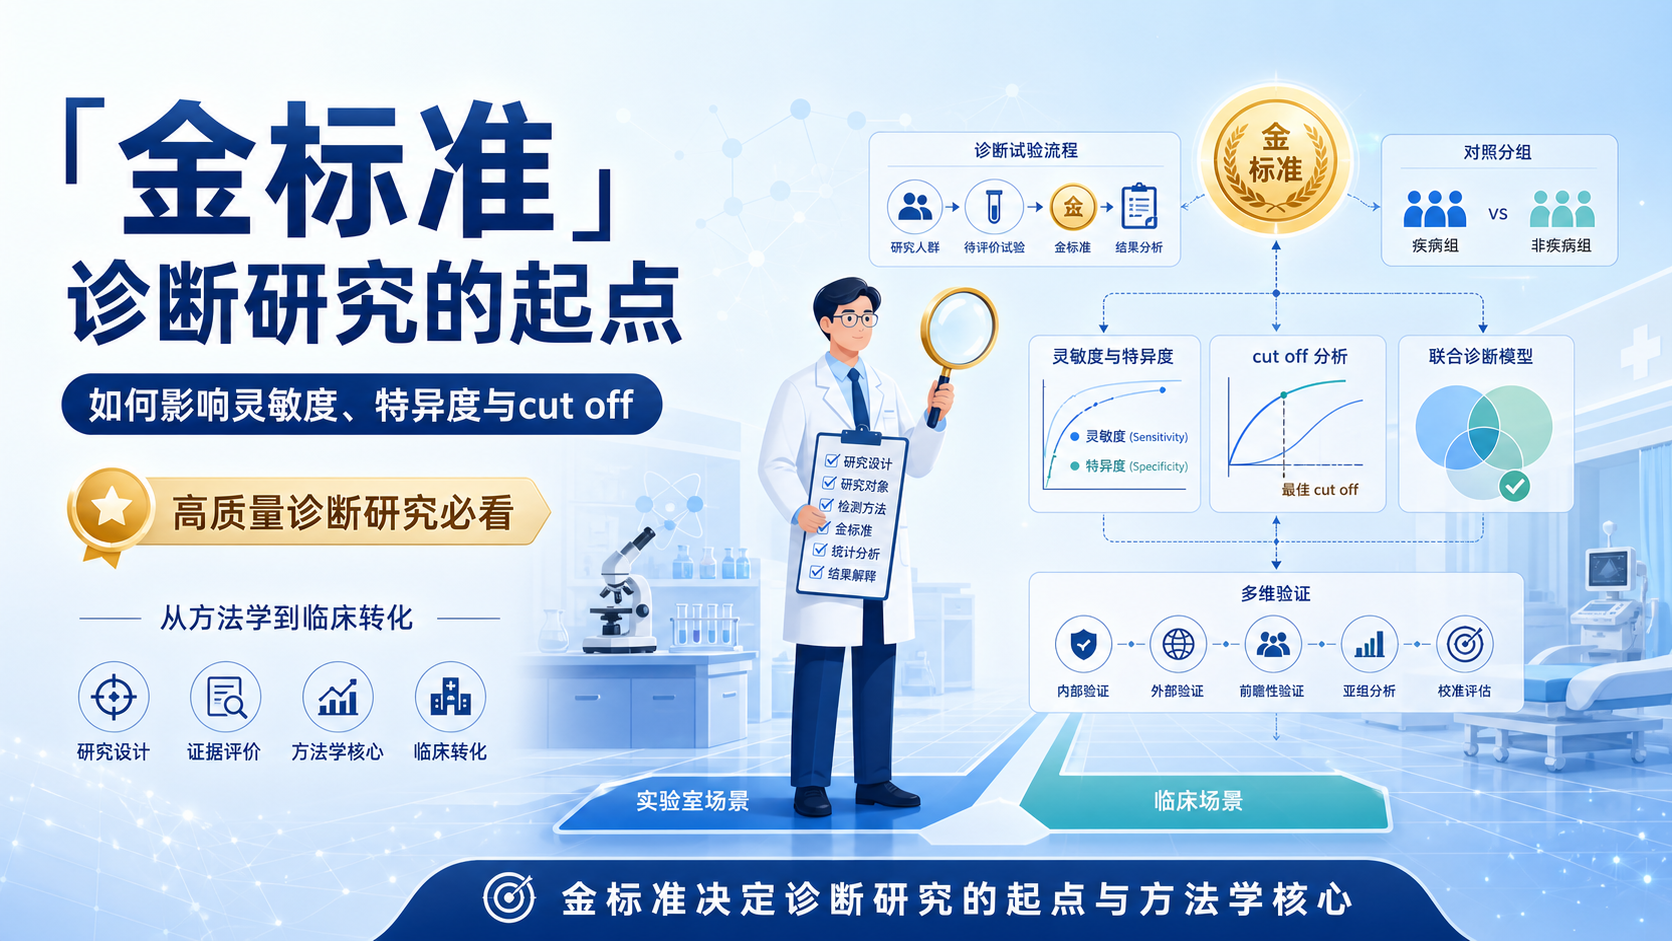
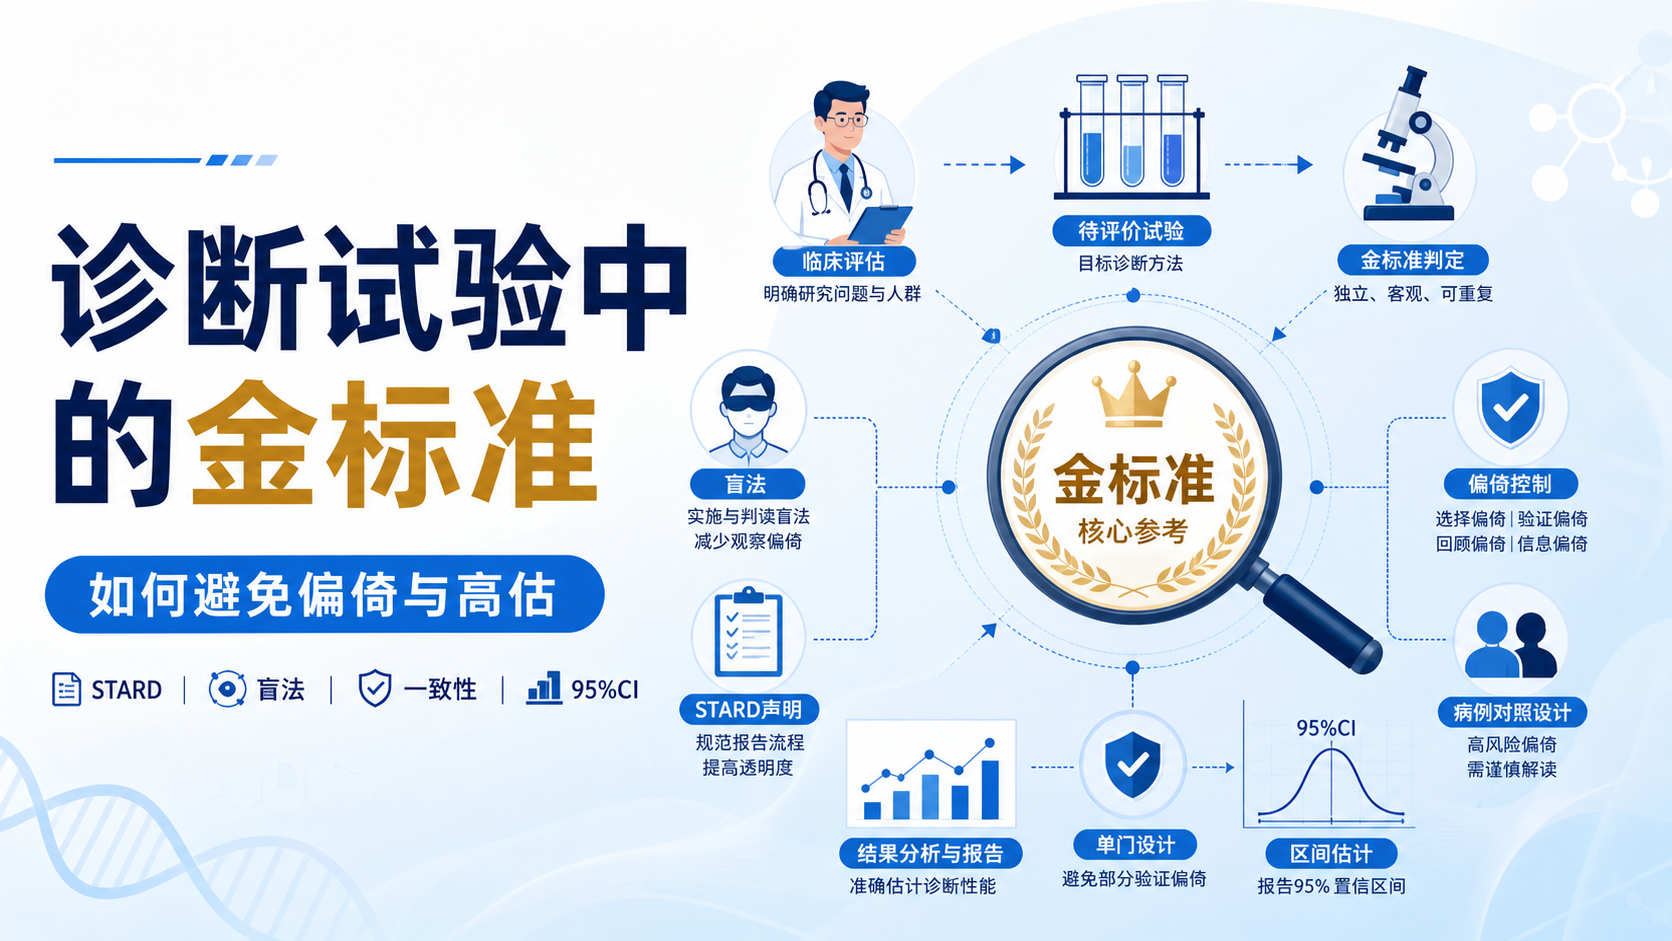
诊断试验做得再漂亮,如果金标准选错,结论也可能失真。对医学生、医生和科研人员来说,真正的难点不只是“测了什么”,而是“用什么判定对错 ”。金标准选择直接决定敏感度、特异度和论文可信度。
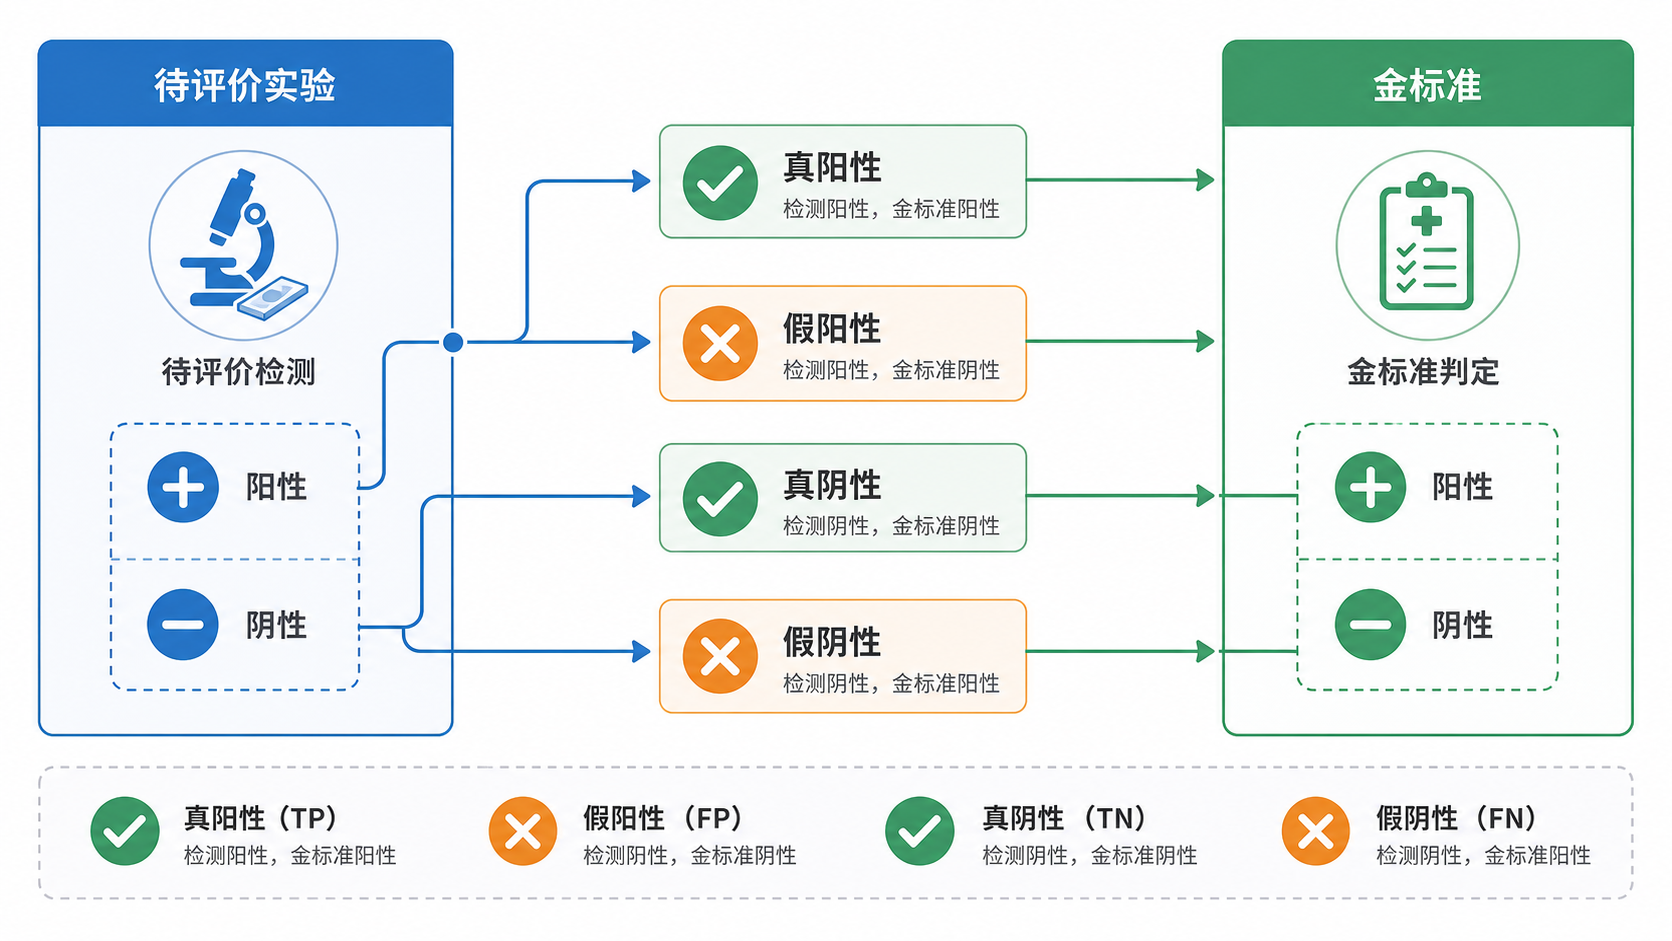
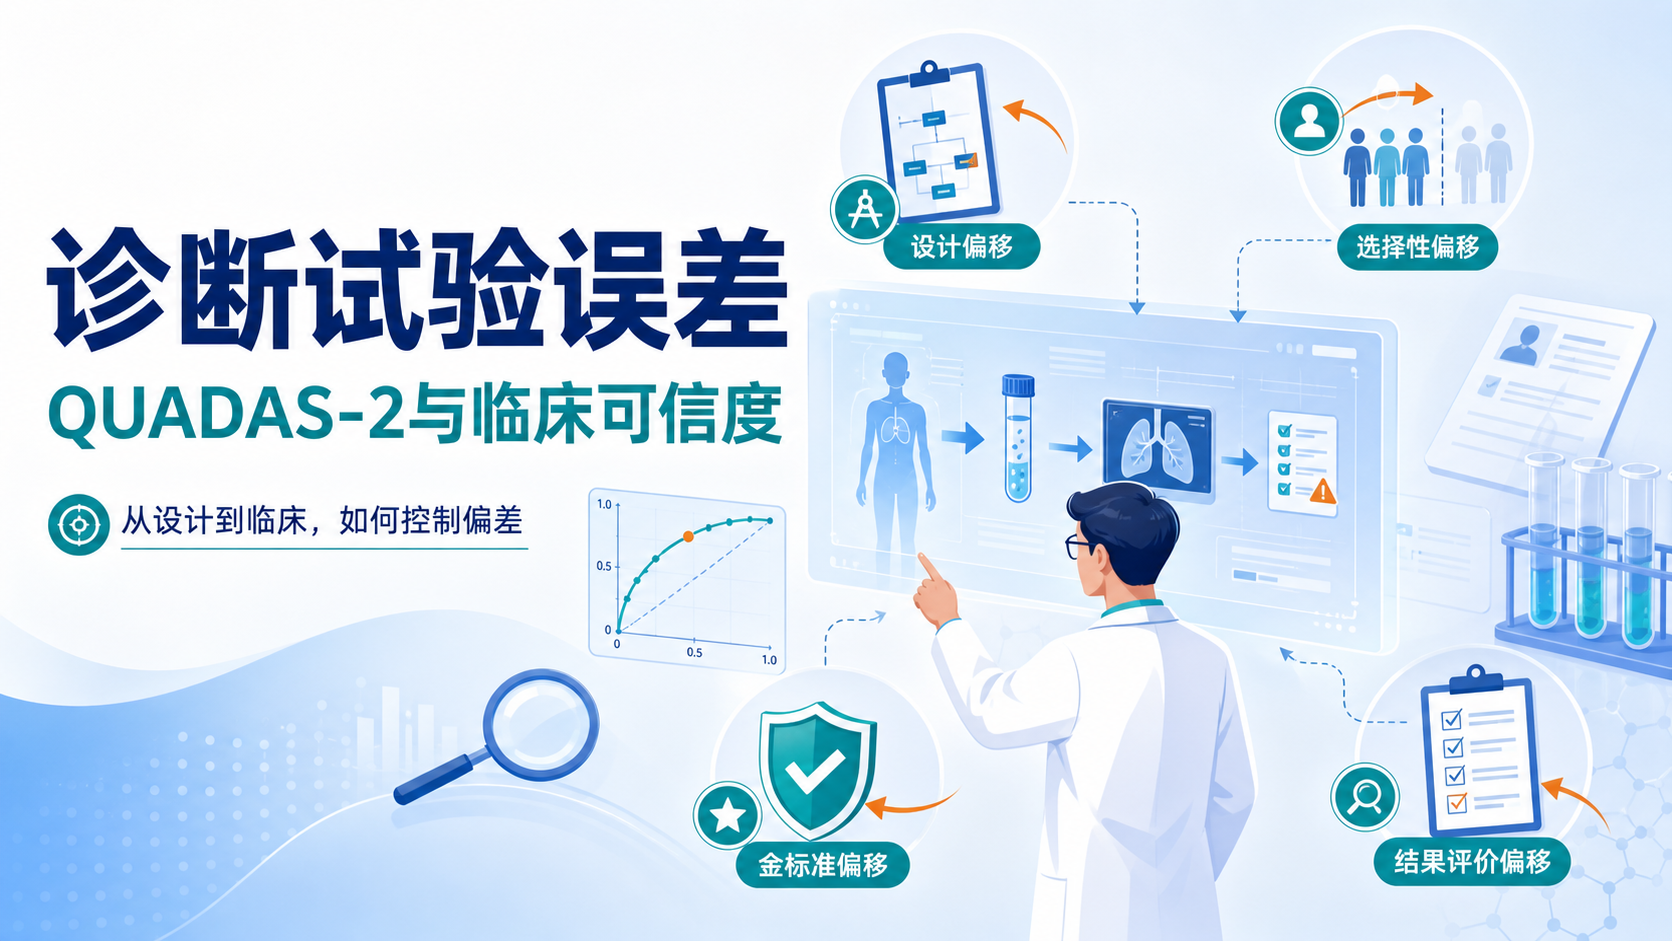
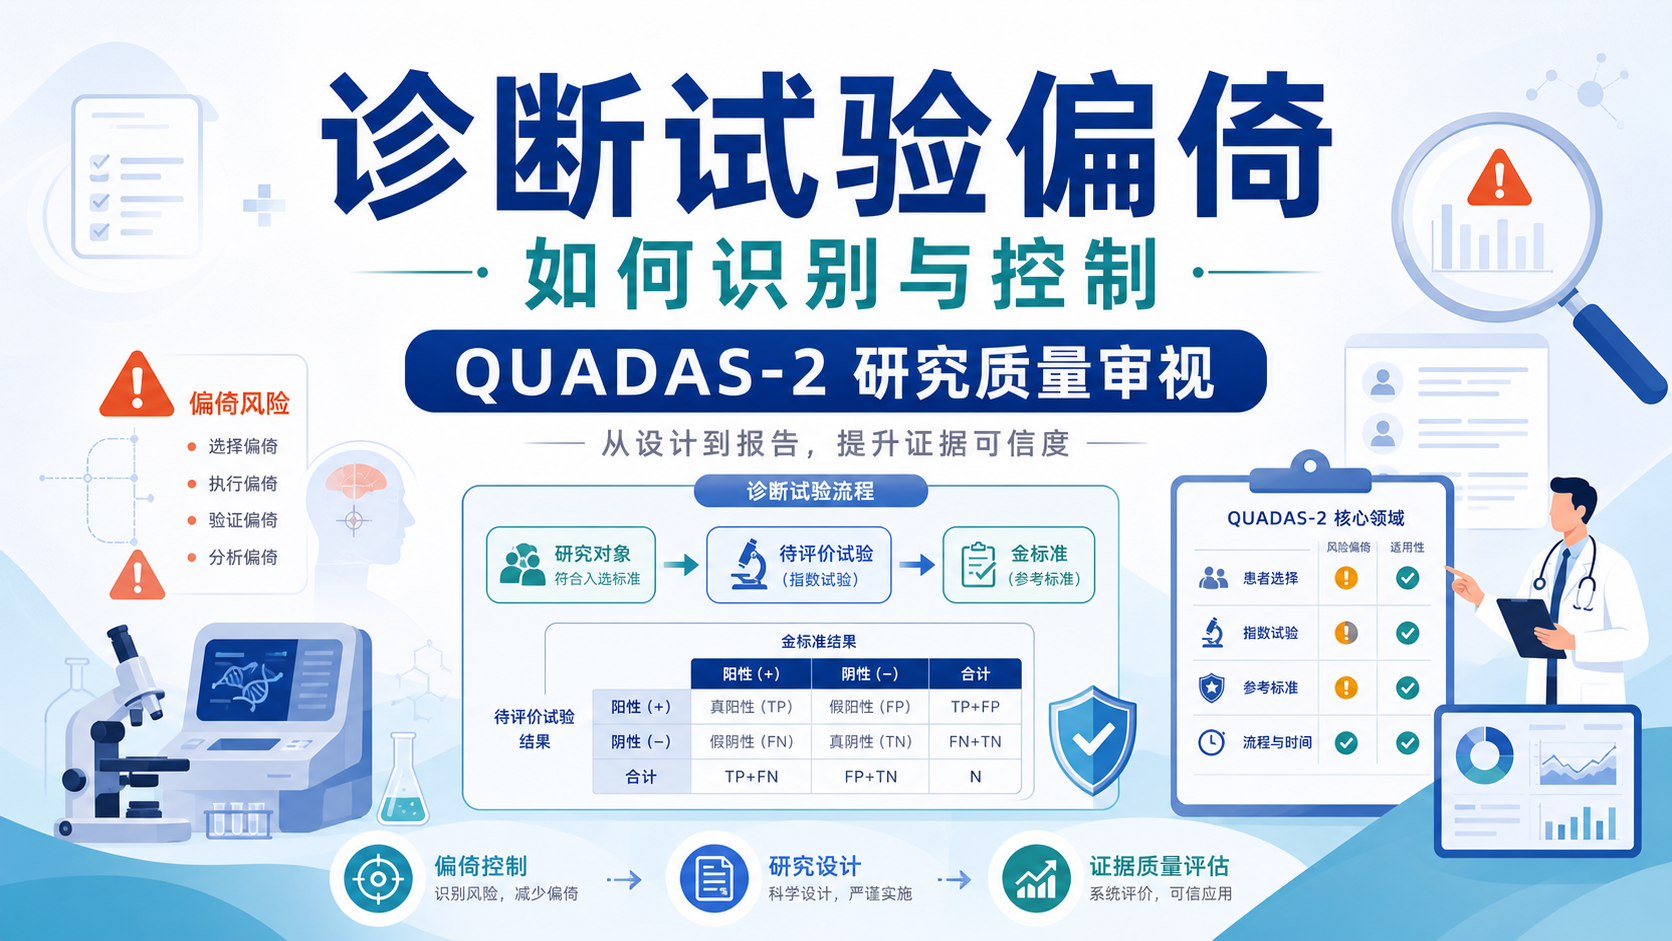
诊断准确性研究的核心,是把待评价实验与参考标准进行严格对照。如果参考标准不可靠,整篇研究的分类就可能偏移 。这也是STARD声明反复强调金标准、盲法和流程图的原因。本文从金标准视角,梳理诊断试验设计中最容易被忽视的规范要点。
1. 金标准为什么是诊断试验的核心
1.1 金标准决定“真值”来源
诊断试验不是单纯比较两个检测结果,而是要回答一个问题。新方法能否正确识别“有病”和“没病”。这就要求研究中必须有一个被视为最可靠的参照,也就是金标准或reference standard。
金标准的作用,是为所有受试者提供统一的真值。
只有真值明确,才能计算敏感度、特异度、阳性预测值和阴性预测值。若真值本身有误差,四格表就会被污染,结果也会偏向错误方向。
临床上,金标准往往并不轻松。它可能有创,可能耗时,可能费用高。比如病理学诊断通常更权威,但并不总能在所有患者身上直接实施。这也是很多新型无创检测不断出现的原因。
1.2 金标准不当会放大系统性偏倚
金标准选择不当,最常见的后果不是“随机误差”,而是系统性偏倚。
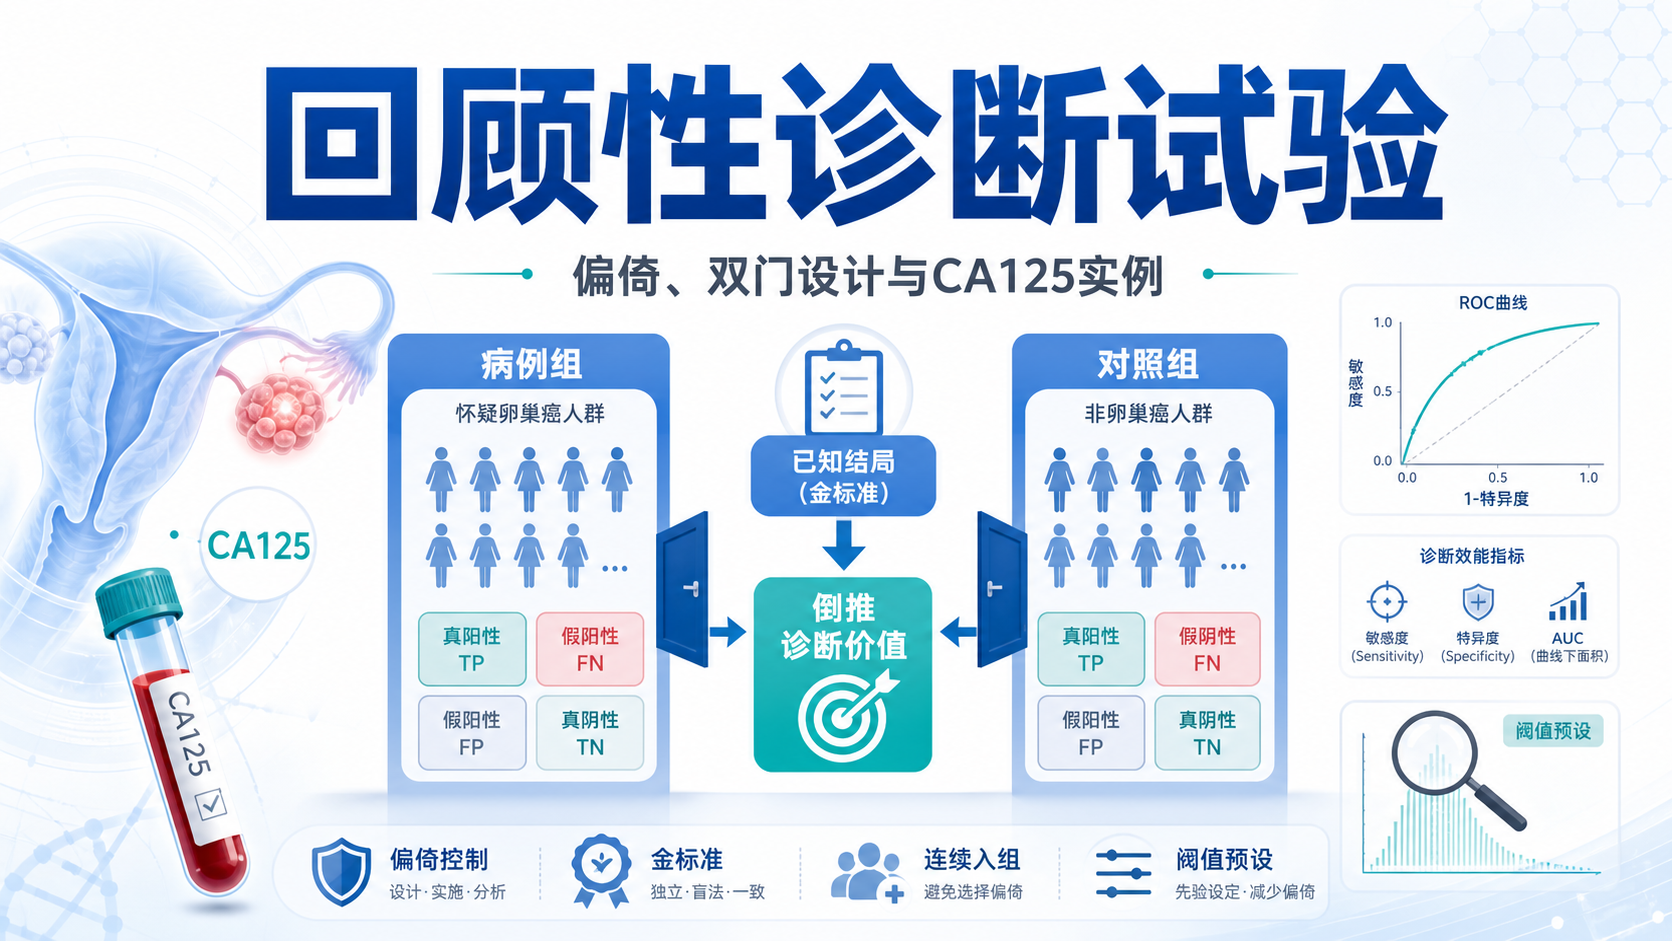
如果对照组过于“干净”,比如只用健康人做对照,就会夸大待评价实验的区分能力。回顾性病例对照设计尤其容易出现这种问题。
更关键的是,不同人群的患病率和疾病谱并不相同。医院门诊、住院病房、社区筛查场景,研究对象的疾病概率差异很大。金标准不仅要准,还要和研究场景匹配。
这就是为什么STARD要求作者明确时间、地点、入组方式和研究对象来源。
2. 金标准选择的基本原则
2.1 优先选择临床公认且可重复的标准
理想的金标准,应尽量满足几个条件。
- 临床公认,具有最高可信度。
- 结果稳定,可重复。
- 判定标准清楚。
- 尽量少受操作者影响。
例如,某些肿瘤的组织病理学检查常被视为重要参考。但即便如此,也要注意病理取材、切片质量和读片一致性问题。没有任何标准是绝对完美的,只有相对更可靠的参照。
2.2 统一金标准,避免验证偏倚
同一研究中,所有受试者应尽可能接受相同的参考标准。
如果部分患者用了病理,部分患者用了影像学,部分患者只是随访观察,就会引入验证偏倚。这样得到的准确性指标通常会被高估或低估。
诊断试验的逻辑不是“谁更方便就用谁”,而是“谁能更一致地代表真值就用谁”。
对于医生和科研人员来说,这一点尤其重要。因为审稿人首先会看:你的金标准是否统一,是否可复核,是否会引发偏移。
2.3 金标准要与临床问题一致
金标准不是孤立存在的。它必须服务于研究目的。
如果研究目的是筛查,金标准应足以回答“是否患病”。
如果研究目的是分层诊断,金标准还要尽量反映疾病分期、分型或严重程度。
因此,金标准选择前,先明确临床问题。
你是想提高敏感度,减少漏诊。还是想提高特异度,减少误诊。不同目标,会影响你如何定义参考标准和纳入人群。
3. 诊断试验设计中,金标准如何落地
3.1 先定义人群,再定义参考标准
高质量诊断试验通常不是先找一个指标,再硬套结论。正确做法是先定义目标人群,再确定参考标准和待评价实验。
建议按以下顺序设计:
- 明确疾病定义和临床场景。
- 制定纳入标准与排除标准。
- 规定index test和reference standard。
- 设定阳性阈值或cut-off。
- 规划盲法流程。
- 预先写明统计方法。
先有人群,后有标准。
这是诊断试验设计的基本逻辑。
3.2 盲法是减少金标准偏移的关键
如果参考标准判读者知道待评价实验结果,或者待评价实验操作者知道金标准结果,就容易出现评价偏移。
STARD强调,index test和reference standard应尽可能独立判读。
在实际研究里,建议至少做到以下两点:
- 评价待测方法者不知道金标准结果。
- 评价金标准者不知道待测方法结果。
双向盲法越充分,研究可信度越高。
尤其是在影像学、病理学、内镜判读中,这一点对结果影响很大。
3.3 对不确定结果要预先规定处理方案
诊断研究中,常会出现“不确定”“可疑”“边界值”结果。
如果不提前说明处理方式,后期很容易产生选择性报告。
可行做法包括:
- 预先设定为阴性。
- 预先设定为阳性。
- 单独作为灰区分析。
- 结合随访或补充检测判定。
不确定结果的处理,必须写在方法学里。
这不仅是规范要求,也是减少事后解释偏差的基础。
4. 常见设计类型中金标准的不同风险
4.1 单门设计更接近真实临床
横断面或前瞻性单门设计,通常是在同一批可疑患者中同时完成待评价实验和金标准。
这种设计更接近临床真实决策过程,也更容易获得可靠的敏感度和特异度。
它的优势在于:
- 人群来源一致。
- 疾病谱更真实。
- 偏倚相对更少。
但缺点也明显。成本更高,组织难度更大。尤其是当金标准本身有创或昂贵时,研究推进并不容易。
4.2 病例对照设计容易高估诊断效能
回顾性病例对照设计,也叫双门设计,常用于早期探索。
它的特点是先找明确病例,再找对照。对照如果过于理想化,就会让待评价实验看起来“特别准”。
病例对照设计常高估诊断效能,这是已知风险。
原因并不复杂。病例和对照差异太大,和真实临床中的灰区患者不一样。研究结果往往更乐观,但外推性较差。
因此,若采用回顾性设计,作者必须在论文中坦诚说明:
- 病例和对照如何选择。
- 是否连续入组。
- 对照是否来自同一临床场景。
- 金标准是否一致。
5. 写作层面如何符合STARD与审稿要求
5.1 标题、摘要和流程图要让研究性质一眼可见
标题中应尽量体现这是诊断准确性研究。
摘要最好采用结构化写法,至少包括目的、方法、结果和结论。
同时,必须有流程图,清楚展示:
- 纳入了多少人。
- 多少人接受了index test。
- 多少人接受了reference standard。
- 有多少人因何原因被排除。
流程图不是装饰。它是审稿人判断研究质量的第一证据。
5.2 方法部分要写清金标准细节
金标准不能只写一个笼统名词。比如只写“以病理为金标准”,通常不够。
还应交代:
- 病理类型或判读依据。
- 由谁判读。
- 是否双人独立评估。
- 是否存在争议仲裁。
- 判定标准是什么。
可重复,是金标准描述的最低要求。
如果别人照着你的方法做不出来,说明方法学信息不完整。
5.3 结果部分要报告95%置信区间
诊断指标不能只报一个点估计。
例如敏感度、特异度、AUC,最好都给出95%置信区间。这样读者才能判断估计值的不确定性。
同时建议呈现配对四格表或完整数据矩阵。
因为对于诊断研究来说,原始分类数据比单独的几个指标更有信息量。
6. 研究者最常犯的三个错误
6.1 把方便当成合理
很多研究的金标准并不是最可靠的,而是最容易做的。
这会直接削弱论文的结论力度。方便不等于正确。
6.2 把对照设得过于理想
只用健康人做对照,往往不能反映临床真实情境。
真正的临床问题,通常是“目标疾病”和“容易混淆的其他疾病”之间的鉴别。
6.3 忽视盲法和一致性
没有盲法,判读容易受先验印象影响。
没有统一标准,不同受试者的真值可能来自不同逻辑。
这两点都会让诊断准确性被高估。
总结Conclusion
诊断试验的质量,首先取决于金标准选择 是否合理。一个好的金标准,应当公认、可重复、与临床问题一致,并尽量避免验证偏倚和评价偏倚。对于医学生、医生和科研人员来说,真正规范的诊断研究,不只是算出敏感度和特异度,更要讲清楚真值如何定义、样本如何入组、盲法如何实施、结果如何报告。
如果你正在准备诊断试验课题、论文或投稿,建议用更系统的工具来校对设计与写作规范。解螺旋可以帮助你从选题、方法设计到论文结构逐步理顺,减少金标准选择不当带来的返工。 让研究更严谨,让投稿更接近目标期刊的要求。
- 引言Introduction
- 1. 金标准为什么是诊断试验的核心
- 2. 金标准选择的基本原则
- 3. 诊断试验设计中,金标准如何落地
- 4. 常见设计类型中金标准的不同风险
- 5. 写作层面如何符合STARD与审稿要求
- 6. 研究者最常犯的三个错误
- 总结Conclusion