31
 分享

引言Introduction
四格表是诊断试验最基础、也最容易出错的部分。很多医学生和科研人员能写出公式,却在真阳性、假阳性、假阴性、真阴性的对应关系上混淆,进而影响敏感度、特异度和预测值的解释。只要四格表列错,后面的所有指标都会失真。 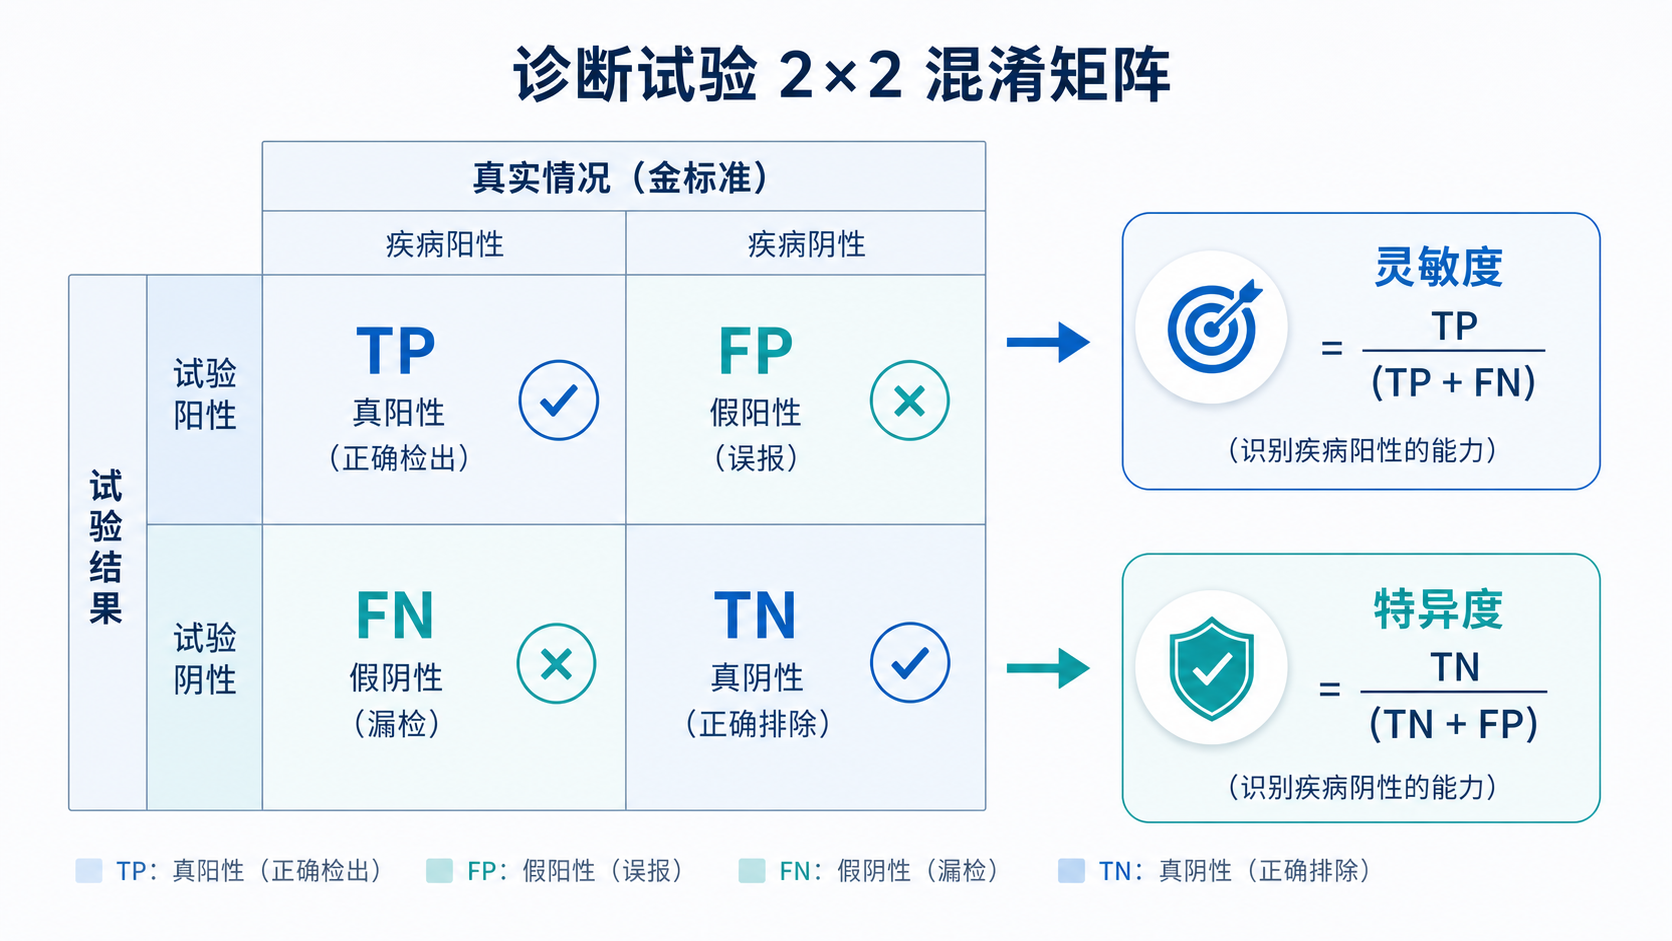
1. 四格表是什么,为什么诊断研究离不开它
1.1 四个格子对应什么
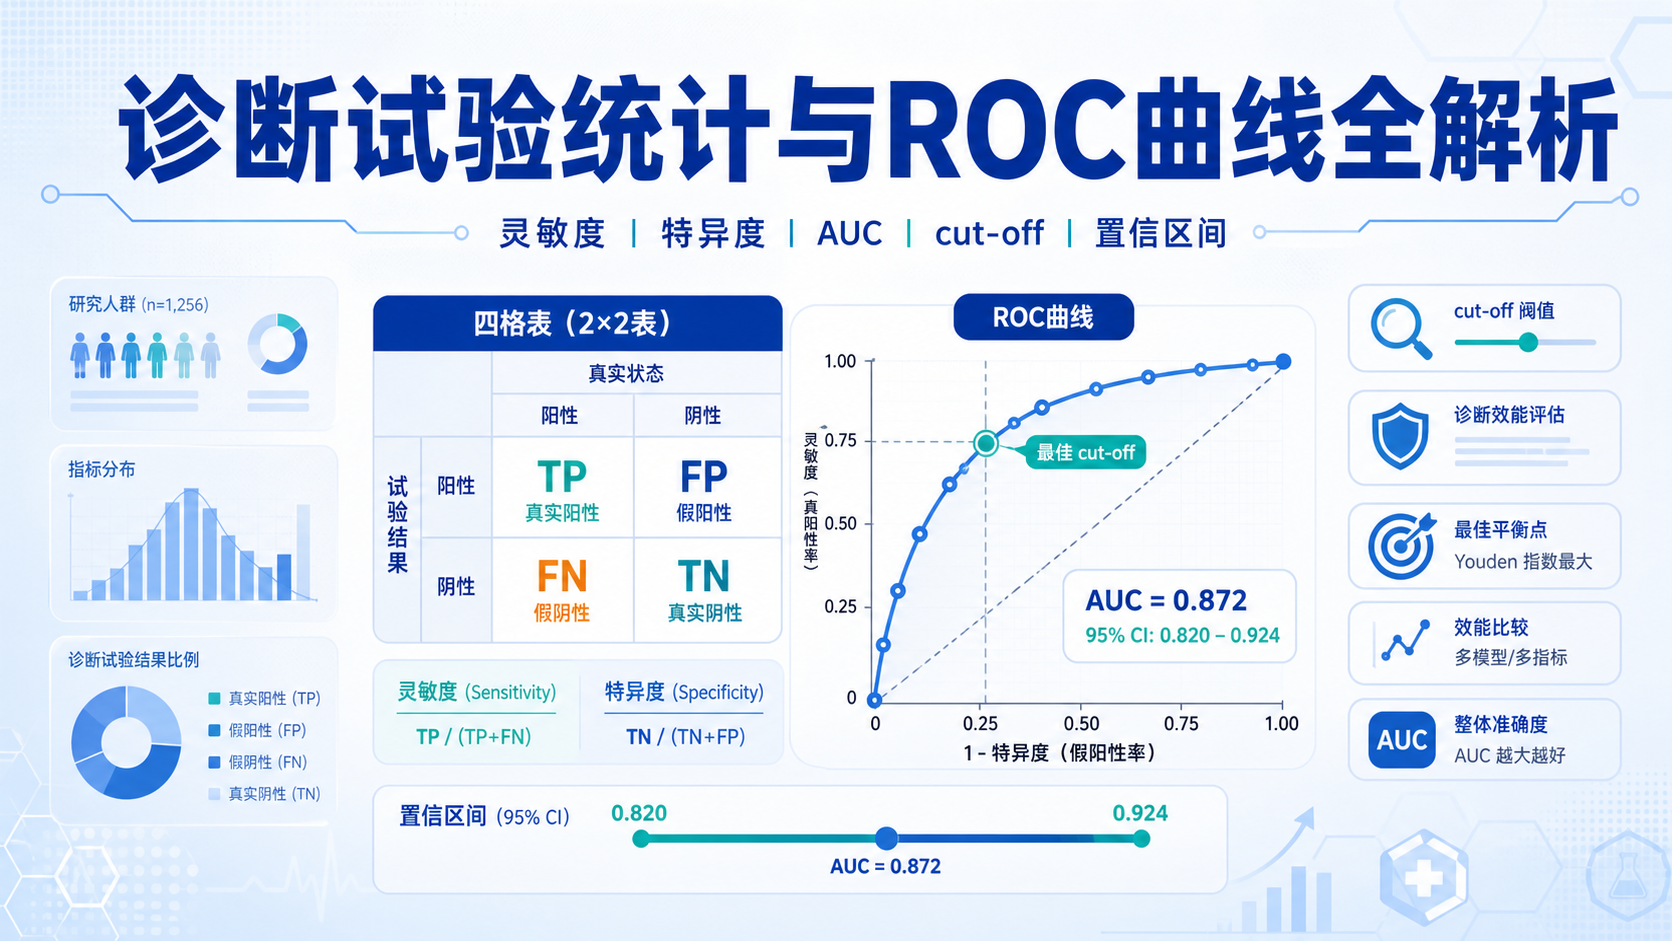
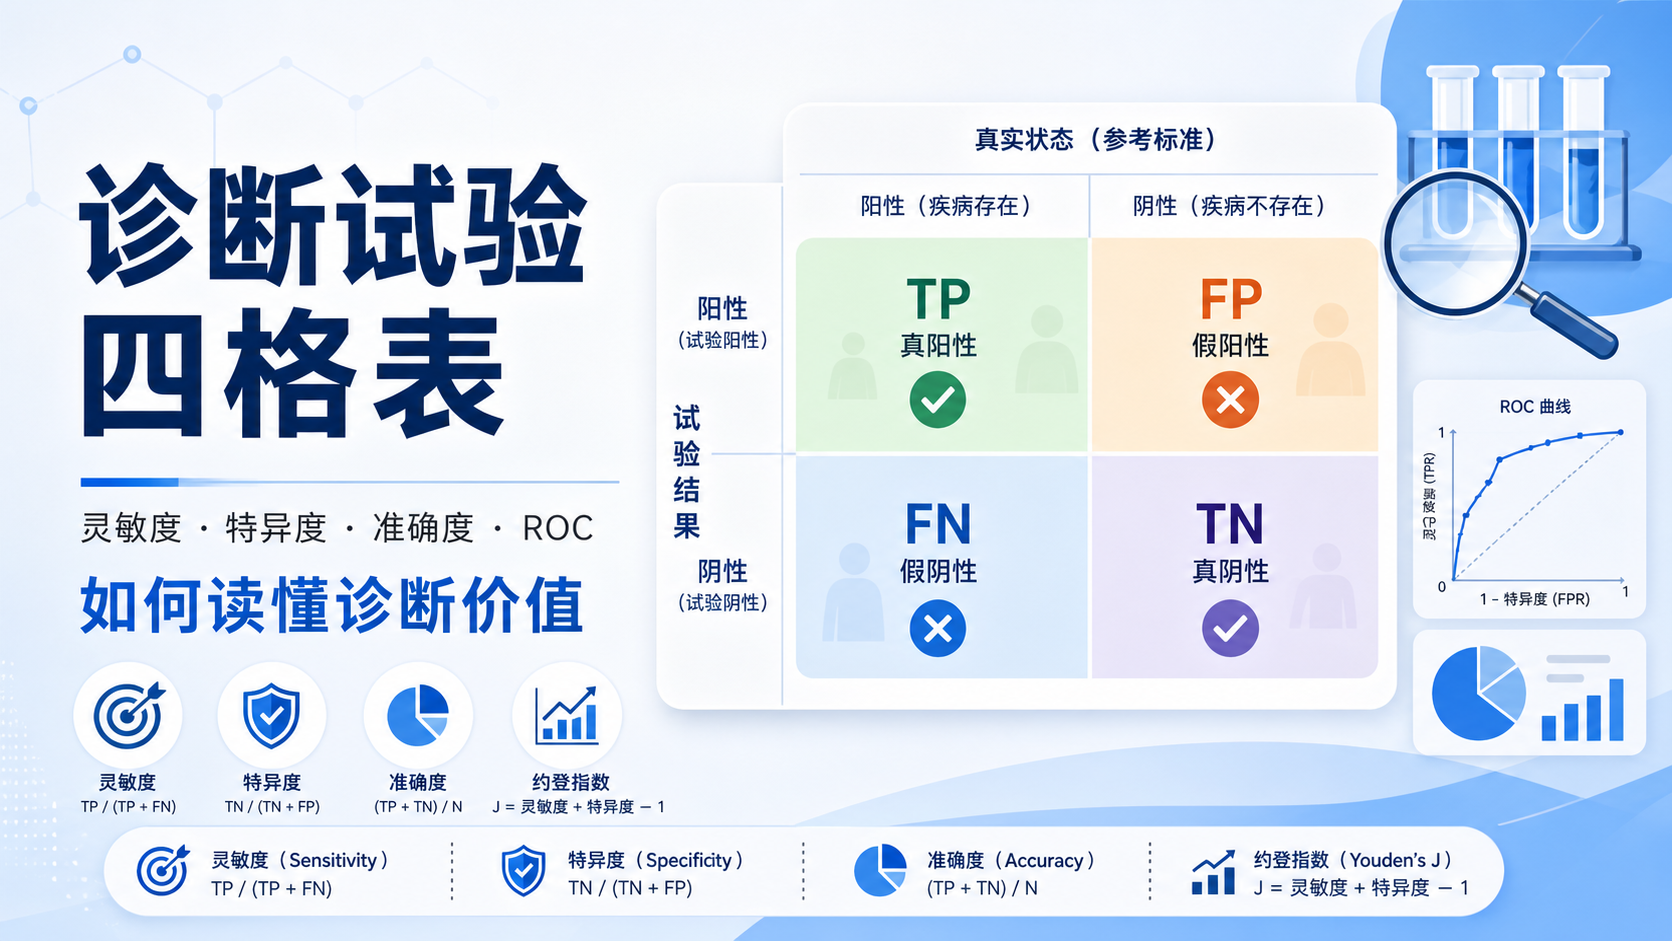
四格表本质上是把“金标准结果”和“待评价方法结果”交叉排列。通常,列放金标准,行放待评价检查 。这样,四个格子的含义就固定了。
常用记法是:
- a,真阳性,TP。
- b,假阳性,FP。
- c,假阴性,FN。
- d,真阴性,TN。
记住一个原则,四格表不是看名字,而是看“金标准”和“检测结果”的交叉位置。 这一步决定了后续公式是否正确。
1.2 为什么它是诊断研究的核心
在诊断准确性研究中,四格表可以直接导出最常见的指标:
- 灵敏度。
- 特异度。
- 阳性预测值。
- 阴性预测值。
- 准确度。
- 阳性似然比。
- 阴性似然比。
这些指标分别回答不同问题。
灵敏度回答“有病的人能检出多少”。
特异度回答“没病的人能排除多少”。
预测值回答“某个检验结果意味着什么”。
临床上最常见的错误,是把灵敏度和预测值混为一谈。 二者分母不同,临床含义也不同。
1.3 先搞清数据结构,再谈统计
如果数据来自病例对照或横断面研究,四格表都能建立。
但如果是连续变量,比如PCT、CA125、血糖,通常还要先确定cut-off值,再转成二分类结果。
如果是二分类检测,比如阳性、阴性,四格表可直接使用。
四格表适合二分类诊断结果,是临床研究中最直接的统计起点。
2. 四格表诊断指标怎么计算
2.1 敏感度和特异度
敏感度是:
敏感度 = a / (a + c)
含义是,在所有真实患病者中,被检测正确识别为阳性的比例。
它反映的是“抓病能力”。
特异度是:
特异度 = d / (b + d)
含义是,在所有真实未患病者中,被检测正确识别为阴性的比例。
它反映的是“排除病能力”。
这两个指标是诊断试验最核心的真实性指标。
敏感度高,不代表特异度一定高。
二者常常存在此消彼长的关系,尤其在调整cut-off值时更明显。
2.2 阳性预测值和阴性预测值
阳性预测值是:
阳性预测值 = a / (a + b)
表示检测阳性的人里,真正患病的比例。
它回答的是“这个阳性结果有多可信”。
阴性预测值是:
阴性预测值 = d / (c + d)
表示检测阴性的人里,真正未患病的比例。
它回答的是“这个阴性结果有多可信”。
需要注意,预测值受患病率影响很大 。
同一个检测,在高患病率人群和低患病率人群中,预测值可能明显不同。
2.3 准确度和似然比
准确度是:
准确度 = (a + d) / (a + b + c + d)
它表示总体判断正确的比例。
但准确度会受患病率影响,在极端不平衡样本中容易被高估。
阳性似然比是:
LR+ = 敏感度 / (1 - 特异度)
它表示检测阳性后,患病概率增加多少。
一般来说,LR+ 越大,阳性结果越有说服力。
阴性似然比是:
LR- = (1 - 敏感度) / 特异度
它表示检测阴性后,患病概率降低多少。
一般来说,LR- 越小,阴性结果越能排除疾病。
在论文写作中,似然比比单独报告敏感度或特异度更完整。
3. 一个四格表实战例子,带你算出所有指标
3.1 例子数据怎么读
假设金标准下,病例100人,非病例100人。
待评价方法结果中,阳性90人,阴性110人。
若整理成四格表,可得到:
- 真阳性 a = 80。
- 假阴性 c = 20。
- 假阳性 b = 10。
- 真阴性 d = 90。
这个例子中,总样本量为200。
四个格子的意义必须和金标准对应,不能只看阳性阴性数量。
3.2 逐项计算
先算灵敏度:
80 / (80 + 20) = 0.80,80%。
再算特异度:
90 / (10 + 90) = 0.90,90%。
阳性预测值:
80 / (80 + 10) = 0.8889,约88.9%。
阴性预测值:
90 / (20 + 90) = 0.8182,约81.8%。
准确度:
(80 + 90) / 200 = 0.85,85%。
如果继续算似然比:
- LR+ = 0.80 / (1 - 0.90) = 8。
- LR- = (1 - 0.80) / 0.90 ≈ 0.22。
这个结果说明,该方法对阳性结果的支持力度较强,对阴性结果也有一定排除价值。
3.3 如何解释这些结果
从临床解释看:
- 灵敏度80%,说明漏诊率为20%。
- 特异度90%,说明误诊率为10%。
- 阳性预测值88.9%,说明阳性结果较可信。
- 阴性预测值81.8%,说明阴性结果也有一定可信度。
但如果患病率改变,预测值会随之变化。
所以论文里不能只写“阳性预测值高”,还要交代研究人群背景。
诊断指标不是孤立存在的,必须放在研究场景里解释。
4. 置信区间、ROC和软件计算,论文里常见但容易漏掉
4.1 为什么要报告95%置信区间
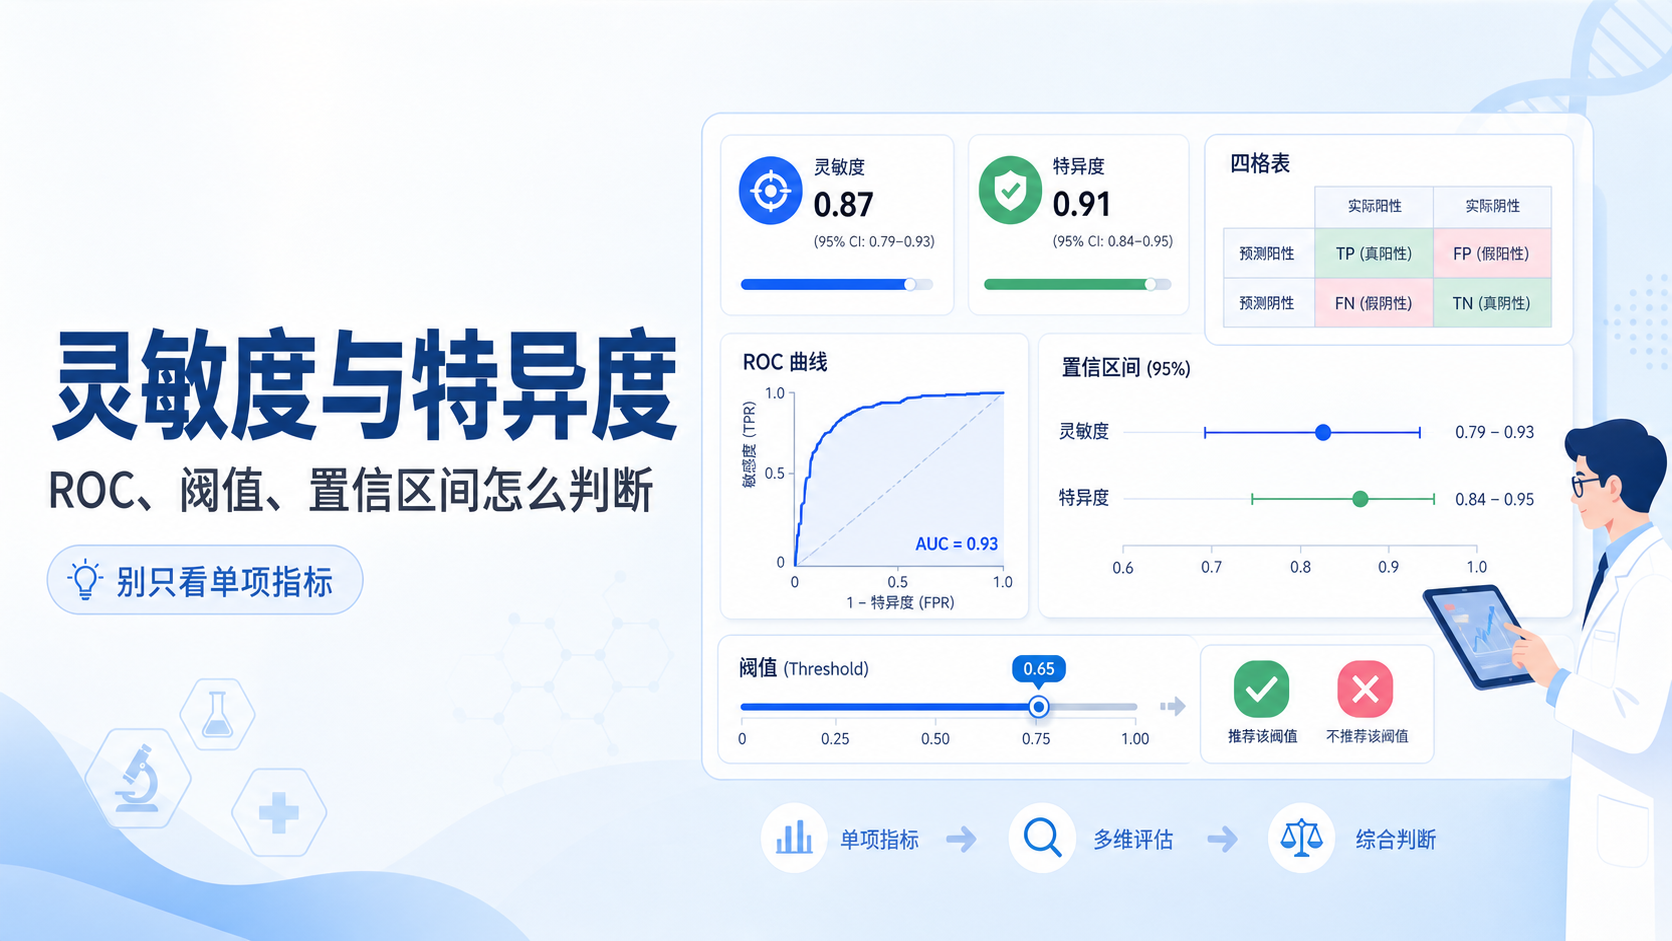
英文文献中,诊断指标常写成“0.80, 95% CI 0.72-0.88”这种形式。
这不是装饰,而是对估计不确定性的表达。
没有置信区间,只给点估计,信息是不完整的。
对于灵敏度、特异度这类比例指标,可以用近似公式或软件计算。
常见做法是根据二项分布估计标准误,再构建95%置信区间。
4.2 连续指标如何处理
如果诊断指标是连续变量,如CA125、PCT、血糖,通常需要ROC分析。
ROC曲线的纵坐标是敏感度,横坐标是1减特异度。
AUC越接近1,区分能力越强。
AUC为0.5,意味着没有明显诊断价值。
连续变量适合ROC,二分类变量适合四格表。
两者并不冲突,而是服务于不同类型的数据。
4.3 软件和工具能解决什么问题
SPSS可以通过交叉表计算灵敏度、特异度、预测值。
但在实际工作中,很多人会卡在数据录入和四格表方向判断上 。
一旦行列放反,所有指标都会错。
因此,实际操作时建议先固定模板,再录入数据。
如果研究需要更完整的诊断指标输出,包括置信区间、似然比和多个评价参数,使用经过验证的统计工具更高效。
5. 写论文时最容易踩的坑
5.1 四格表方向错了
这是最常见的错误。
一定先确认:
- 金标准是什么。
- 待评价方法是什么。
- a、b、c、d分别对应哪一个象限。
只要四格表方向错,所有结果都不能用。
5.2 只报一个指标
只报灵敏度不够。
只报特异度也不够。
至少应同时报告灵敏度、特异度、预测值,必要时加AUC和95%置信区间。
5.3 忽视患病率
预测值和患病率高度相关。
在筛查研究里,这一点尤其重要。
高危人群和普通人群,结果解释不能完全一样。
5.4 混淆诊断研究和筛查研究
诊断研究关注“是否有病”。
筛查研究关注“能否提前发现”。
如果研究设计不同,统计解释和临床价值也不同。
总结Conclusion
四格表是诊断试验分析的基础。
掌握a、b、c、d的对应关系后,就能准确计算灵敏度、特异度、预测值、准确度和似然比。真正难的不是公式,而是数据结构和临床解释。 对医学生、医生和科研人员来说,先把四格表做对,再谈统计报告,才是规范路径。
如果你希望把四格表指标计算、ROC分析、95%置信区间和论文结果表一次性做规范,建议借助成熟工具提高效率。解螺旋 可帮助你更系统地完成诊断研究的数据整理、结果输出和论文写作,减少低级错误,让研究表达更专业。
- 引言Introduction
- 1. 四格表是什么,为什么诊断研究离不开它
- 2. 四格表诊断指标怎么计算
- 3. 一个四格表实战例子,带你算出所有指标
- 4. 置信区间、ROC和软件计算,论文里常见但容易漏掉
- 5. 写论文时最容易踩的坑
- 总结Conclusion