33
 分享
引言Introduction
诊断试验里,很多人会先问灵敏度和特异度是多少,却忽略了二者如何权衡、如何计算、如何报告。如果只看单个指标,很容易高估检测方法的真实价值。 对医学生、医生和科研人员来说,真正重要的是把四格表、置信区间、ROC 和 cut-off 串起来理解。

1. 诊断试验中最基础的统计框架
1.1 四格表是所有指标的起点
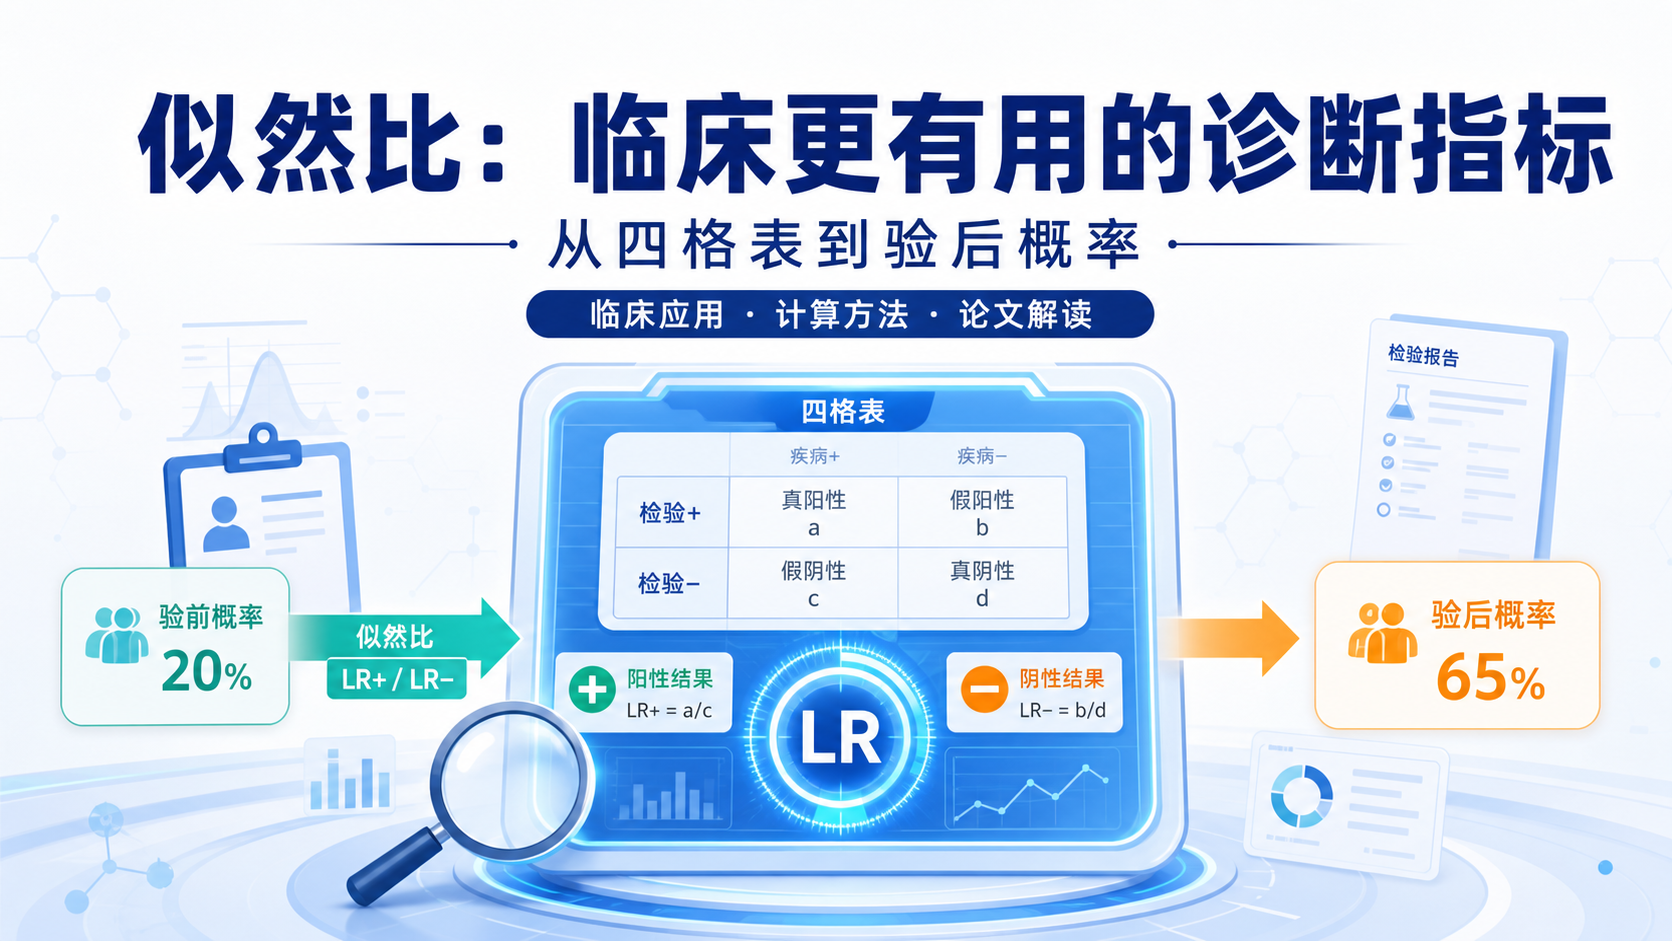
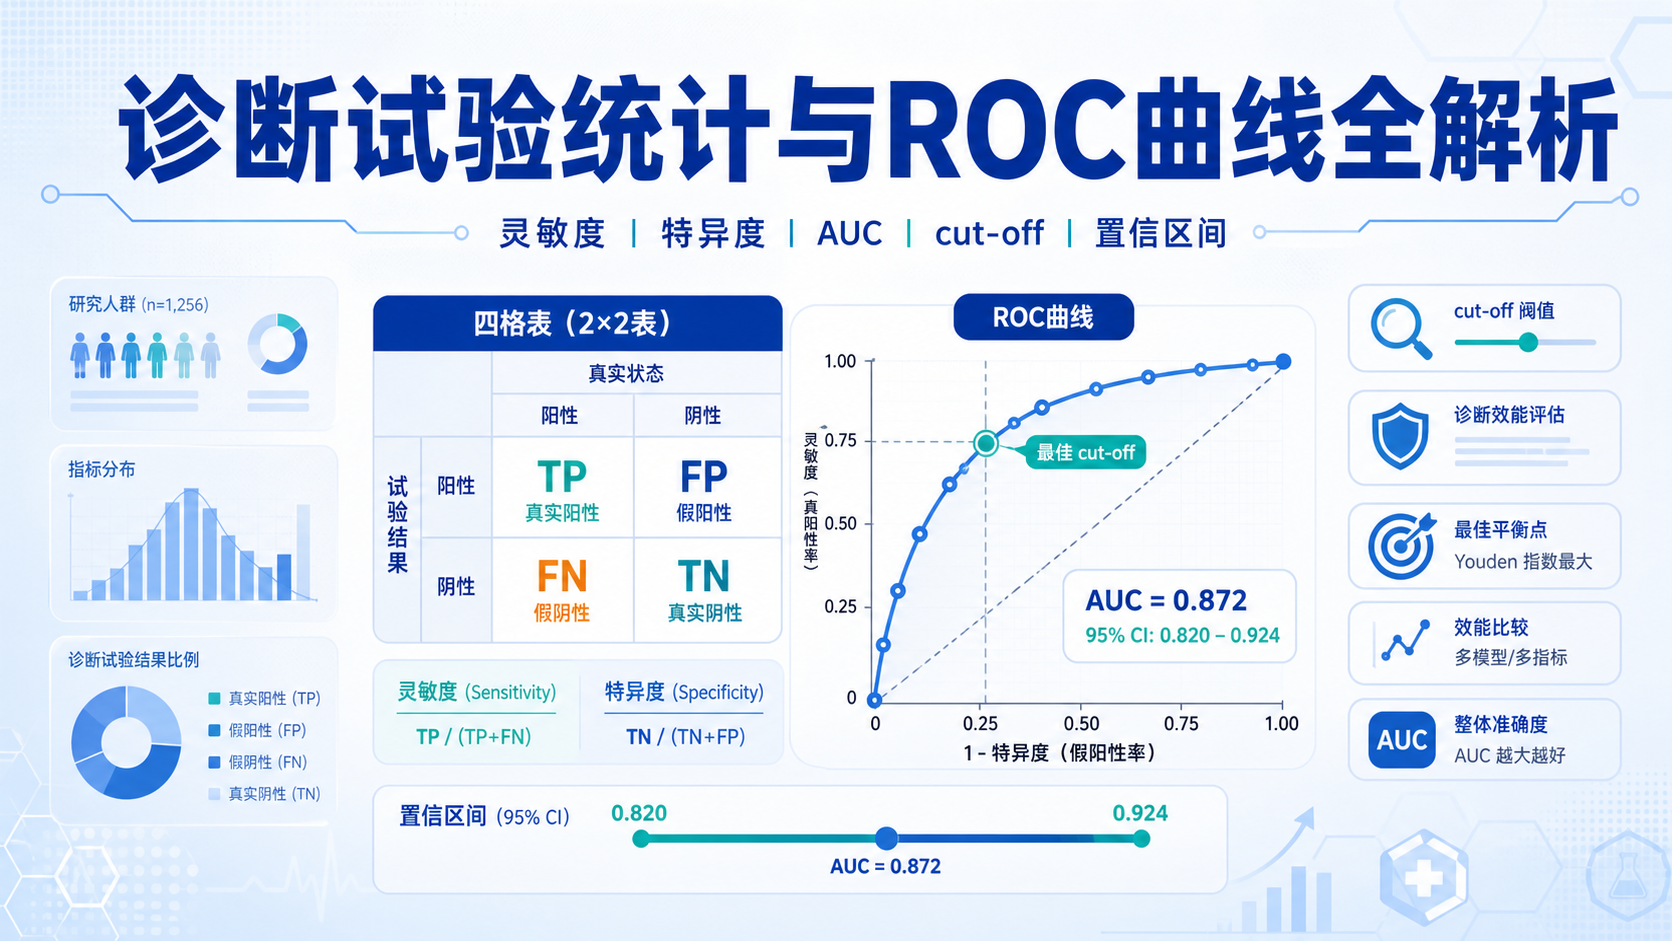
诊断准确性研究最常见的结果形式,是四格表。它把研究对象按“金标准结果”和“待评价方法结果”交叉分类。对应关系很固定。
- a,真阳性,TP。
- b,假阳性,FP。
- c,假阴性,FN。
- d,真阴性,TN。
灵敏度、特异度、阳性预测值和阴性预测值,都来自这个四格表。
这也是为什么在读文献时,先看分组是否清楚、金标准是否可靠,非常关键。
1.2 指标分别回答什么问题
四个常用指标,回答的是不同临床问题。
- 灵敏度,回答“有病的人能检出多少”。
- 特异度,回答“没病的人能排除多少”。
- 阳性预测值,回答“检测阳性的人真正患病的概率”。
- 阴性预测值,回答“检测阴性的人真正无病的概率”。
灵敏度和特异度反映的是检测方法本身的区分能力。
预测值则会受患病率影响。人群不同,预测值常常不同。这个差异在筛查研究中尤其明显。
1.3 行列顺序不能乱
在标准四格表中,待评价方法通常放在行,金标准放在列。这样排列后,a、b、c、d 的位置才不会错。
如果行列颠倒,后续计算灵敏度和特异度时,就可能出现方向性错误。
对科研写作来说,最常见的问题不是不会算,而是把真阳性、假阳性、真阴性、假阴性的对应关系搞反。
这会直接导致结论错误。
2. 灵敏度和特异度关系的本质
2.1 它们不是独立变量
在同一个检测方法里,灵敏度和特异度并不是互不相关的。它们受 cut-off 值影响,而且通常是此消彼长。
- cut-off 降低,灵敏度通常上升,特异度通常下降。
- cut-off 升高,特异度通常上升,灵敏度通常下降。
这就是灵敏度特异度关系最核心的临床逻辑。
它决定了你是在“尽量少漏诊”,还是在“尽量少误诊”。
2.2 不同临床场景,优先级不同
不同疾病和不同用途,对两者的偏好不一样。
- 筛查场景,通常更看重灵敏度。
- 确诊场景,通常更看重特异度。
- 高风险、低容错疾病,需要更稳妥的平衡。
例如,肿瘤筛查中,漏诊代价往往更高,因此会倾向提高灵敏度。
但在侵入性检查前,误诊代价高时,特异度又更重要。
临床上不是追求一个“绝对更高”的数字,而是追求“更符合场景”的组合。
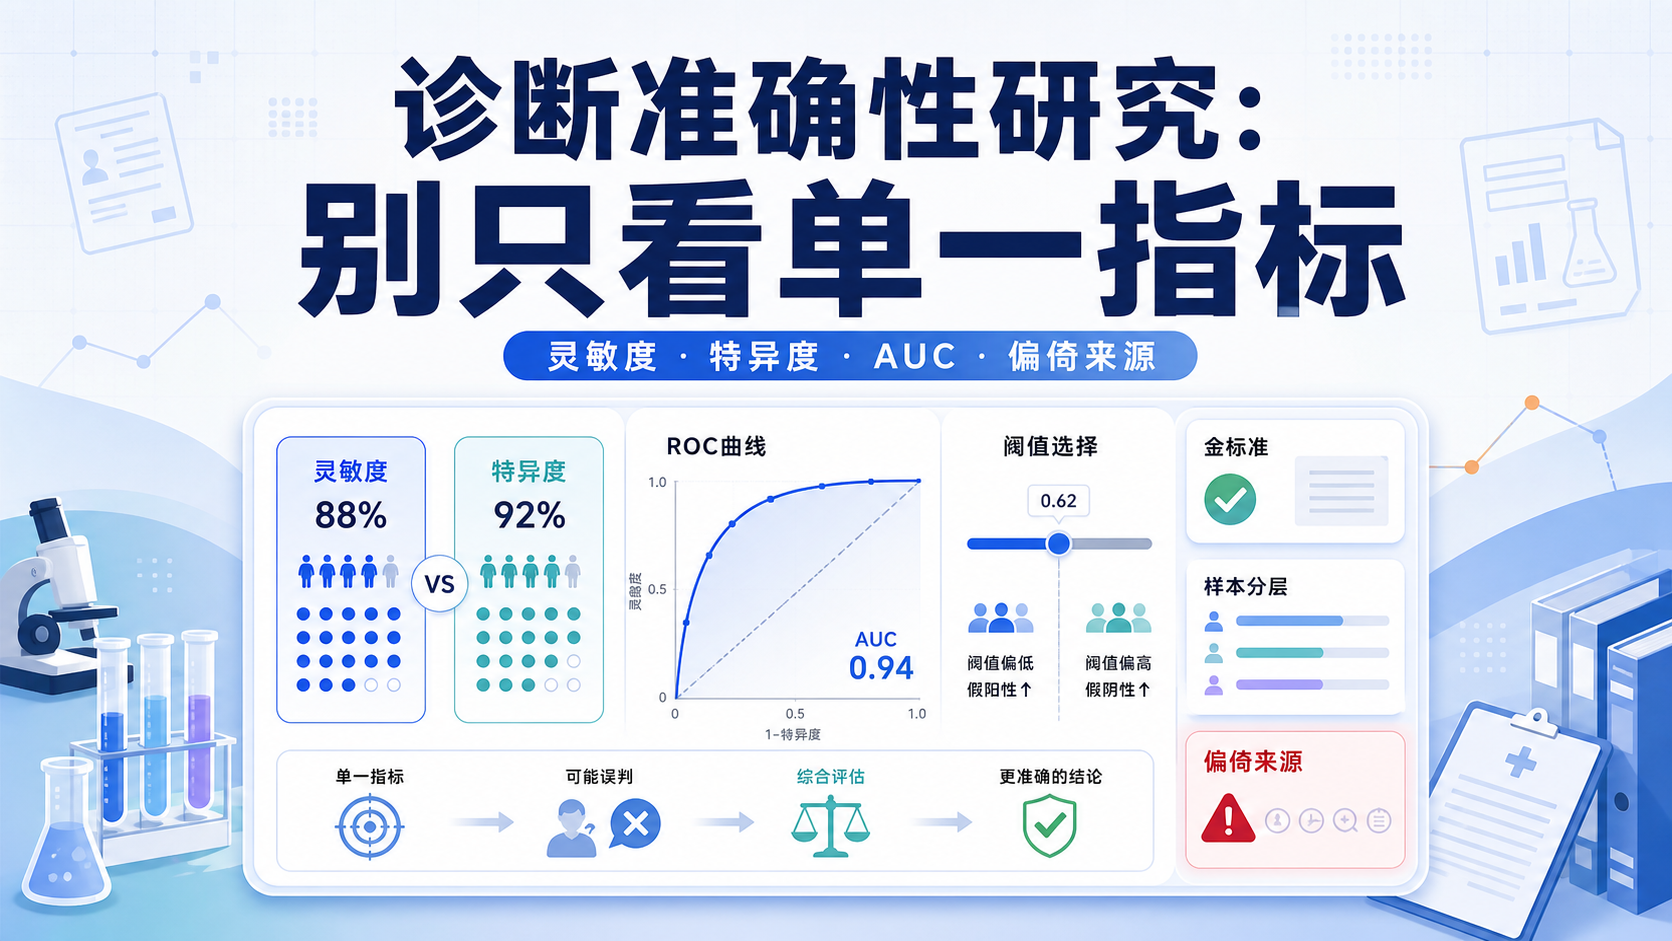
2.3 不能只拿一个指标判断方法优劣
很多研究会出现这样的误区。
A 方法灵敏度高一点,B 方法特异度高一点,最终不知道哪个更好。
这时不能只凭单项指标下结论。应该结合:
- 患病率。
- 检查目的。
- 误诊和漏诊的代价。
- 置信区间。
- ROC/AUC。
真正有临床意义的评价,不是看某一个百分比,而是看整体表现。
3. 指标怎么计算,怎么报告
3.1 基本公式要先掌握
四格表中,核心计算公式如下。
- 灵敏度 = a / (a + c)
- 特异度 = d / (b + d)
- 阳性预测值 = a / (a + b)
- 阴性预测值 = d / (c + d)
- 准确度 = (a + d) / n
这些公式在论文写作、结果解读、统计复核中都必须熟悉。
它们是诊断试验统计分析的底层语言。
3.2 置信区间比单点估计更重要
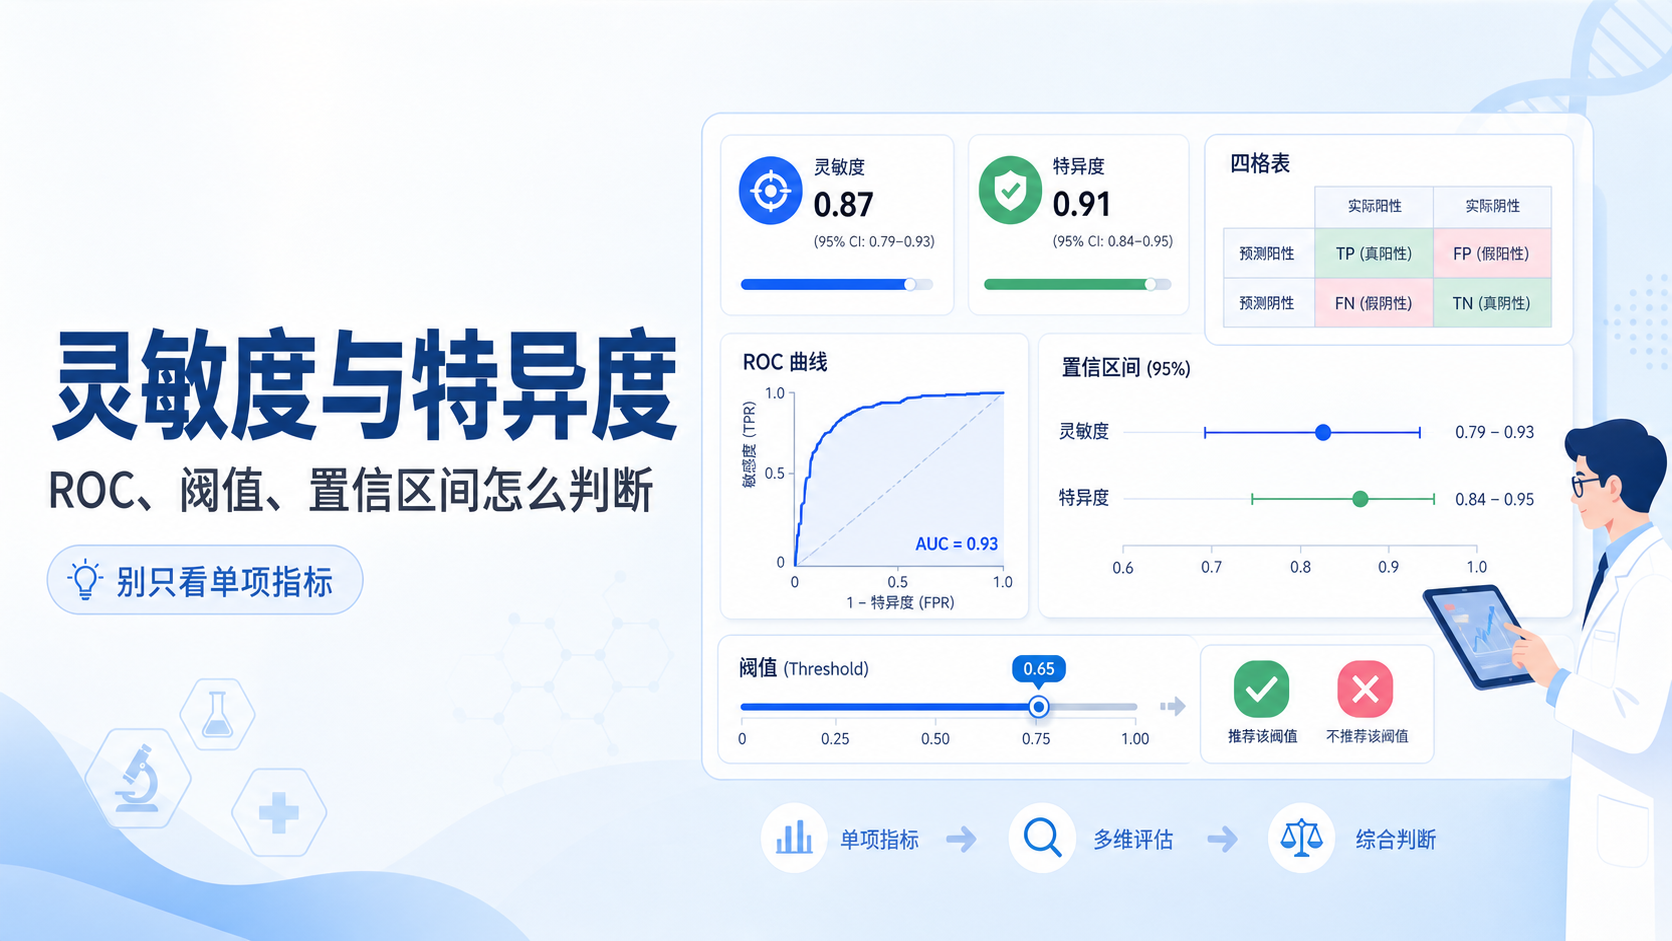
英文文献里,常见写法不是只报一个灵敏度或特异度,而是同时报告 95% 置信区间。
这是因为单点估计会受样本波动影响。置信区间能反映不确定性。
例如:
- 灵敏度 0.80,95%CI 0.72-0.88。
- 特异度 0.90,95%CI 0.81-0.94。
没有置信区间,结果的稳健性就不完整。
尤其在样本量较小、病例数有限时,这一点更重要。
3.3 近似计算与软件计算
灵敏度和特异度的置信区间,可以用近似公式,也可以借助统计软件或专业网站。
近似法常基于正态分布假设,先算标准误,再用 1.96 倍标准误构建 95%CI。
但要注意,不同方法的区间可能并不完全一致。
原因在于其背后的统计原理不同。
写论文时,关键不是“用了哪种工具”,而是“方法是否交代清楚”。
4. ROC 曲线如何帮助选择最佳 cut-off
4.1 ROC 的核心作用
ROC 曲线用于展示不同 cut-off 下,灵敏度与特异度的整体变化。
横坐标是一减特异度,纵坐标是灵敏度。
它的价值在于,把单个阈值问题变成整条曲线问题。
这样就能比较不同检测方法的区分能力。
AUC 是 ROC 中最常用的综合指标。
AUC 越大,说明整体区分能力越强。
4.2 AUC 怎么看才合理
一般可以这样理解。
- AUC = 0.5,接近随机判断。
- 0.5-0.7,区分能力有限。
- 0.7-0.9,中等诊断价值。
- 0.9 以上,通常提示较高诊断价值。
这只是经验性分层,不是绝对标准。
最终仍要结合疾病背景和临床用途判断。
4.3 最佳 cut-off 的常见思路
临床和科研中,常用“灵敏度加特异度最大”的点来选最佳 cut-off。
也就是找 ROC 上最接近左上角的点。
这个思路的优点是简单、直观,能兼顾两类错误。
但它并不总是最适合所有研究。
在某些高危疾病筛查里,研究者可能更偏向灵敏度优先。
在确认性诊断里,则可能更偏向特异度优先。
所以,最佳 cut-off 不是数学上唯一正确的答案,而是与临床目标匹配的答案。
5. 从结果到论文,常见质控点有哪些
5.1 研究设计先于统计分析
诊断试验的质量,首先由设计决定。
常见设计包括横断面设计、病例对照设计,以及某些筛查场景中的队列设计。
其中,病例对照设计更容易引入偏倚。
因为病例和对照的来源、病情谱、病程阶段可能与真实临床场景不同。
如果研究设计本身有偏差,后面的灵敏度、特异度再漂亮,也未必能外推到临床。
5.2 样本和金标准决定可信度
几个关键点必须确认:
- 金标准是否可靠。
- 受试者是否连续入组。
- 是否存在选择偏倚。
- 检测者是否盲法判读。
- 病例与对照是否来自同一临床谱。
这些因素会影响结果真实性。
很多诊断指标看似不错,实际只是样本选择偏倚造成的高估。
5.3 论文中建议同时报告这些内容
诊断准确性研究,建议至少报告:
- 四格表原始数据。
- 灵敏度、特异度。
- 阳性预测值、阴性预测值。
- 95%置信区间。
- ROC 和 AUC。
- 最佳 cut-off 及其依据。
这样报告,读者才能判断结果是否可复现、是否可推广。
5.4 用专业工具提升结果整理效率
如果你正在做诊断试验、整理四格表、计算置信区间或绘制 ROC,建议使用成熟工具提高效率。
例如,解螺旋可以帮助你更高效地完成数据分析、结果规范化和论文写作框架整理,减少公式抄错、表格排错和指标解读偏差的风险。
把重复劳动交给工具,把精力留给临床问题和研究设计。
总结Conclusion
灵敏度、特异度不是孤立的数字。它们来自四格表,受 cut-off 影响,也受临床场景影响。理解灵敏度特异度关系,才能真正把数据转化为临床决策。
写诊断试验时,建议同时关注四格表、置信区间、ROC/AUC 和研究设计质量。这样才能避免“看起来很好,实际上不能用”的结果。
如果你正在做诊断准确性研究,想更高效地完成数据分析、结果呈现和论文写作,不妨进一步了解解螺旋。
- 引言Introduction
- 1. 诊断试验中最基础的统计框架
- 2. 灵敏度和特异度关系的本质
- 3. 指标怎么计算,怎么报告
- 4. ROC 曲线如何帮助选择最佳 cut-off
- 5. 从结果到论文,常见质控点有哪些
- 总结Conclusion