65
 分享
全文概要
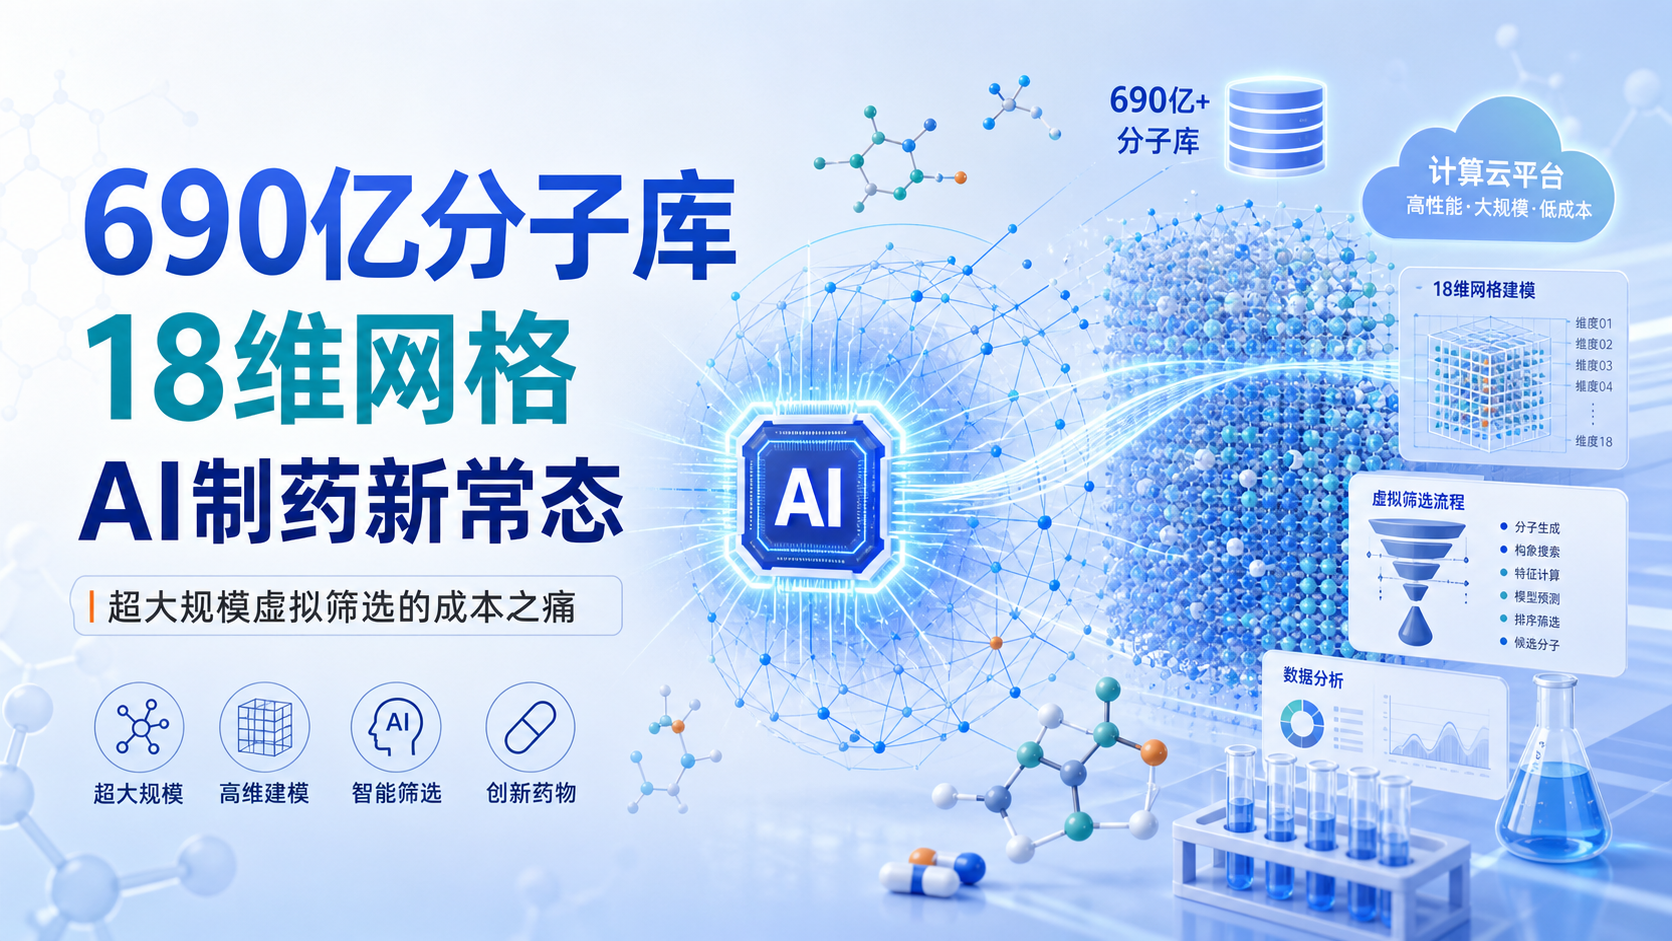
9 月 1 日,圣裘德儿童研究医院、哈佛大学、Dana-Farber 癌症研究所、斯坦福大学、昆士兰大学等机构的研究人员在《自然·生物技术》(Nature Biotechnology)发表 AdaptiveFlow 开源平台,能够以现有方法约 1/1000 的计算成本,对数百亿种类药分子进行虚拟筛选,并成功识别出 FSP1、PARP1 的纳摩尔级抑制剂。该平台被视为"新一代自动化药物发现"的代表,有望让超大规模虚拟筛选走向常规化。

1. 超大规模虚拟筛选的"成本之痛"
超大规模虚拟筛选(ULVS)是 AI 药物研发的重要工具,理论上可评估数十亿种分子,从海量化学空间中"捞"出候选先导化合物。然而,高昂的计算成本、有限的灵活性与可扩展性,长期限制了这一技术的大规模普及,使其更多停留在大型药企或少数顶尖实验室的能力范围内。
AdaptiveFlow 的核心突破,正在于"效率、经济性与可及性"。研究团队宣称,该平台能以现有方法 1/1000 的成本完成同等规模的筛选,且即使在数百万虚拟 CPU 上运行,仍能保持近乎完美的线性扩展——这一特性解决了传统软件在 CPU 数量激增时"沟通效率骤降"的顽疾。
2. "18 维网格"背后的设计哲学
AdaptiveFlow 的技术核心是一个 18 维网格,每个维度代表一种分子属性(如分子量、电荷、卤原子数目等)。这一框架使研究者能够优先筛选化学多样性高的分子,并理性地选择有前景的分子库子集进行更深入的筛选,而非无差别地"暴力扫库"。
研究团队将平台应用于两个具有治疗意义的靶点进行验证:FSP1(调控铁死亡、在癌症耐药中崭露头角)与 PARP1(肿瘤学中公认的 DNA 修复酶与临床靶点)。结果显示,AdaptiveFlow 成功识别出纳摩尔级抑制剂,并通过高分辨率共晶结构完成了实验验证,证实抑制剂与靶蛋白的有效结合。
3. 690 亿分子库与 AI 制药"新常态"
据研究团队介绍,借助 AdaptiveFlow,可筛选多达 690 亿种分子,构成"全球规模最大的即用型对接分子库"。这一数字意味着,超大规模虚拟筛选正在从"少数机构的特有能力"走向"可常规开展的基础设施"。
对医学科研工作者与药企而言,AdaptiveFlow 的意义在于显著降低了"从靶点到先导化合物"的门槛:计算成本的断崖式下降,让中小型团队也有机会参与大规模虚拟筛选,进而加速早期药物发现进程。当然,“算得快"不等于"选得准”,平台的最终价值仍需在更多靶点与真实药物管线中接受检验,但其在效率与可及性上的突破,无疑为 AI 制药的普惠化铺平了道路。
来源:Nature Biotechnology、生物世界
声明:本文资讯来源于公开报道及学术期刊,仅作行业信息传播,不构成临床用药建议。转载需注明来源。
- 1. 超大规模虚拟筛选的"成本之痛"
- 2. "18 维网格"背后的设计哲学
- 3. 690 亿分子库与 AI 制药"新常态"