21
 分享
引言Introduction
临床研究里,很多人不是不会做统计,而是不知道先做什么、后做什么。结果是软件会了,方法选错了,结论也解释不清。真正的难点,不是公式,而是统计思维。

1. 先建立“统计思维”,再谈软件操作
1.1 统计学不是数学竞赛
很多初学者一看到公式就退缩,误以为统计学必须先学高等数学。其实,对临床医生和硕博生来说,重点不是推导公式,而是会应用。统计学是应用数学,核心任务是把临床问题转化为可分析的数据问题。
你需要掌握的,主要是四件事。
- 数据怎么收集。
- 用什么方法分析。
- 在软件里怎么实现。
- 结果如何回到临床解释。
如果这四步打通,论文写作和课题设计都会顺很多。
1.2 软件不是统计本身
很多人把SPSS、R、Stata当成统计学本身,这是常见误区。软件只是工具。如果不知道方法适用范围,学会菜单操作也可能得到错误结论。
例如,同样是比较两组差异,数据类型不同,方法就不同。计量资料、计数资料、配对资料、重复测量资料,不能混用检验。先理解数据结构,再选软件操作路径,效率会高很多。
对于初学者,SPSS更适合入门,因为菜单式操作清晰。若希望后期提升效率和绘图能力,R更值得投入。临床试验或申报场景中,SAS仍有不可替代的地位。软件选择应服务于研究目标,而不是反过来。
2. 研究设计决定统计方法,不能倒推
2.1 先定问题,再定设计
临床研究最常见的问题是,数据都采完了,才开始想用什么统计方法。这种顺序是反的。正确逻辑应当是:临床需求决定科研方向,科研方向决定实验设计,实验设计再决定统计方法。
这一步非常关键。因为不同设计对应不同分析框架。
- 随机对照研究,强调组间均衡。
- 队列研究,强调暴露与结局。
- 横断面研究,强调某一时点的关联。
- 配对设计,强调同一对象前后对照。
- 重复测量设计,强调时间或条件变化。
如果设计不清楚,后面的统计分析几乎一定会混乱。
2.2 统计设计要前置到方案阶段
很多硕博生写课题时,只写研究对象和观察指标,不写统计设计。这样很容易在答辩或返修时被追问。统计设计必须和实验设计同步完成。
建议在方案阶段就明确以下内容。
- 样本来源和纳入排除标准。
- 主要终点和次要终点。
- 变量类型和数据表达方式。
- 统计方法和显著性标准。
- 缺失值和异常值处理策略。
这样做的好处很直接。后续无论是做临床统计,还是写方法学部分,都不会临时补洞。
3. 高效分析的核心,是把流程标准化
3.1 用“问题导向”建立分析路径
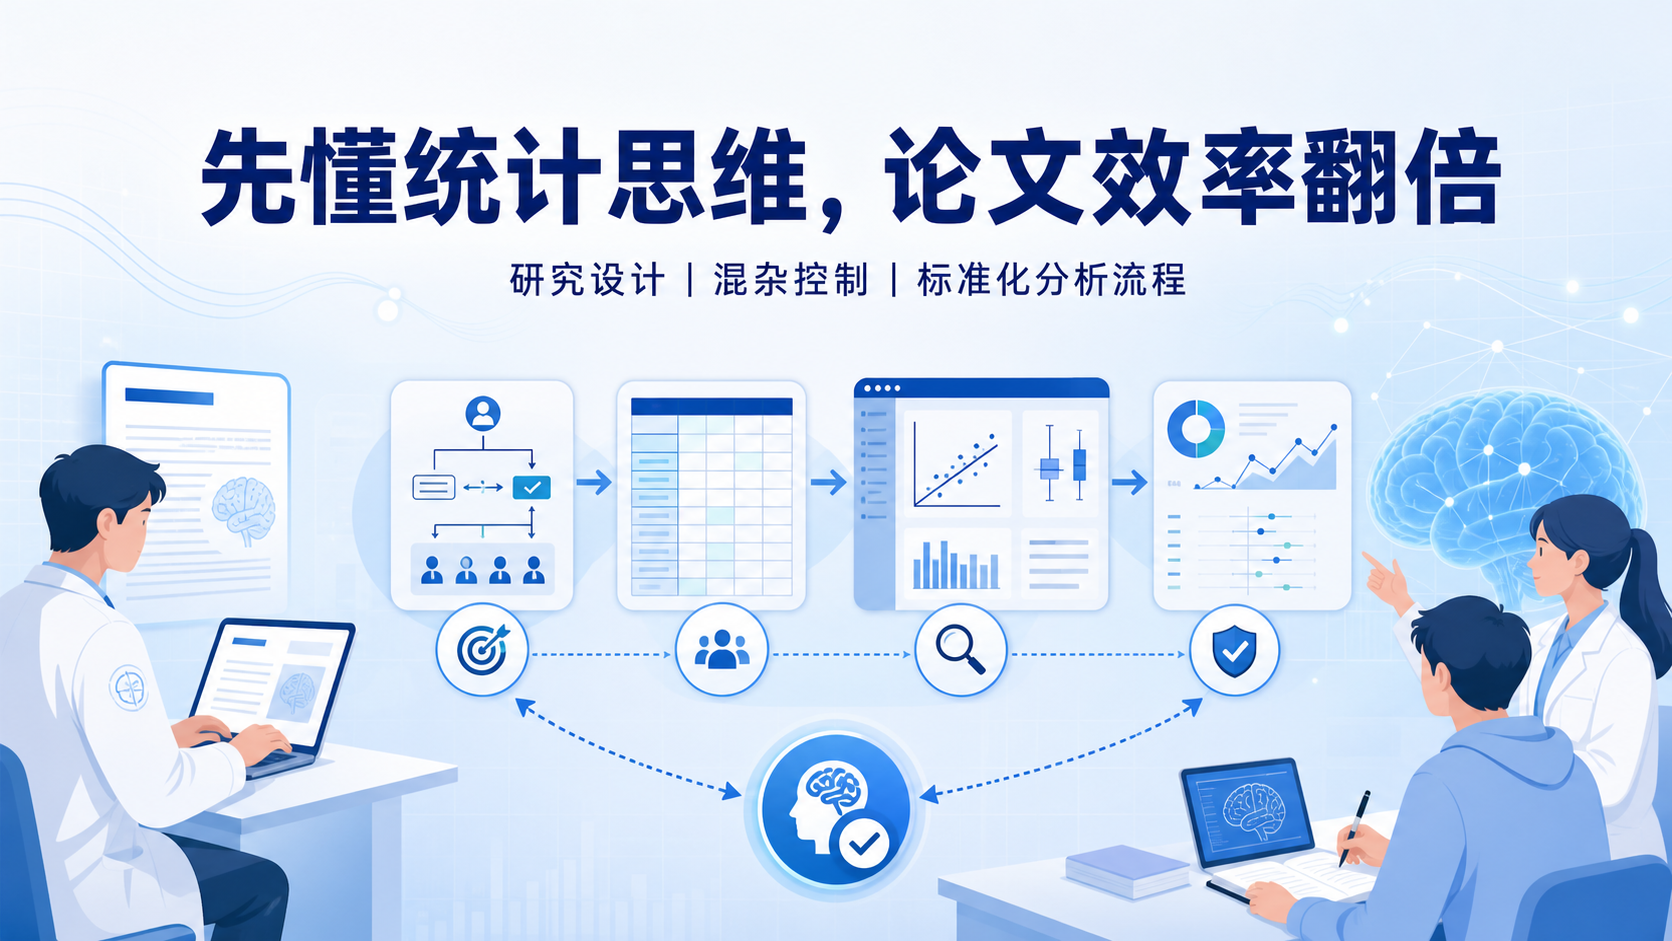
对临床医生和硕博生来说,最有效的统计学习方式不是背概念,而是按问题推进。可以把流程简化成四步。
- 第一步,按实验设计收集数据。
- 第二步,选择合适的统计方法。
- 第三步,用软件完成分析。
- 第四步,把统计结果翻译成临床语言。
统计结果不能直接照搬到论文里,必须解释它意味着什么。
比如P值只说明差异是否具有统计学意义,还要结合效应量、置信区间和临床意义一起看。
3.2 常见分析要关注“数据类型”
效率统计的关键,不是做得多,而是做得准。不同数据类型对应不同方法,这是最基础也最容易出错的部分。
常见情况包括:
- 计量资料,先看正态性和方差齐性。
- 计数资料,关注构成比和率。
- 生存资料,关注删失和随访时间。
- 多因素资料,关注混杂控制。
- 时间序列或重复测量,关注相关性。
只要数据类型判断错了,后面的结论就可能不成立。
这也是为什么在正式建模前,先做描述性统计、分布检查和变量梳理非常重要。
4. 医学生、医生、硕博生最需要的,是统计推断与混杂控制
4.1 不要只看“有效率”
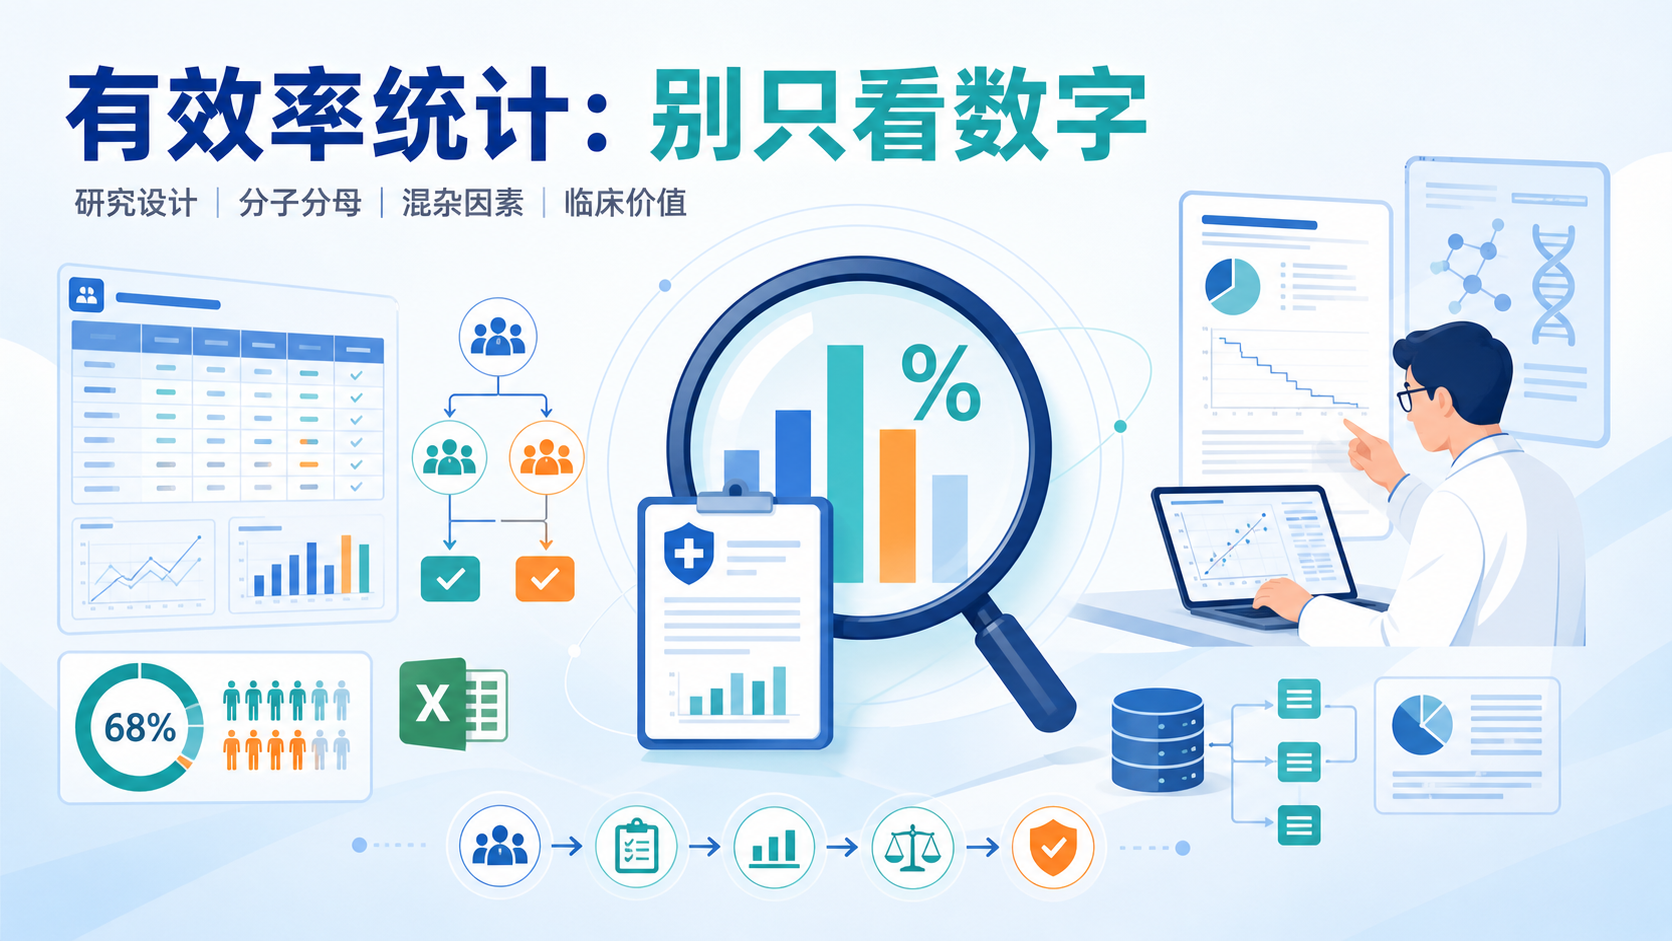
在生物医学研究里,很多人习惯用一个简单比例下结论。比如某治疗组有效率更高,就认为疗效更好。其实不够。显效率统计不能替代统计推断。
你需要回答的是,观察到的差异是随机波动,还是确实存在组间差异。
这就要结合假设检验、P值和置信区间来判断。单纯看“高一点”或“低一点”,都不严谨。
4.2 观察性研究尤其要控制混杂因素
随机对照试验可以在一定程度上平衡混杂因素,但观察性研究做不到。比如年龄、性别、病程、基础疾病,都可能影响结局。如果不控制混杂因素,关联可能是假的。
常见控制方法有:
- 限制。
- 配对。
- 分层。
- 多因素分析。
其中,多因素分析最常用于临床回顾性研究和队列研究。它的核心目标不是“让结果变显著”,而是尽量剥离其他变量的干扰,让主效应更可信。
辛普森悖论就是典型例子。总体趋势和分层趋势可能相反。这说明,统计分析不能只看总表,还要看分层和结构。
5. 提升论文效率,关键在于分析链条完整
5.1 从数据到结论,必须形成闭环
很多文章的问题不在于数据少,而在于链条断。高效的生物医学效率统计,应该尽量形成“问题-数据-方法-结果-解释”的闭环。
可以按以下顺序推进。
- 明确研究问题。
- 确定研究设计。
- 定义变量与终点。
- 收集并清洗数据。
- 选择统计方法。
- 完成结果解释。
- 反推讨论部分逻辑。
这样写出来的论文,结构会更稳定,也更容易通过审稿。
5.2 对硕博生来说,先会用,再深入理解
对大多数临床学习者来说,不需要一开始就掌握所有统计理论。更合理的路径是先掌握常用方法,再逐步理解原理。能独立完成数据整理、方法选择、结果解释,已经足够支撑大量科研场景。
建议优先掌握这些内容:
- 正态性检验和方差齐性检验。
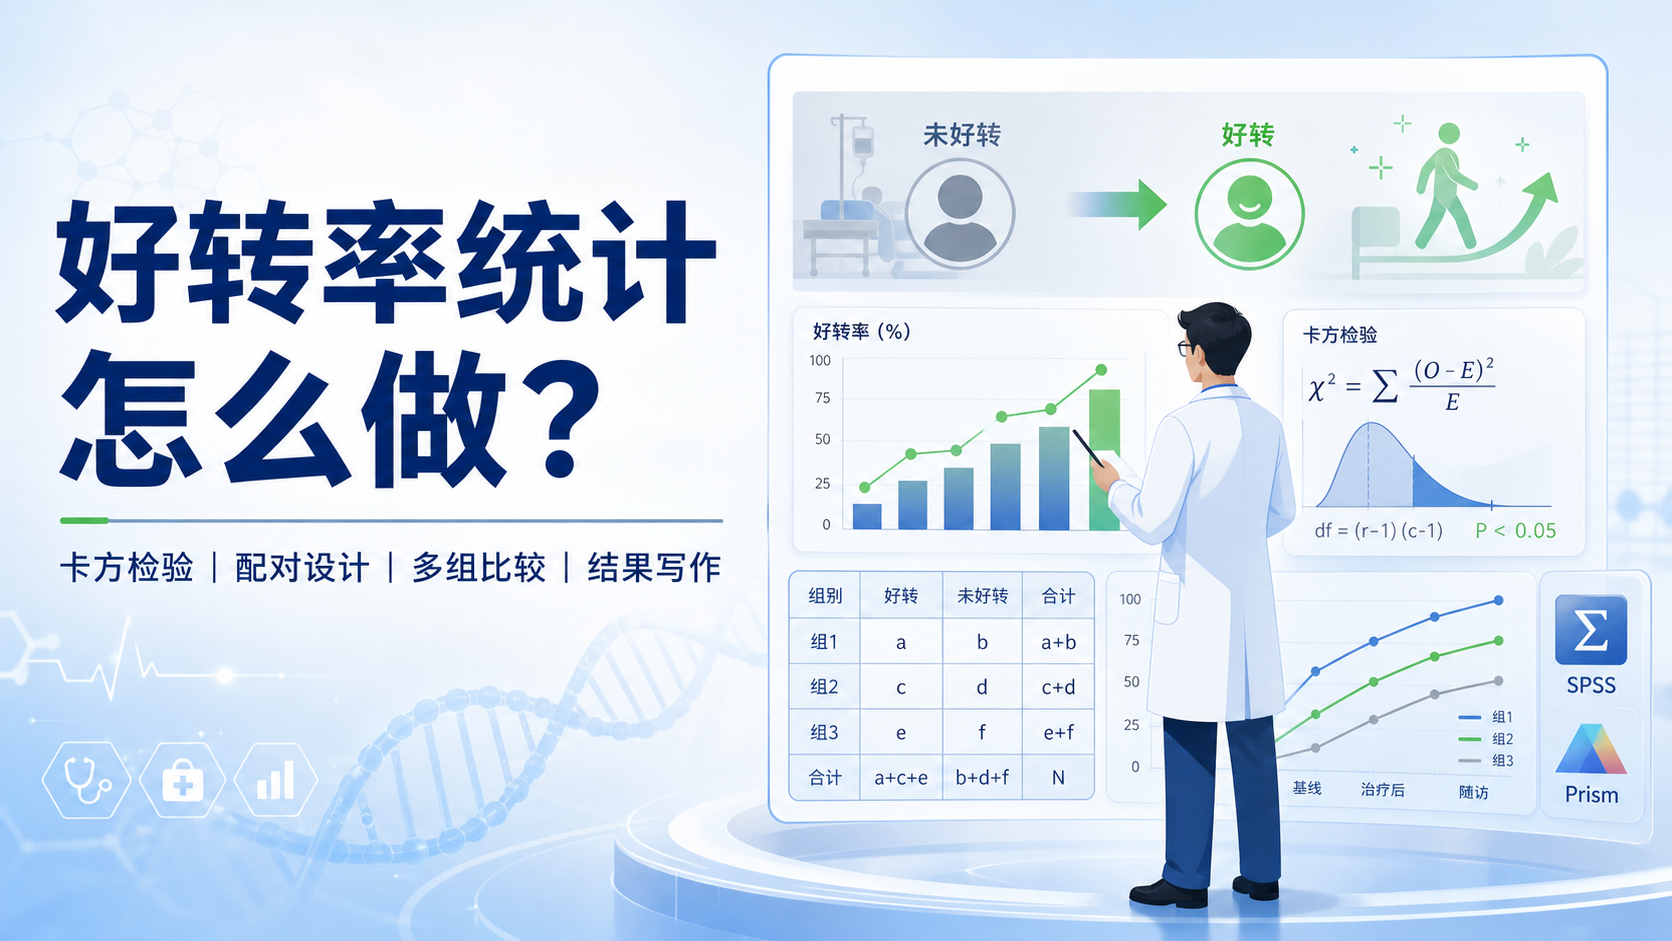
- t检验、卡方检验、秩和检验。
- 相关分析和回归分析。
- 生存分析。
- ROC分析。
- 多因素模型和亚组分析。
这几类方法覆盖了大部分医学论文的基础统计需求。
6. 让效率真正提升,离不开专业支持
6.1 统计思路比“套模板”更重要
很多人急着找现成模板,但模板只能解决表面问题。真正影响论文质量的,是你是否理解研究设计和统计逻辑。模板可以借,思路不能借。
如果前期设计不清晰,后期即使勉强跑出结果,也会面临解释困难、返修反复、甚至结论被推翻的问题。对医学生、医生和科研人员来说,这种隐性成本很高。
6.2 借助解螺旋,让统计流程更顺
如果你希望更快搭建研究框架,减少试错,解螺旋 可以提供更系统的支持。从统计思维训练,到软件分析,再到结果解释,都能帮助你把复杂流程拆成可执行步骤。这样不仅能提高显效率统计的准确性,也能提升整篇论文的完成效率。
总结Conclusion
生物医学效率统计的核心,不是追求复杂,而是追求正确。先有统计思维,再有软件操作。先定研究设计,再选统计方法。先控制混杂,再解释结论。对医生和硕博生来说,真正高效的分析,是让数据服务于临床问题。
如果你希望少走弯路、快速建立自己的统计分析能力,可以进一步了解解螺旋 ,把研究设计、数据分析和论文写作连成一条高效路径。

- 引言Introduction
- 1. 先建立“统计思维”,再谈软件操作
- 2. 研究设计决定统计方法,不能倒推
- 3. 高效分析的核心,是把流程标准化
- 4. 医学生、医生、硕博生最需要的,是统计推断与混杂控制
- 5. 提升论文效率,关键在于分析链条完整
- 6. 让效率真正提升,离不开专业支持
- 总结Conclusion