13
 分享
引言Introduction
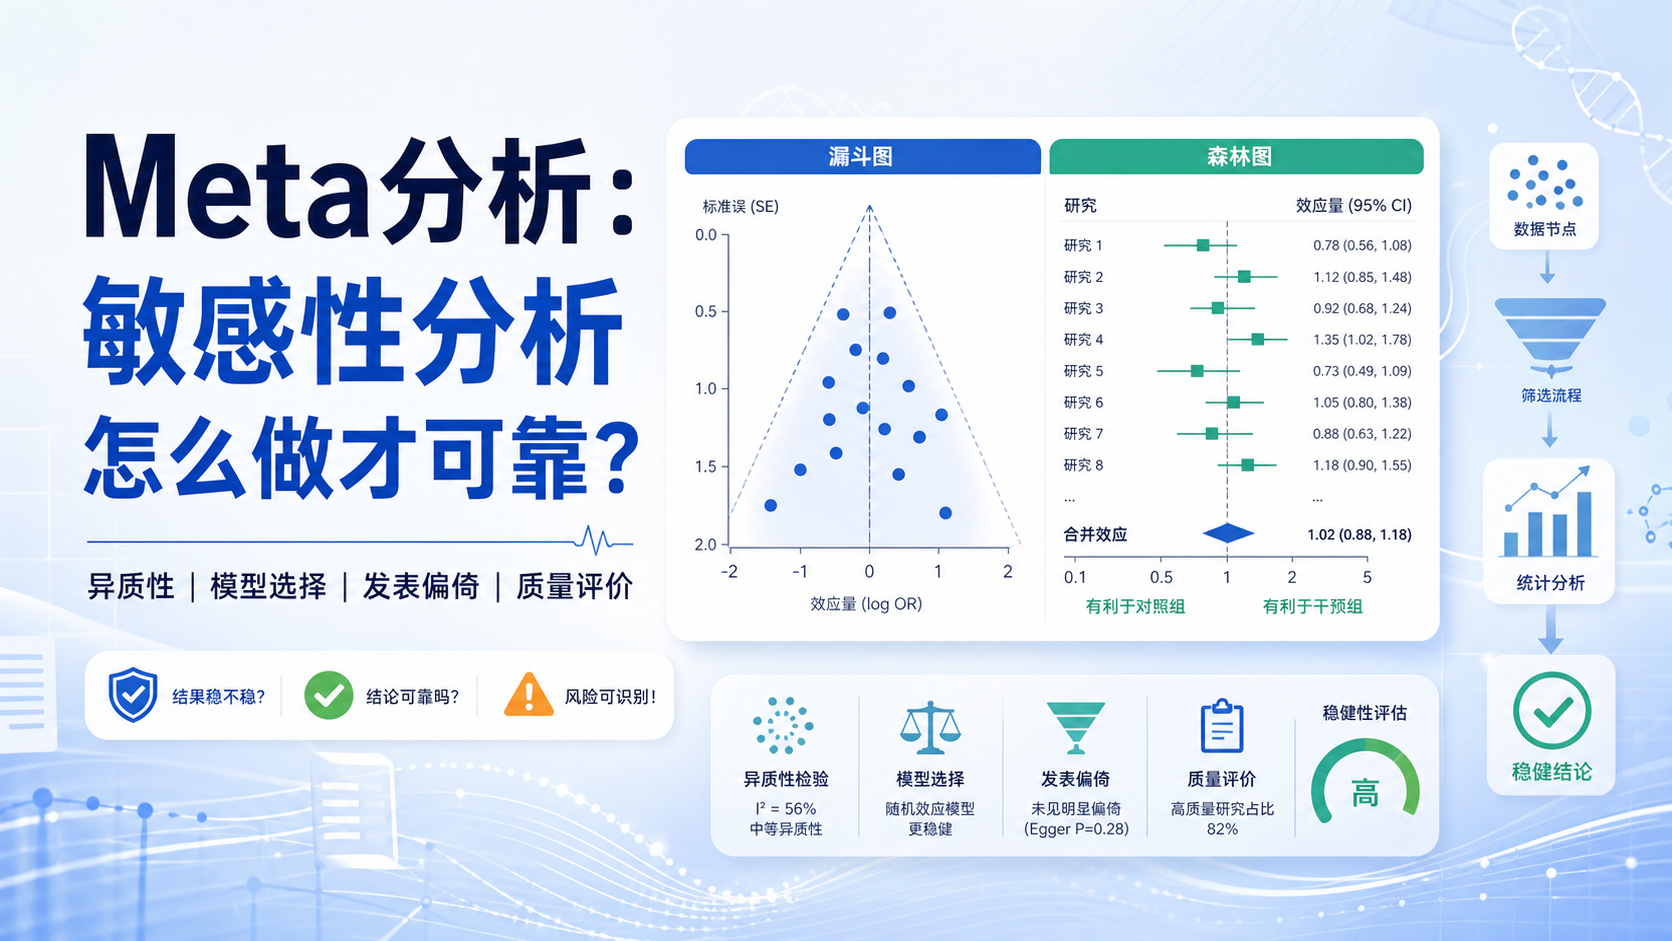
Meta分析不是把几篇文章简单相加。真正决定结果能不能信的,往往是无效统计、异质性和敏感性分析。很多医学生和科研人员在做完合并效应后,才发现结论“不稳”。如果不先处理这些问题,Meta结果很可能只是看起来显著。
1. 先理解什么是无效统计与敏感性分析
1.1 无效统计并不是“没有结果”
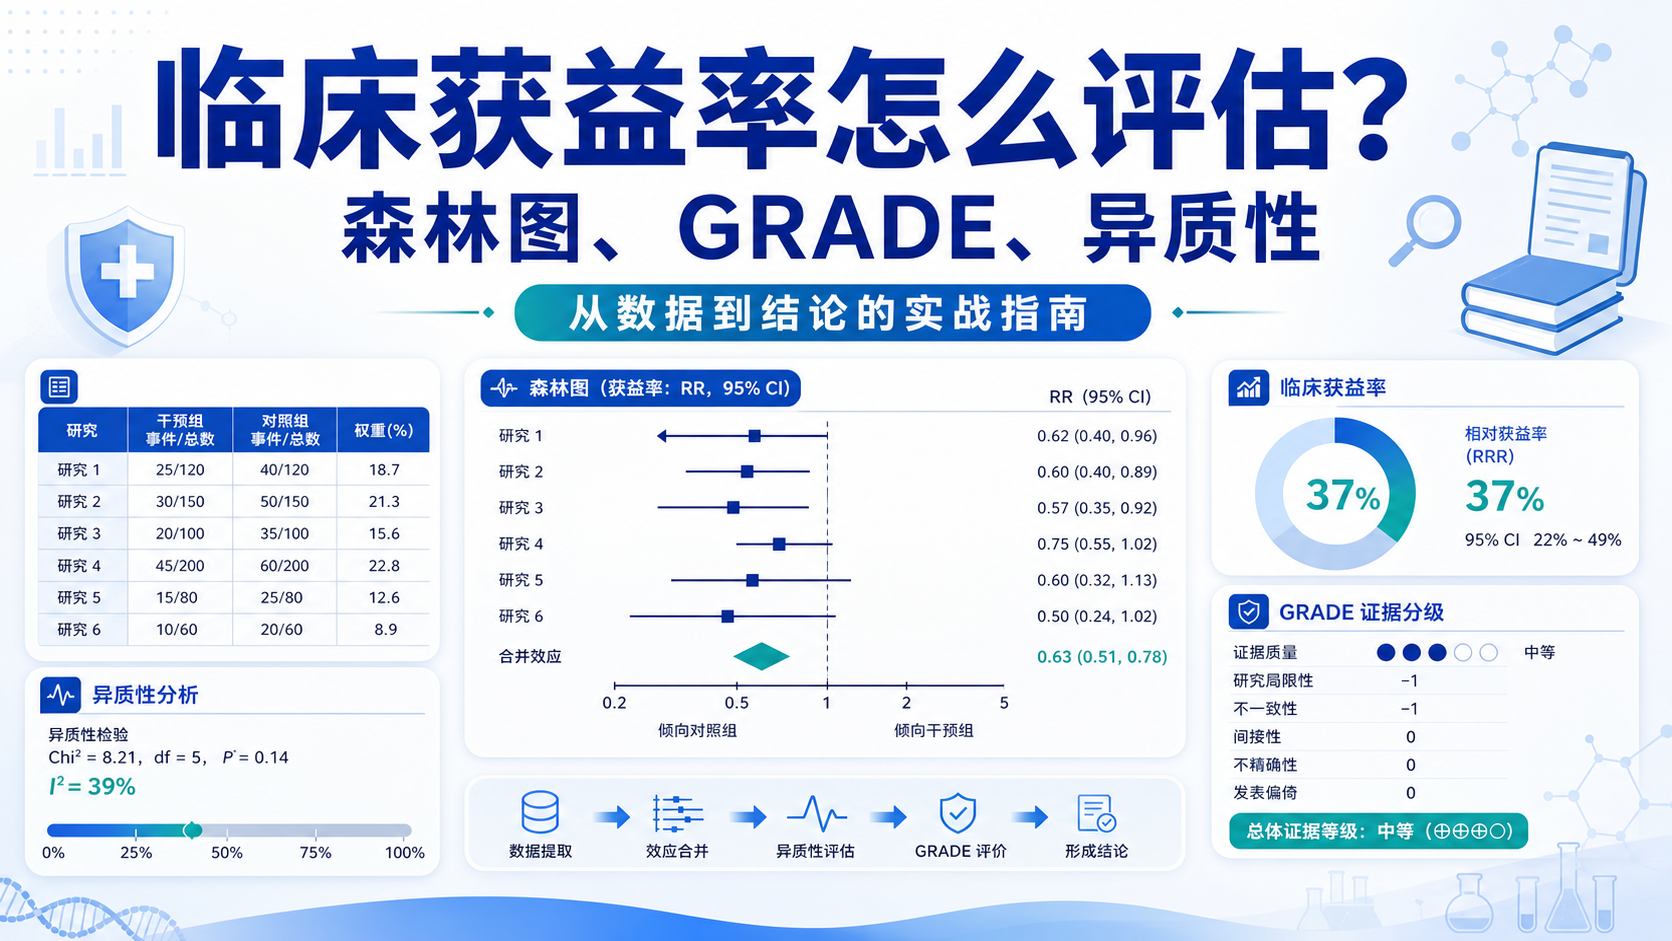
在Meta分析语境里,很多人会把“无效统计”理解成没有意义的统计。更准确地说,它通常对应森林图中的无效线,也就是效应量为0或1的参考线。
判断结果是否有统计学意义,核心是看合并效应是否跨过无效线。 如果跨线,说明差异可能不显著;如果未跨线,才可能支持阳性结论。
不同效应指标对应不同的无效值。比如:
- OR、RR、HR的无效值通常是1。
- 均数差的无效值通常是0。
这一步很基础,但非常关键。很多初学者只看P值,忽略效应量方向,容易误判结果。
1.2 敏感性分析的作用是检验“稳不稳”
敏感性分析不是重新做一遍Meta分析,而是通过改变分析条件,观察结论是否改变。
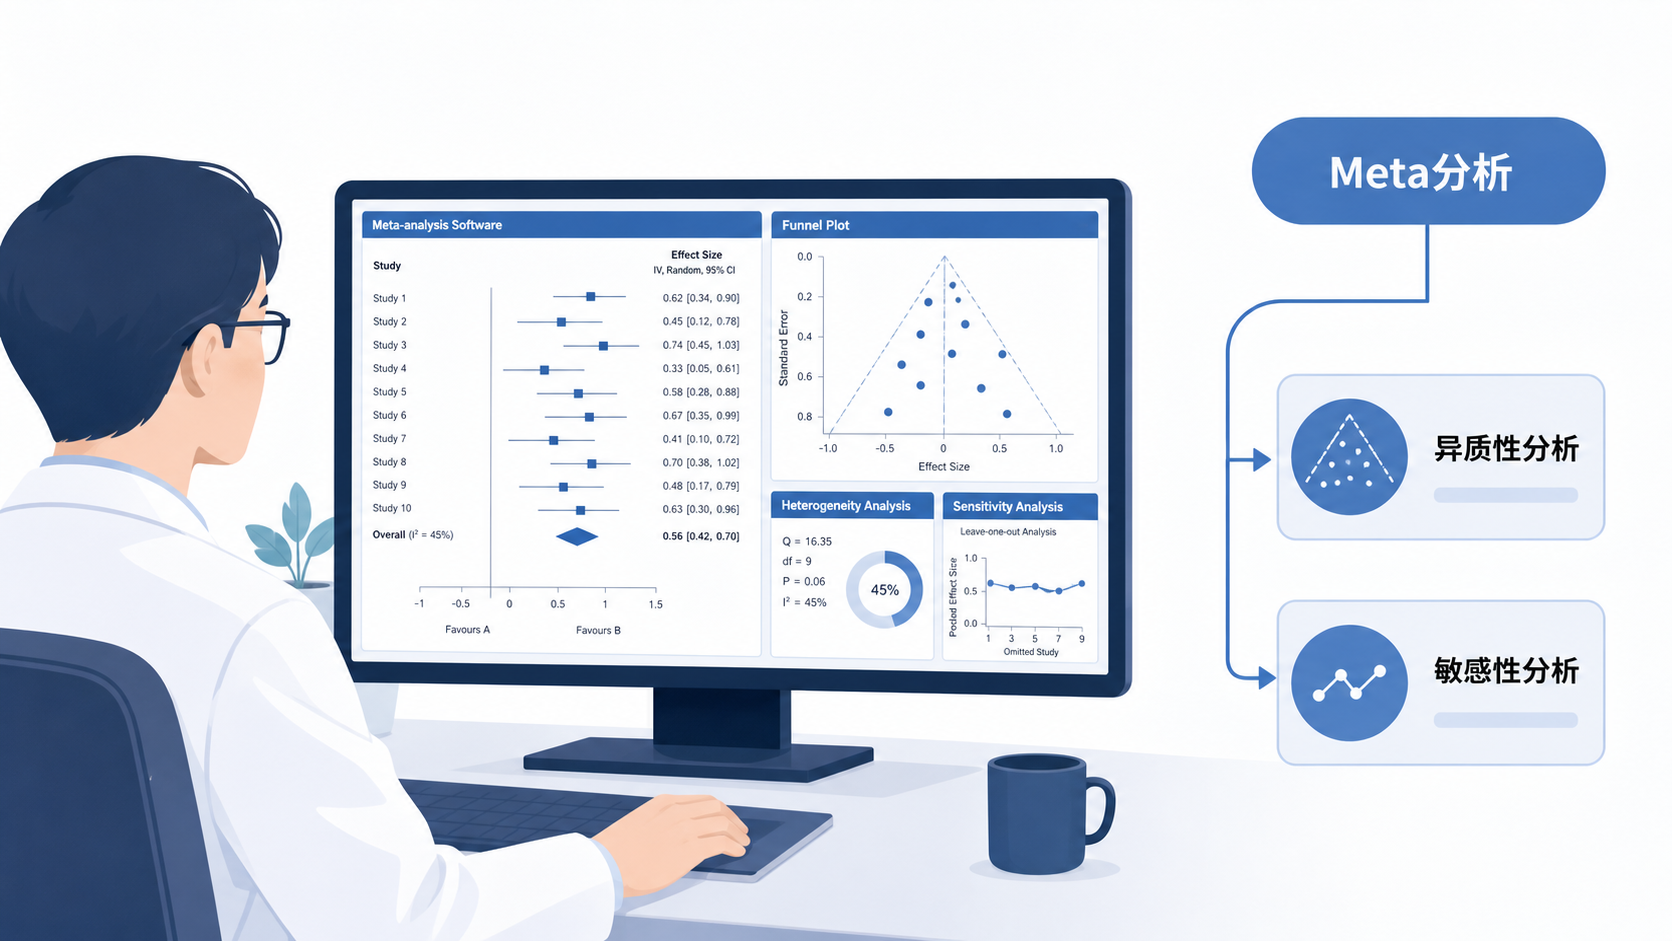
如果剔除某篇研究后,总效应方向或显著性发生明显变化,说明结果对该研究高度敏感。
常见目的包括:
- 排除低质量研究。
- 检查重复发表是否影响结果。
- 观察模型切换后结果是否一致。
- 评估单篇研究对总体结论的影响。
对于临床研究来说,敏感性分析的价值在于帮助判断结论是否可以用于实践,而不是只停留在统计显著。
2. 结果可靠吗,先看异质性和模型选择
2.1 异质性是敏感性分析的前提
Meta分析中,研究之间很少完全一致。异质性可能来自三个层面。
临床异质性 包括年龄、病情严重程度、干预方案、结局指标不同。
方法学异质性 包括诊断标准、实验方法、随机方法和随访时长不同。
统计学异质性 则表现为各研究效应量波动较大。
常用判断指标是Q检验和I²。
- Q检验的P值小于0.05,提示存在异质性。
- I²越大,异质性越明显。
- 一般可粗略理解为:I²约25%为低异质性,50%为中等,75%以上为高异质性。
这不是机械阈值,但对初学者判断模型很有帮助。
2.2 固定效应模型和随机效应模型不能乱选
模型选择直接影响合并结果。
如果异质性不明显,通常采用固定效应模型。
如果异质性明显,通常采用随机效应模型。
原因很简单。固定效应模型假设所有研究估计的是同一个真实效应。随机效应模型则认为研究间存在真实差异,合并的是一个分布下的平均效应。
在实际写作中,不能只写“P>0.05所以用固定效应模型”。更稳妥的做法是结合研究设计、临床一致性和统计指标一起判断。
如果研究数量较少,I²不高,但临床差异明显,也要谨慎使用固定效应模型。
3. 哪些因素会让Meta结论不稳
3.1 重复发表会夸大样本量
重复发表是Meta分析中必须排查的问题。
同一研究如果在不同杂志、不同版本或不同主题中重复出现,可能导致样本被重复计入。
常见处理原则是:
- 优先纳入最新发表文章。
- 如果样本重叠,优先纳入样本量更大的研究。
- 早期重复版本剔除。
- 剔除原因要在流程图中记录。
一旦重复发表未被识别,合并效应可能被人为放大。 这会直接影响结论可信度。
3.2 纳入标准过松会增加波动
纳入标准设置得太宽,研究之间差异会变大。
例如诊断标准不同、终点定义不同、语言限制不一致,都会让结果难以比较。
建议在方案阶段就明确:
- 研究类型。
- 年限范围。
- 语言限制。
- 样本量和随访时长。
- 结局指标是否一致。
- 是否允许联合亚组分析。
标准越清晰,后续敏感性分析越有解释力。 因为你知道哪些变量可能是波动来源。
3.3 基因多态性研究还要关注遗传平衡性
在基因多态性Meta分析中,遗传平衡性常被作为筛选条件之一。
有些研究会严格排除不符合遗传平衡性的文献;有些则保留这类文献,再通过亚组分析处理。
这两种做法都可以,但前提是逻辑一致。
- 文献数量充足时,可以更严格。
- 文献数量较少时,可以适当放宽,再做亚组分析。
关键不是“一刀切”,而是解释清楚为什么这么做。 这也是E-E-A-T中很重要的专业性体现。
4. 敏感性分析怎么做,才有临床和科研价值
4.1 最常用的是逐一剔除法
逐一剔除法是最常见的敏感性分析。
做法很直接:每次去掉一篇研究,重新合并,观察总效应是否改变。
如果结果一直稳定,说明结论较可靠。
如果某篇研究一删就翻转结果,说明该研究影响很大,必须回到原文检查:
- 样本量是否过大。
- 质量评分是否偏低。
- 数据提取是否有误。
- 是否存在异常值。
敏感性分析的本质,是找出“谁在主导结果”。
4.2 改变纳入标准也是常用方法
除了逐一剔除,还可以通过改变纳入标准来测试稳健性。比如:
- 只保留高质量研究。
- 排除重复发表。
- 排除样本量特别小的研究。
- 仅纳入某一时间段的研究。
- 仅纳入同一种实验方法的研究。
如果在更严格条件下,结论仍保持一致,说明结果更可信。
如果一严格就不显著,说明原结论可能依赖于低质量或偏倚研究。
4.3 亚组分析常与敏感性分析配合使用
亚组分析本来主要用于探索异质性,但在实操中也常帮助判断结果是否稳定。
比如按以下因素分组:
- 成人和儿童。
- 中国人群和其他人群。
- 早期研究和近期研究。
- 不同诊断标准。
- 不同性别比例。
- 不同疾病分型。
如果各亚组方向一致,说明结论外推性更强。
如果只有某一亚组阳性,就要谨慎表述,不能夸大总体结论。
5. 结果可靠,还要看发表偏倚和质量评价
5.1 漏斗图只能看一部分问题
发表偏倚会影响Meta分析的真实性。
常用方法包括漏斗图、Egger检验和Trim and Fill方法。
其中:
- 漏斗图偏向定性判断。
- Egger检验更偏定量。
- Trim and Fill用于估计缺失研究对结果的影响。
如果漏斗图明显不对称,结果就要谨慎解释。
但漏斗图不对称不等于一定有偏倚。 小样本、异质性大时,也会造成图形不对称。
5.2 质量评价决定结论的底层可信度
质量评价不能省。观察性研究常用NOS等量表,RCT则更关注随机、盲法、分配隐藏等要素。
一般来说,质量较高的研究更适合作为主要结论依据。
如果纳入研究质量参差不齐,建议在正文里明确说明,并在讨论中解释对结果的影响。
这比单纯报一个合并P值更符合科研写作规范。
6. 写作时,怎样让结果“更像一个可靠结论”
6.1 不要只写“有统计学意义”
Meta分析结果不能只报一个P值。更规范的表述应包括:
- 效应量及95%CI。
- 异质性指标I²和Q检验P值。
- 使用的模型。
- 敏感性分析是否稳定。
- 是否存在发表偏倚。
- 主要限制因素是什么。
例如,若I²较低、逐一剔除后结果稳定、漏斗图较对称,那么结论就更有说服力。
如果这些条件缺失,哪怕P值显著,也要谨慎下结论。
6.2 讨论部分要主动交代局限性
科研写作中,真正专业的地方往往不是“报喜”,而是如实说明边界。
你可以在讨论里说明:
- 纳入研究数量有限。
- 研究设计以观察性研究为主。
- 结局指标不完全一致。
- 存在语言限制。
- 亚组样本量不足。
这不是削弱文章,而是增强可信度。 审稿人和读者更容易认可这种写法。
总结Conclusion
Meta分析结果是否可靠,不取决于一个显著P值,而取决于无效线判断、异质性大小、模型选择、敏感性分析和偏倚控制是否完整。只有当结果在多种条件下仍然稳定,才更值得用于临床和科研决策。
如果你正在准备Meta分析、流程图、森林图或敏感性分析结果,建议先把方法设计好,再进入写作。需要更系统的实战支持,可以关注解螺旋 ,帮助你更高效完成高质量Meta分析。

- 引言Introduction
- 1. 先理解什么是无效统计与敏感性分析
- 2. 结果可靠吗,先看异质性和模型选择
- 3. 哪些因素会让Meta结论不稳
- 4. 敏感性分析怎么做,才有临床和科研价值
- 5. 结果可靠,还要看发表偏倚和质量评价
- 6. 写作时,怎样让结果“更像一个可靠结论”
- 总结Conclusion