14
 分享
引言Introduction
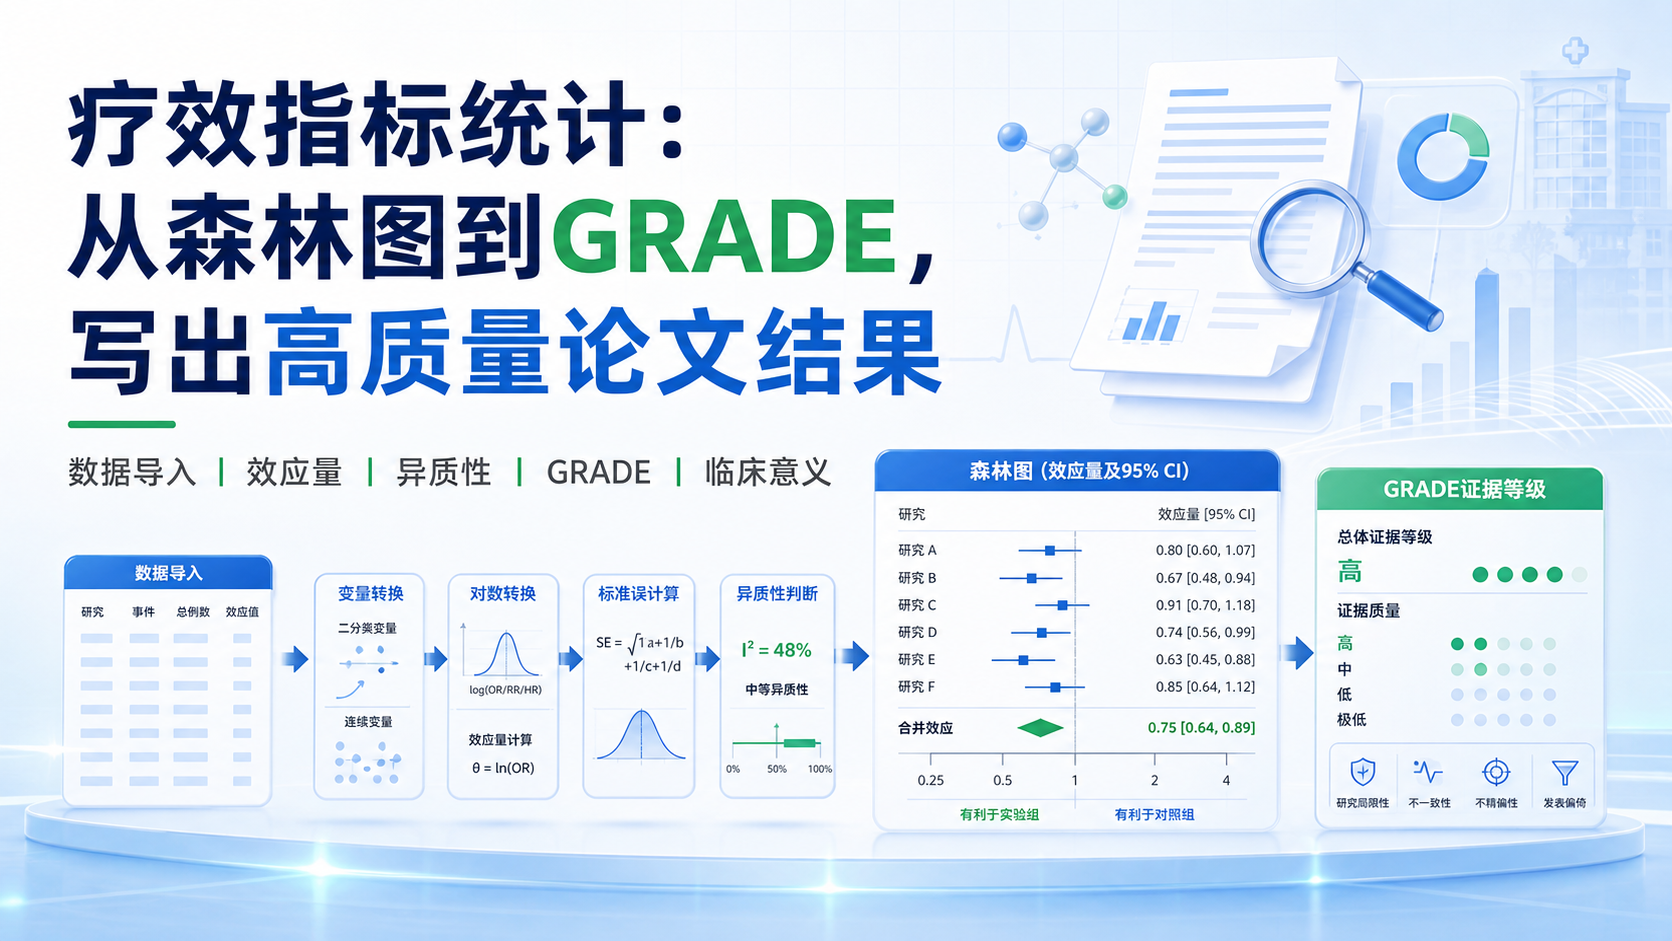
疗效指标统计常让人卡在两处,一是数据格式混乱,二是结果展示不够直观。对于做预后分析、亚组分析和系统评价的人来说,不会整理效应量、不会画森林图、不会解读GRADE,结果就很难写进论文 。
1. 疗效指标统计,先解决什么问题
1.1 从原始表格到可分析数据
疗效指标统计不是先画图,而是先把数据理顺。常见来源是文章表1或原始病例表,通常包括作者、年份、样本量、效应量、随访时间、年龄、分期等信息。如果这些变量不统一,后续合并分析会直接出错。
在实操中,很多变量需要先转成分类变量。比如:
- 研究设计,回顾性记为1,前瞻性记为2。
- 治疗方案,手术、化疗、联合方案分别编码。
- HR类型,单因素HR和多因素HR要分开。
- 分期,早期、晚期、全部阶段要统一定义。
这样做的目的很明确。不是为了“格式好看”,而是为了让元回归和亚组分析能够被软件正确识别。
1.2 先看效应量,再谈临床意义
疗效指标统计的核心,不是单看一个P值,而是看效应量及其95%置信区间。对预后研究而言,HR最常见。对二分类结局,也常见OR、RR。
如果95%CI跨过无效线,结论往往就不稳。真正有价值的是效应量方向、区间宽窄和异质性。
在论文写作中,这一步决定结果能不能站住。
如果只报“有统计学差异”,而没有HR、CI和模型选择,临床读者很难判断结果能否应用。
疗效指标统计的第一原则,是把数字变成可解释的证据。
2. 数据导入与变量转换,决定后面是否顺利
2.1 导入前,先统一表结构
在软件导入前,建议先把数据整理成固定列。常见最少需要以下字段:
- 研究名称。
- 样本量。
- 效应量。
- 下限与上限。
- 结局指标。
- 分组变量。
如果是HR分析,很多时候需要先把HR、LL、UL转换为对数尺度。这是因为合并分析通常基于LNHR及其标准误,而不是直接用原始HR。
这一步看似基础,但很关键。
若导入后把连续变量误设为分类变量,或把分类变量误设为连续变量,后面出的图和统计量就会偏。
数据结构错了,后续所有图形都不可信。
2.2 对数转换与标准误计算
进行合并前,通常要先计算:
- LNHR。
- LNLL。
- LNUL。
- SE。
常用思路是把HR及其置信区间转化到对数尺度,再计算标准误。这样做的好处是,合并模型更稳定,也更符合统计假设。
对于疗效指标统计来说,这一步相当于把“可报告的结果”转成“可合并的证据”。
如果你在做系统评价,建议保留转换前后两套数据。
这样既便于核对,也便于写方法学部分。
很多审稿人会特别看这一段,因为它直接关系到结果是否可重复。
3. 森林图怎么做,怎么读,怎么写进结果
3.1 森林图的核心信息只有三类
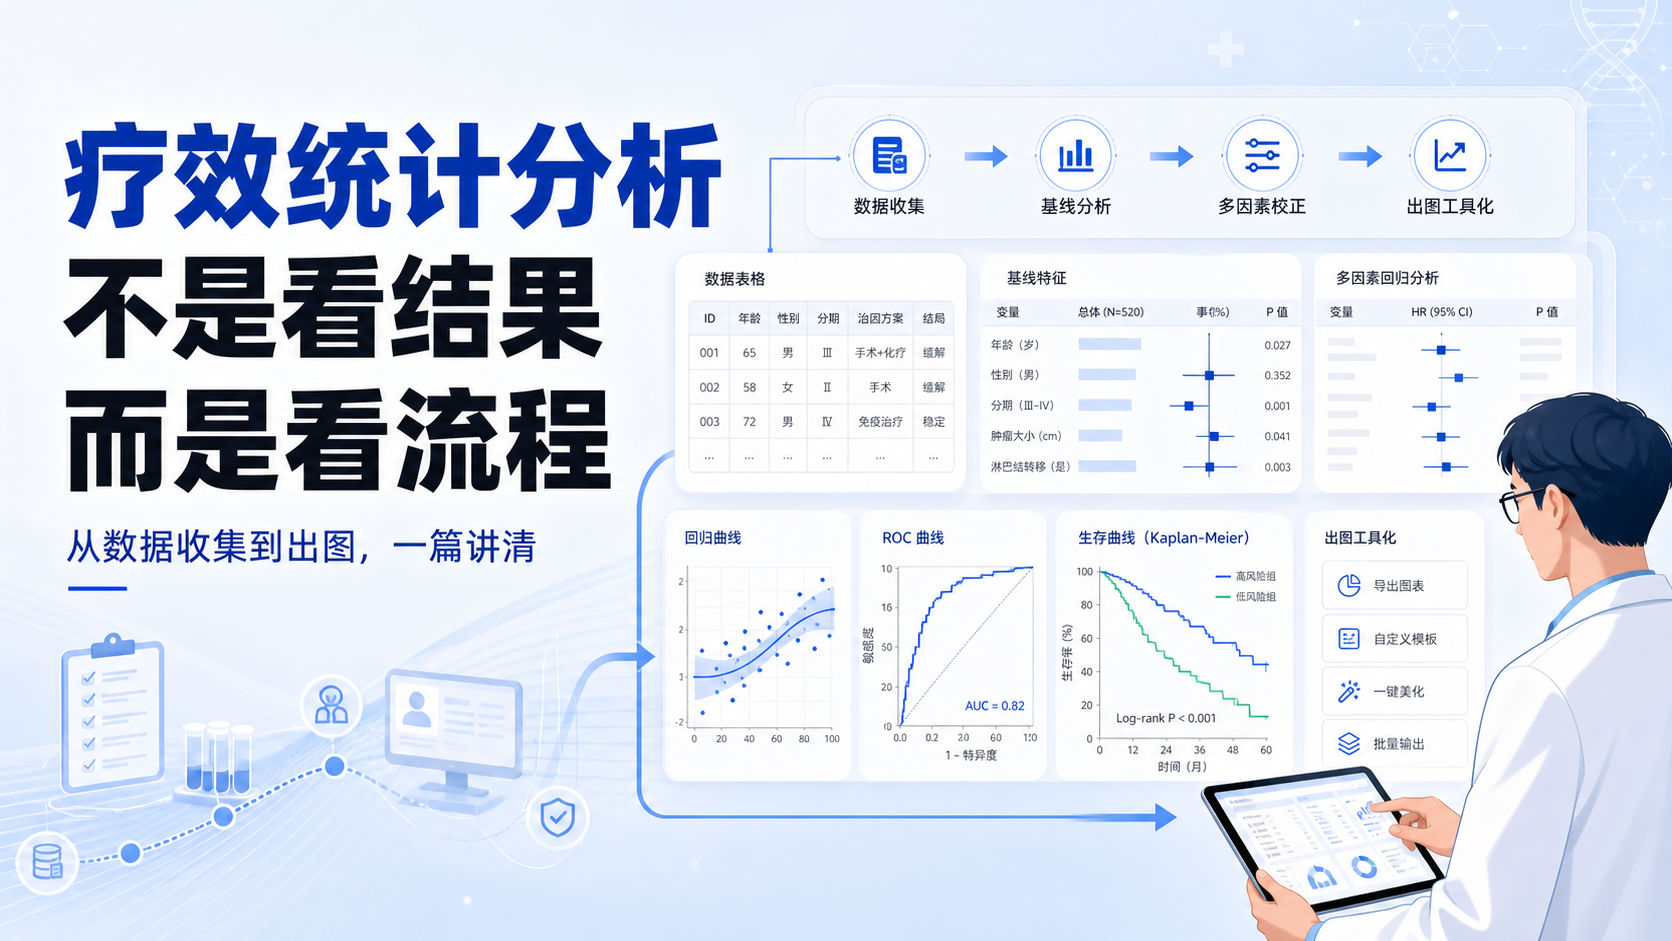
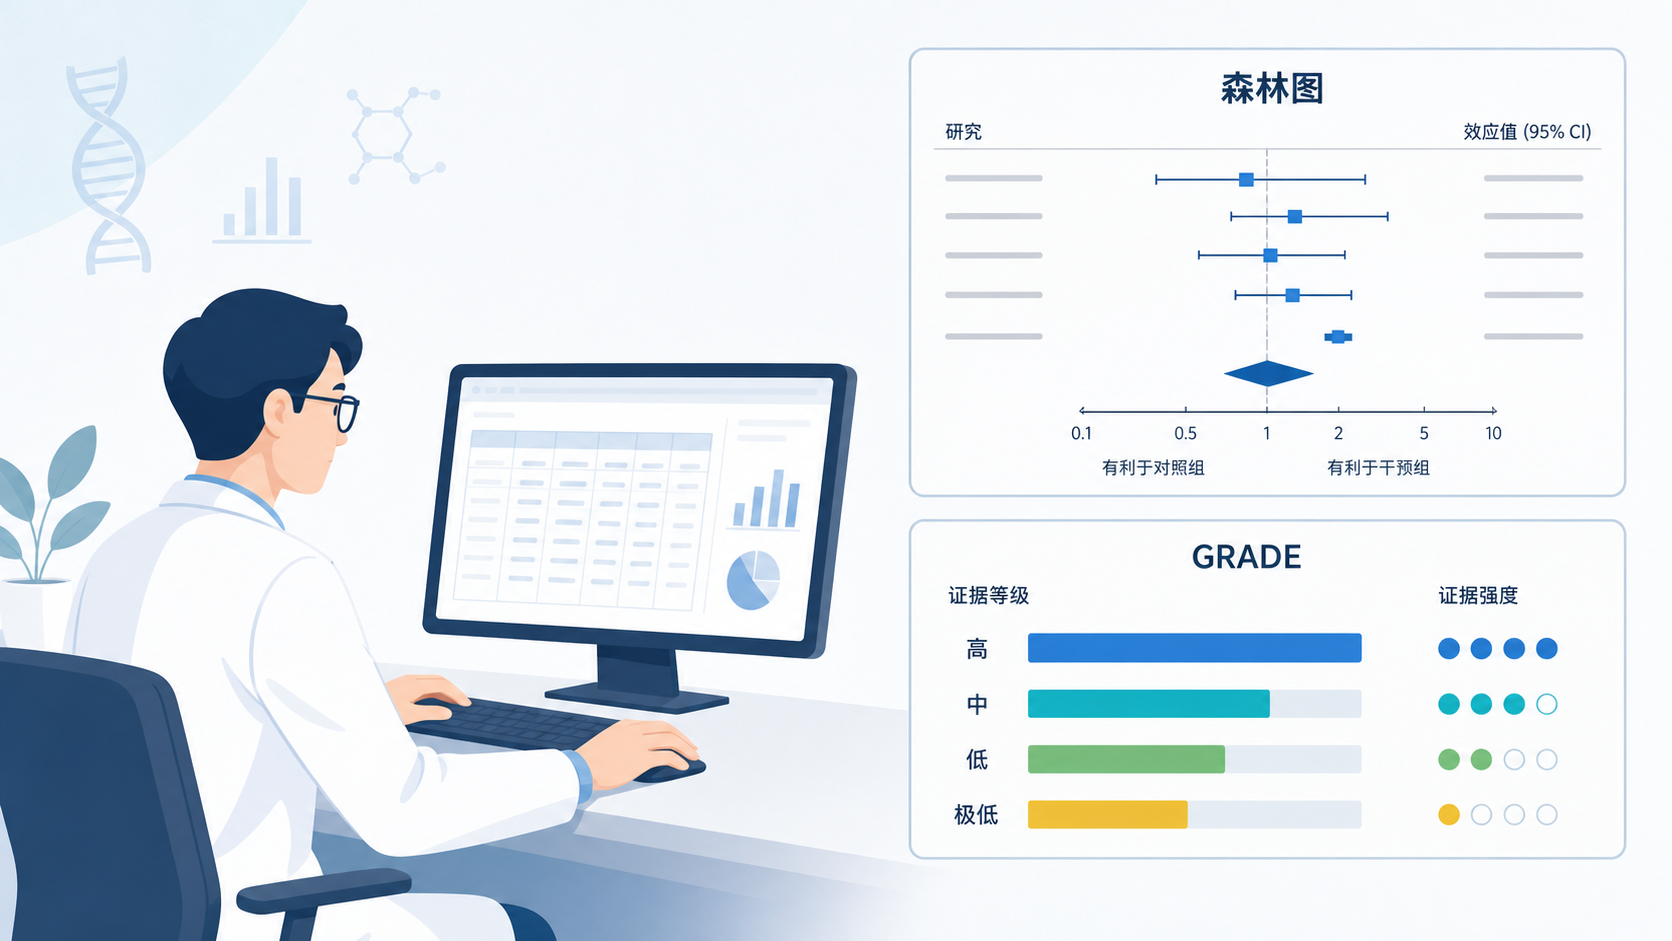
森林图是疗效指标统计里最常用的可视化方式之一。它把复杂表格压缩成一张图,方便快速判断方向和稳定性。通常会包含:
- 变量名或分组名。
- HR或其他效应量及95%CI。
- 参考线。
- P值。
无效线的位置很重要。
如果是HR分析,无效线应设为1,而不是默认的0。
这一点看似细节,实际上会直接影响图的解释逻辑。对预后研究来说,HR大于1通常提示风险升高,小于1提示风险降低。
3.2 先判断异质性,再决定模型
森林图不是“画出来就结束”,关键是解读。
如果各研究方向一致,95%CI大多不交叉无效线,且异质性可接受,那么结果更容易支持稳定结论。
如果异质性显著,通常应优先考虑随机效应模型。
可以这样理解:
- 固定效应模型,适合研究间差异较小。
- 随机效应模型,适合研究间存在真实差异。
疗效指标统计不是追求一个好看的综合值,而是要尊重研究之间的差异。
这也是为什么同一个指标,在不同研究集合中,模型选择可能不同。
3.3 森林图的排版也影响论文质量
很多人忽视图形美观,其实审稿人和读者都会看。常见优化包括:
- 背景用白底黑字。
- 字号清晰。
- 线条粗细统一。
- 参考线醒目但不过度抢眼。
- 按年份或变量排序,让图更整洁。
如果导出用于投稿,优先考虑高分辨率格式,如TIFF或PDF。
一张清晰、规范的森林图,往往比一段冗长文字更能说明疗效指标统计的结论。
4. GRADE怎么用,才能真正服务临床判断
4.1 GRADE不是“附录”,而是证据等级判断
很多文章只把GRADE放在补充材料,但实际上它非常重要。
GRADE用于评估证据质量,常分为四档:
- high。
- moderate。
- low。
- very low。
在临床决策中,high和moderate证据通常更值得采信。
如果某个疗效指标统计结果显著,但证据等级很低,临床解释就必须谨慎。
GRADE关注的不是“结果显不显著”,而是“这个结论靠不靠谱”。
评价时通常会考虑:
- 风险偏倚。
- 不一致性。
- 间接性。
- 不精确性。
- 发表偏倚。
这些因素决定证据会不会降级。
所以,GRADE不是额外装饰,而是疗效指标统计从“统计结果”走向“证据结论”的桥梁。
4.2 为什么阴性结果也要报告
很多研究只展示阳性结果,其实不够完整。
如果某些并发症、次要终点或分层指标没有显著差异,也应如实报告。
阴性结果不是失败,而是证据拼图的一部分。
在系统评价或meta分析中,完整呈现所有疗效指标,能减少选择性报告偏倚。
这对构建GRADE证据等级也很重要,因为不完整结果会削弱整体可信度。
对医学生和科研人员来说,这也是训练研究思维的关键一步。
5. 实战写作时,疗效指标统计如何落到论文结果
5.1 结果段建议按“三步写”
写结果时,建议按以下顺序:
- 先交代纳入研究和数据来源。
- 再报告合并效应量和95%CI。
- 最后说明异质性、模型和GRADE等级。
这样写逻辑最清楚。
例如,可以围绕某个疗效指标说明趋势是否一致,CI是否跨线,异质性是否可接受,再补充证据等级。
结果段的重点不是堆数字,而是把数字串成临床可读的结论。
5.2 讨论段要回到临床问题
讨论时不要只重复图上的HR。
更重要的是解释:
- 这个疗效指标代表什么。
- 为什么不同亚组会有差异。
- 异质性可能来自哪里。
- 证据等级是否足以支持推广。
如果证据等级较低,就要明确提示局限。
如果趋势一致且GRADE较高,就可以更有底气地支持结论。
真正高质量的疗效指标统计,是统计结果、图形表达和证据分级三者一致。
6. 用对工具,才能把统计变成高质量产出
疗效指标统计最怕三件事。数据没整理好,模型选错了,图做得不规范。
这会让研究者在合并分析、森林图制作和GRADE判断上反复返工,浪费大量时间。
如果你希望更高效地完成数据导入、效应量合并、森林图绘制和结果排版,可以借助成熟工具和标准化流程。解螺旋提供的科研支持思路,正适合帮助你把复杂疗效指标统计快速整理成可投稿的图表和证据链。
对于医学生、医生和科研人员来说,这类工具的价值不只是省时间,更是减少低级错误,让分析更接近发表标准。
总结Conclusion
疗效指标统计的关键,不是单独会算一个HR,而是能把数据导入、对数转换、森林图解读和GRADE证据分级 连成完整流程。
只要你能正确处理变量、选择合适模型,并用GRADE评估证据强度,结果就更容易被同行理解,也更容易写进论文。
如果你正在做系统评价、预后分析或meta分析,建议把这套流程固定下来。
想更快把疗效指标统计做成规范结果,可以结合解螺旋的专业支持,把复杂分析变成清晰、可发表的证据。

- 引言Introduction
- 1. 疗效指标统计,先解决什么问题
- 2. 数据导入与变量转换,决定后面是否顺利
- 3. 森林图怎么做,怎么读,怎么写进结果
- 4. GRADE怎么用,才能真正服务临床判断
- 5. 实战写作时,疗效指标统计如何落到论文结果
- 6. 用对工具,才能把统计变成高质量产出
- 总结Conclusion