12
 分享

引言Introduction
硕博阶段最怕的,不是没数据,而是数据下载、定量、标准化、差异分析流程断裂 。尤其是转录组研究,很多人卡在tximport导入和下游分析衔接上,重复劳动多,结果还不够可复现。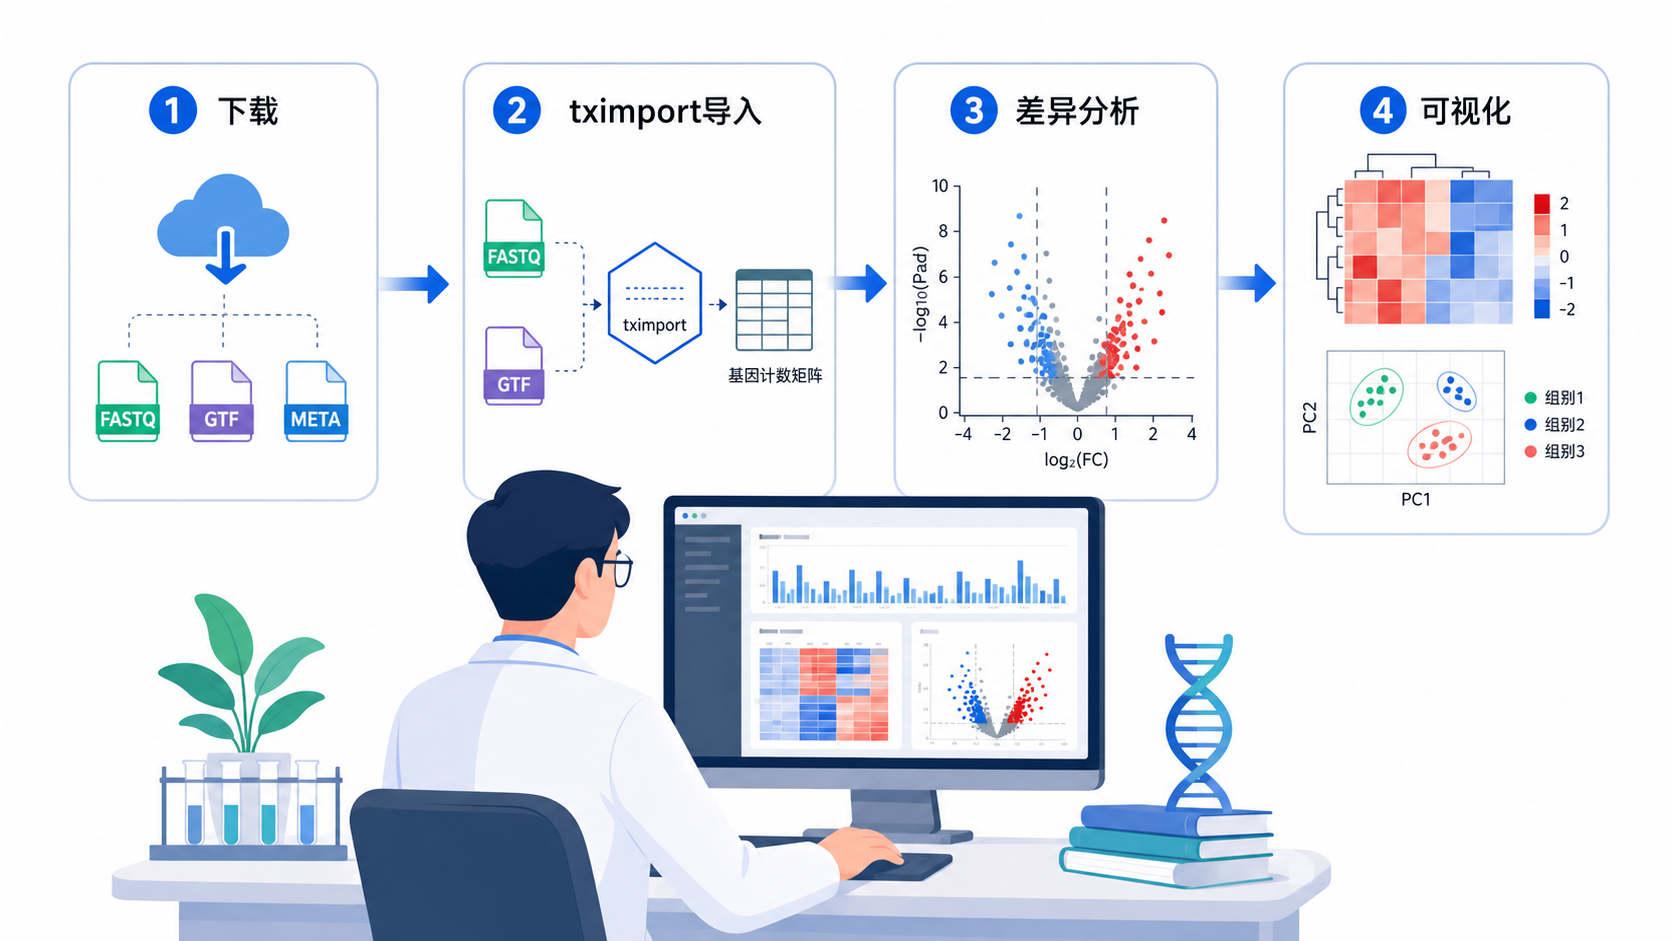
1. 为什么WorkBuddy+tximport流程适合硕博研究
1.1 tximport解决了转录本定量到基因层面的衔接问题
在转录组分析中,常见的定量结果来自Salmon、Kallisto这类工具。它们输出的是转录本层面的丰度信息。
而很多下游分析,如差异表达、富集分析、WGCNA,往往更关注基因层面。tximport的核心价值,就是把转录本定量结果稳定地导入R环境,并汇总到基因层面。
它的优势很明确。
- 保留更多定量信息。
- 支持转录本到基因的合理汇总。
- 可与DESeq2、edgeR等流程衔接。
- 便于形成标准化、可复现的分析路径。
对硕博生来说,这一步不是“可有可无”,而是流程规范的基础。很多后续结果是否可靠,取决于这里是否处理正确。
1.2 WorkBuddy提升的是流程组织效率,不是替代科研判断
WorkBuddy的价值,不在于“替你思考课题”,而在于把分析步骤模块化、调用化、标准化 。
对于科研人员来说,这一点非常重要。因为真正耗时的,往往不是一个图,而是整套流程的反复整理。
传统做法里,你可能要反复切换:
- 数据下载。
- 样本信息整理。
- tximport导入。
- 质控与归一化。
- 差异分析。
- 作图和结果解释。
如果每一步都手工拼接,错误率会明显上升。WorkBuddy+tximport流程的优势,是把分析动作沉淀为可重复调用的路径。 这对毕业论文、课题汇报、文章复现都更友好。
1.3 硕博阶段最需要的是“低成本、可复现、能交付”
很多研究生面临的现实问题很一致。
时间紧,任务重,预算有限。
这时分析方案必须满足三个条件。
- 低成本。
- 可复现。
- 能快速产出结果。
tximport本身是成熟方法,WorkBuddy则更适合把它嵌入一条可执行的分析链路中。这类组合方案的意义,在于把“会做”变成“稳定做”。
2. WorkBuddy+tximport流程的核心步骤
2.1 第一步,明确输入数据类型
做任何分析前,先确认你拿到的是什么文件。
如果是Salmon输出,通常会包含quant.sf文件。
如果是Kallisto输出,也有相应的丰度文件。
只有先确认输入格式,后面的tximport才能正确工作。
这一步常被忽略,但很关键。
因为不同定量工具的输出结构不同,样本目录结构也可能不同。
目录混乱,会直接影响后续批量导入。
建议先完成三件事。
- 统一样本命名。
- 整理每个样本的文件路径。
- 准备样本分组表。
这三项准备好,tximport导入成功率会高很多。
2.2 第二步,用tximport完成导入和汇总
tximport的典型任务,是把多个样本的定量文件读入R,并按基因层面汇总。
在实际分析中,你通常需要配合注释文件,将转录本ID映射到基因ID。
这一步决定了后续差异分析的数据矩阵是否规范。
这里有几个细节要注意。
- 确保注释版本和定量文件版本一致。
- 处理好重复基因映射问题。
- 检查低表达基因是否需要过滤。
- 记录导入参数,便于复现。
如果这些步骤不记录,后面很难回溯问题来源。
科研里最怕的,不是结果慢,而是结果无法解释。
2.3 第三步,接入差异分析和可视化模块
完成tximport后,数据通常会进入DESeq2或edgeR流程。
这一步是硕博论文中最常见的核心分析部分。
你可以继续做以下内容。
- PCA或样本聚类。
- 差异基因筛选。
- 火山图和热图。
- GO、KEGG富集分析。
- 关键基因表达验证。
WorkBuddy的优势在于,可以把这些步骤组织成连续链路,减少中间手工切换。
对写论文的人来说,这能明显减少重复劳动。
对做组会的人来说,也能更快形成完整结果链。
3. 硕博生在使用这套流程时,最容易踩的坑
3.1 样本信息不规范,导致分析中断
很多分析失败,不是代码错,而是样本表错。
常见问题包括:
- 样本名不一致。
- 分组标签写法不统一。
- 文件路径缺失。
- 对照组和实验组混淆。
这类问题在tximport前就该解决。
一旦样本信息混乱,后面所有统计结果都可能失真。
3.2 注释版本不一致,导致基因映射错误
转录本定量文件和注释文件如果版本不匹配,汇总结果会受影响。
尤其在不同数据库、不同物种、不同批次下载的数据中,这种问题很常见。
建议坚持三个原则。
- 数据来源统一。
- 注释版本统一。
- 记录数据库版本号。
这是最基础的可复现要求。
也是很多论文答辩时最容易被追问的地方。
3.3 只会做结果图,不会解释流程逻辑
很多同学拿到火山图后就结束了。
但真正的科研写作,需要你说明:
- 数据从哪里来。
- 为什么用tximport。
- 为什么采用这个归一化方式。
- 差异筛选阈值是多少。
- 结果是否能复现。
没有流程逻辑支撑,图再漂亮也只是展示,不是证据。
硕博论文和投稿文章,最终比拼的不是图的数量,而是方法链条是否完整。
4. 如何把WorkBuddy+tximport流程用到论文和文章里
4.1 在方法学部分写清楚数据处理路径
论文方法部分最忌讳一句带过。
尤其是转录组分析,审稿人和导师都会关注细节。
建议至少写清以下内容:
- 原始数据来源。
- 定量软件名称。
- tximport用途。
- 过滤标准。
- 差异分析软件。
- 显著性阈值。
方法写得越清楚,结果越容易被认可。
这也是E-E-A-T在学术写作中的体现。
不是堆概念,而是让每一步都可追踪。
4.2 在结果部分突出“流程带来的稳定性”
结果部分不要只写“发现了多少基因”。
还要体现分析路径的稳定性。
比如可以从以下角度组织内容。
- 样本分组后聚类是否分离。
- PCA是否显示组间差异。
- 差异基因是否具有一致方向性。
- 富集结果是否与疾病机制吻合。
好的分析流程,不只是输出数据,更是提升结果可信度。
这对硕博论文尤其重要。因为答辩时,老师通常会追问“为什么这样分析”。
4.3 在课题推进中保留可复制模板
对大多数研究生来说,最有效的做法不是每次从零开始,而是建立模板。
WorkBuddy适合做的,就是把常见分析步骤沉淀下来。
这样你后续换课题、换数据,也能沿用同一套逻辑。
建议保存三类模板。
- 数据导入模板。
- 差异分析模板。
- 图表输出模板。
模板化不是偷懒,而是提高科研效率。
尤其在毕业季,模板能显著减少返工。
5. 为什么这套方案适合解螺旋的使用场景
5.1 从数据整理到分析输出,减少中间损耗
在实际科研中,最消耗时间的往往不是分析本身,而是前期整理和后期补图。
如果把tximport这类标准化流程,和WorkBuddy的任务组织能力结合起来,就能把流程压缩得更紧凑。
这对需要快速推进论文的用户很关键。
你节省下来的,不只是时间,还有反复试错的成本。
5.2 适合需要“边学边做”的硕博生
很多硕博生并不是没有数据,而是缺少一条能直接跑通的路径。
他们需要的是:
- 清晰步骤。
- 可复用模板。
- 可验证结果。
- 可持续迭代的分析方案。
这正是解螺旋在做的事情。
通过把常见生信分析流程沉淀为更容易上手的工具和支持体系,帮助用户更快完成从原始数据到论文结果的转换。
如果你希望少走弯路,优先把流程搭对,比盲目加班更有效。
总结Conclusion
WorkBuddy+tximport流程的核心价值,在于把转录组分析从“零散操作”变成“标准化链路”。
它适合硕博生完成数据导入、基因汇总、差异分析和结果输出,也更利于论文写作和复现。
如果你正在处理转录组项目,建议先把输入格式、样本表、注释版本和分析模板整理好,再进入下游分析。
想要更高效地落地这套流程,可以结合解螺旋的工具与支持服务,把重复性工作交给更成熟的分析方案,从而把精力留给课题设计和结果解释。

- 引言Introduction
- 1. 为什么WorkBuddy+tximport流程适合硕博研究
- 2. WorkBuddy+tximport流程的核心步骤
- 3. 硕博生在使用这套流程时,最容易踩的坑
- 4. 如何把WorkBuddy+tximport流程用到论文和文章里
- 5. 为什么这套方案适合解螺旋的使用场景
- 总结Conclusion