17
 分享

引言Introduction
表达矩阵导入是很多生信项目的第一道门槛。格式不对,后续差异分析、富集分析、临床关联都会卡住。对硕博生来说,真正难的不是“会不会做图”,而是能否把原始数据快速整理成可分析、可复现的标准输入 。
1. 为什么表达矩阵导入是生信分析的起点
1.1 表达矩阵决定后续分析是否成立
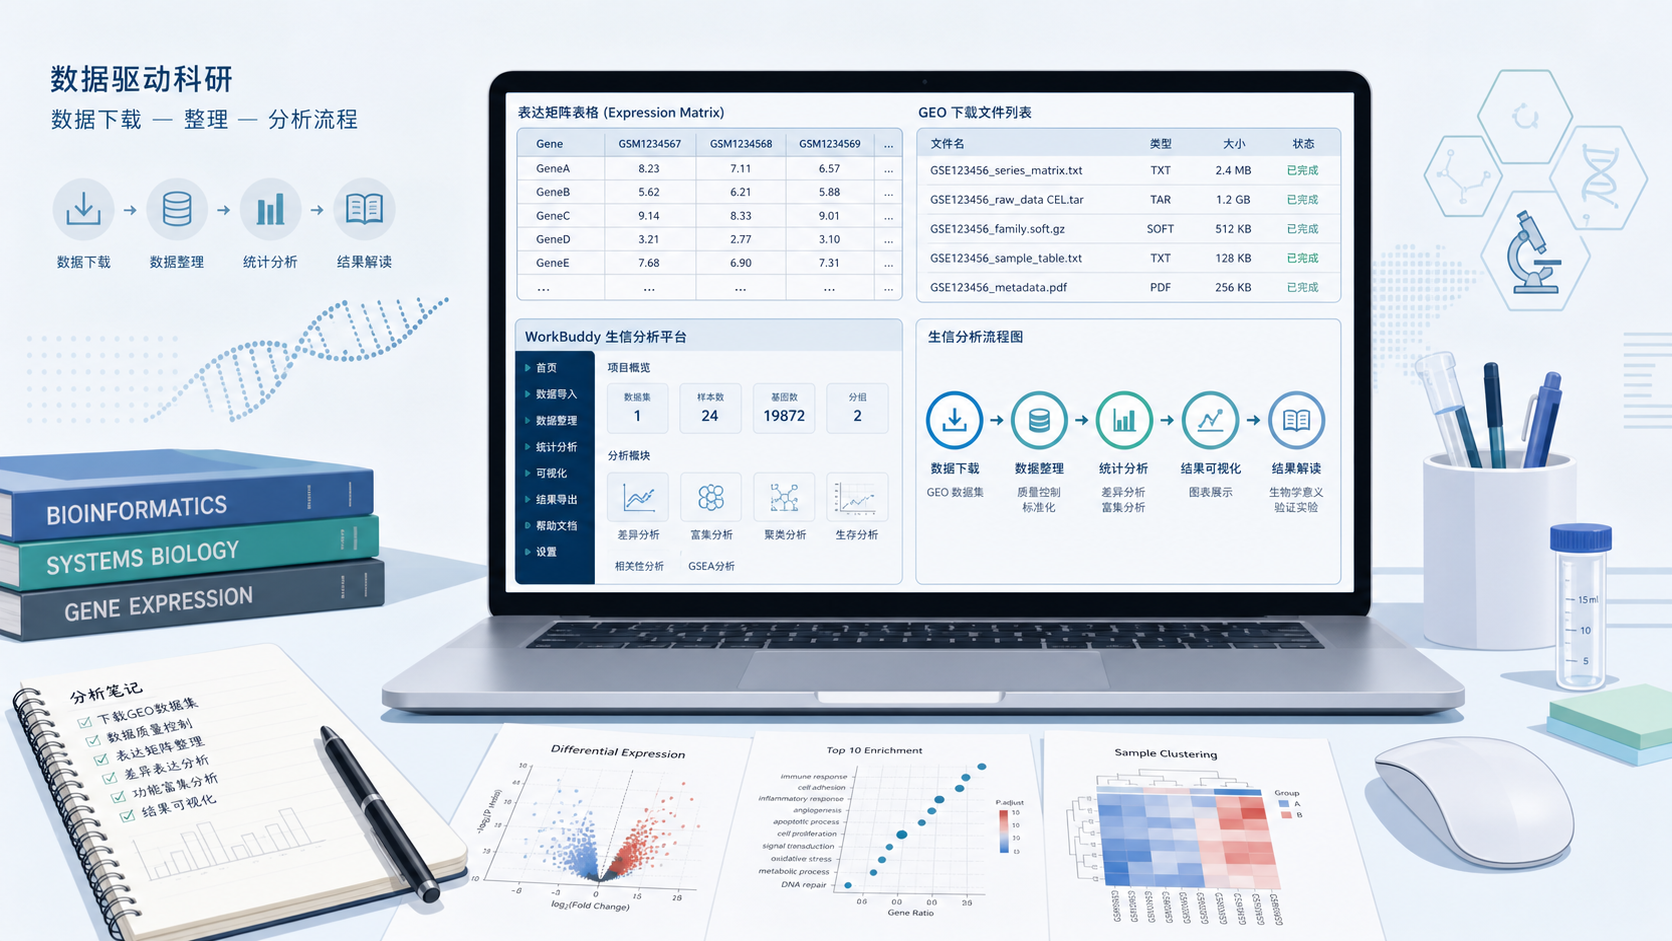
在转录组、芯片、单细胞和多组学研究中,表达矩阵是最基础的数据结构。它通常包含基因或转录本ID,以及每个样本的表达值。
如果这一层输入出错,后面的差异分析、聚类、PPI、GSEA和模型构建都会受到影响。
常见问题包括:
- 样本列顺序混乱。
- 基因ID重复或缺失。
- 行列方向错误。
- 归一化格式不统一。
- 临床分组信息没有对齐。
这些问题看似简单,却很耗时间。尤其是硕博生在赶论文、赶答辩时,反复返工非常常见。
1.2 传统整理方式效率低,且不利于复现
很多人一开始会用Excel手工处理表达矩阵。但当样本数超过20个、基因数超过1万时,手工整理就容易出错。
更麻烦的是,人工操作很难完整记录每一步,复现性差。
从科研规范来看,表达矩阵处理至少要保留以下信息:
- 数据来源。
- 过滤规则。
- ID注释方式。
- 缺失值处理方式。
- 标准化方法。
- 最终输入文件版本。
这也是为什么越来越多研究者倾向于使用标准化工具来完成导入和预处理。
2. WorkBuddy表达矩阵导入的核心价值
2.1 把“能用的数据”变成“可分析的数据”
WorkBuddy的价值,不只是导入文件。更重要的是,它帮助研究者把杂乱数据变成规范输入。
对于生信新人来说,这一步直接决定项目启动速度。
结合上游知识库中的常见分析思路,表达矩阵导入后,才能继续完成:
- 差异分子筛选。
- 功能富集分析。
- 关系网络分析。
- 临床变量关联分析。
- 预测模型构建。
也就是说,导入不是终点,而是整个分析链条的起点。
2.2 更适合零代码或低代码场景
硕博生常见的现实是,时间紧,代码基础不一,数据来源还很杂。
在这种情况下,WorkBuddy更适合用来做标准化入口。它能降低对手工脚本和反复格式转换的依赖。
尤其在以下场景中,优势更明显:
- GEO下载的表达谱需要清洗。
- 芯片数据需要注释到基因Symbol。
- RNA-seq结果需要重新组织成矩阵。
- 临床分组要和表达矩阵匹配。
- 多组学数据需要统一字段结构。
对非程序员来说,最重要的不是“炫技”,而是稳定、快速、少出错。
2.3 便于连接后续的富集和网络分析
表达矩阵一旦规范化,后续就能快速进入分析主线。
比如:
- 先做差异分析,再导出logFC。
- 再做GO、KEGG、GSEA。
- 进一步构建PPI网络。
- 再筛Hub基因。
- 最后进入生存分析或Cox回归。
这和“找主要矛盾”的思路是一致的。先把核心数据抓出来,再谈功能、关系和临床意义。
WorkBuddy的作用,就是让这个入口尽量少卡壳。
3. 表达矩阵导入前,必须先检查的4个要点
3.1 明确矩阵类型
导入前先确认你拿到的是什么数据。常见有四类:
- 原始count矩阵。
- TPM或FPKM矩阵。
- 芯片表达矩阵。
- 单细胞表达矩阵。
不同类型的数据,后续处理逻辑不同。
不要把原始count和已经标准化的表达值混用。
如果是非肿瘤或公共数据库复现,尤其要看清原文材料方法。很多文章会明确说明使用的是哪种数据类型,以及是否做过标准化。
3.2 统一ID体系
表达矩阵导入失败,最常见的原因之一就是ID不统一。比如:
- Ensembl ID与Gene Symbol混用。
- 一个基因对应多个探针。
- 同名基因重复出现。
- 物种注释版本不一致。
处理原则很简单:
- 先确定分析层级。
- 再统一到同一种ID。
- 最后去重或合并重复项。
如果是芯片数据,注释文件几乎是必需的。
如果是转录组数据,最好在导入前就完成标准化命名。
3.3 检查样本顺序和分组
表达矩阵中,样本列的顺序必须和分组文件一致。
这个问题看上去琐碎,但一旦对不上,结果就可能完全错误。
建议检查:
- 对照组和疾病组是否对应。
- 临床信息是否缺失。
- 是否有重复样本。
- 是否存在离群值。
- 分组标签是否拼写统一。
样本信息错位,是最常见也最容易被忽视的错误。
3.4 保留处理痕迹
科研写作不是一次性操作。你后面很可能要补实验、补图、返修。
因此,导入时要保留清晰的版本记录:
- 原始文件名。
- 清洗后的文件名。
- 导入日期。
- 使用的筛选规则。
- 是否删除低表达基因。
这样在论文返修时,你不会因为找不到旧文件而重复劳动。
4. 硕博生用WorkBuddy导入表达矩阵的实操思路
4.1 先清洗,再导入
更稳妥的顺序是先在本地完成基础清洗,再进入工具分析。
推荐的整理流程如下:
- 下载原始数据。
- 解压并查看表头。
- 删除无关列。
- 统一基因ID。
- 去除重复和缺失。
- 设定样本顺序。
- 保存为标准矩阵格式。
- 再导入WorkBuddy。
这样做的好处是,问题更容易定位。
如果后面结果异常,你能快速回溯到具体哪一步出了错。
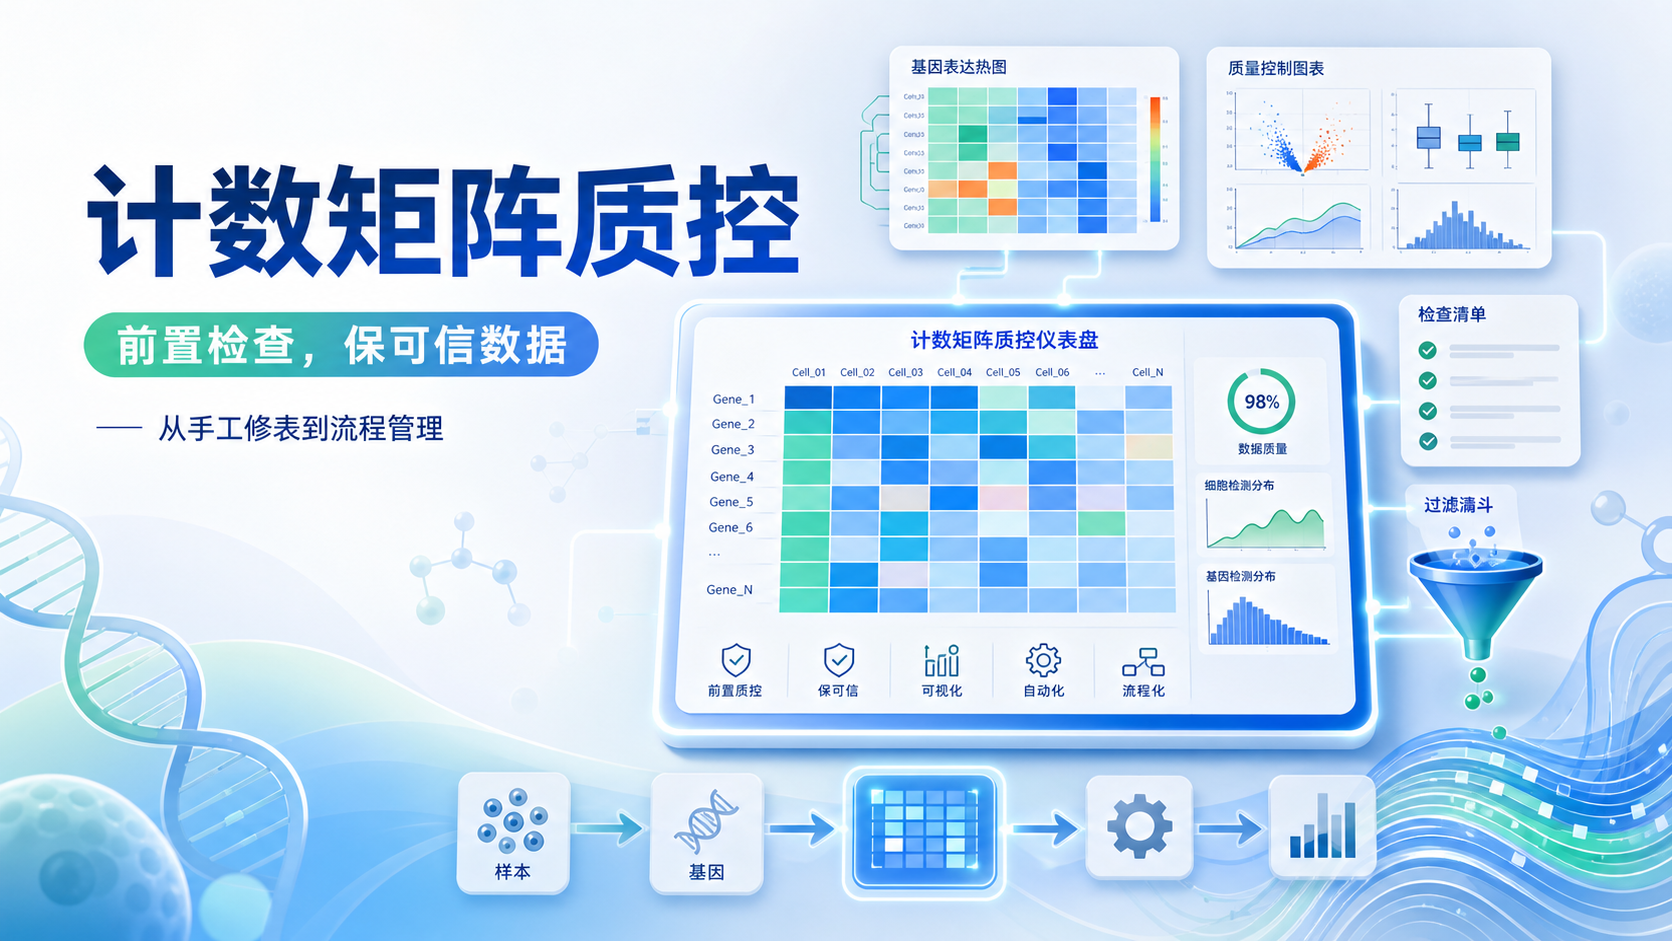
4.2 导入后先做基础质控
导入完成后,不建议马上进入差异分析。
先看几个基础指标:
- 样本数量是否正确。
- 基因数量是否合理。
- 是否有明显离群样本。
- 是否存在大量缺失值。
- 是否需要进一步标准化。
基础质控做好,后面的图才可信。
这一步对发表也很重要。审稿人常问的不是你做了多少图,而是你的输入是否可靠、流程是否规范。
4.3 用标准流程提升复现效率
对研究生来说,最宝贵的是时间。
WorkBuddy这类工具的意义,在于把复杂流程压缩成标准步骤,让你把精力放在问题本身,而不是反复处理格式。
它适合用于:
- 课题前期探索。
- 文章复现。
- 公共数据库挖掘。
- 预实验数据整理。
- 答辩前补图和补分析。
当你的流程越标准,后续沟通、返修和复现就越省力。
5. 从导入到文章,WorkBuddy如何提升整体产出效率
5.1 让分析链条更连贯
表达矩阵导入成功后,整个生信链条会顺很多。
你可以快速推进到:
- 差异表达。
- GO/KEGG富集。
- PPI网络。
- Hub基因筛选。
- 相关性分析。
- 预后分析。
- 列线图构建。
这类结果如果流程连贯,文章结构也更清晰。
一篇好的生信文章,通常不是图多,而是逻辑顺。
5.2 更适合科研协作
实验室里常见的情况是,生信、实验和临床数据分别由不同人负责。
如果表达矩阵格式不统一,协作效率会很低。
WorkBuddy这类工具的优势之一,就是帮助团队建立统一入口。
这样做有几个直接好处:
- 新人容易上手。
- 交接成本低。
- 数据结构统一。
- 出错率更低。
- 返修更快。
对于项目组来说,这比单次分析速度更重要。
5.3 降低“会做图,不会做项目”的风险
很多硕博生会卡在一个问题上。图能做出来,但项目推进不稳定。
真正的难点是把数据整理、分析逻辑和论文叙事连起来。
WorkBuddy表达矩阵导入的意义,就是帮你把第一步做稳。
当输入标准化后,你更容易判断:
- 哪些基因值得继续分析。
- 哪些通路和表型相关。
- 哪些临床变量值得纳入模型。
- 哪些结果适合写进正文,哪些适合放补充材料。
这会直接影响文章质量。
总结Conclusion
表达矩阵导入看似只是起步,实际上决定了后面所有分析是否顺畅。对硕博生来说,关键不是“有没有数据”,而是能不能把数据快速整理成标准、可复现、可继续分析的形式 。WorkBuddy在这一步的价值很明确,它能减少格式错误,提升导入效率,并帮助你更快进入差异分析、富集分析和临床建模。
如果你正在做公共数据挖掘、文章复现或课题预实验,建议优先把入口做规范。需要更高效的生信流程支持,可以直接关注并使用解螺旋,让表达矩阵导入到后续分析更省时、更稳、更适合发表。

- 引言Introduction
- 1. 为什么表达矩阵导入是生信分析的起点
- 2. WorkBuddy表达矩阵导入的核心价值
- 3. 表达矩阵导入前,必须先检查的4个要点
- 4. 硕博生用WorkBuddy导入表达矩阵的实操思路
- 5. 从导入到文章,WorkBuddy如何提升整体产出效率
- 总结Conclusion