16
 分享
引言Introduction
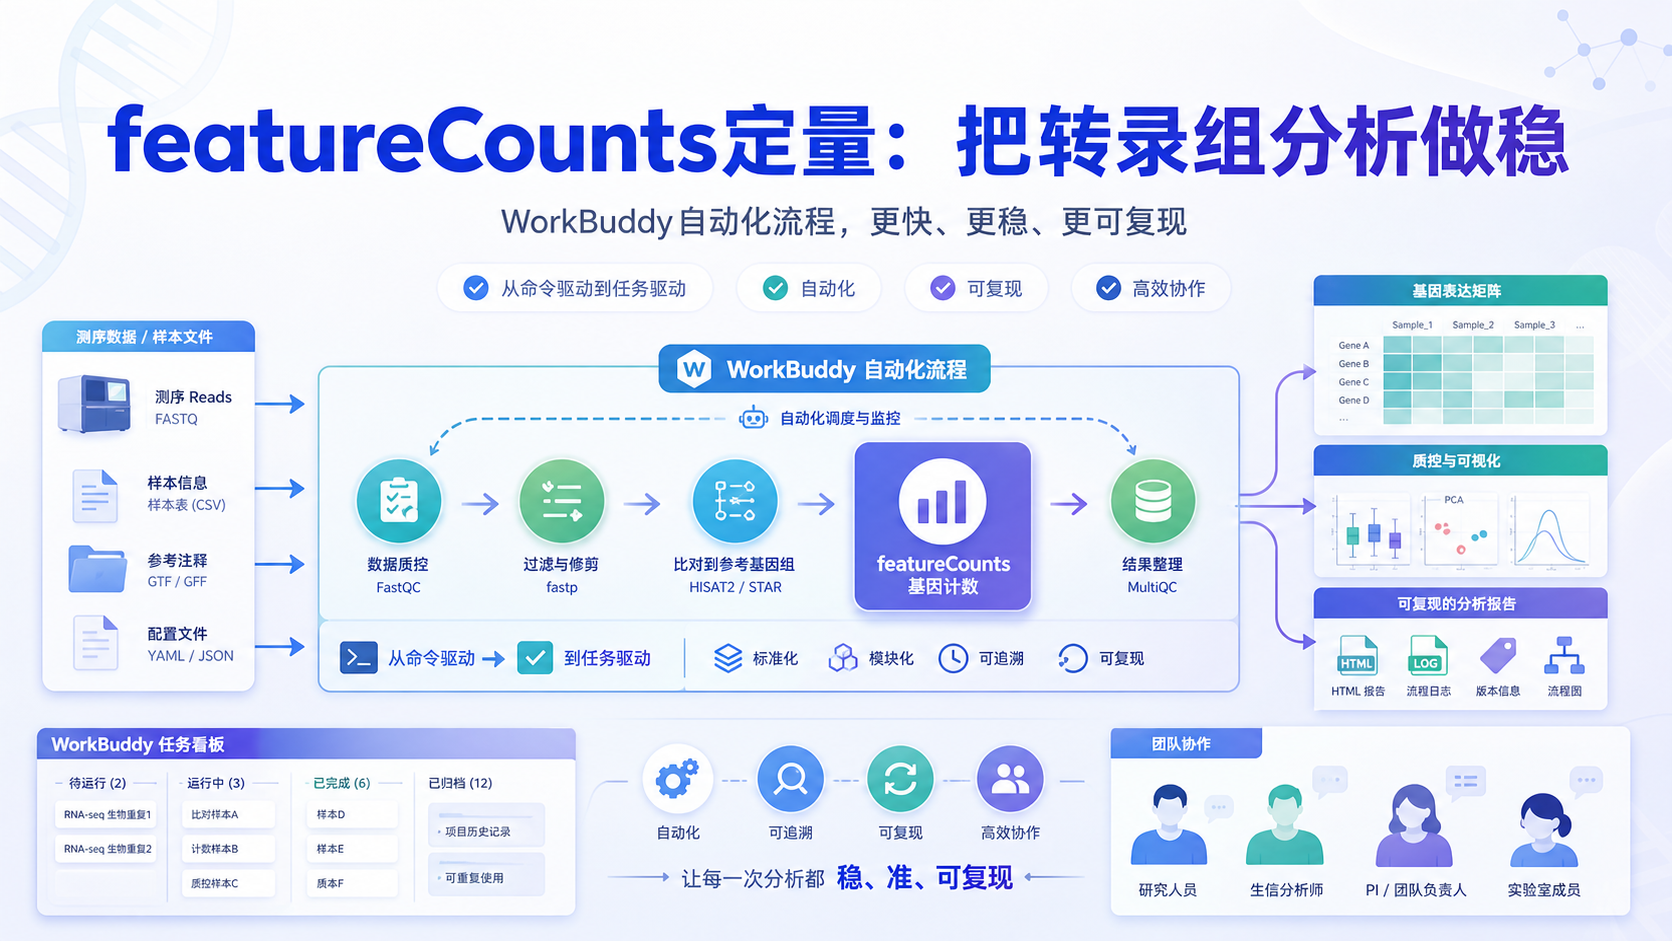
在转录组分析里,featureCounts定量往往卡在装环境、写命令、批量跑样本这几步。对医学生、医生和科研人员来说,真正耗时的不是“会不会分析”,而是“能不能稳定、快速、少出错地完成”。WorkBuddy自动featureCounts定量 ,正是在这个痛点上提供更省力的新选择。

1. 为什么featureCounts定量仍是转录组分析的关键一步
1.1 定量结果决定后续分析质量
转录组分析的第一步,不是差异分析,而是把比对后的reads准确分配到基因或转录本上。featureCounts的作用,就是完成这个“计数”环节。如果这一步偏差大,后面的差异基因、富集分析、模型构建都会被放大误差。
在实际研究里,定量阶段常见问题包括:
- GTF注释版本与参考基因组不一致。
- 多样本批量处理时,参数不统一。
- 分组样本过多,人工操作容易漏样本。
- 结果文件命名混乱,后续统计难以复现。
这些问题看起来小,但会直接影响文章质量。尤其是做疾病队列、药物干预、分组比较时,定量结果必须可追溯、可复核、可重复。
1.2 featureCounts适合标准化流程,但不适合低效手工操作
featureCounts本身是成熟工具,优势在于速度快、资源占用低、适合大样本批量计数。它常用于RNA-seq比对后的read分配,输出基因层面的count矩阵,便于进入DESeq2、edgeR等下游分析。
但问题也很明确。很多团队不是不会用,而是每次都要重复配置路径、检查索引、核对注释、整理输出 。对临床科研和课题组协作场景来说,这种重复劳动会明显拖慢进度。
所以,真正需要优化的不是featureCounts算法本身,而是围绕它的执行流程。
2. WorkBuddy如何重构featureCounts定量流程
2.1 从“命令驱动”转向“任务驱动”
WorkBuddy的价值,在于把原本依赖命令行经验的流程,转成更接近任务式管理。对研究者来说,不必每次从零搭建分析步骤,而是把样本信息、参考文件和输出目标按统一规范输入系统,再由工具自动完成定量任务。
这种方式适合以下场景:
- 批量样本定量。
- 多项目并行处理。
- 新人上手训练。
- 需要快速出初步结果的预实验。
对于没有稳定生信支持的课题组,这类自动化工具能显著降低启动门槛。
2.2 自动化的核心,是减少人为波动
featureCounts定量里最常见的问题,不是算法错误,而是人为波动。比如同一批数据,因为参数不一致,最后得到的count矩阵就不完全相同。WorkBuddy的意义就在于,通过固定流程减少操作偏差,让结果更稳定。
从科研管理角度看,这类流程至少带来三点好处:
- 参数统一,便于不同批次结果对比。
- 文件规范,便于审稿时补充方法细节。
- 操作标准化,便于团队协作和交接。
对需要发表论文的研究者而言,可复现性比“跑出来一次”更重要。
2.3 自动化不等于黑箱化
很多人担心自动化工具会让分析变成“黑箱”。这个担心是合理的。真正可用的工具,必须保留结果可追踪性。也就是说,用户应当知道:
- 用的是什么参考注释。
- 采用了什么定量规则。
- 输出了哪些统计结果。
- 哪些样本被纳入或排除。
如果一个工具只能给结果,却不能说明过程,那它不适合科研发表。
WorkBuddy这类产品的正确定位,是帮助研究者更快完成标准任务,而不是替代科研判断。
3. WorkBuddy+featureCounts定量适合哪些研究场景
3.1 适合转录组入门和论文前期筛选
对于刚进入生信分析的医学生和临床研究者,featureCounts定量常常是第一道门槛。因为它同时涉及文件格式、注释文件、样本路径和下游矩阵整理。WorkBuddy自动featureCounts定量能把这一步前移为标准化任务,适合做预实验和数据筛选。
常见应用包括:
- 疾病组与对照组表达比较。
- 干预前后转录变化分析。
- 候选基因验证前的表达筛选。
- 多组学研究中的转录组基础定量。
这类场景里,研究者更需要的是效率和稳定,而不是复杂的个性化参数堆叠。
3.2 适合多样本、多人协作的科研项目
当样本数增加后,手工定量的管理成本会快速上升。尤其是队列研究、回顾性样本研究、联合中心项目,任何一个文件命名错误或路径错误,都可能影响整批数据。自动化任务流可以把“人工记忆”变成“系统规则”。
这对团队协作很重要。因为研究生更替、项目交接、共同作者协同,都会要求流程清楚、输出明确。标准化的定量流程,能够减少沟通成本,也能减少返工。
3.3 适合需要快速形成可发表框架的课题
在基础科研里,生信分析常常不是终点,而是起点。定量之后,研究者通常还要继续做差异分析、PPI网络、富集分析、临床相关性分析,甚至构建预测模型。如果前端定量耗时太长,整个项目节奏就会被拖住。
在这种情况下,WorkBuddy的价值很直接。它把前期数据整理和featureCounts执行速度拉起来,让研究者更快进入“解释结果”和“设计验证”的阶段。
这也符合当前低成本科研的趋势。先用标准化工具锁定方向,再决定后续要不要投入湿实验资源。
4. 与传统手工流程相比,WorkBuddy的优势在哪里
4.1 更适合标准化输出
传统方式往往依赖个人习惯。不同人写的脚本、不同版本的注释、不同目录结构,都会导致结果文件风格不一致。WorkBuddy更强调流程统一,这对发表论文和内部归档都更友好。
标准化输出至少带来三种收益:
- 结果更容易整理成表达矩阵。
- 便于后续差异分析直接调用。
- 容易在方法学部分描述清楚。
4.2 更适合时间紧张的临床科研
临床科研常见现实是,样本不一定很多,但时间窗口很紧。研究者可能要同时处理病例资料、伦理流程、统计分析和文章撰写。这时,能自动完成featureCounts定量的工具,不只是省时间,更是减少认知负担。
对于非纯生信背景的用户,这一点尤其重要。因为很多人不是缺少数据,而是缺少稳定执行流程。自动化工具的意义,就是把“需要反复确认的步骤”尽量固化下来。
4.3 更利于后续复现和修改
论文返修时,经常会被问到:
- 用的是哪个版本的注释文件。
- 某些样本为什么排除。
- 定量参数是否统一。
- 结果能否复现。
如果前期流程清晰,这些问题都更容易回答。可复现性不是附加项,而是发表高质量生信文章的基本要求。
5. 结论:把定量环节做稳,后续分析才有价值
featureCounts定量看似只是转录组流程中的一环,但它决定了后面所有分析的起点质量。对医学生、医生和科研人员来说,真正的难点不是“有没有工具”,而是能否把工具稳定、规范、批量化地用起来。WorkBuddy自动featureCounts定量,正是把经验型操作转成标准化流程的新选择。
如果你的项目正卡在环境配置、批量定量、结果整理这些环节,建议优先考虑能提升效率和可复现性的方案。想把转录组分析做得更快、更稳、更适合发表,可以进一步了解解螺旋的WorkBuddy相关能力,让定量环节从负担变成优势。

- 引言Introduction
- 1. 为什么featureCounts定量仍是转录组分析的关键一步
- 2. WorkBuddy如何重构featureCounts定量流程
- 3. WorkBuddy+featureCounts定量适合哪些研究场景
- 4. 与传统手工流程相比,WorkBuddy的优势在哪里
- 5. 结论:把定量环节做稳,后续分析才有价值