12
 分享
引言Introduction
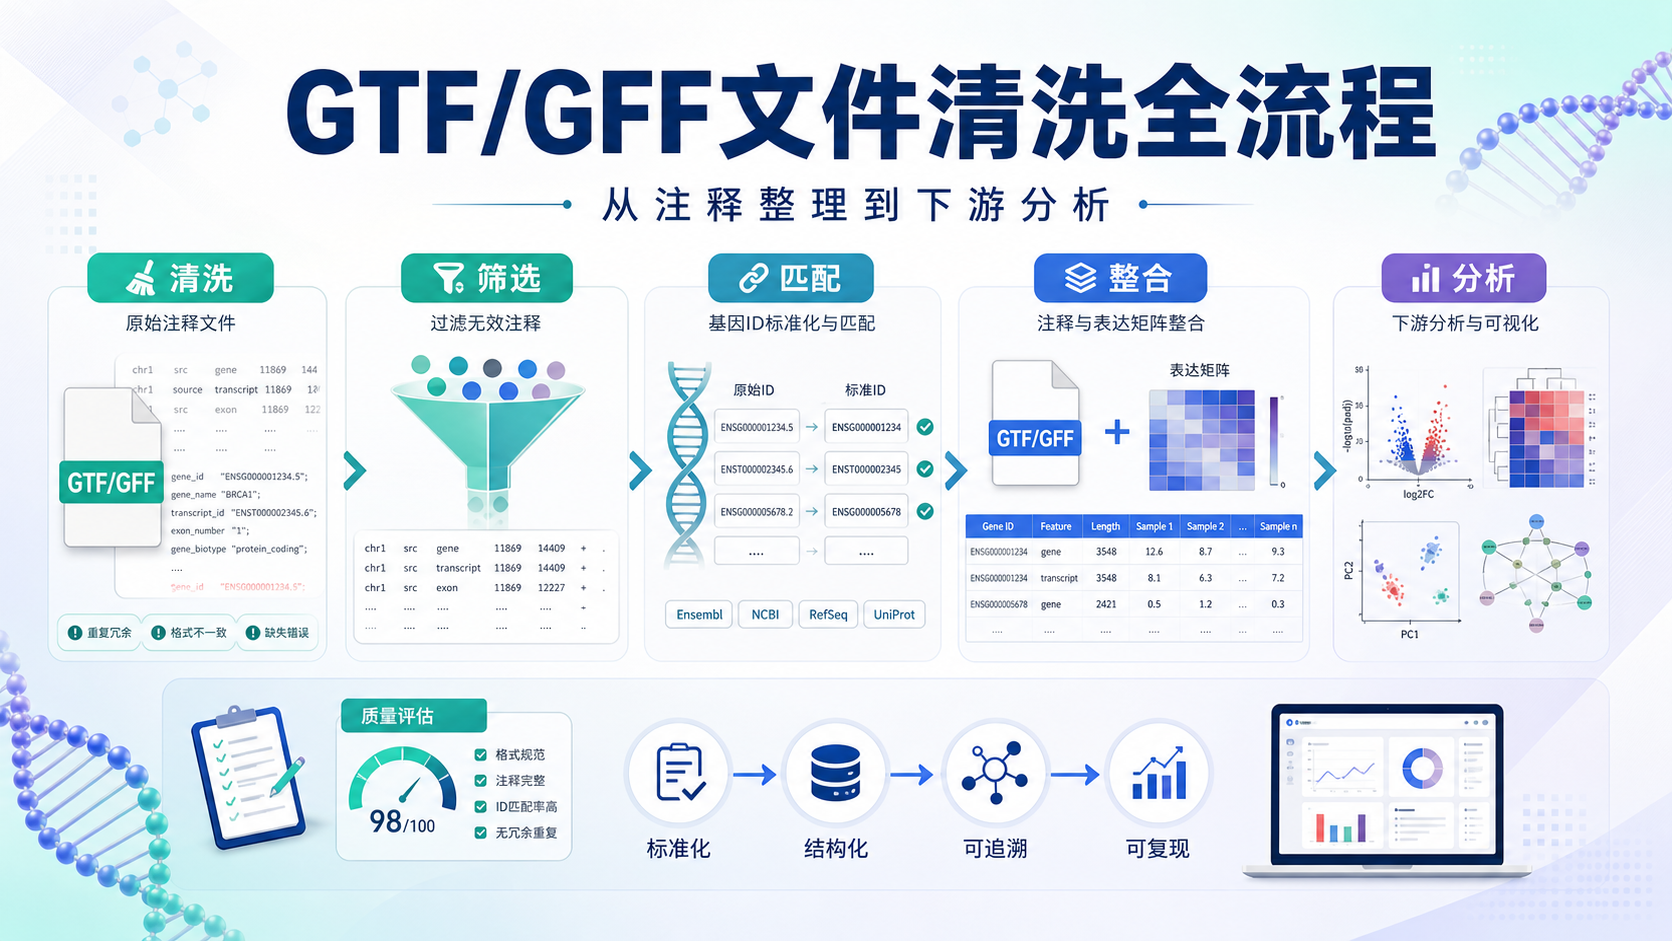
GTF/GFF文件结构复杂,字段多、注释杂、列名长,直接处理很容易出错。对医学生、医生和科研人员来说,真正的痛点不是“能不能打开”,而是如何快速清洗、筛选、标准化并保留可用于下游分析的注释信息 。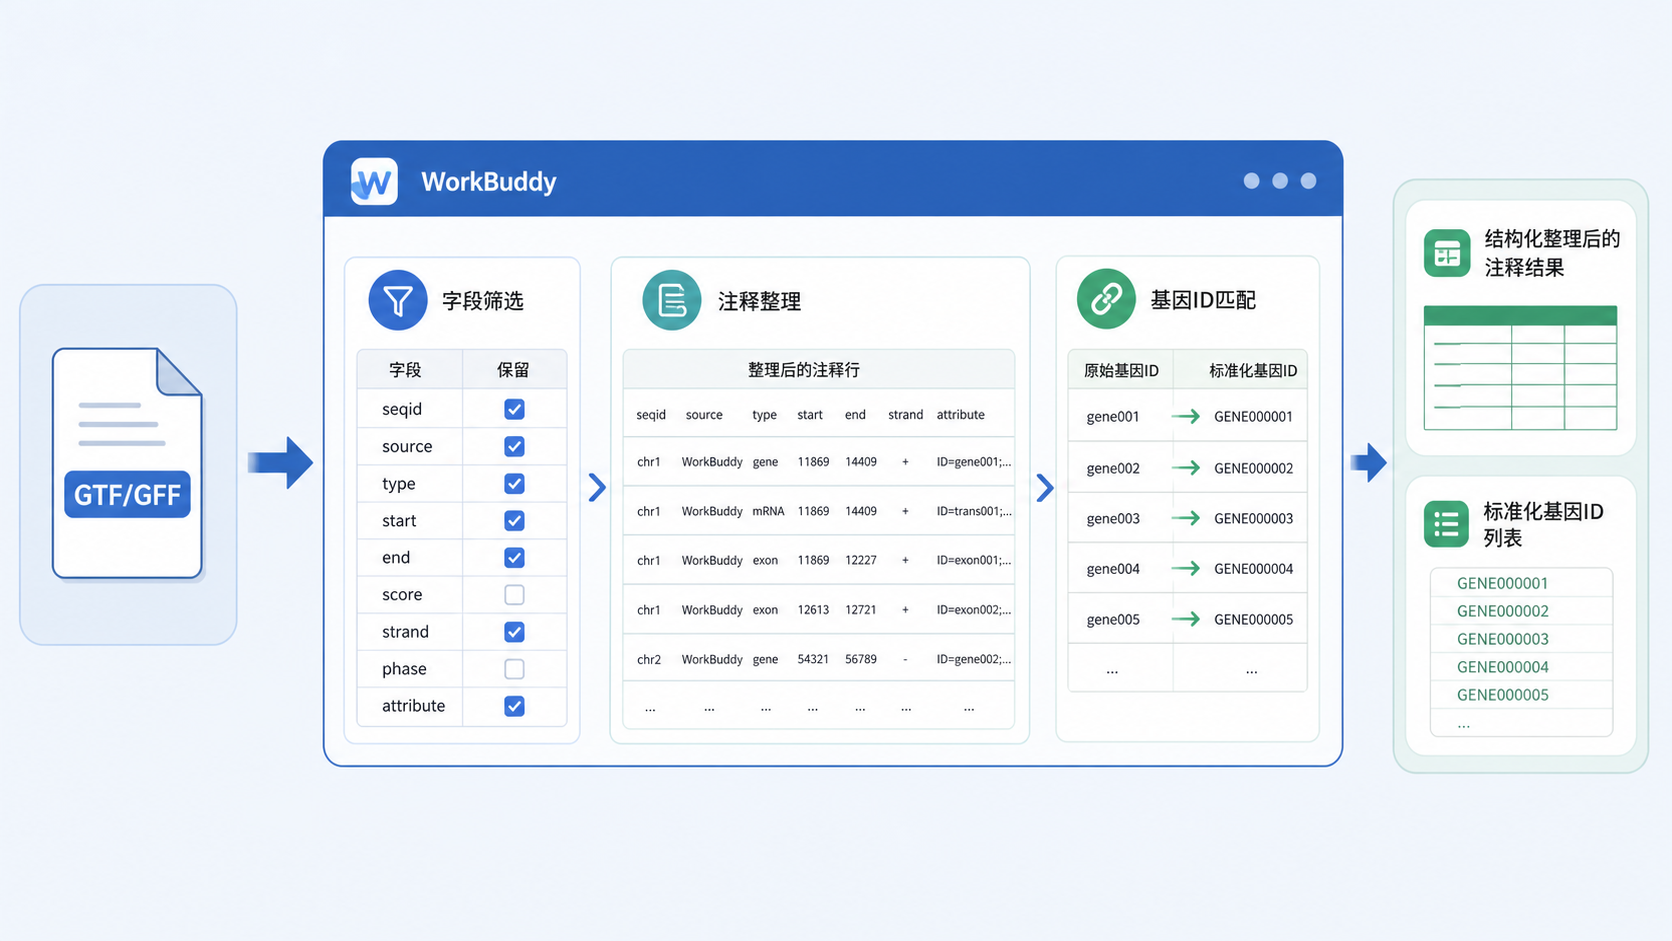
1. 先看清GTF/GFF文件到底包含什么
1.1 GTF/GFF不是“普通表格”
GTF/GFF本质上是基因组注释文件。常见字段包括染色体位置、转录本信息、基因ID、基因名、feature类型和属性列。
如果不先理解字段含义,后面的筛选和匹配很容易把关键信息删掉。
在TCGA、Ensembl、UCSC等数据源中,注释文件格式可能不完全一致。
但核心目标一致。就是把“原始注释”整理成可直接用于表达矩阵、差异分析和可视化的标准信息。
1.2 处理前先明确你要什么
在进入WorkBuddy前,先回答3个问题。
- 你要的是gene层面、transcript层面,还是exon层面。
- 你后续是做差异分析,还是做基因ID转换。
- 你是否只需要protein coding等特定类型。
目标越清晰,删除的列越准确,后续分析越稳。
2. 第一步,导入文件并快速识别关键列
2.1 先读取原始GTF/GFF
在WorkBuddy中导入GTF/GFF文件后,第一件事不是马上筛选,而是先检查总列数和字段类型。
通常需要优先确认这些列:
- gene_id
- gene_name
- gene_type 或 gene_biotype
- feature
- chromosome
- start 和 end
如果是来自TCGA或类似数据库的整理版注释,部分信息可能已经标准化。
这时可以减少重复注释步骤,直接进入筛选。
2.2 先删无用字段,再保留核心信息
如果文件中某些列已经没有分析价值,比如重复的type列,或者与当前任务无关的辅助字段,可以先删除。
保留的原则只有一个,凡是不影响下游分析的列都可以先移除。
对于表达矩阵关联分析,最重要的是:
- 基因ID
- 基因名
- 基因类型
- 与样本对应的表达信息
这样做的好处是,数据更轻,后续匹配速度更快,也更不容易在大文件处理中发生混乱。
2.3 样本列命名要统一
如果你的输入文件中包含多个样本列,建议尽早统一命名规则。
例如把TCGA样本名截取到前16位,用于匹配metadata或表达矩阵。
统一列名,是后续合并、分组和配对分析能否顺利进行的关键。
3. 第二步,按研究目的筛选注释类型
3.1 先筛掉不需要的注释类型
在基因注释处理中,最常见的任务是只保留protein coding基因。
因为很多下游分析,如差异表达、通路富集和机器学习建模,主要关注的是编码蛋白的基因集合。
如果全表保留,常见问题有:
- pseudogene混入
- lncRNA干扰统计
- 低信息量条目增加噪音
所以在WorkBuddy中,建议先按gene_type或gene_biotype筛选。
只保留研究真正需要的类型,可以显著提升数据可解释性。
3.2 按feature层级进一步过滤
如果你的任务是转录本分析或外显子分析,还需要按feature字段筛选。
常见层级包括:
- gene
- transcript
- exon
- CDS
不同层级对应不同分析场景。
例如做表达矩阵关联时,通常以gene层级为主。
而做剪接变体研究时,就需要更细的transcript或exon层级。
3.3 过滤后立即检查结果
筛选完成后,不要直接保存。
先检查以下内容:
- 剩余记录数是否合理
- gene_id是否仍完整
- gene_name是否存在大量NA
- 目标类型是否真的被单独保留
先验证,再保存。这样能避免把错误筛选结果带入后续分析。
4. 第三步,完成基因ID和注释信息整理
4.1 基因ID转换是基础技能
很多原始数据只提供gene_id,没有直接可读的gene_name。
这时就必须做ID转换。
比如通过注释文件把gene_id映射到gene_name和gene_type。
在WorkBuddy中,常见流程是:
- 导入表达矩阵或注释表。
- 导入GTF/GFF注释文件。
- 用gene_id做匹配。
- 输出gene_name、gene_type等新列。
没有ID转换,很多结果只能停留在“编号层面”,不利于解释和发表。
4.2 匹配后要处理NA
ID匹配后,部分条目可能显示NA。
这通常说明这些基因ID不在当前注释文件中,或者版本不一致。
这类数据一般应进一步过滤。
建议保留规则:
- 无法注释的条目先剔除
- 重复映射的条目按研究目的处理
- 关键基因可单独人工核查
这样能减少后续差异分析中的异常值和重复条目问题。
4.3 统一行名和列名
处理完注释后,建议把gene_id设为行名,gene_name放到相邻列。
如果是样本表达矩阵,也要同步整理成统一格式。
一个干净的矩阵结构,能显著提升后续建模、绘图和统计效率。
5. 第四步,和表达矩阵联动,形成可分析数据
5.1 只保留需要的样本列
如果你的目标是配对样本差异分析,就只保留配对样本对应的列。
例如肿瘤样本和正常样本各一半,且必须来自同一患者。
常见做法是:
- 截取TCGA ID前16位
- 按样本类型区分01和11
- 统计每位患者样本数
- 仅保留同时具有肿瘤和正常组织的患者
这一步决定了你后面做的是“真实配对差异”,还是混杂样本比较。
5.2 低表达基因要先过滤
低表达基因会增加噪音。
在mRNA矩阵中,常见过滤逻辑是:
如果一个基因在达到一定数量的样本中表达量大于0,才保留。
这样做的原因很直接。
低表达基因往往不稳定,容易影响标准化和差异分析的结果。
尤其在DESeq2等方法中,适当过滤低计数基因是标准操作之一。
5.3 保存中间结果,减少重复劳动
完成筛选后,建议把整理好的对象保存下来。
包括:
- 过滤后的注释文件
- 配对样本metadata
- 过滤后的表达矩阵
- 标准化前后数据
中间结果可复用,能节省大量重复清洗时间。
6. 第五步,用WorkBuddy把清洗结果用于下游分析
6.1 标准化前先做质量评估
正式分析前,建议先做基础质控。
常见检查包括:
- 箱线图
- 密度图
- PCA图
如果标准化前分布不一致,说明样本间存在较大技术差异。
标准化后,分布应更趋一致。
PCA图则能帮助判断肿瘤和正常样本是否有合理分离。
如果质控不过关,后续差异分析再精细也不可靠。
6.2 标准化后的注释更适合下游统计
经过WorkBuddy整理后的GTF/GFF信息,可以直接服务于多个场景:
- 差异表达分析
- 注释后富集分析
- 核心基因筛选
- 免疫浸润关联
- 生存分析
在这个阶段,注释文件不再只是“说明书”,而是分析链条中的关键输入。
它决定了你的表达矩阵能否被准确解释。
6.3 为什么推荐用WorkBuddy
对大多数研究者来说,GTF/GFF处理最耗时间的不是算法,而是反复清洗、字段对齐和格式转换。
WorkBuddy的价值在于把这些重复动作标准化。
你可以更快完成:
- 字段筛选
- ID匹配
- 类型过滤
- 样本整理
- 中间结果输出
这能让研究者把更多时间放在结果解释,而不是机械整理文件。
最后,如果你希望把GTF/GFF处理、ID整理和注释标准化做得更稳、更快,借助解螺旋的WorkBuddy会更省力。它适合把碎片化的注释文件快速整理成可直接进入分析流程的数据。对于需要频繁处理TCGA或其他数据库注释的团队来说,这一步能明显减少重复劳动,也降低格式出错风险。
总结Conclusion
GTF/GFF处理的核心不是“打开文件”,而是筛选、注释、匹配和标准化 。
按这5步走,先识别字段,再筛选类型,接着完成ID转换,然后联动表达矩阵,最后进入质控和下游分析,流程就会清晰很多。
对医学生、医生和科研人员来说,真正高效的做法,是把复杂注释处理变成可复用的标准流程。
如果你希望进一步提升GTF/GFF整理效率,可以试试解螺旋 提供的WorkBuddy,让基因注释处理更快、更稳、更适合科研场景。

- 引言Introduction
- 1. 先看清GTF/GFF文件到底包含什么
- 2. 第一步,导入文件并快速识别关键列
- 3. 第二步,按研究目的筛选注释类型
- 4. 第三步,完成基因ID和注释信息整理
- 5. 第四步,和表达矩阵联动,形成可分析数据
- 6. 第五步,用WorkBuddy把清洗结果用于下游分析
- 总结Conclusion