15
 分享
引言Introduction
短读和长读数据各有优势,但真正难的是把组装、质控、注释和下游分析串成一条稳定流程。很多团队卡在工具切换、参数配置和结果复现上,最后耗掉时间,却难以产出可用结论。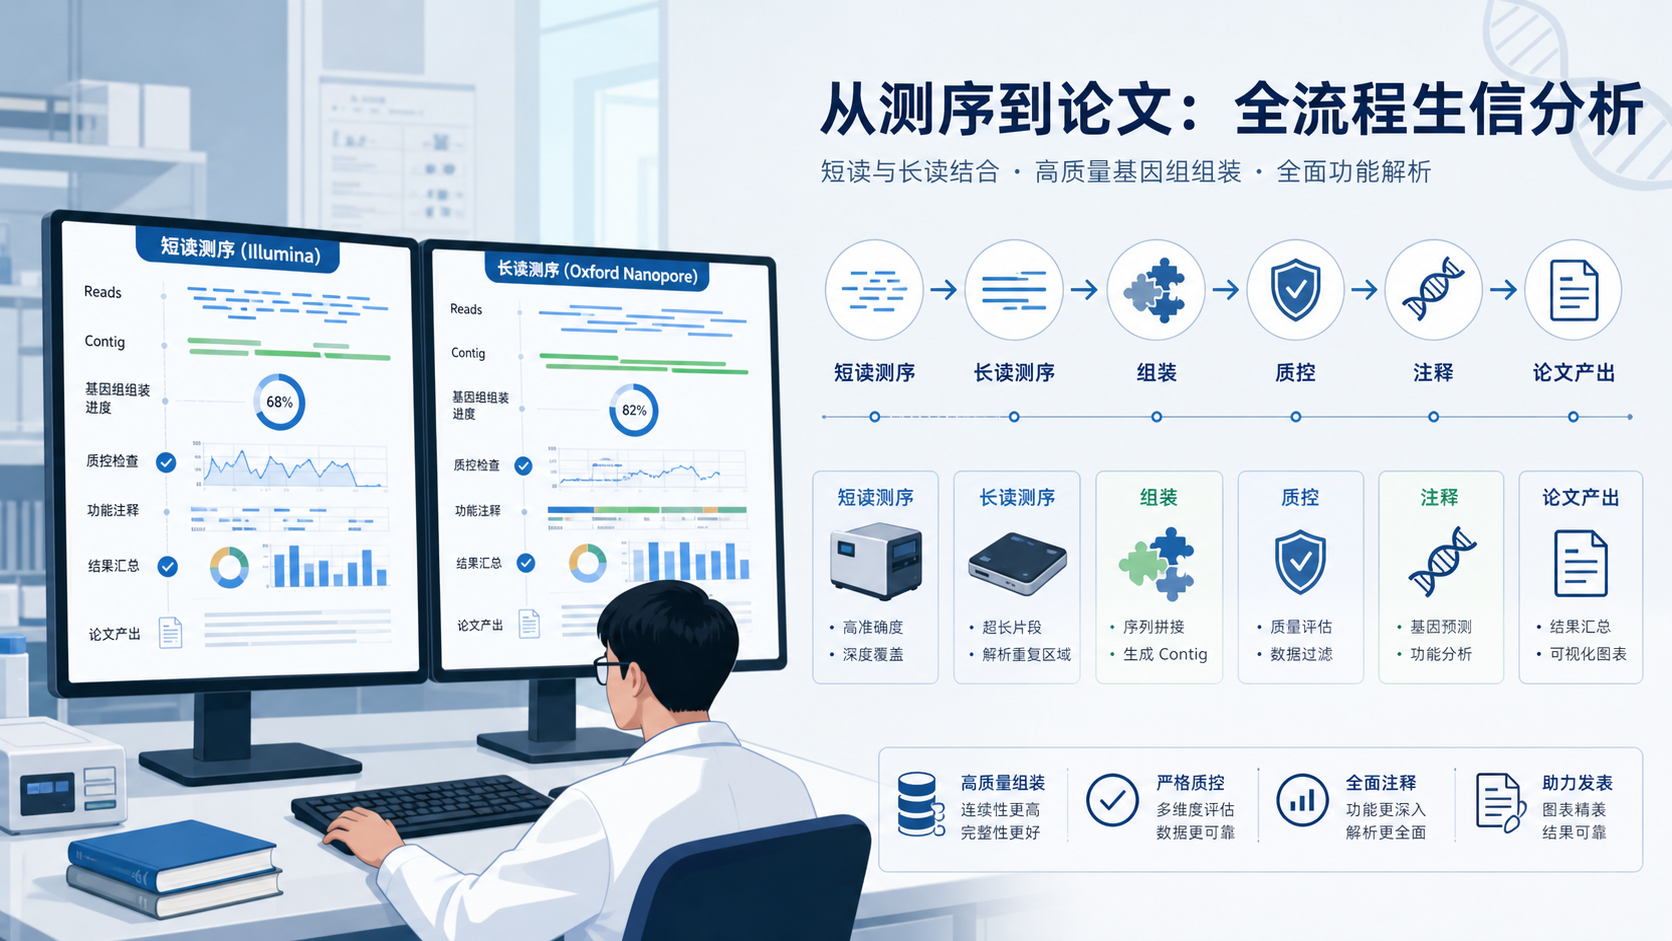
1. 为什么短读长组装后的流程更考验效率
1.1 数据类型不同,流程复杂度显著增加
短读测序适合高准确度、低成本的数据采集,长读测序更适合跨越重复区域、提升连续性。当两类数据联合用于组装时,真正的难点不在“能不能做”,而在“能否稳定做完并得到可信结果”。
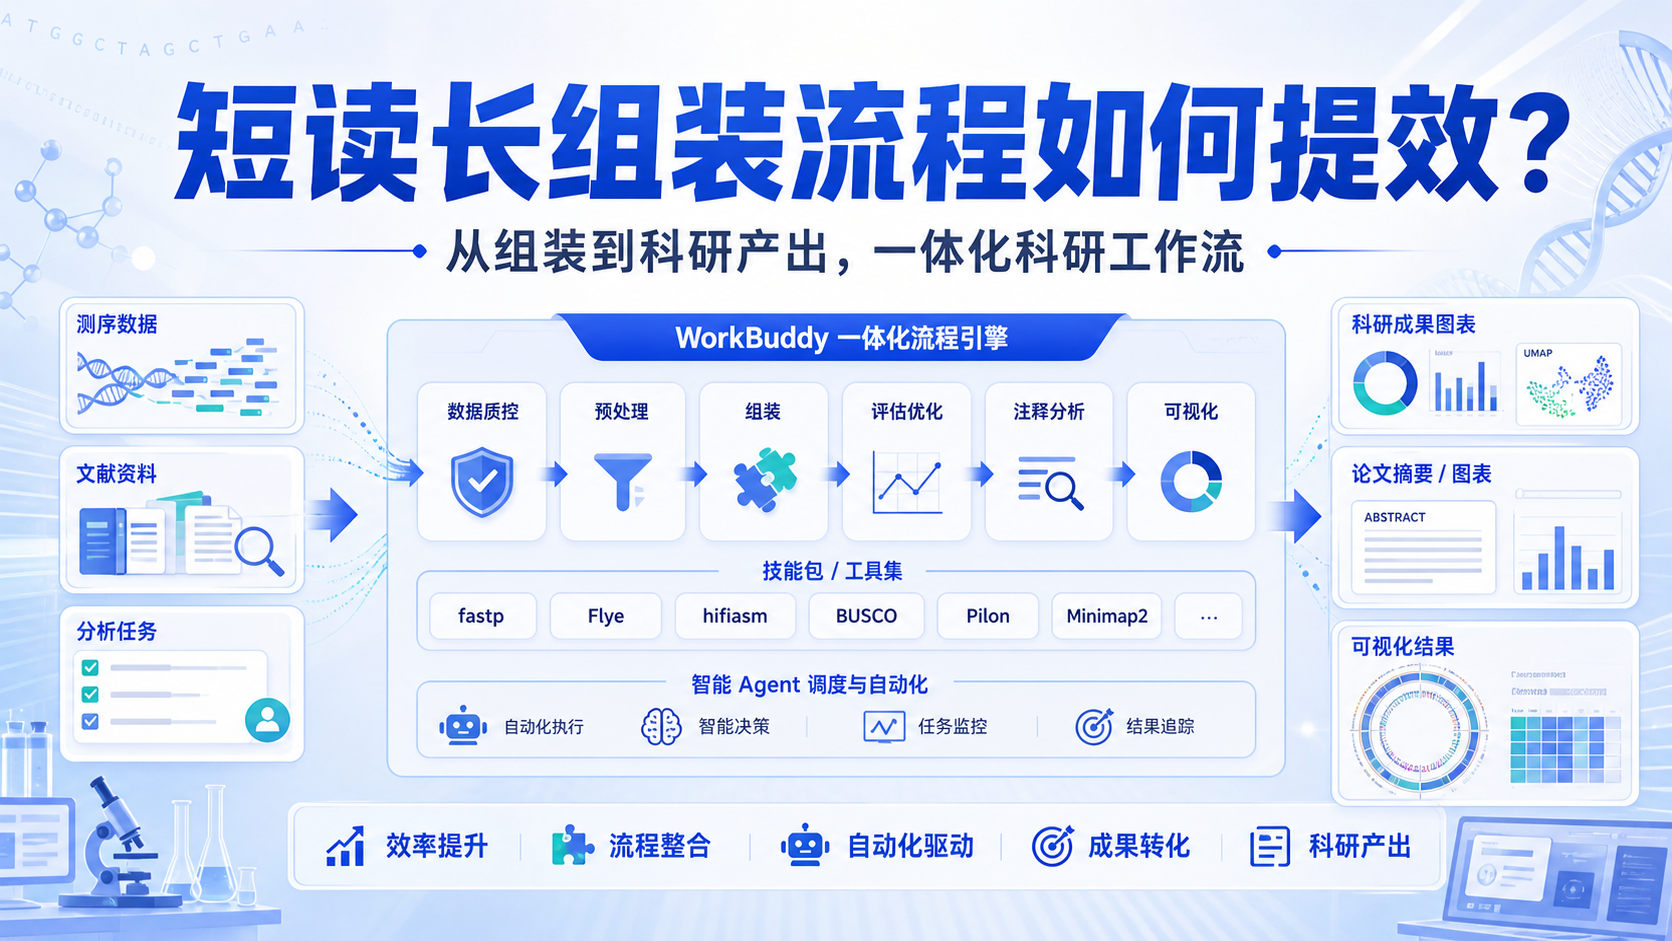
从科研实践看,短读长组装通常会经历几个环节。
- 原始数据质控。
- 组装策略选择。
- 错误校正。
- 组装评估。
- 注释与功能分析。
- 结果整理和论文写作。
每一步都可能引入软件切换、格式转换和人工检查。对医学生、医生和科研人员来说,这种链条式流程最容易拖慢节奏。
1.2 传统方式的问题在于碎片化
很多人会分别使用不同工具完成每个任务。这样做并非不可行,但会带来三个现实问题。
- 参数分散,学习成本高。
- 结果文件格式不统一。
- 复现时容易遗漏关键步骤。
对临床与生物医学研究而言,数据分析不仅要快,更要可追溯、可验证。 如果每一步都依赖手工记忆,后续复核和重复分析就会变得非常困难。
1.3 组装之外,真正决定产出的是后续转化
短读长组装完成后,研究并没有结束。更关键的是把组装结果转化为可发表内容,包括基因注释、变异分析、比较分析和图表输出。很多项目不是死在组装阶段,而是卡在“如何把结果写成文章”。
这也是为什么越来越多团队开始寻找一套能够贯穿前期分析和后期写作的工作流工具。
2. WorkBuddy如何覆盖短读长组装的核心流程
2.1 一体化工作流减少切换成本
根据上游知识库,WorkBuddy的定位并不只是单点AI工具,而是覆盖科研多个场景的工作流体系。它可以把文献阅读、方案设计、写作和数据处理串联起来,减少频繁切换平台的损耗。
对于短读长组装这类任务,一体化的价值在于:同一套知识库和技能包可以支持从数据理解到结果整理的连续操作。
这意味着用户不必在多个独立软件之间反复导入导出,只需在一个体系内完成大部分操作。
2.2 通过技能包把标准流程工程化
知识库中提到,解螺旋正在把生物医学领域的技能包做成可调用资源,包括查文献、做方案、摘要写作、综述生成和数据作图等。更重要的是,这些技能包是文档化流程参数,可由人工修改,也可由AI按指令调整。
这对科研场景很关键。
- 标准化流程更容易复现。
- 参数可追踪,便于审稿和复核。
- 可以根据项目特点进行局部修改。
对做短读长组装的人来说,工程化流程比“每次现写一遍”更可靠。
2.3 从组装到科研产出,重点在结果表达
WorkBuddy的价值不止于分析,还体现在结果输出。知识库中提到,它可以支持摘要、论文、综述、deep research和数据作图。也就是说,分析完成后,用户可以继续在同一体系中完成文本组织与图表整理。
这对临床科研尤其有用。因为很多研究不是缺数据,而是缺把结果讲清楚的能力。如果组装结果、统计结果和图表输出能够在同一工作流中完成,科研产出速度会明显提升。
3. WorkBuddy在科研场景中的实际优势
3.1 适合从文献到课题的连续任务
短读长组装通常不是孤立任务,它往往与课题设计、机制假设和论文写作连在一起。知识库明确提到,WorkBuddy可用于查文献、读文献、做方案、从文献提方案,并可延伸到摘要和综述写作。
这意味着它更适合下面几类需求。
- 先读文献,再定组装策略。
- 先做数据,再反推课题切口。
- 先出结果,再快速整理成论文框架。
对于时间紧张的临床科研团队,这种连续性比单点功能更重要。
3.2 模型选择更贴近实际使用环境
知识库提到,目前多数流程使用 deepseek,主要考虑国内合规性和性价比。对于很多高校、医院和研究机构来说,这一点很现实。模型选择不只是技术问题,还涉及部署成本、权限管理和使用稳定性。
此外,知识库也提到,部分工作站需要会员权限,但学员可申请免费 key。对实际用户而言,这降低了试用门槛,也便于团队快速评估工具是否适合自己的研究方向。
3.3 对数据分析的态度更谨慎
值得注意的是,知识库对数据分析部分给出了非常明确的专业判断。它指出,AI现写代码虽然可以辅助,但如果用户本身不懂代码,就很难保证结果一定正确。
这是一种务实态度。因为数据分析的核心不是“看起来能跑”,而是“能否验证、可否复现”。知识库也提到,未来更理想的方向是让AI调用固定R包和既定流程,而不是完全依赖随机生成代码。
这对科研人员来说是重要信号。好的工具不是替代判断,而是放大专业判断。
4. 从评测角度看,WorkBuddy适合谁,不适合谁
4.1 更适合这些用户
如果你符合以下情况,WorkBuddy的价值会更高。
- 经常处理文献、方案和写作。
- 需要把分析和文章产出连起来。
- 希望减少软件切换和重复劳动。
- 需要更标准化、可复现的科研流程。
尤其是医学生、住院医、规培生、临床科研人员和生信初学者,往往既要做研究,又要兼顾临床或学习任务。对这类人群,节省流程时间本身就是科研效率提升。
4.2 需要保持理性使用的场景
如果你的项目已经有成熟的生信管线,且团队有稳定的数据工程能力,那么WorkBuddy更适合用于提效,而不是完全替代现有体系。
此外,知识库也强调,目前数据分析流程仍在构建中,自动化能力还在迭代。这说明它更适合作为“科研协同平台”和“流程加速器”,而不是对所有复杂分析都一键终结的黑箱系统。
任何涉及临床和组学数据的分析,都必须保留人工审核环节。
5. 未来价值:从工具集合到科研自动化
5.1 技能包和Agent是下一步重点
知识库明确提到,团队正在把技能包和agent工程化,让AI在加载技能包后可自动执行写标书、做选题分析等任务。这个方向的意义很大。
因为科研人员最缺的,从来不是单一功能,而是连续执行能力。未来如果能把短读长组装、结果解释、论文初稿和图表生成串成自动流程,科研效率会发生明显变化。
5.2 为什么“可修改的流程”更有长期价值
相比完全黑箱的AI,文档化技能包更适合科研场景。原因很简单。
- 参数可改。
- 过程可查。
- 结果可审。
- 更容易团队协作。
这类机制比单次生成文本更接近真实科研需求。
5.3 解螺旋的价值在于把复杂流程变简单
如果你希望把短读长组装、文献整理、方案生成和论文写作放进同一条工作流里,解螺旋提供的是更接近科研真实场景的工具体系。它不是只解决一个步骤,而是尽量减少你在多个系统之间来回切换的损耗。
对正在做组装项目、临床科研或论文产出的用户来说,这种“从数据到文章”的连续能力,往往比单点AI更有实际意义。想把短读长组装真正转化为科研产出,可以优先了解解螺旋的WorkBuddy体系。
总结Conclusion
短读长组装的难点,不只是组装本身,而是如何把前期分析、结果整理和论文产出连成闭环。WorkBuddy的优势在于一体化、技能包化和流程化,适合文献、方案、分析和写作的连续场景。它更像科研提效平台,而不是单一工具。
如果你正在寻找能把组装结果快速转化为科研成果的方案,可以进一步了解解螺旋的WorkBuddy。 对于需要兼顾准确性、复现性和产出效率的医学生、医生与科研人员来说,这会是更务实的选择。

- 引言Introduction
- 1. 为什么短读长组装后的流程更考验效率
- 2. WorkBuddy如何覆盖短读长组装的核心流程
- 3. WorkBuddy在科研场景中的实际优势
- 4. 从评测角度看,WorkBuddy适合谁,不适合谁
- 5. 未来价值:从工具集合到科研自动化
- 总结Conclusion