13
 分享
引言Introduction
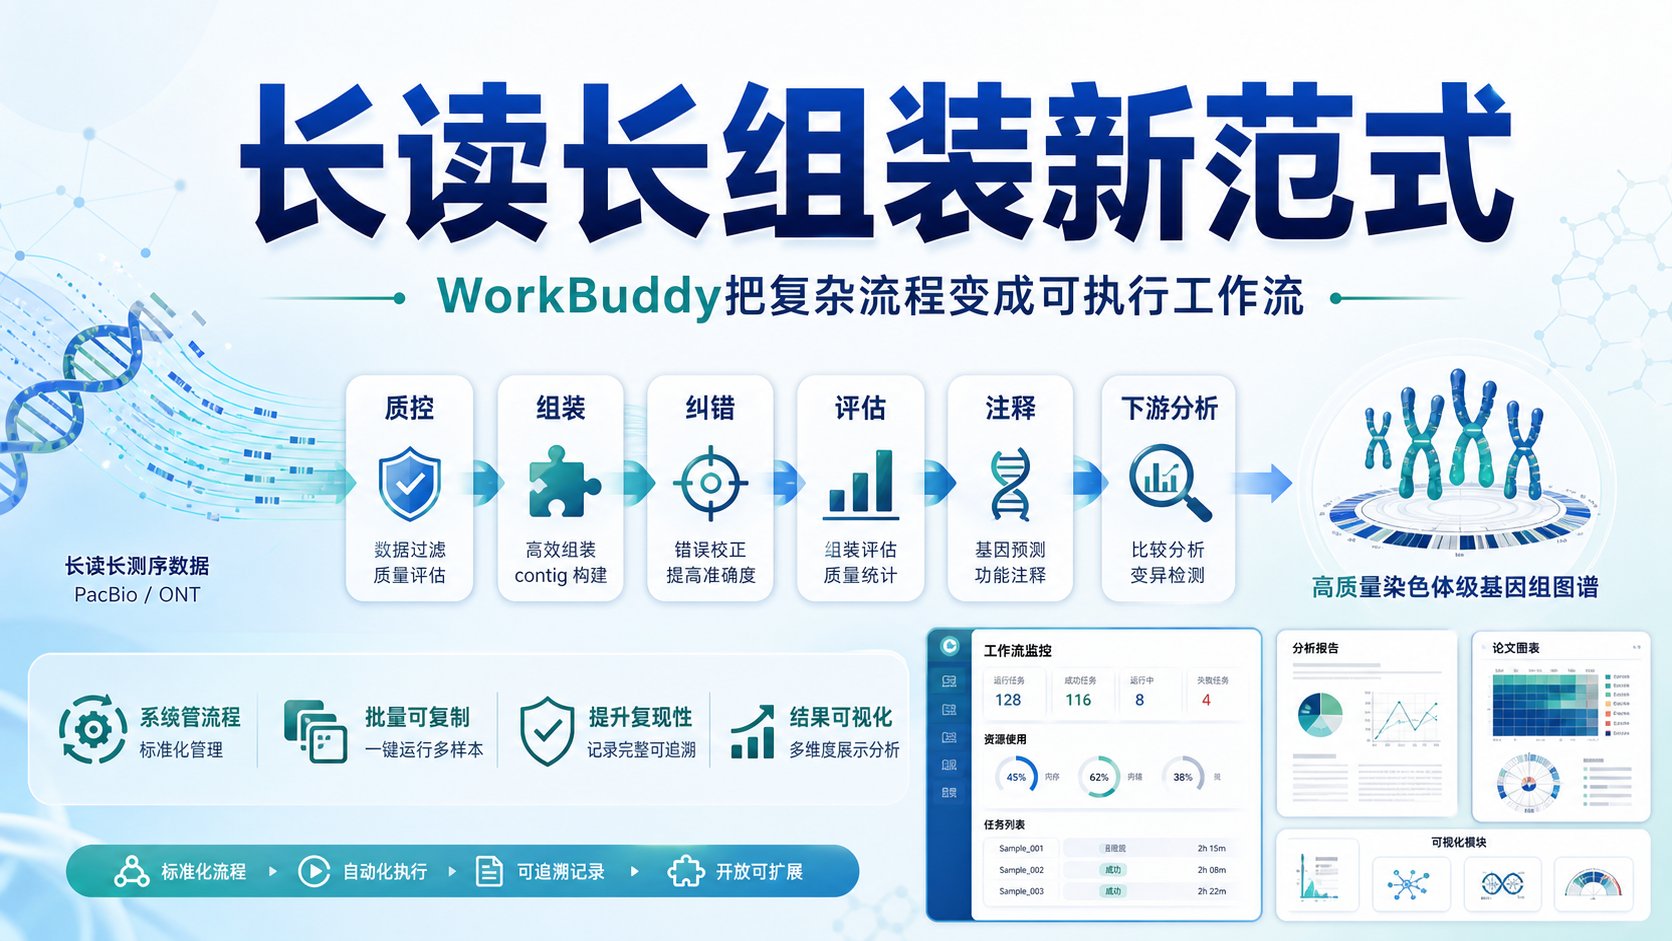
长读长组装正在重塑基因组研究,但数据量大、流程长、算力要求高,常让科研人员卡在质控、组装、校正和注释之间。如果没有稳定的自动化流程,项目周期会被显著拉长。 本文从实战角度拆解 WorkBuddy 如何帮助团队提升长读长组装效率。
1. 长读长组装为什么需要新范式
1.1 长读长数据的优势,也意味着更复杂的流程
长读长测序,通常指 PacBio HiFi 或 Oxford Nanopore 数据。它的优势很明确。读长更长,跨越重复区能力更强,更适合完成高连续性组装。
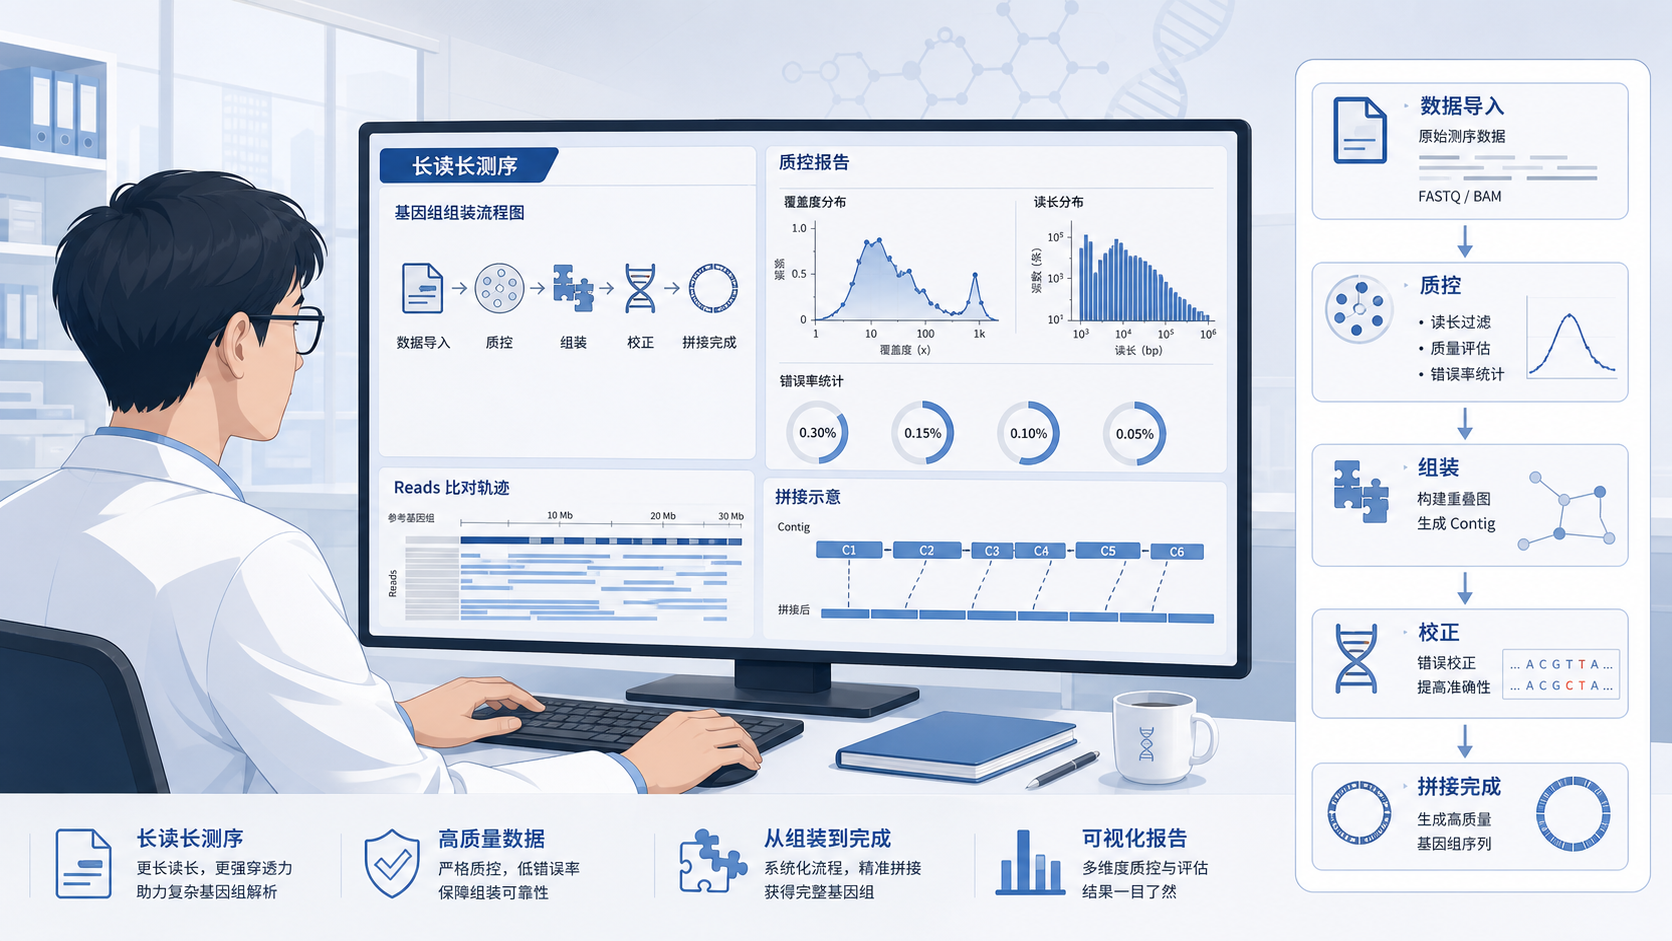
但问题也同样突出。数据文件更大,错误模式更复杂,参数选择更敏感。一个项目往往要经历原始数据质控、去接头、组装、纠错、去冗余、评估和注释多个环节。
对于医学生、医生和科研人员来说,真正的难点不是“会不会跑一个软件”。而是如何把一条完整流程稳定跑通,并且保留可追溯性。尤其在论文和课题申报中,流程是否标准化,直接影响结果可信度。
1.2 传统手工分析的瓶颈很明显
传统长读长组装通常依赖人工串联多个工具。常见问题包括:
- 不同软件版本不一致。
- 参数记录不完整。
- 中途失败后难以定位原因。
- 不同样本复现性差。
- 结果图表和报告分散,整理成本高。
这会带来两个后果。第一,分析效率下降。第二,文章和标书的证据链变弱。对于需要快速产出结果的团队,单点工具已经不够,必须转向流程化、模块化和自动化。
1.3 WorkBuddy的价值在于把流程变成可执行模块
WorkBuddy的意义,不是替代生信判断,而是把复杂任务拆成标准步骤。对于长读长组装,这种方式特别重要。因为组装项目天然依赖多个环节串联,任何一步出错都会影响后续分析。
把分析流程模块化,才能把“经验型操作”变成“可复用流程”。
这也是长读长组装的新范式。它不只是做完数据分析,而是让分析过程更标准、更高效、更容易复现。
2. 长读长组装的核心步骤如何标准化
2.1 从原始数据开始,先解决质量问题
长读长组装的第一步不是直接组装,而是看数据质量。不同平台的数据特征不同。PacBio HiFi 强调高准确性,Nanopore 强调超长读长,但原始错误率更高。
因此,分析前必须先判断:
- 数据量是否充足。
- 读长分布是否合理。
- Q 值和污染情况是否可接受。
- 是否需要去接头和过滤低质量 reads。
没有高质量输入,后面再好的组装算法也难以得到稳定结果。
WorkBuddy的优势在于可以将质控、统计、可视化和报告输出连成统一流程,减少人工反复操作。
2.2 组装、纠错、评估三步不能省
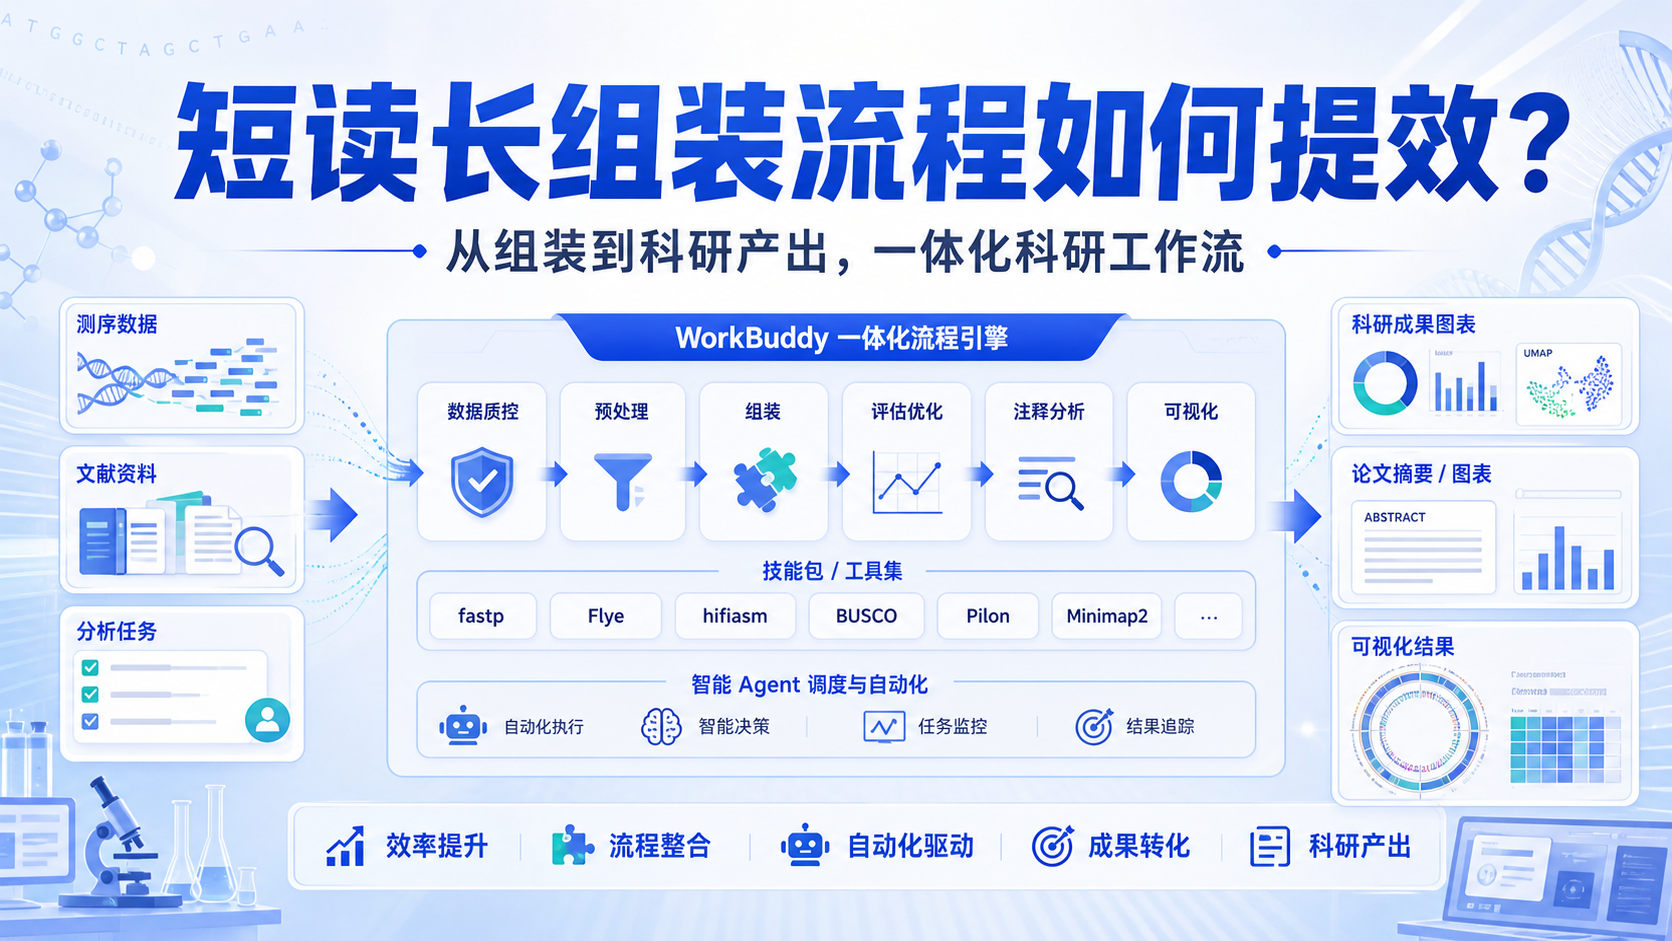
长读长组装不是一次性拼接完成。通常要经历以下逻辑:
- 初始组装,获得 contig。
- 根据数据类型进行纠错。
- 评估连续性和完整性。
- 必要时再进行去冗余和二次优化。
常用评估指标包括 N50、总长度、contig 数量、BUSCO 完整性和比对一致性。这些指标不是摆设,而是判断组装质量的核心证据。
如果只看一张漂亮的组装图,却不看完整性和错误率,结论是不稳的。
2.3 注释和下游分析决定文章深度
组装完成后,真正有价值的是下游解释。常见方向包括:
- 基因预测和功能注释。
- 重复序列分析。
- 结构变异分析。
- 比较基因组分析。
- 特定通路或基因家族扩展研究。
这一步非常适合和疾病机制、进化研究或药物靶点研究结合。长读长组装的价值,不只是“拼出基因组”,而是为后续机制解释提供更完整的底图。
3. WorkBuddy如何提升长读长组装效率
3.1 把多工具串联成统一工作流
长读长组装常常需要调用多个工具。问题不在工具数量,而在工具之间的衔接。WorkBuddy的实用价值在于把任务拆成清晰模块,例如:
- 数据导入。
- 质量统计。
- 组装任务提交。
- 结果整理。
- 图表输出。
- 日志记录。
当流程被统一管理后,科研人员可以把精力放在判断结果,而不是重复搬运数据。
对于样本数较多的项目,这种效率提升非常明显。
3.2 让结果更适合写论文和做汇报
科研人员最需要的,不只是分析完成,而是能快速形成可发表、可答辩的材料。WorkBuddy可帮助输出结构化结果,便于整理成:
- 方法学部分。
- 结果部分图表。
- 补充材料。
- 汇报PPT。
- 标书中的技术路线。
对于需要高频产出的实验室,自动化报告能力本身就是生产力。
尤其在长读长组装项目中,图表很多,指标很多,手工整理非常耗时。把这些内容标准化后,论文写作会轻松很多。
3.3 提高复现性,降低协作成本
组装类项目往往不是一个人完成。可能由测序平台、实验室和生信人员共同协作。此时最怕的就是“别人接手就重跑一遍”。
WorkBuddy这类工具的优势在于:
- 流程记录更完整。
- 参数更容易追踪。
- 任务分工更清晰。
- 结果可重复调用。
对团队来说,复现性就是效率。对论文来说,复现性就是可信度。
4. 长读长组装的常见应用场景
4.1 病原微生物与临床相关研究
长读长组装在病原微生物研究中尤其常见。原因很简单。许多病原体存在重复序列、质粒、插入元件和结构复杂区域,短读长很难完全解析。
长读长数据可以更好地完成菌株基因组拼接、耐药基因定位和可移动元件分析。
对于临床研究者来说,这类分析有助于:
- 明确耐药相关结构。
- 提升病原分型分辨率。
- 支持院感溯源。
- 增强文章机制深度。
4.2 非模式生物和复杂基因组研究
非模式生物研究常常缺少参考基因组,或者参考质量较差。此时长读长组装价值更高。
它能帮助研究者更好地解析:
- 大片段重复区域。
- 复杂结构变异。
- 特异基因家族扩张。
- 新物种的基因组框架。
这类项目对自动化和标准化要求很高。因为一旦样本较多,手工处理会迅速成为瓶颈。WorkBuddy非常适合这类需要批量处理和统一管理的任务。
4.3 从组装到机制,才能形成完整故事
一篇高质量文章,通常不是只有组装结果,而是组装服务于明确科学问题。比如:
- 为什么某病原体毒力更强。
- 为什么某类基因家族扩张。
- 为什么某结构变异与表型相关。
- 为什么某药物靶点在特定菌株中更稳定。
长读长组装只是起点,机制解释才是终点。
WorkBuddy的价值就在于帮助研究者更快地完成起点,把更多时间留给结果解释和实验验证。
5. 为什么说这是生信分析的新范式
5.1 从“人盯流程”转向“系统管流程”
过去的生信更像手工技艺。现在更像工程管理。长读长组装尤其如此。
因为项目的难点不只是算法,而是管理:
- 数据管理。
- 版本管理。
- 参数管理。
- 结果管理。
- 协作管理。
新范式的核心,就是让分析从个人经验驱动,转向流程系统驱动。
5.2 从“单次完成”转向“批量复制”
当一个流程被验证后,下一步就是复制到更多样本、更多项目和更多课题中。
这对实验室和平台型团队很重要。因为真正有价值的分析体系,必须能复制、能扩展、能沉淀。
WorkBuddy这类工具最适合做的,就是把一次成功的长读长组装流程,变成后续可复用的模板。这比单次跑通更重要。
5.3 从“工具堆叠”转向“价值输出”
科研不是为了跑工具,而是为了回答问题。长读长组装的最终价值体现在三点:
- 更完整的基因组。
- 更可靠的结构信息。
- 更强的论文叙事。
当流程足够稳定后,研究者才能把注意力放在科学问题本身。这才是WorkBuddy带来的真正改变。
总结Conclusion
长读长组装已经不再是单纯的软件操作,而是一个需要标准化、自动化和可复现管理的系统工程。对于医学生、医生和科研人员来说,真正的挑战是把复杂流程稳定转化为可发表结果。 WorkBuddy的价值,正是在于把组装、质控、评估和输出整合为更高效的新范式。
如果你正在推进长读长组装项目,想减少重复劳动、提升复现性、加快成果产出,可以进一步了解解螺旋的工具与服务支持,让长读长组装真正从“能做”走向“做快、做稳、做成”。

- 引言Introduction
- 1. 长读长组装为什么需要新范式
- 2. 长读长组装的核心步骤如何标准化
- 3. WorkBuddy如何提升长读长组装效率
- 4. 长读长组装的常见应用场景
- 5. 为什么说这是生信分析的新范式
- 总结Conclusion