16
 分享
引言Introduction
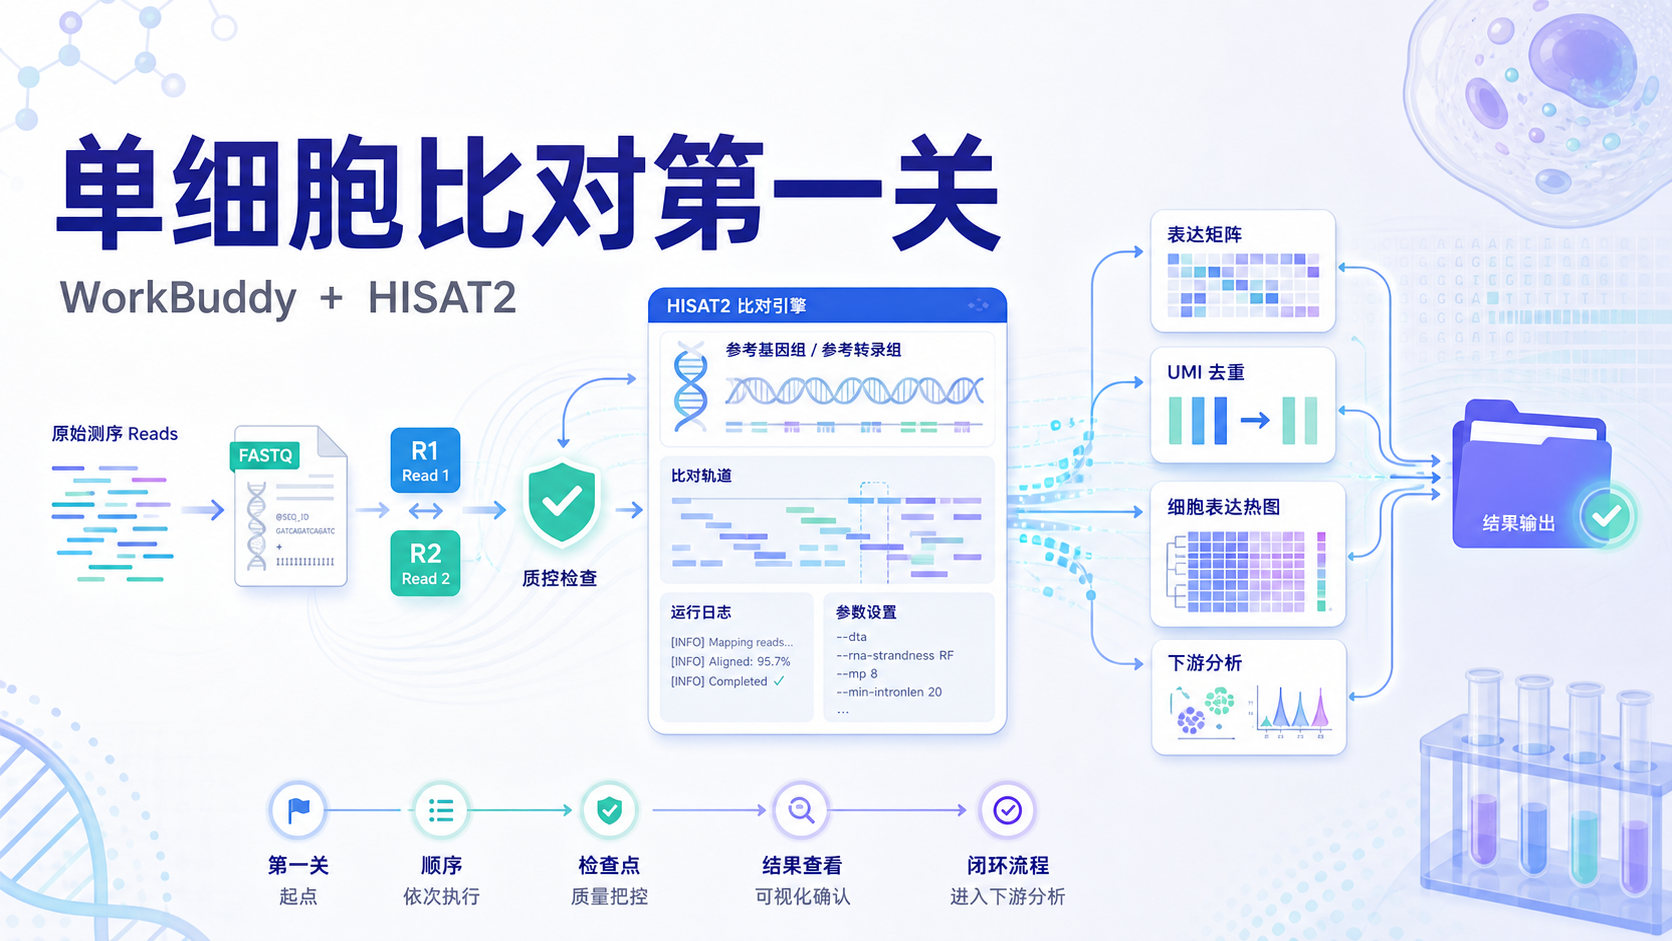
测序公司把原始数据交给你了,但真正难的是,如何把FASTQ文件快速变成可分析的表达矩阵。对零基础医学生和年轻科研人员来说,比对、质控、UMI、barcode、表达表,常常是第一道门槛。
1. 为什么生信比对是单细胞分析的第一关
单细胞转录组分析的起点,不是差异分析,也不是聚类。真正的起点,是把测序数据准确转换为表达表。 如果这一步出错,后面的细胞分群、标记基因、通路富集都会偏。
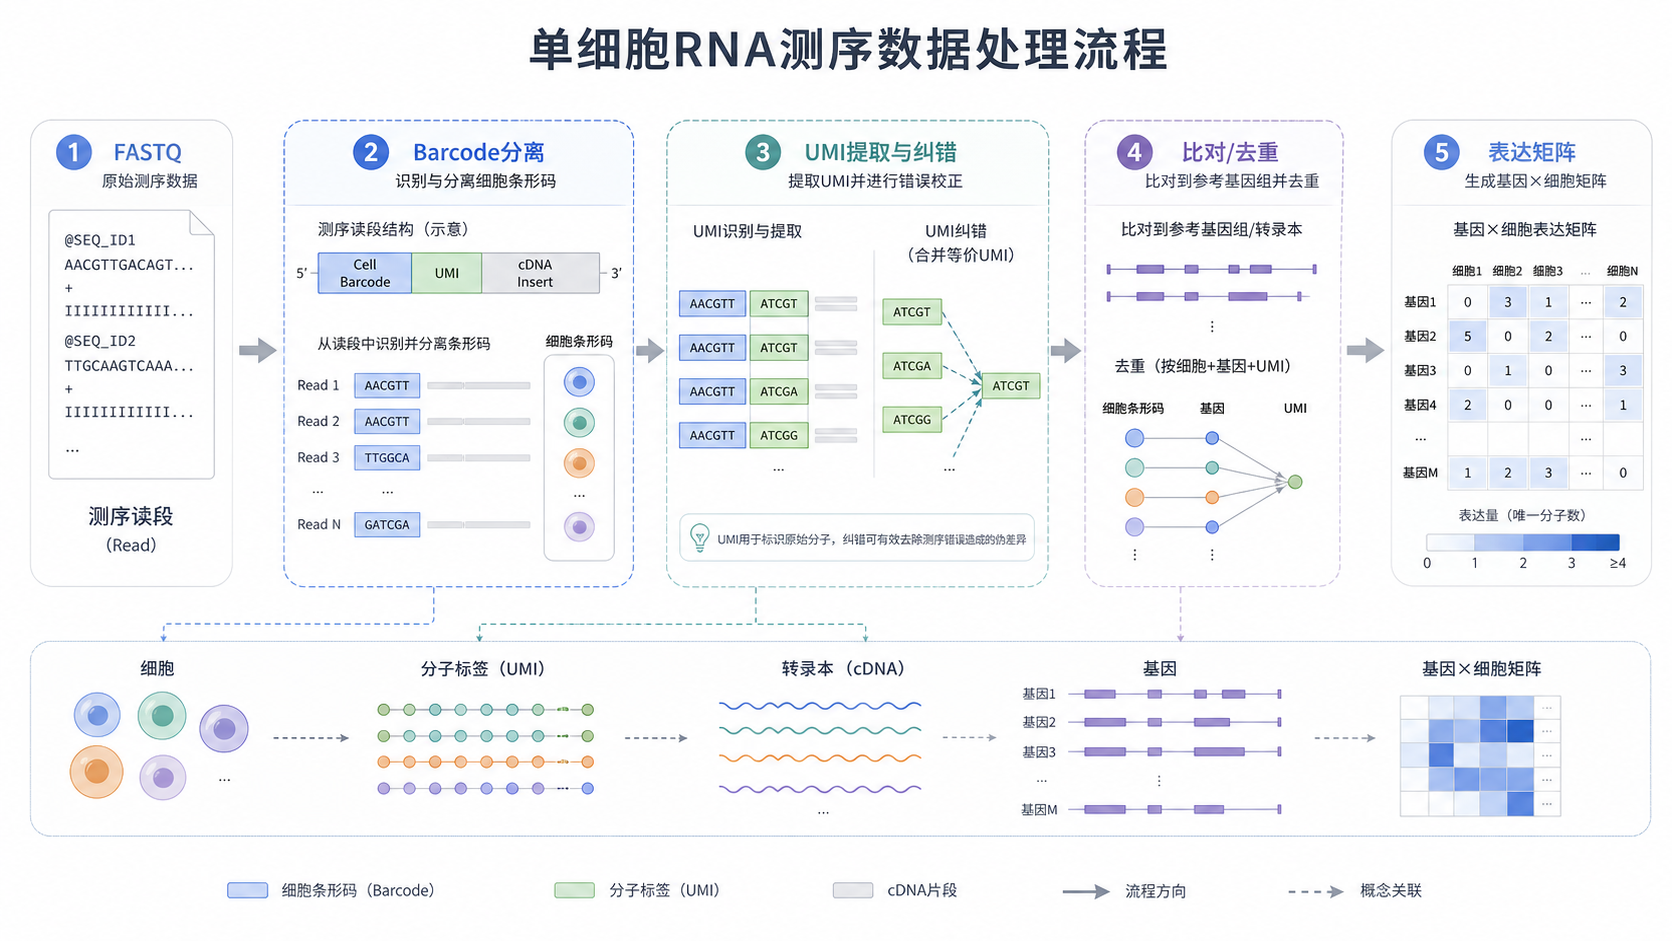
在实际项目里,测序公司通常只返回原始数据。你拿到的是R1、R2文件,里面混着barcode、UMI、PolyA和真实转录本信息。先分离细胞,再提取UMI,再清洗序列,最后比对到基因组,这是最稳妥的路线。 这也是很多初学者最容易忽略的逻辑。
对医学生和医生来说,理解这一步非常关键。因为你不只是“会跑软件”,而是在判断数据是否可靠。对科研人员来说,表达表的质量,直接决定文章结果是否稳定。
1.1 原始测序数据里到底有什么
以常见双端测序为例,R2往往携带barcode和UMI信息,R1则主要保留转录本序列。也就是说,R2更像身份信息,R1更像生物学信号。
在下游分析中,barcode用于识别细胞来源,UMI用于去除PCR重复。这个逻辑很重要。因为单细胞数据放大扩增后,重复读段很多,如果不处理,表达量会被高估。
1.2 为什么不能直接做比对
很多人拿到数据后,第一反应是直接上比对软件。这样做往往会遇到三个问题。
- barcode没分开,细胞身份混乱。
- UMI没提取,重复读段无法去重。
- 低质量序列和污染序列没清掉,映射率下降。
所以,比对前的预处理不是“额外步骤”,而是分析能否成立的前提。
2. WorkBuddy如何帮助你把流程跑顺
对于没有Linux基础、没有脚本经验的人,最大的困难不是理解原理,而是把每一步真正执行出来。这里就很适合借助WorkBuddy这类流程化工具。它的价值不在于替代思考,而在于把复杂的生信步骤标准化、可视化、可复用。
从教学和实战经验看,初学者最容易卡在三个点。
- 文件格式看不懂。
- 命令行参数记不住。
- 中间结果不会判断对错。
WorkBuddy的意义,就是降低这三个门槛。 你不需要一开始就写完整脚本,而是先把每一步的输入、输出和检查点理清楚。这样更适合零基础上手,也更符合真实科研环境。
2.1 先建立正确的数据处理顺序
标准流程一般可以拆成七步。
- 根据barcode分离细胞。
- 添加UMI信息。
- 进行质控和剪切。
- 比对到参考基因组。
- 提取unique mapping转录本。
- 根据UMI去除PCR重复。
- 标准化并构建表达表。
这七步的核心,是先保留真实信号,再逐层去噪。 任何一步跳过,都会影响最终矩阵的可信度。
2.2 初学者最该关注的检查点
你不需要一开始就追求“跑得快”,而要追求“跑得对”。建议重点检查以下内容。
- R1、R2的read ID是否一一对应。
- barcode长度是否固定。
- UMI是否位于预期位置。
- 质控后是否仍保留足够的有效 reads。
- 比对后唯一比对比例是否合理。
如果这些基础检查没通过,后面的生信结果就不值得信任。
3. HISAT2比对的核心逻辑
在转录组比对工具中,HISAT2是常用选择之一。它是TopHat的升级思路,更快,也更适合现代转录组分析场景。对于单细胞数据,虽然很多流程还会结合STAR等工具,但HISAT2比对 依然是学习转录组基础原理的非常好入口。
它的优势很明确。速度快,内存占用相对可控,适合中小规模服务器环境。对于很多实验室来说,这一点很现实。不是每个课题组都有高配服务器,但HISAT2通常能在有限资源下完成稳定比对。
3.1 HISAT2适合解决什么问题
HISAT2主要用于将清洗后的转录本序列比对到参考基因组或转录组参考文件。它关心的是两个问题。
- 这条read来自哪里。
- 这条read对应哪个基因或外显子区域。
在单细胞转录组中,只有定位清楚,才能进一步做基因计数。没有正确比对,就没有可信表达量。
3.2 比对前必须先做的准备
比对不是“点一下按钮”就结束。你至少要准备好三类文件。
- 参考基因组序列。
- 基因注释文件。
- 清洗后的样本序列文件。
其中,注释文件尤其关键。因为后续计数要依赖基因坐标信息。如果注释版本和参考基因组不一致,结果会出现大量偏差。
3.3 比对结果怎么看
比对完后,最重要的不是“跑完了”,而是看结果是否合理。常见指标包括:
- 总比对率。
- 唯一比对率。
- 多重比对比例。
- 未比对reads比例。
一般来说,唯一比对率越高,说明数据越干净、参考库越匹配。 如果未比对比例异常高,要优先排查污染、物种不匹配、接头残留和过度剪切。
4. 从比对到表达表,真正决定数据质量的细节
很多人以为比对完成就结束了,其实真正决定表达表质量的,是比对前后的一串细节处理。尤其是单细胞数据,barcode、UMI、polyA、TSO和低质量碱基都会影响最终结果。
4.1 质控不是形式,而是筛掉噪音
常见需要去除的内容包括:
- 低质量碱基。
- 不确定碱基N。
- PolyA尾。
- TSO残留。
- 接头序列。
TSO和PolyA处理不到位,后续比对会明显受影响。 这是很多初学者容易忽视的地方。因为这些序列看起来“像正常片段”,但实际上并不代表真实转录信息。
4.2 UMI去重为什么重要
单细胞测序里,PCR扩增会制造大量重复片段。如果只看read数,不看UMI,表达量会虚高。
UMI的价值,就是把技术重复和真实分子区分开。
这一步做得好,后续的表达矩阵更接近真实生物学状态。对医生读者来说,可以把它理解成“去掉重复测量带来的假象”。对科研人员来说,这是保证定量分析可信度的基础。
4.3 表达矩阵不是终点,而是起点
当表达表构建完成,你才真正进入单细胞下游分析。后面才是:
- 细胞聚类。
- 标记基因识别。
- 细胞类型注释。
- 差异表达分析。
- 通路富集分析。
所以,表达表构建不是附属步骤,而是整个研究设计的核心地基。
5. 零基础上手时,最容易犯的3个错误
如果你刚开始做单细胞分析,最容易踩坑的地方通常不是复杂算法,而是基础操作。
5.1 把R1和R2的角色弄反
R2常含barcode和UMI,R1常含转录本信息。搞反以后,分离细胞和去重都会出问题。
一开始就把文件角色记清楚,能省下大量返工时间。
5.2 过早追求高级分析
很多人一上来就想做轨迹分析、细胞互作、机器学习。实际上,基础表达表不稳,任何高级分析都站不住。 先把原始数据处理到位,再考虑下游挖掘。
5.3 忽略参数和日志文件
生信不是只看结果图。日志文件、错误提示、比对统计表,都是判断流程是否正常的重要依据。会看日志,才算真正开始入门。
6. 结合WorkBuddy+HISAT2,如何更快建立你的分析闭环
对于零基础用户,最现实的做法不是一口气学完所有命令,而是先建立一个可重复的工作流。WorkBuddy适合做流程组织,HISAT2适合做核心比对。两者结合,能让你更快形成闭环。
你可以按这个顺序推进:
- 读懂输入文件。
- 完成barcode和UMI处理。
- 做质控清洗。
- 用HISAT2完成比对。
- 检查比对率和唯一映射。
- 输出计数表。
- 进入下游分析。
这套流程的关键,不是“复杂”,而是“稳定”。 只要每一步都能解释清楚,你就已经超过了大多数只会复制命令的人。
在实际学习中,很多人卡在“知道原理,但不会落地”。这时,借助解螺旋这类成熟资源,会更高效。如果你希望把WorkBuddy+HISAT2比对流程真正跑通,解螺旋提供的标准化教学和实战思路,可以帮助你少走很多弯路。
总结Conclusion
单细胞数据分析的第一步,不是直接做结果图,而是把原始测序数据转换成可信的表达表。barcode分离、UMI提取、质控清洗、HISAT2比对、去重和标准化,每一步都决定最终结果是否可靠。
对医学生、医生和科研人员来说,真正要掌握的不是某一个命令,而是整套数据处理逻辑。先把基础打牢,再谈高阶分析,文章和项目才更稳。
如果你想系统掌握这条路径,建议直接结合解螺旋 的实战内容,把WorkBuddy+HISAT2比对流程学成可复用的方法。

- 引言Introduction
- 1. 为什么生信比对是单细胞分析的第一关
- 2. WorkBuddy如何帮助你把流程跑顺
- 3. HISAT2比对的核心逻辑
- 4. 从比对到表达表,真正决定数据质量的细节
- 5. 零基础上手时,最容易犯的3个错误
- 6. 结合WorkBuddy+HISAT2,如何更快建立你的分析闭环
- 总结Conclusion