22
 分享

全文概要
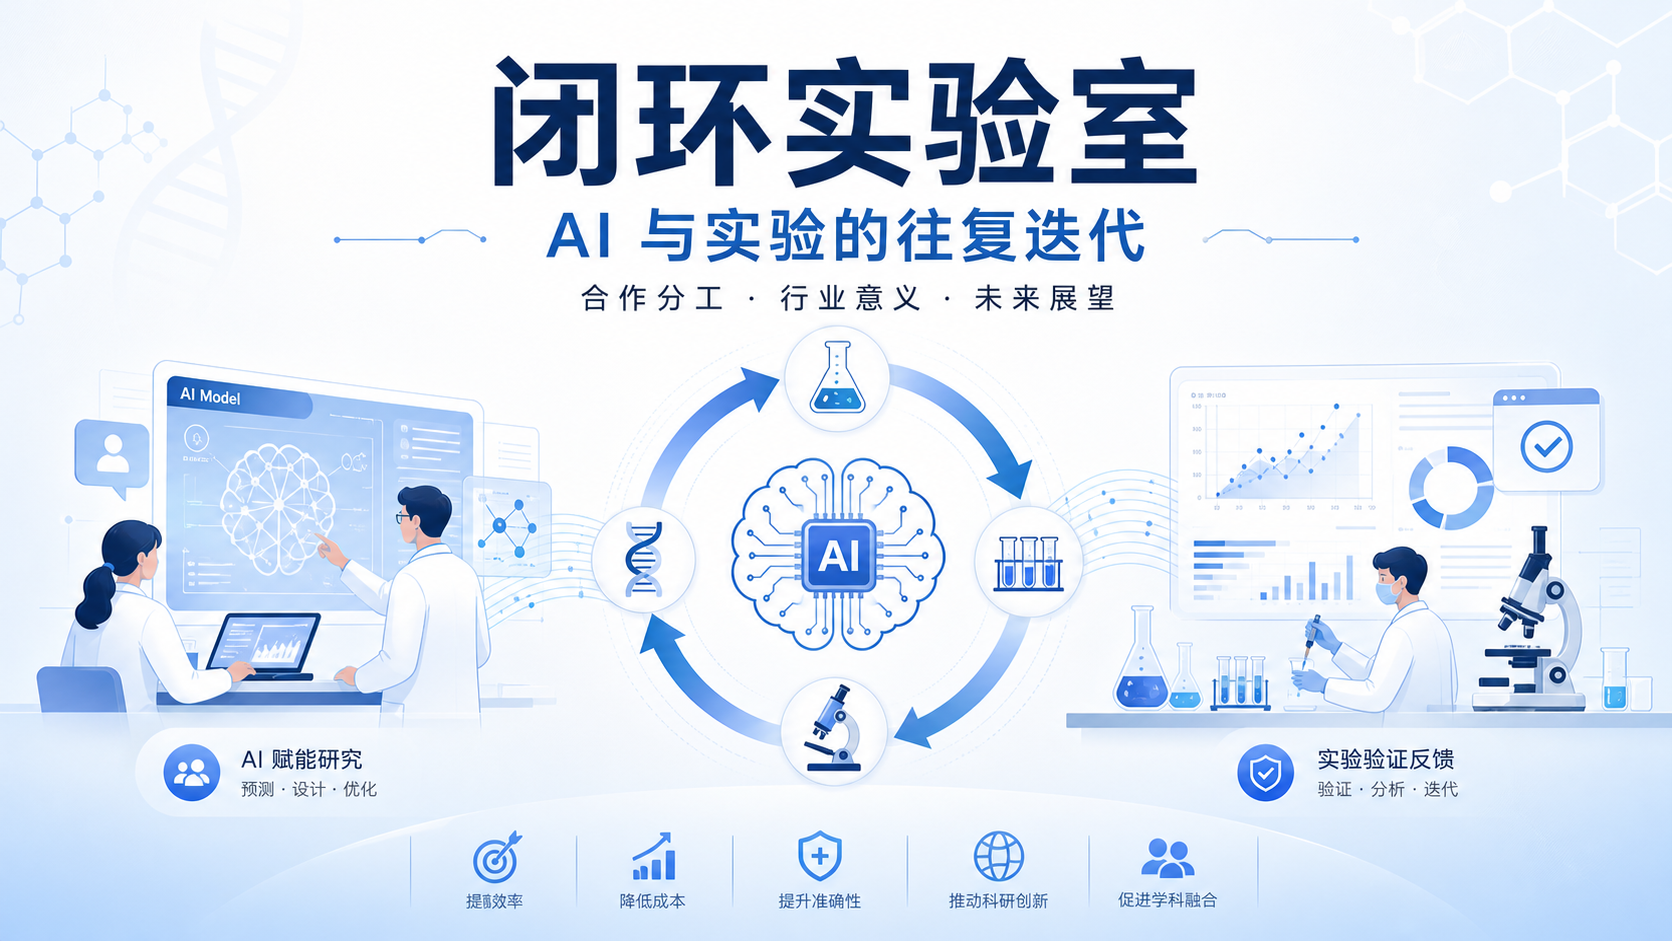
Biohub 联合美国能源部(DOE)、美国国立卫生研究院(NIH)以及 Google DeepMind、Isomorphic Labs、Meta 等机构宣布,共同投入 18 亿美元构建面向 AI 模型的生物学基础数据,打造"虚拟生物学计划"(Virtual Biology Initiative)。这是迄今规模最大的、面向 AI 的生物学数据生成行动,目标是让全球科研界能够构建并调用可预测细胞与疾病行为的 AI 模型,从而加速疾病理解与治疗手段的发现。
1. 破解 AI 生物学的"数据瓶颈"
AI 在生物学中的应用长期受制于高质量、结构化生物学数据的稀缺——相比训练现代 AI 系统的海量文本与图像数据,可用于预测性模型训练的生物数据要少得多。虚拟生物学计划正是针对这一瓶颈,通过跨机构、跨学科的数据生成协作,扩展细胞对不同干预条件响应的数据覆盖范围,覆盖远超现有研究的细胞类型与条件,并开发验证更大规模、更快速度、更高精度的细胞研究技术。
2. 各方投入与合作分工
在该计划中,DOE 将通过其"创世纪使命"(Genesis Mission)在五年内投入逾 5 亿美元,用于实验室测量、建模与计算,依托百亿亿次级超算、X 射线与中子散射、冷冻电镜及国家实验室体系的自主实验室等资源。NIH 将协调其既往逾 5 亿美元联邦投资所形成的数据集、知识库与生物信息库,并与 Biohub 合作将这些数据标准化以用于 AI 模型训练。Google DeepMind、Isomorphic Labs 与 Meta 则合计投入 3 亿美元,用于创建技术与多模态数据集。Biohub 早前已承诺 5 亿美元锚定该计划,其中 4 亿美元支持冷冻电子断层扫描、活体组织大规模成像及分子—细胞—组织—整体水平构建与扰动等新技术,另有 1 亿美元资助外部研究。
3. 开放科学与前景区分
该计划定位为开放科学行动,但参与出资的商业伙伴可在数据正式公开前获得临时早期访问权;禁运期结束后数据将作为公共科学资源发布,政府资助的工作则不受此类限制。Biohub 预计首批数据集将在约一年内就绪,并力争在五年内构建越来越精确的预测模型。若"虚拟细胞"得以实现,科研人员将可在数字层面进行实验,大幅加速新疗法与新药的发现路径,这也使其被视为下一阶段科学研究的核心挑战之一。
来源:Biohub 官方公告;Newswise;Analytics Insight 等科技媒体

声明:本文资讯来源于公开报道及学术期刊,仅作行业信息传播,不构成临床用药建议。转载需注明来源。
- 1. 破解 AI 生物学的"数据瓶颈"
- 2. 各方投入与合作分工
- 3. 开放科学与前景区分