17
 分享
引言Introduction
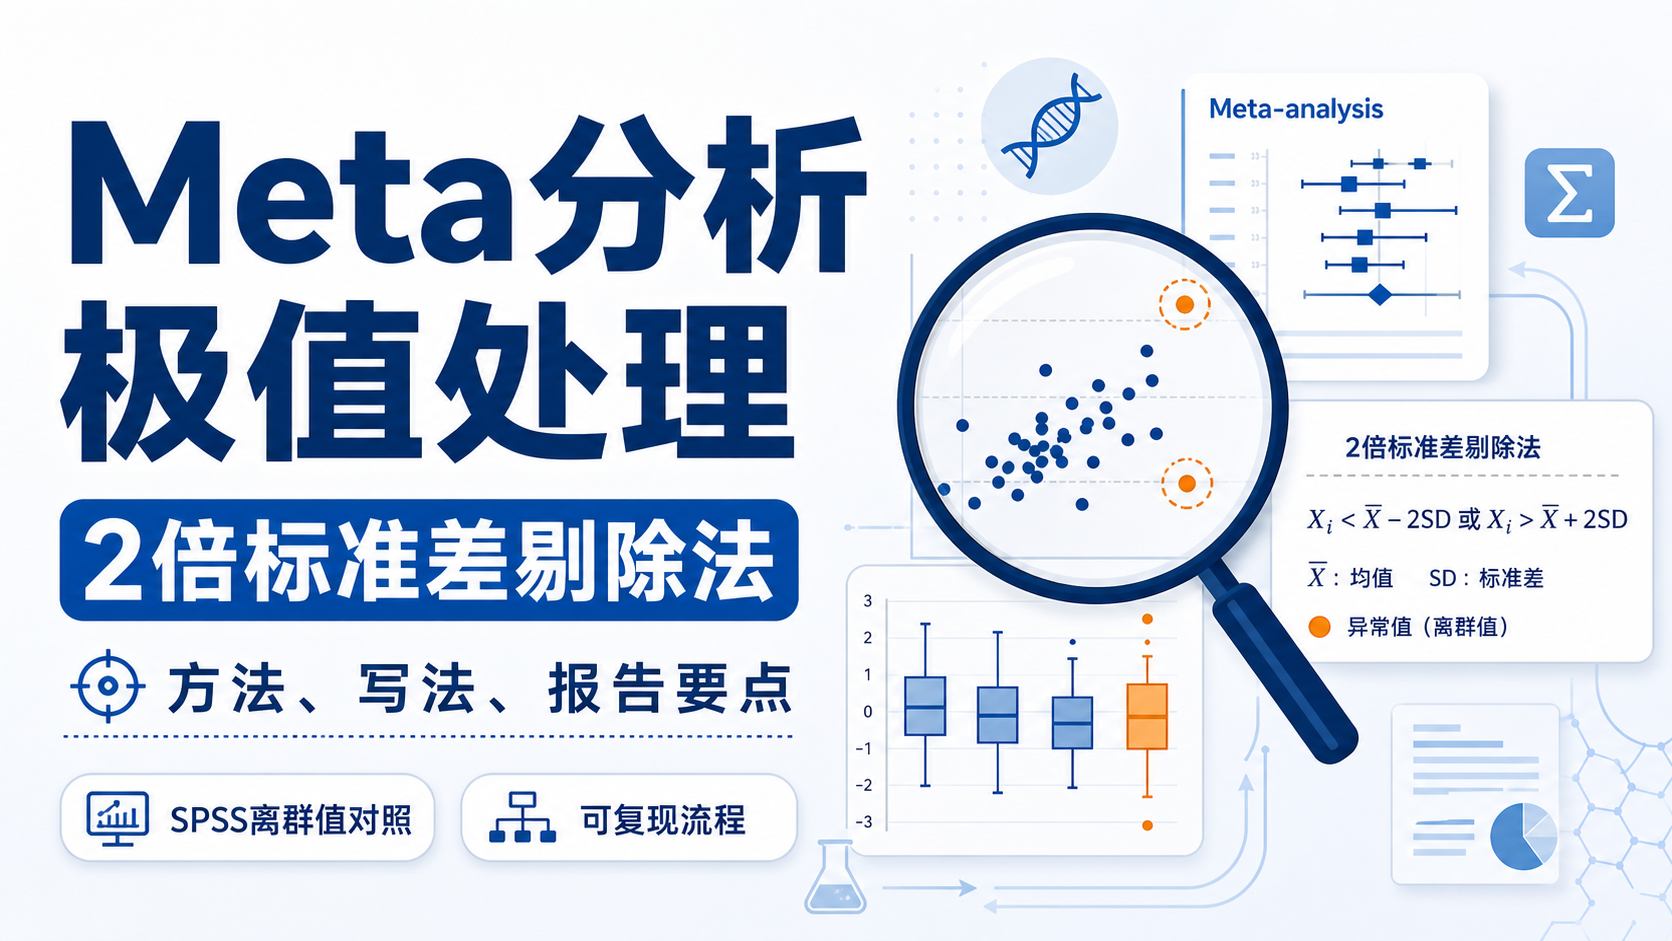
Meta分析里,极值数据会放大异质性,干扰效应量和结论稳定性。很多医学生和科研人员在整理原始研究时,最常问的是,遇到明显偏离整体分布的统计误差,该怎么处理才既合理又可追溯 。本文用两倍标准差剔除法,结合SPSS思路,讲清判断、处理和写法。
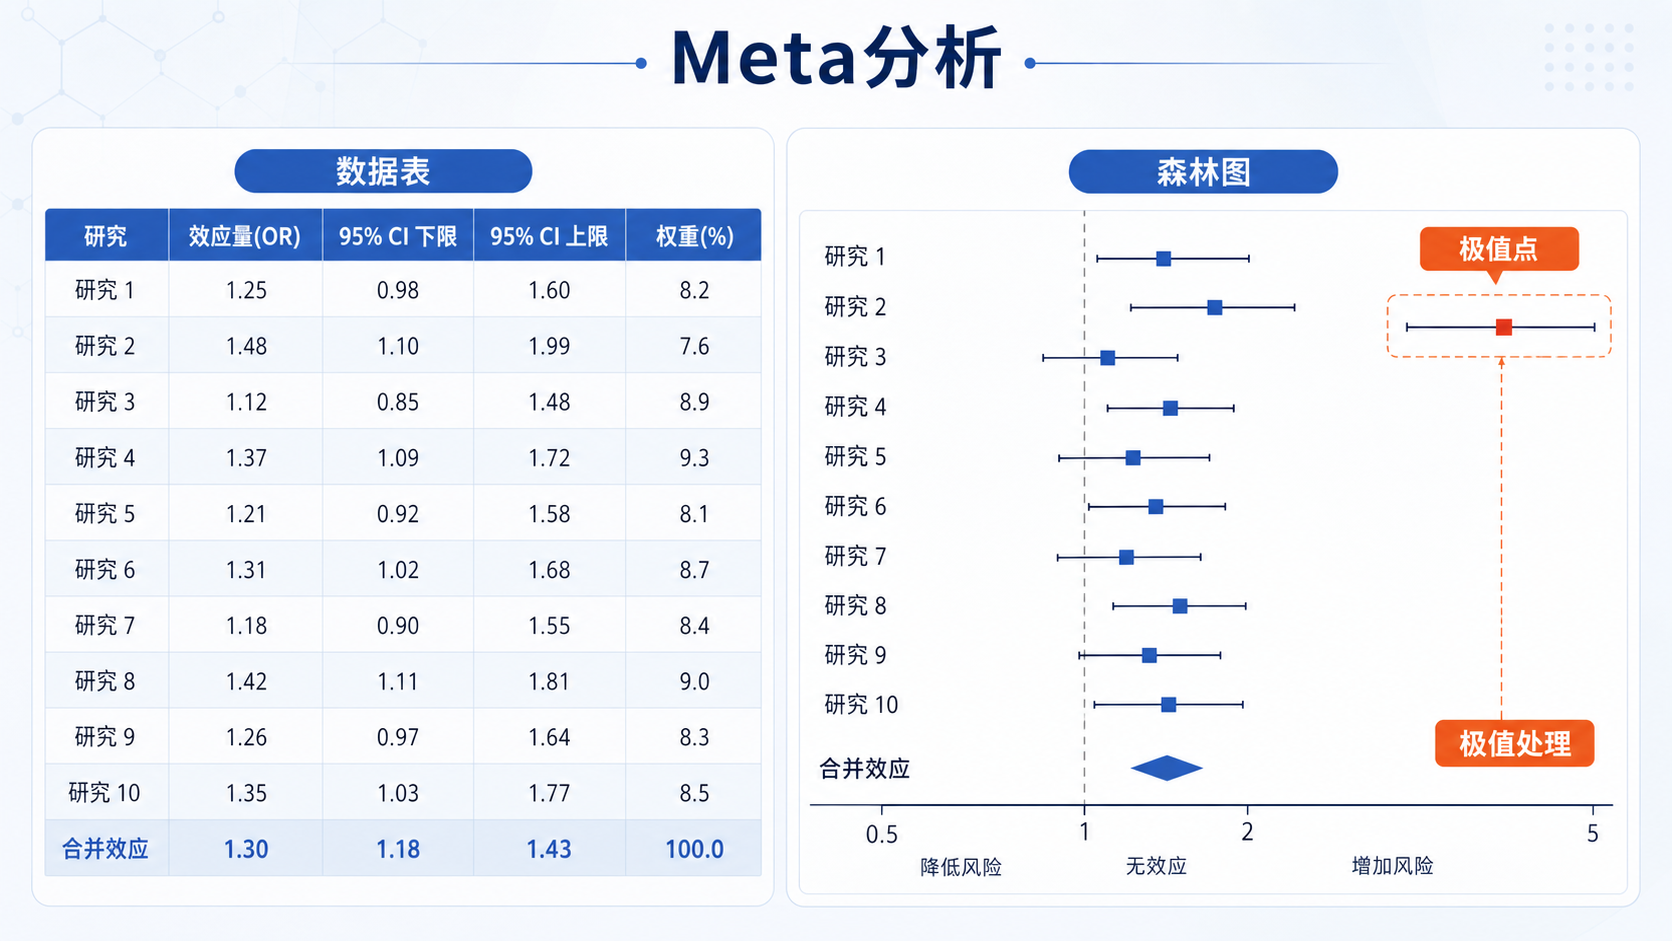
1. 为什么Meta分析要先处理极值
1.1 极值会直接影响异质性判断
Meta分析的核心是合并多个研究的结果。若某项研究中的个别数值明显偏离总体分布,就可能把均值、标准差、效应量一起拉偏。这类统计误差一旦进入合并分析,常见后果就是I²升高、森林图分布变散。
对于连续型变量尤其要谨慎。因为极值不仅影响单个研究的描述统计,还会影响后续加权合并。若原始数据本身样本量不大,少数异常点的影响会更明显。
1.2 极值不等于错误数据,但需要规则
极值可能来自录入错误、测量误差,也可能是真实存在的临床极端值。不能因为“看起来不正常”就直接删除。
更稳妥的做法是先确认数据来源,再选择统一、可复现的规则处理。
常见思路包括:
- 核对原始病例记录。
- 检查是否存在单位错误、录入错误。
- 判断分布是否接近正态。
- 再决定是否采用剔除或保留策略。
1.3 两倍标准差剔除法适合什么场景
两倍标准差剔除法,本质上是基于均值和离散程度的经验规则。当数据分布接近正态,且需要一个清晰、可写入方法学部分的阈值时,这种方法比较常用。
它的优势是简单,透明,便于在method里说明。
但它不是万能规则。若数据明显偏态,或者样本量很小,单纯用2倍SD可能不够稳健。此时需要结合分位数、箱线图或敏感性分析一起判断。
2. 两倍标准差剔除法怎么做
2.1 先算均值和标准差
第一步,是对目标变量计算均值和标准差。SPSS中可通过“分析-描述统计-描述”完成。若用Excel,也可以先得到均数和SD,再计算阈值。
两倍标准差阈值通常写为:均值±2SD。
实际操作中,若研究变量是单侧偏高更明显,也可以按研究目的设定上限或下限。
例如,某变量均值为50,标准差为10,则:
- 上限 = 50 + 2×10 = 70
- 下限 = 50 - 2×10 = 30
超出范围的观测值,就进入待核查列表。
2.2 再定位异常样本
算出阈值后,需要回到原始数据逐条核对。SPSS里可以用“选择个案”或按数值排序,把离群样本找出来。
如果数据量大,建议先降序或升序排列,再核对对应ID。
这一步很重要。删除前必须确认是“极值”,而不是正常的临床极端值。
如果是录入错误,优先更正原始数据,而不是直接删除。
2.3 删除后要保留痕迹
处理极值时,最容易出问题的是不可追溯。
因此建议保留以下信息:
- 原始数值。
- 阈值计算方式。
- 删除的样本编号。
- 删除原因。
- 处理后的样本量变化。
这样不仅便于复核,也方便论文撰写时解释。在方法学中写清楚处理规则,比“结果变好看”更重要。
3. 在Meta分析中如何写进方法部分
3.1 方法描述要足够具体
论文里不能只写“剔除异常值”。最好明确到可复现。比如:
- 采用均值±2倍标准差作为极值判断标准。
- 超出阈值的观测值纳入异常值核查。
- 经核对后,对确认不符合总体分布且可能影响统计结果的数据予以剔除。
- 剔除过程由两名研究者独立完成,分歧由第三人裁定。
这样的写法更符合E-E-A-T要求,也更容易通过审稿。
3.2 需要说明剔除依据
如果你在Meta分析中使用极值处理,审稿人最关心的是“为什么是2倍SD,而不是3倍SD或IQR”。
这里的回答要客观:
- 2倍SD是常见经验阈值,适合接近正态的数据。
- 若研究对象分布稳定,这个阈值有较好的可操作性。
- 若存在明显偏态,需补充敏感性分析。
也就是说,不是因为2倍SD绝对正确,而是因为它兼顾了简洁性和可解释性。
3.3 最好加敏感性分析
极值处理后,建议做一次敏感性分析。
目的很简单,看结论是否稳定。常见做法包括:
- 保留极值再合并一次。
- 剔除极值后再合并一次。
- 比较效应量、I²、P值是否明显变化。
如果结果基本一致,说明结论稳健。
如果变化很大,就要在讨论部分如实说明。
4. 与SPSS常用离群值方法的关系
4.1 直方图和散点图适合初筛
在SPSS中,直方图、标准化残差散点图、ZPRED和ZRESID图,都能帮助发现离群值。
一般来说,标准化残差绝对值超过3,往往提示异常观测。
这类方法适合回归或模型诊断,也适合在极值筛查的前期使用。
它们的优点是直观,缺点是仍需人工判断。
4.2 拉依达准则与两倍SD的区别
拉依达准则通常以均值±3SD作为离群值界限。相比之下,2倍SD更敏感,能更早捕捉到偏离点。
因此:
- 2倍SD更适合较严格的筛查。
- 3倍SD更保守,误删风险更低。
到底用2倍还是3倍,要看研究目的、分布形态和后续分析计划。
如果目标是减少异常点对合并结果的干扰,2倍SD常更实用。
4.3 马氏距离适合多变量异常识别
如果是多指标联合分析,单看某一个变量不够。马氏距离可用于识别多变量层面的异常个案。
这在基线特征分析、回归建模和样本质量控制中更有价值。
但它不替代单变量极值判断。
最佳策略通常是单变量筛查加多变量核查。
5. 论文写作与结果报告要点
5.1 结果部分要报告变化
如果你做了极值处理,结果里最好写清楚:
- 剔除了多少个极值。
- 剔除前后样本量变化。
- 剔除前后均值、SD或效应量变化。
- 合并结果是否稳定。
这样读者才能判断处理是否合理。
没有前后对比的数据处理,很难证明结论可靠。
5.2 讨论部分要承认局限
极值处理并不等于消除偏差。
它只是减少异常点对模型的干扰。你需要在讨论中承认:
- 规则有经验性。
- 不同阈值可能产生不同结果。
- 对偏态分布数据,单纯均值±2SD未必最优。
这种写法更符合科研规范,也更容易体现专业性。
5.3 不要把剔除写成“自动化动作”
很多初学者容易把异常值处理写成机械步骤。实际上,每一次删除都应该有明确理由。
尤其在Meta分析和临床研究中,任何删除都可能改变证据链。
建议把处理流程固定为:
- 初筛。
- 核对原始数据。
- 判断是否为录入或测量错误。
- 决定保留、修正或剔除。
- 做敏感性分析。
6. 用规范工具提高处理效率
6.1 研究者最需要的是可复现流程
极值处理最怕的是“个人经验化”。
如果每次都临时决定阈值,结果就很难复核,也不利于团队协作。一个标准化的统计流程,能显著减少统计误差带来的方法学争议。
6.2 解螺旋可帮助你把流程做规范
对于医学生、医生和科研人员来说,真正的难点往往不是“知道概念”,而是“把方法落到论文和数据分析里”。
这时,使用解螺旋这类专业科研支持工具,可以更高效地完成数据核查、统计流程整理和方法写作,减少重复试错。当极值处理、结果记录和方法描述都能标准化,研究质量会更稳定。
总结Conclusion
Meta分析中的极值处理,不是简单删除,而是一个需要规则、证据和记录的统计过程。两倍标准差剔除法适合接近正态、需要明确阈值的场景,但必须结合原始数据核查和敏感性分析。 写进论文时,要交代清楚标准、步骤和影响。若你希望把这套流程做得更规范、更高效,可以进一步结合解螺旋的科研支持能力,帮助你把统计误差控制在更可追溯的范围内。
- 引言Introduction
- 1. 为什么Meta分析要先处理极值
- 2. 两倍标准差剔除法怎么做
- 3. 在Meta分析中如何写进方法部分
- 4. 与SPSS常用离群值方法的关系
- 5. 论文写作与结果报告要点
- 6. 用规范工具提高处理效率
- 总结Conclusion