15
 分享
引言Introduction
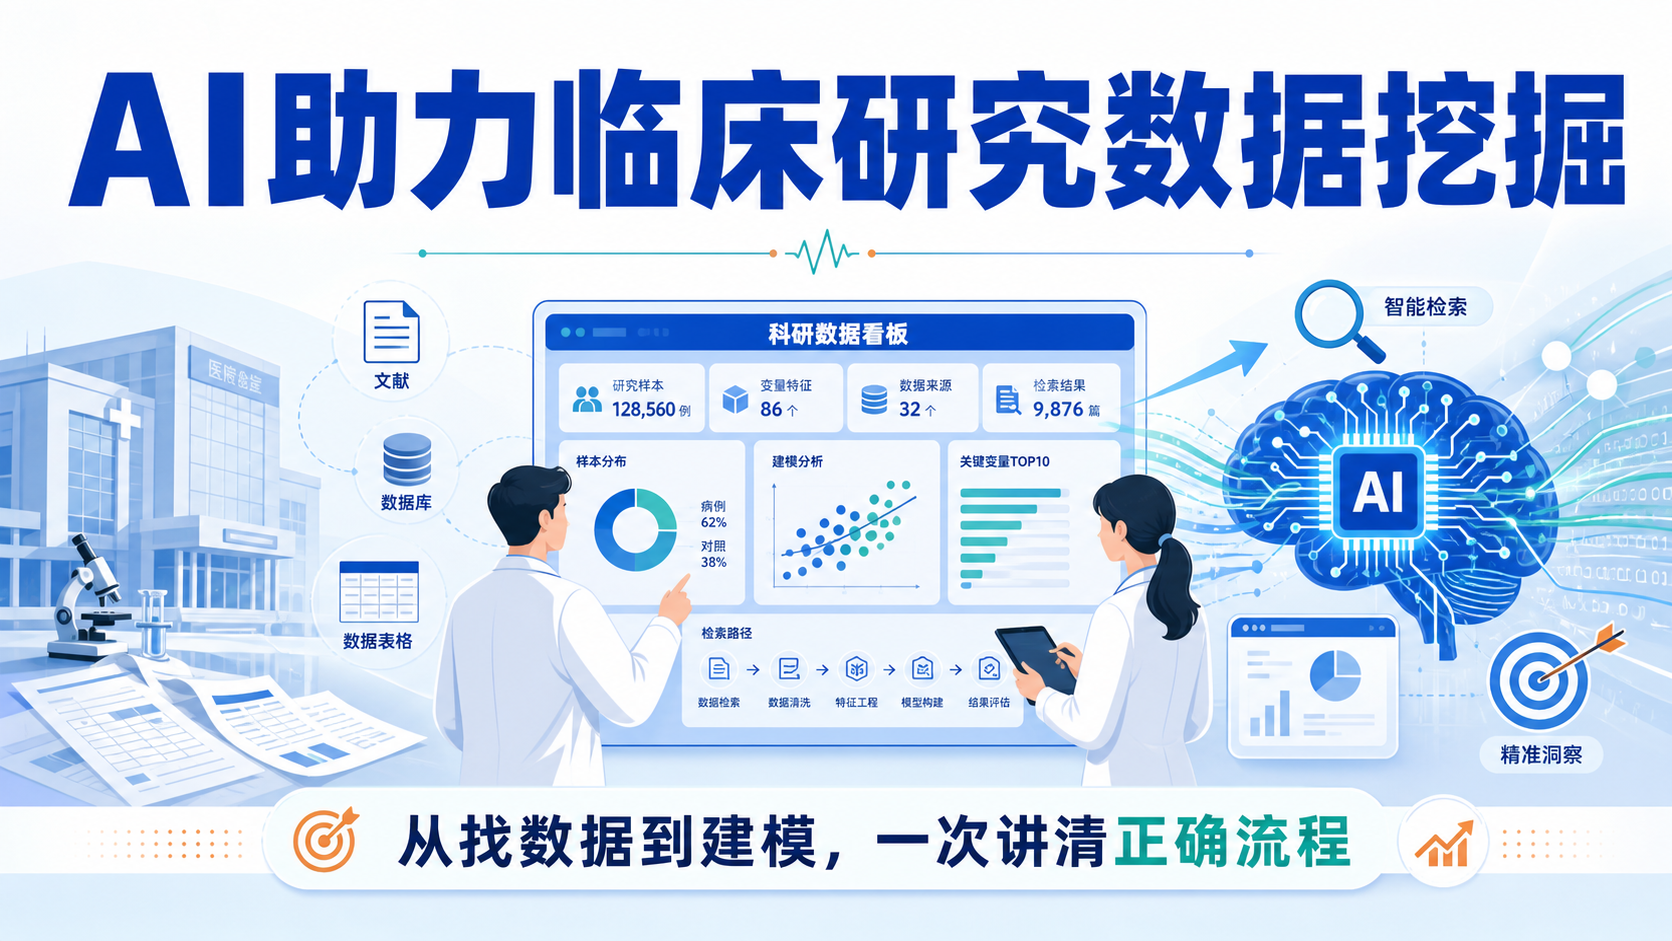
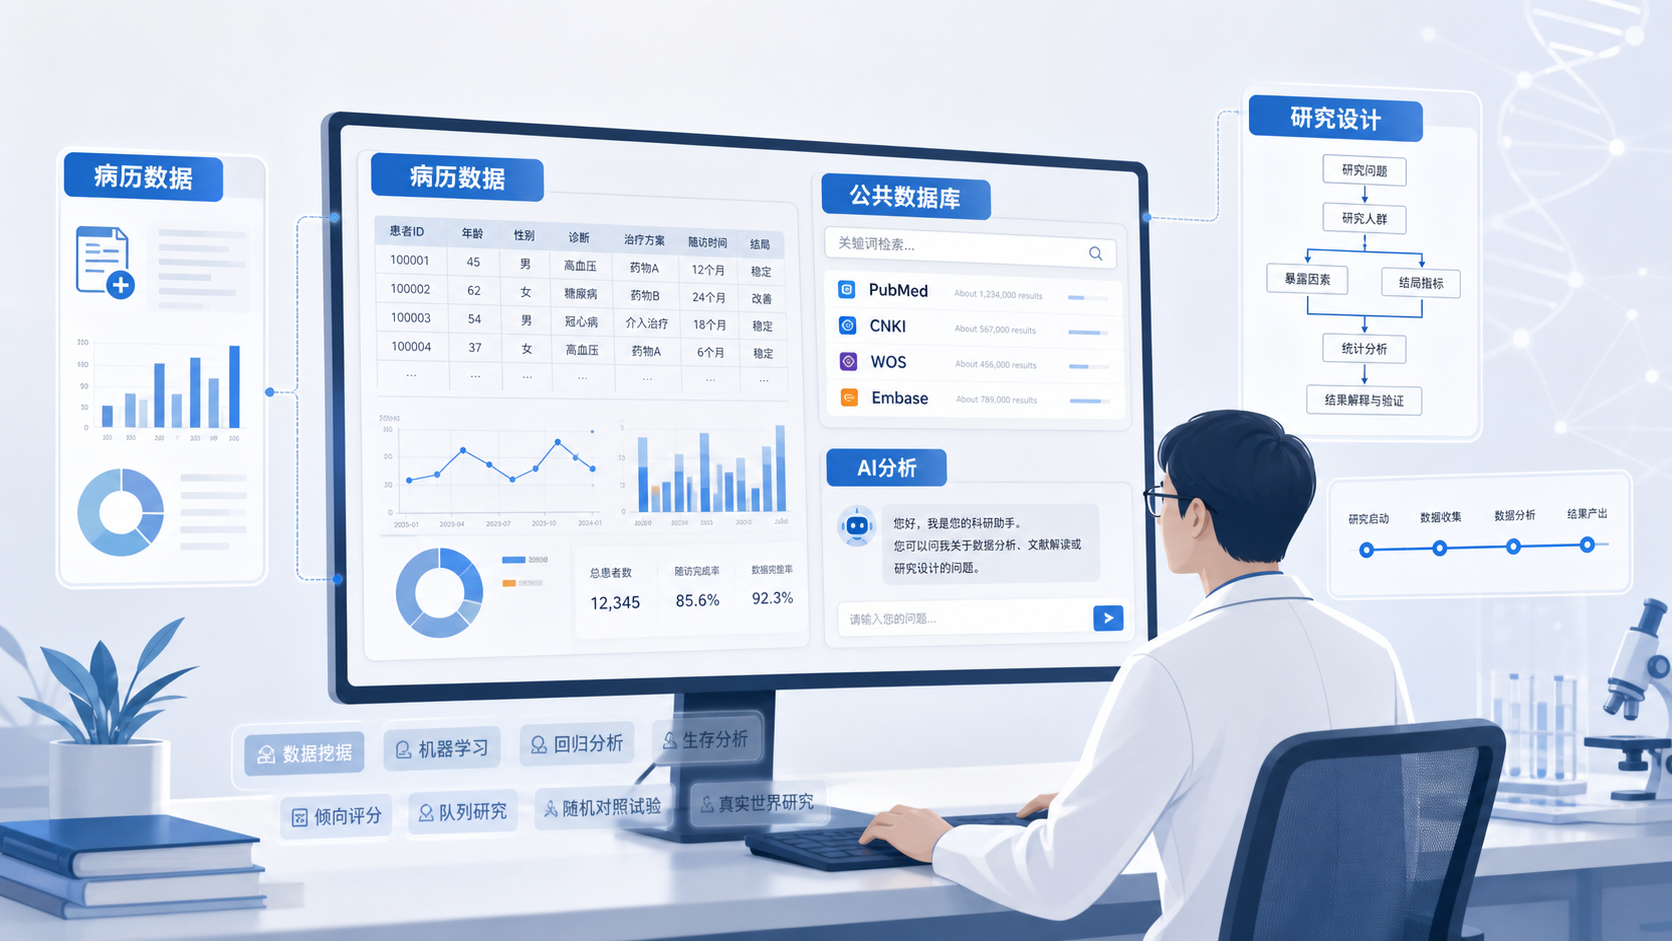
临床研究常卡在两处,选题不清,数据挖掘不会做。很多医学生和医生已经有数据,却不知道该补什么、挖什么、怎么判断公共数据库是否适配课题。AI的价值,不是替你下结论,而是帮你更快完成数据调研、补充变量和扩展分析思路。
1. 临床研究为什么总卡在数据挖掘
1.1 不是没有数据,而是不知道怎么把数据用对
很多课题并不缺原始数据,缺的是挖掘思路。比如已经收集了300例肺癌患者的临床资料、CT影像和生存数据,下一步常见问题是,还需要哪些公共数据集来补强样本量、做外部验证,或者增加分子层面的解释。
这一步看似简单,实际上会直接影响研究质量。若只依赖单中心数据,常见问题包括样本量偏小、结论稳定性不足、亚组分析不够充分。对于临床预测模型来说,这会限制文章层次,也会影响发表成功率。
1.2 传统挖掘方式慢,且容易遗漏
过去做数据挖掘,往往依赖文献检索、数据库官网浏览、请教统计师或资深研究者。这个流程本身没错,但效率低,而且容易漏掉和课题高度相关的数据集。
临床研究真正难的,不是“会不会做统计”,而是“能不能先找到对的数据”。 一旦数据选错,后续的分组、建模、验证都会偏离目标。尤其在影像、组学、预后模型这类课题中,数据集是否包含临床结局、标注信息、随访时间,决定了研究能做到哪一步。
1.3 AI适合做什么,不适合做什么
AI最适合做的是前期辅助筛选和结构化整理。它可以快速给出数据库名称、可能的数据集方向、相关用途和下一步追问思路。比如围绕肺癌CT影像和预后预测,AI可先提示 TCIA、TCGA 等数据库,再进一步推荐更具体的数据集。
但要注意,AI不是数据库本身,也不能替代人工核实。 它的知识存在时效性和幻觉风险。模型可能知道旧数据集,却不知道最新更新版本;也可能把数据库和具体数据集混在一起。因此,AI输出只能作为初筛线索,最终仍要回到原始来源核查。
2. 用AI做数据挖掘的正确流程
2.1 先明确研究问题,再让AI找数据
数据挖掘不是先找库,再想题,而是先定问题,再找数据。临床研究者需要先回答三个问题:
- 研究对象是谁。
- 研究终点是什么。
- 需要哪些变量支持分析。
例如,如果目标是“基于CT影像预测肺癌治疗响应”,那数据最好同时包含影像、临床变量和结局信息。若希望做更深层分析,还可以进一步考虑分子数据、分型信息或治疗方案记录。
这个顺序非常关键。 没有明确研究问题,AI很容易返回一堆看似相关、实则不可直接用于课题的数据源。
2.2 让AI推荐数据库,再追问到具体数据集
实际操作中,可以先让AI推荐与课题相关的数据库,再继续追问具体数据集名称、样本特征、适用方向和局限性。这个过程像“层层筛选”。
以肺癌研究为例,AI可能先给出 TCIA、TCGA 等数据库。此时不要停。应继续追问:
- 是否有CT影像数据。
- 是否包含临床结局。
- 是否适合分割、特征提取或预后建模。
- 是否能支持外部验证。
只有把“数据库”问成“具体数据集”,数据挖掘才真正开始。 这是很多初学者容易忽略的一步。
2.3 把AI当成检索助手,不要当成最终判定者
AI回答快,但不是权威来源。对于科研来说,最重要的是可追溯性和可验证性。建议对AI输出的每个数据集做三项核查:
- 官网是否真实存在。
- 数据内容是否与AI描述一致。
- 是否满足当前研究设计需要。
如果研究有明确时效要求,还要注意模型知识截止时间。例如,模型若基于较早版本训练,就可能无法覆盖新公开的数据集。这也是为什么AI只能加速流程,不能代替判断。
3. AI如何帮助临床研究者完成高质量数据挖掘
3.1 扩大样本规模,提升分析可信度
在临床研究中,样本量偏小会导致统计功效不足。AI可以帮助研究者快速找到可扩展的公共数据源,从而补足样本量短板。比如单中心只有300例患者,若能结合公共数据库,就更容易完成分层分析、亚组分析和外部验证。
这对临床预测模型尤其重要。样本扩增后,可以更稳健地评估模型性能,如区分度、校准度和临床适用性。没有足够样本,很多模型看起来“很准”,实际上不稳。
3.2 补充变量,丰富模型解释
AI不仅能找数据,还能提示哪些变量适合加入模型。比如在肺癌研究中,除了CT影像和临床资料,某些数据库还可能包含基因组信息。这样就有机会把影像特征与分子特征结合,做更高层次的分析。
这类扩展有两个价值:
- 提升预测效果。
- 增强机制解释。
对于科研写作而言,这意味着文章不只是“做了一个模型”,而是“回答了更完整的问题”。这类结果更容易形成层次,也更接近高质量临床研究。
3.3 支持分割、特征提取和下游建模
很多临床影像研究,第一步是分割,第二步是提特征,第三步才是建模。AI在数据挖掘阶段,能够帮助你判断某个数据集更适合哪一步。
例如,有些数据集更适合做肿瘤分割和标注验证,有些数据集则更适合做预后评估或治疗响应预测。研究者若能提前知道这一点,就能减少无效试错。
数据集用途不同,决定了建模路径不同。 这是临床研究者使用AI时最该牢记的原则。
4. 临床研究者最容易犯的三个错误
4.1 只看名字,不看内容
很多数据集名称看起来很专业,但内部变量差异很大。有的只有影像,没有结局。有的有临床信息,但缺少完整随访。还有的标注格式复杂,不适合直接建模。
所以,不要因为数据集名字熟悉就直接使用。 应先核对变量、样本量、标注方式和适用任务。这个步骤做不到位,后面的统计分析再漂亮,也可能只是建立在错误数据基础上的结果。
4.2 只追求“更多”,不追求“更合适”
数据集不是越多越好,而是越匹配越好。对于同一个研究问题,过多无关数据只会增加清洗成本,甚至引入偏倚。临床研究要关注的是变量一致性、终点定义一致性和随访结构一致性。
适配性优先于数量。 这是数据挖掘和普通资料收集最大的区别。
4.3 过度相信AI结论
AI可以给思路,但不能保证每条推荐都准确。尤其在数据库边界模糊、数据集更新频繁的领域,错误推荐并不少见。临床研究者必须保留核验意识,尤其是涉及发表、送审和注册时。
建议把AI输出当作“第一版检索结果”,再由研究者逐条确认。这样既保留效率,也能降低风险。
5. 从统计基础到数据挖掘,AI真正帮你省在哪里
5.1 省时间,也省认知负担
对很多临床研究者来说,统计基础并不是最大障碍,真正难的是前期信息整理。AI能快速把零散信息压缩成可操作清单,让你更快完成选库、筛库和判断用途。
这对时间紧张的医生尤其重要。门诊、病房、科研三线并行时,最缺的就是系统梳理时间。AI的价值,就是把“找数据”这件事从手工劳动变成半自动流程。
5.2 让你把精力放在关键判断上
当AI完成初步筛选后,研究者就可以把精力集中在更高价值的环节,例如:
- 变量是否可比。
- 终点是否清晰。
- 统计方法是否匹配。
- 模型是否具有临床解释性。
这比盲目翻数据库更有效,也更符合高质量临床研究的逻辑。对于学生和年轻医生来说,这种工作方式尤其能缩短入门周期。
5.3 借助解螺旋,把数据挖掘变成可落地流程
如果你希望把AI真正用到科研里,而不是停留在“会问不会做”,可以借助解螺旋这类科研工具,直接围绕课题进行数据集调研、变量梳理和分析路径设计。它的核心价值,是把数据挖掘从零散搜索变成结构化任务。
对于正在做临床课题的研究者来说,这意味着更快定位合适数据源,更少走弯路,也更容易把AI输出转化为可执行方案。当你需要把公共数据集调研、变量扩展和课题设计串起来时,解螺旋可以显著提升效率。
总结Conclusion
临床研究的数据挖掘,核心不是“会不会统计”,而是“能不能找到并用对数据”。AI最适合介入的环节,是前期的数据库筛选、数据集追问和变量扩展。它能帮助研究者更快完成公共数据调研,补足样本量,丰富分析维度,并为后续建模打下基础。
但要记住,AI只能加速,不会替代核查。 研究者仍需检查数据来源、变量完整性和时效性。若你希望把这种流程真正用于课题设计和临床研究推进,可以尝试解螺旋,让数据挖掘更高效、更规范,也更接近可发表的研究标准。
- 引言Introduction
- 1. 临床研究为什么总卡在数据挖掘
- 2. 用AI做数据挖掘的正确流程
- 3. AI如何帮助临床研究者完成高质量数据挖掘
- 4. 临床研究者最容易犯的三个错误
- 5. 从统计基础到数据挖掘,AI真正帮你省在哪里
- 总结Conclusion