12
 分享
引言Introduction
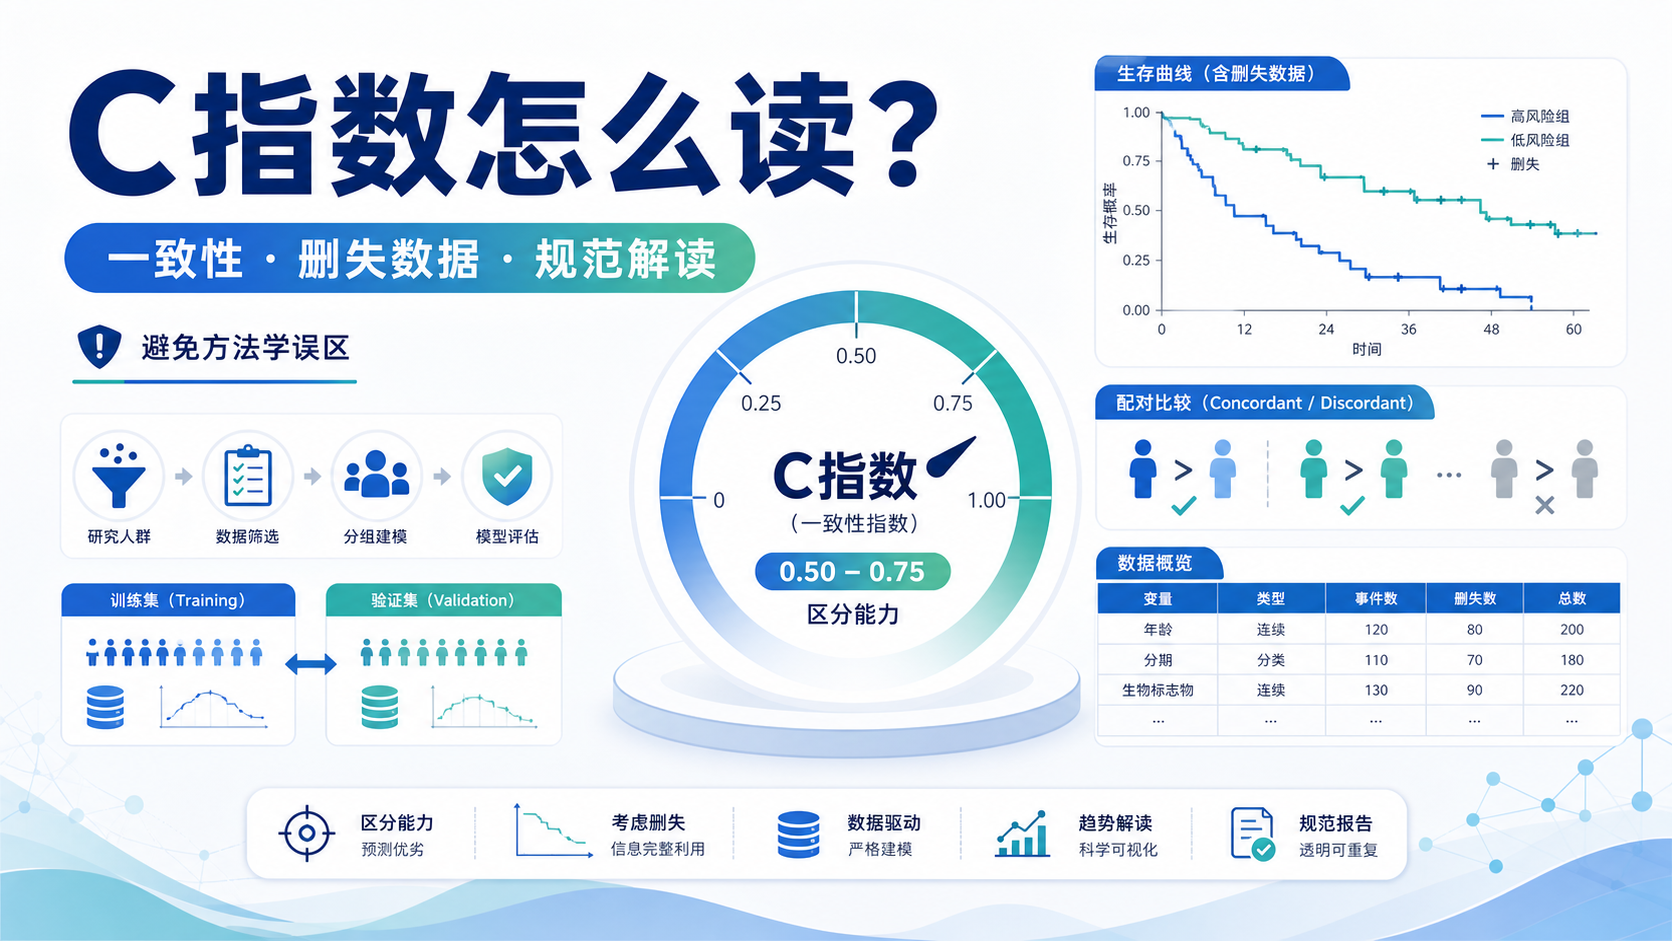
在预测模型研究里,很多人会把C指数当成“唯一答案”。但如果不理解它的计算逻辑、适用场景和局限,结果很容易被误读。C指数不是越高越好,也不是单独就能证明模型可靠。
1. C指数到底衡量什么
1.1 一致性,而不是简单准确率
C指数,即一致性指数,核心看的是模型预测顺序和真实结局顺序是否一致。它常用于生存资料和预后模型评价。本质上,它估计的是“随机抽取一对个体时,模型排序与真实结局排序一致的概率”。
以生存分析为例,如果一位患者真实生存时间更长,那么模型也应给出更长的预测生存时间,或者更高的生存概率。只要排序一致,这一对子就计为一致对子。
1.2 它和回归模型密切相关
临床预测模型的统计学基础,通常是回归建模。常见类型包括:
- 多重线性回归。
- Logistic回归。
- Cox回归。
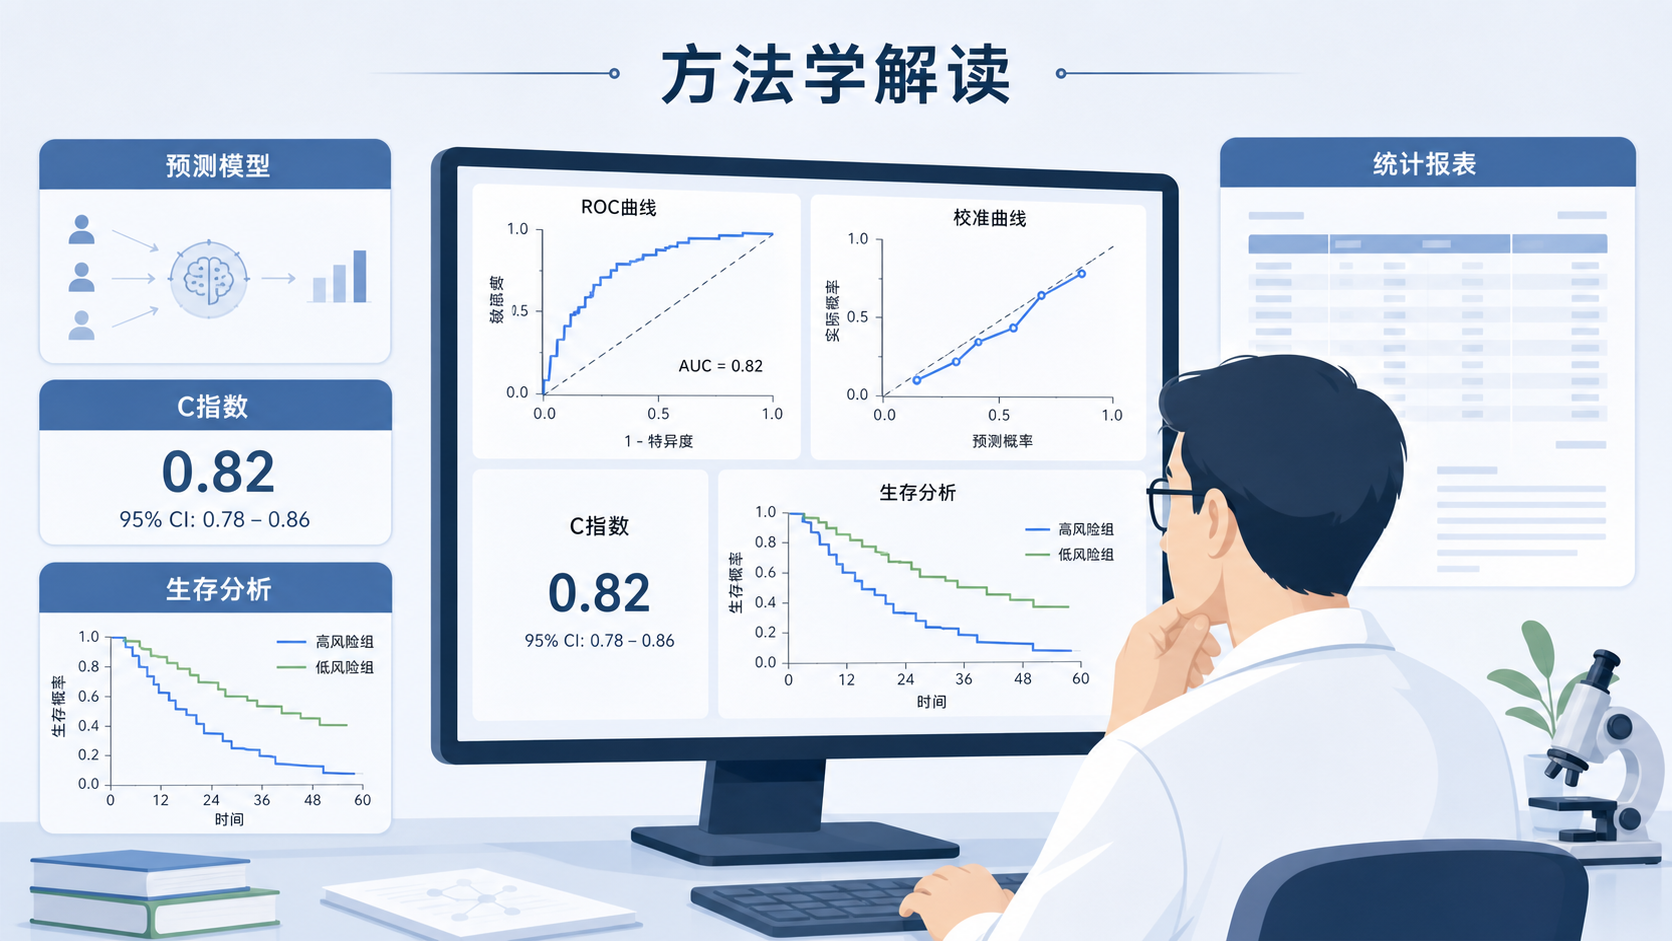
C指数并不是建模本身,而是对模型区分能力的评价。 也就是说,模型能不能把高风险和低风险人群分开,是C指数重点关心的问题。
2. C指数的计算逻辑
2.1 先配对,再筛选有用对子
计算C指数时,首先把所有研究对象两两配对。若样本量为n,理论上的配对数是C(n,2)。
但并不是所有对子都能用于评价。需要排除两类无效对子:
- 较小观察时间的个体没有达到终点。
- 两个个体都没有达到终点。
剩下的,才是“有用对子”。
2.2 一致对子数除以有用对子数
最终公式很直接:
C-index = 一致对子数 / 有用对子数。
这意味着,C指数的高低,取决于模型在多少个可比较的患者对子中保持了正确排序。它不是单纯看单个患者是否预测正确,而是看整体排序是否正确。
2.3 数值区间要这样理解
C指数的范围通常在0.5到1之间。
- 0.5,表示完全随机。
- 1,表示完全一致。
- 0.50-0.70,通常认为准确度较低。
- 0.71-0.90,通常认为中等准确度。
- 高于0.90,才可视为较高准确度。
如果一个模型C指数只有0.52,却被写成“预测性能良好”,这就是典型的过度解读。
3. 研究设计中最常见的误区
3.1 把训练集C指数当成最终结论
很多初学者在训练集上得到一个很高的C指数,就直接写进论文结论。这样做风险很大。因为训练集上的结果,容易受到过拟合影响。
训练集C指数只能说明模型在建模数据中的表现,不等于真实泛化能力。
更规范的做法是:
- 在训练集构建模型。
- 在验证集或交叉验证中评价。
- 尽量报告校正后的C指数。
3.2 忽视删失数据的处理
生存分析中,删失数据是常态。C指数的计算必须考虑终点是否发生。若忽视删失机制,结果会偏。
因此,实际分析中常会用逆概率加权等方法处理截尾信息。以R语言实现时,相关函数通常会设置cens.model等参数来指定处理方式。
3.3 把时间依赖性忽略掉
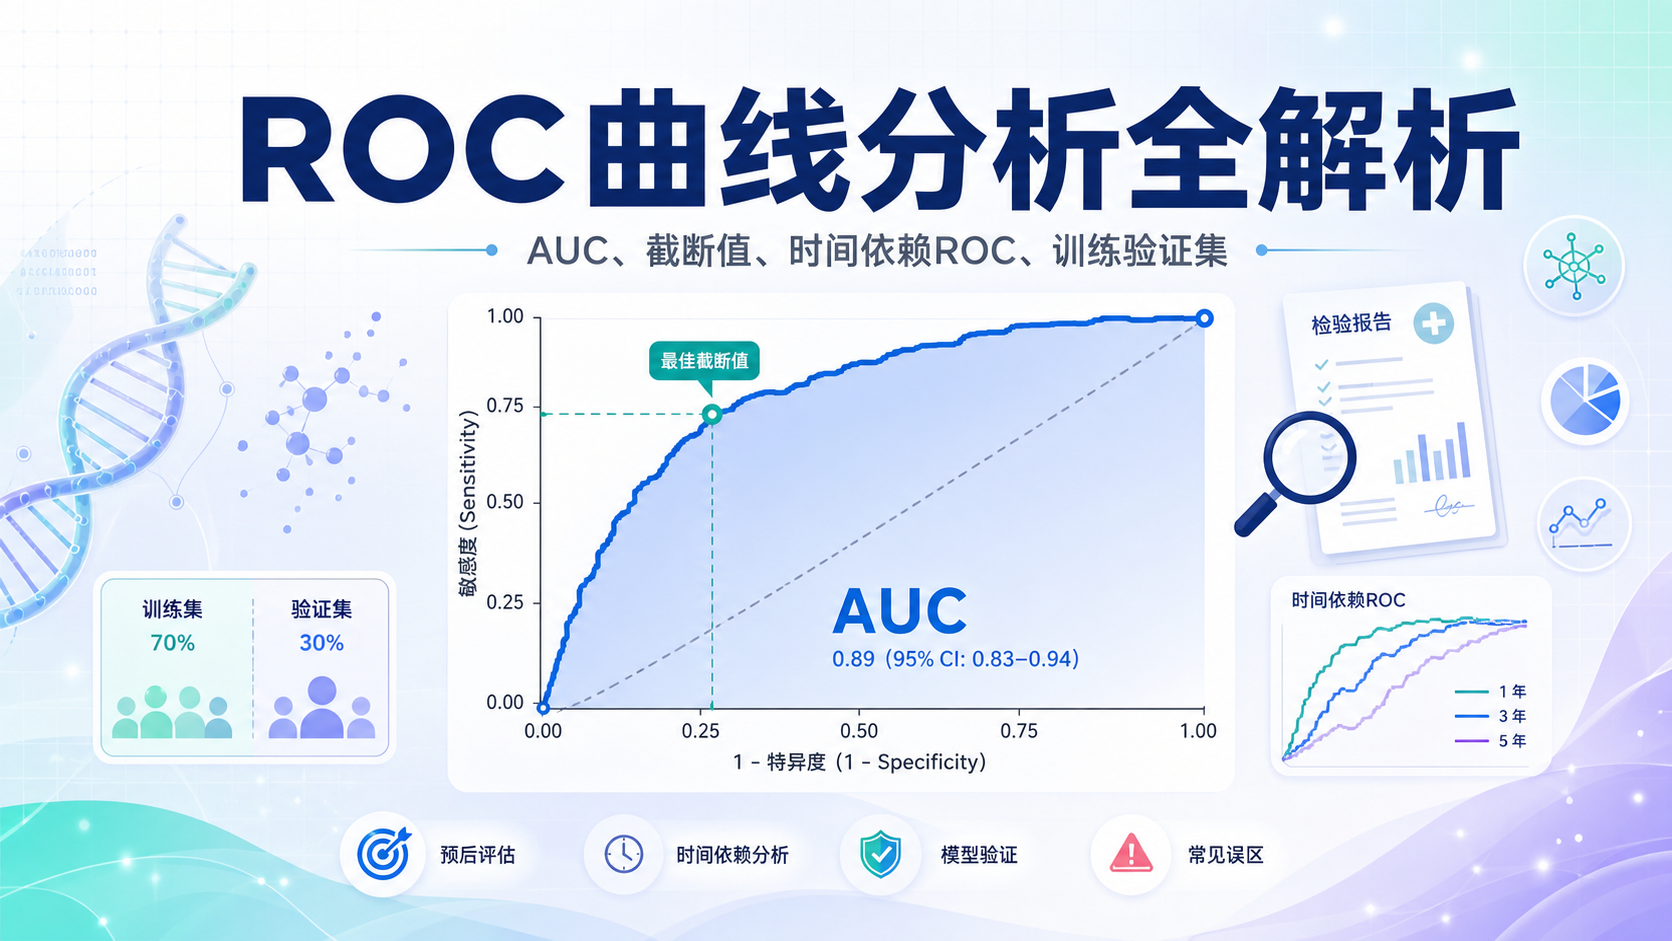
很多模型不是静态的。它在1年、2年、5年时的区分能力可能不同。因此,C指数最好结合具体时间点来解释。
例如同一模型:
- 1年C指数较高。
- 10年C指数下降。
这并不罕见,提示模型对短期结局更敏感,对长期预测能力可能减弱。
4. 规范解读C指数时要看什么
4.1 看的是趋势,不只是单个数值
在研究设计中,C指数最有价值的地方,不是一个孤立的数字,而是它随时间变化的趋势。若不同时间点的C指数维持在0.7以上,通常说明模型具有一定稳定区分能力。
但如果早期很高,后期明显下滑,就要考虑:
- 随访时间是否足够。
- 变量是否存在时变效应。
- 模型是否适用于长期预测。
4.2 训练集和交叉验证结果要一起看
以bootstrap交叉验证为例,常会同时得到:
- Apparent C-index,训练集表观值。
- Bootstrapped C-index,重抽样校正值。
两者存在轻微差异是正常的。 这种差异恰恰说明模型在外推时会有一定性能损失。若训练集很高,而校正后明显下降,就要警惕过拟合。
4.3 图形展示比单一表格更直观
除了数值,绘制C指数曲线也很重要。横轴为时间,纵轴为C指数。图形能直接显示模型在各时间点的表现。
规范的图形解读应关注:
- 曲线是否平稳。
- 是否存在明显波动。
- 是否在某个时间段持续下降。
- 是否需要调整x轴范围,避免图形截断。
图不是装饰,而是帮助发现模型局限的重要工具。
5. 一个规范的分析流程应该怎么做
5.1 推荐步骤
在实际研究中,建议按以下顺序完成:
- 明确结局类型,判断是否适合使用C指数。
- 建立回归模型,如Cox模型。
- 处理缺失值,避免后续分析偏倚。
- 进行内部验证,如bootstrap或交叉验证。
- 计算不同时间点的C指数。
- 绘制C指数曲线。
- 结合临床背景解释结果。
5.2 结果报告要具体
论文写作中,不建议只写“模型表现良好”。更合理的表达方式是:
- 1年C指数为0.879。
- 2年C指数为0.865。
- 10年C指数为0.793。
- 校正后C指数与表观值接近,提示模型稳定性较好。
这样的写法更符合E-E-A-T,也更便于同行评审。
6. 如何避免方法学误区并提升论文质量
6.1 变量选择要有依据
模型不是变量越多越好。变量过多会抬高过拟合风险。尤其在样本量有限时,更应该控制自变量数量,并结合临床意义筛选候选变量。
6.2 缺失值和删失值都要提前处理
这两类问题都可能影响C指数。缺失值会降低样本有效性,删失值会影响真实结局顺序判断。研究设计阶段就要考虑数据质量,而不是分析到一半再补救。
6.3 不要把区分能力等同于临床效用
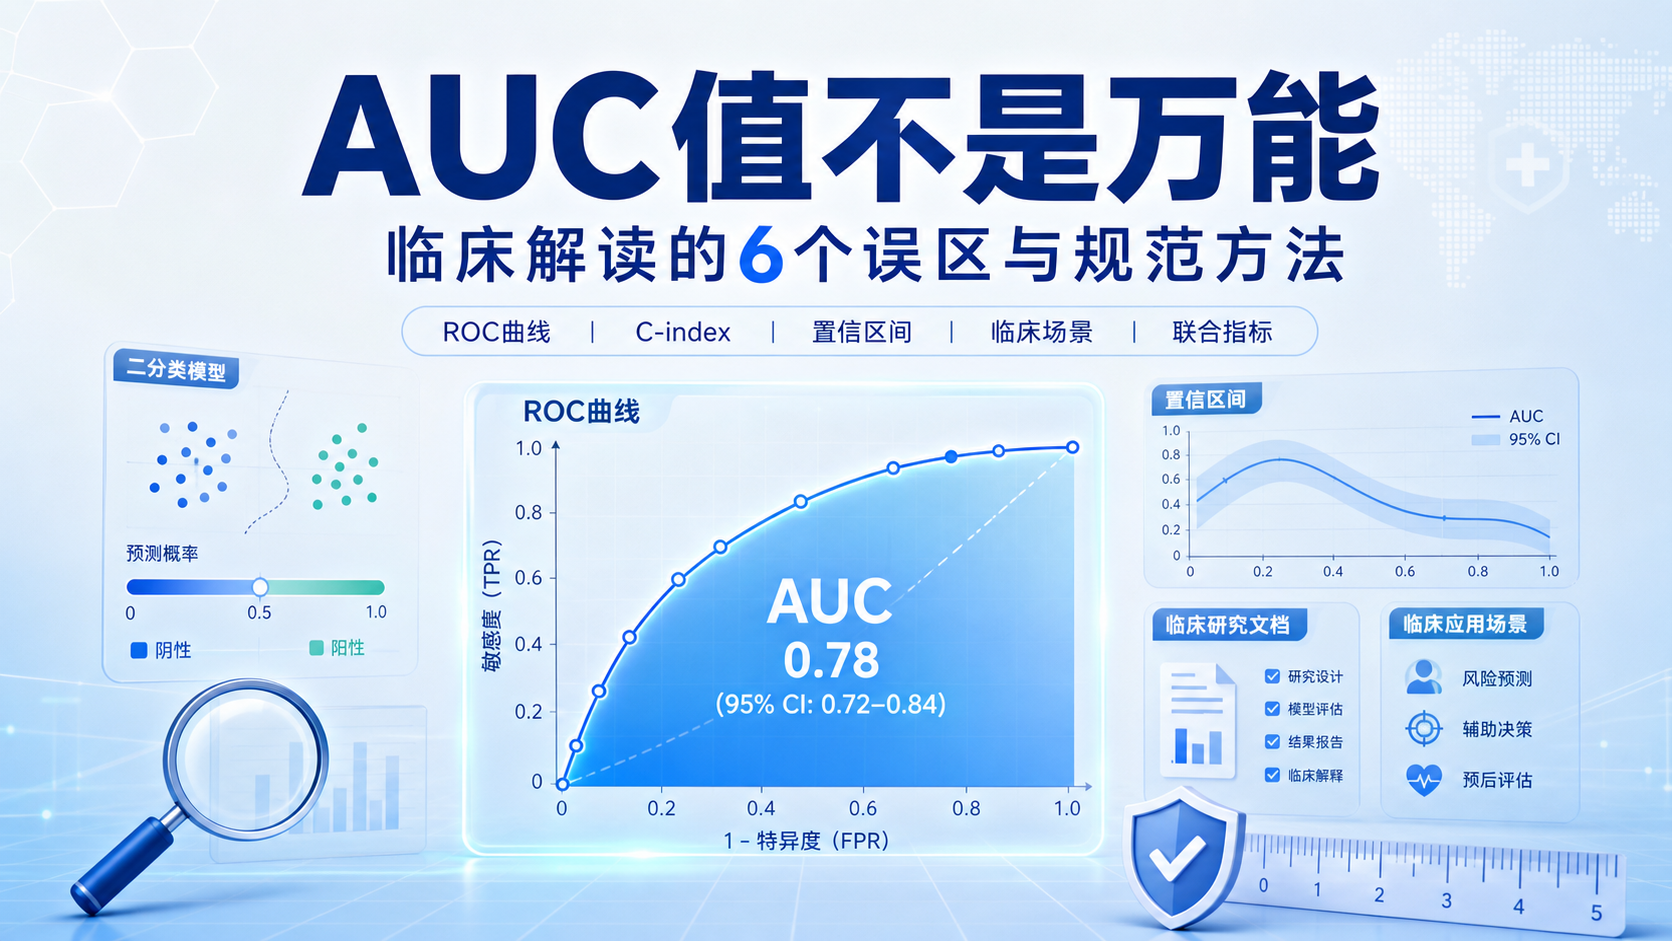
C指数只反映区分能力,不直接等于临床可用性。一个模型可能C指数不错,但校准差,或者临床决策收益有限。真正规范的预测模型研究,通常还要结合校准曲线、决策曲线等指标一起判断。
7. 结论与实践建议
C指数是预测模型研究中非常核心的评价指标,尤其适用于生存分析和预后模型。它回答的不是“模型是否绝对正确”,而是“模型能否正确排序患者风险”。
在研究设计中,必须同时关注训练集与校正后结果,理解删失机制,避免把表观值当成最终结论。只有这样,C指数才真正有解释力。
如果你正在整理预测模型论文,或者需要把C指数结果写得更规范、更符合投稿要求,建议借助解螺旋 的系统化方法和实战内容,减少方法学误区,让模型评价更严谨、表达更专业。
- 引言Introduction
- 1. C指数到底衡量什么
- 2. C指数的计算逻辑
- 3. 研究设计中最常见的误区
- 4. 规范解读C指数时要看什么
- 5. 一个规范的分析流程应该怎么做
- 6. 如何避免方法学误区并提升论文质量
- 7. 结论与实践建议