7
 分享
引言Introduction
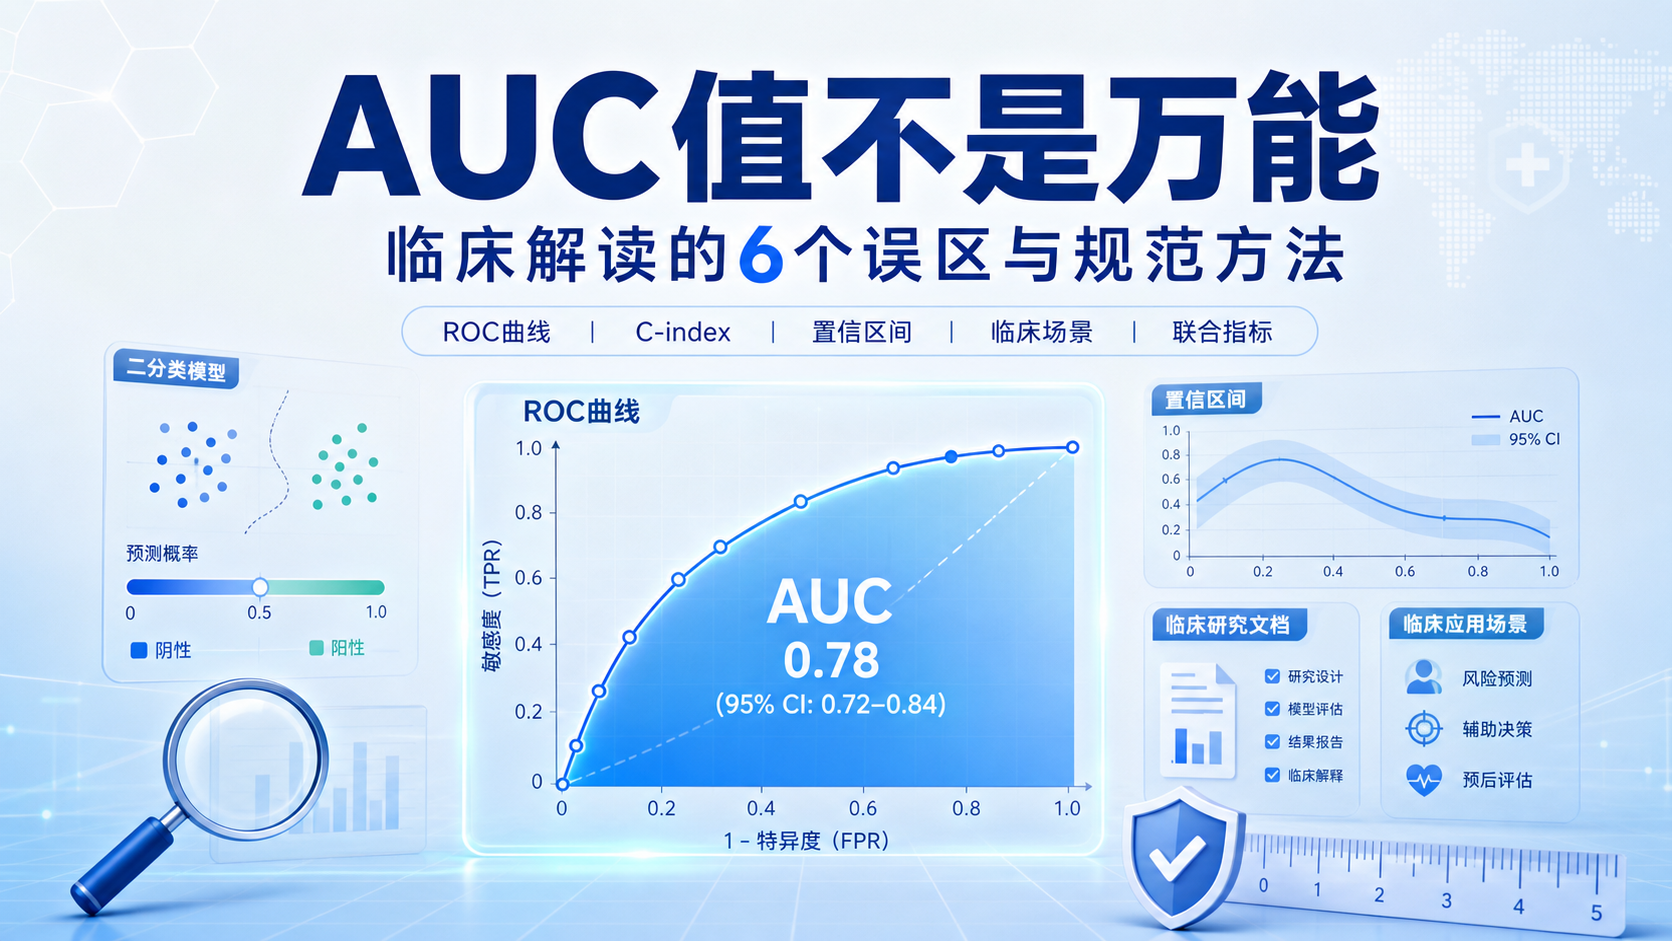
AUC值常被当成“模型好坏”的唯一标准,但临床研究里,很多人其实读错了它。AUC高,不等于模型一定可用;AUC低,也不代表模型没有价值。 如果你正在做预测模型、读文献或准备发表,先把AUC值的真实临床意义弄清楚。
1. AUC值到底代表什么
1.1 ROC曲线和AUC值的关系
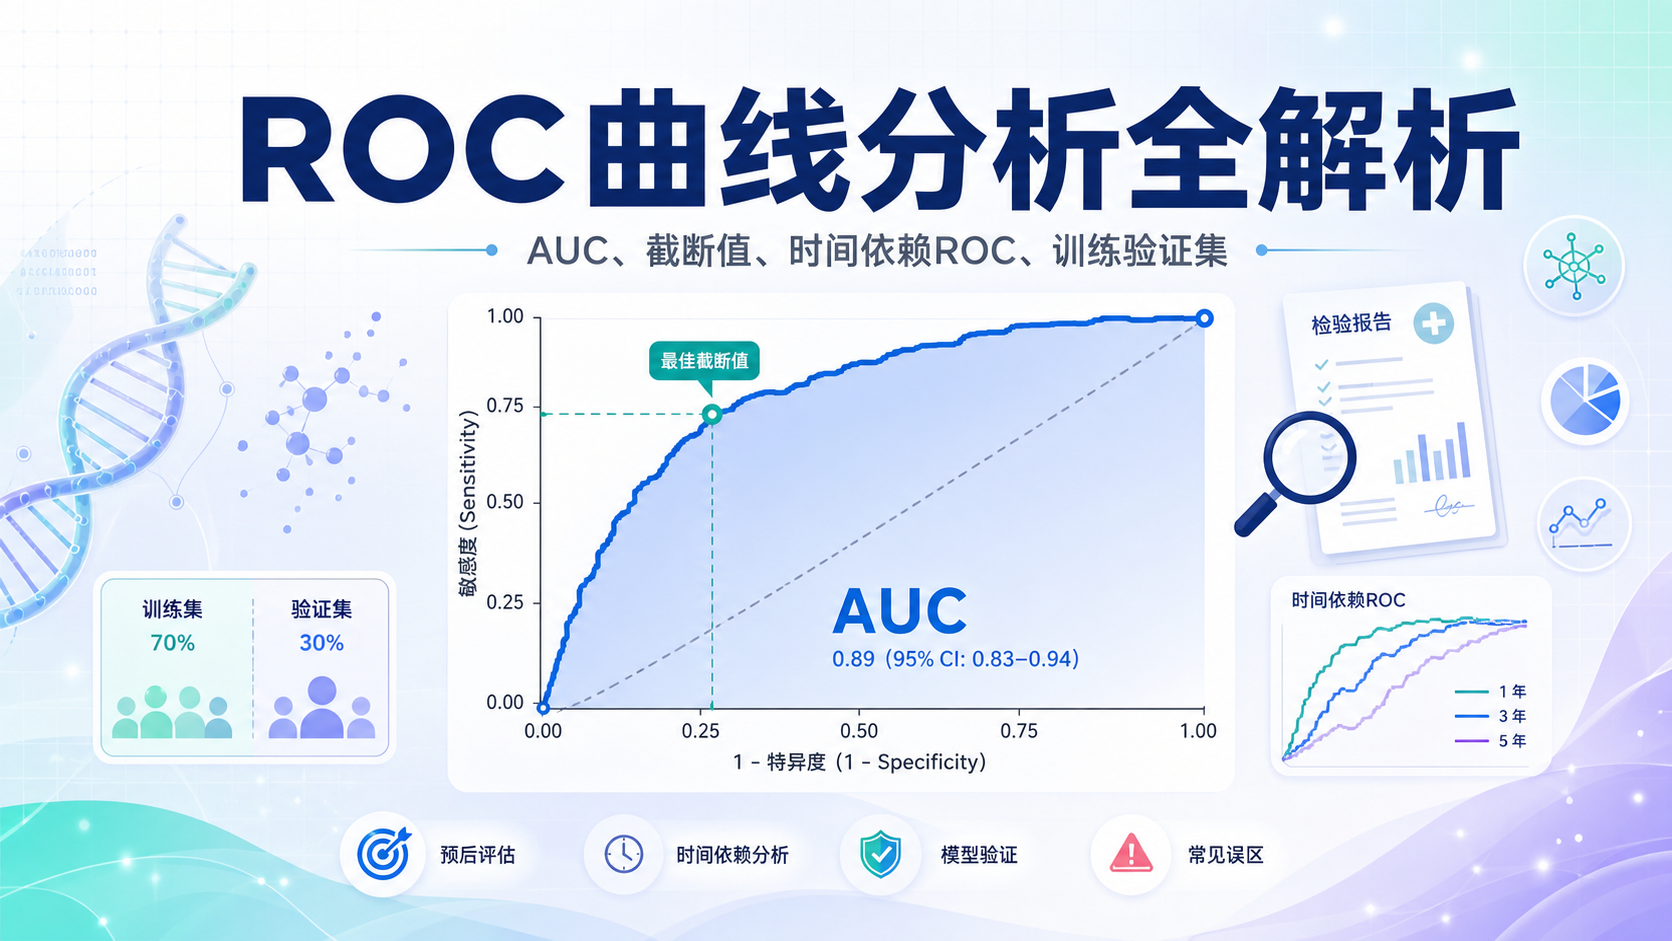
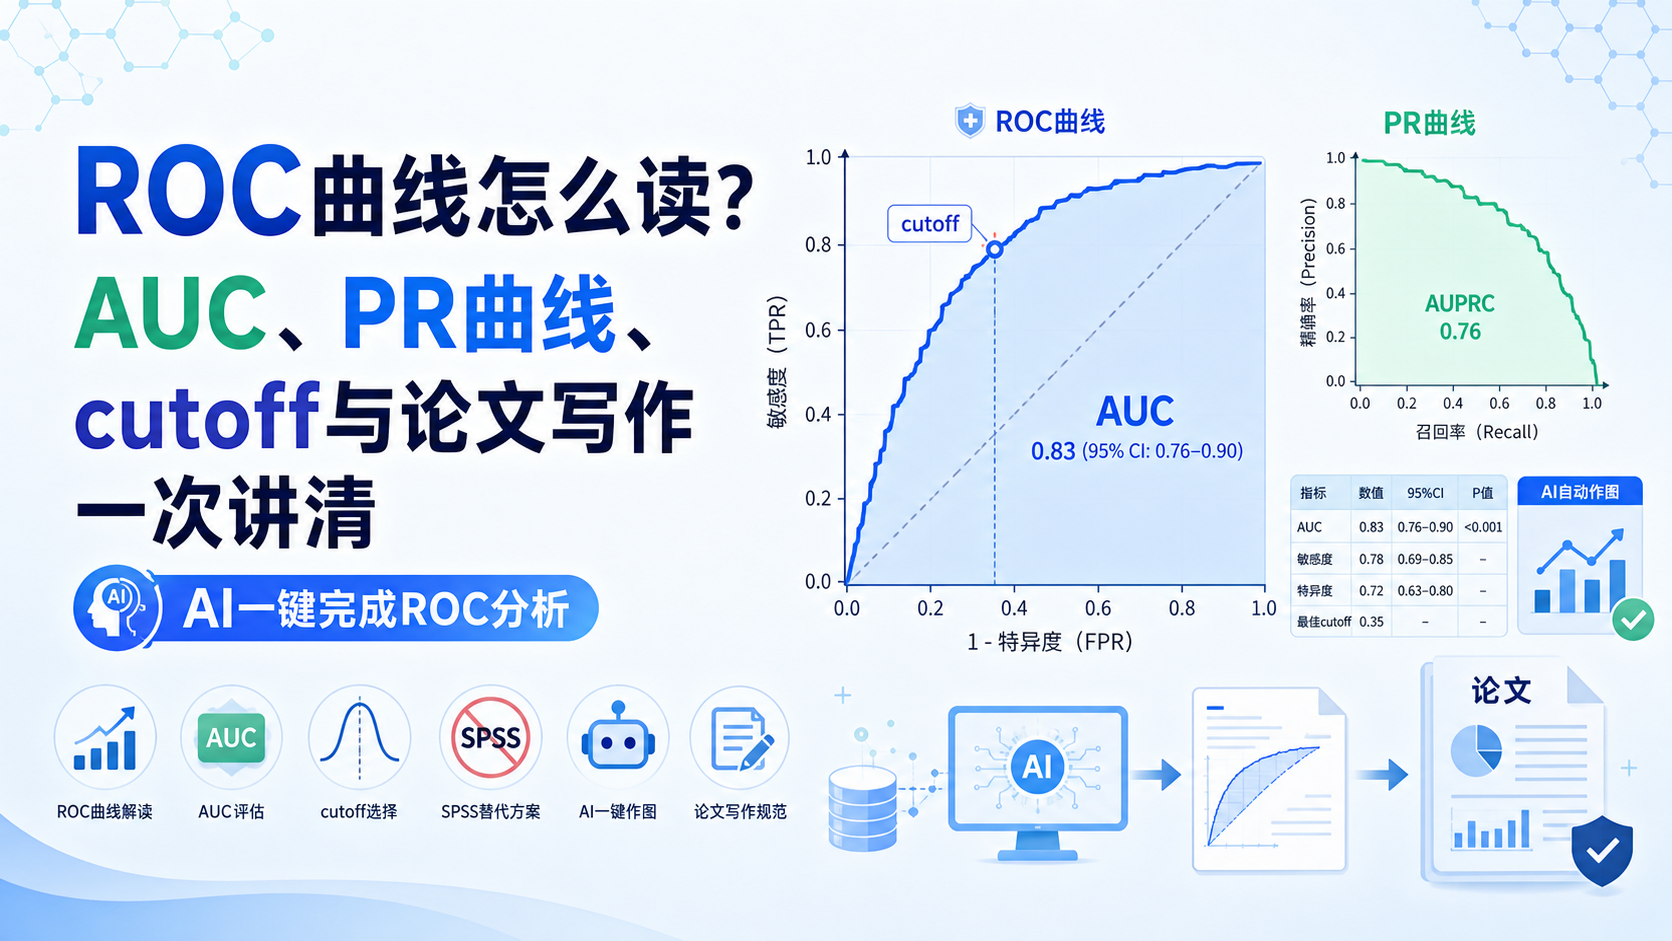
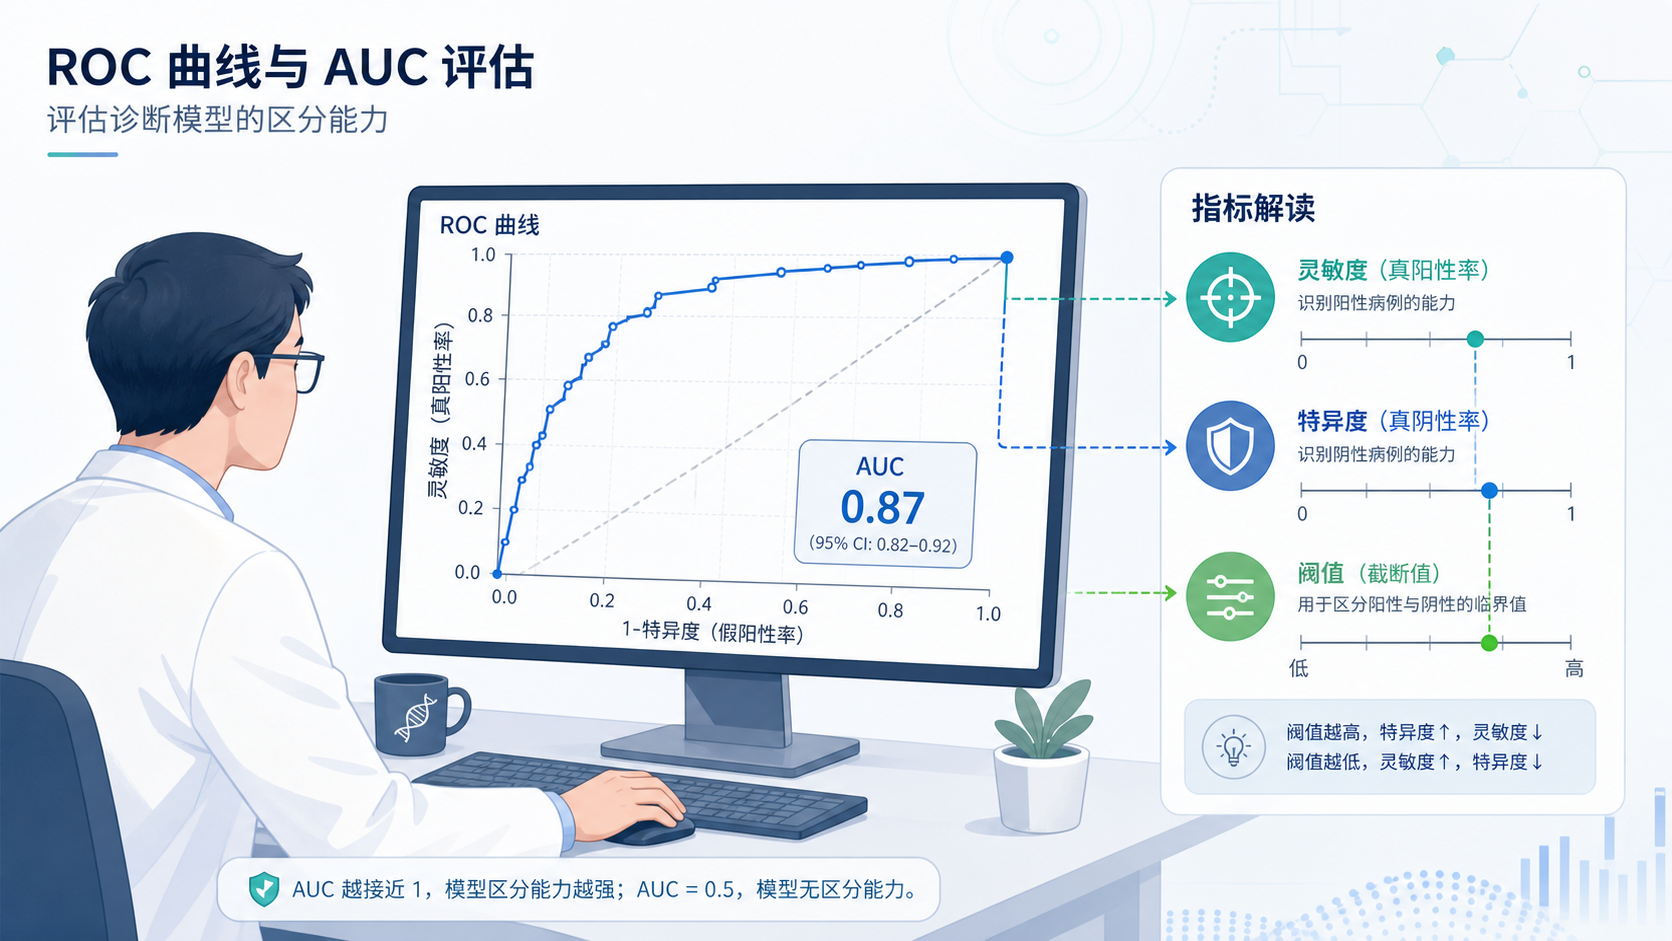
ROC曲线全称是受试者工作特征曲线。它的横坐标是假阳性率 ,即1减去特异度。纵坐标是真阳性率 ,即灵敏度。曲线上的每一个点,都对应一个分类阈值。
AUC值就是ROC曲线下面积。 它反映的是模型对阳性和阴性样本的整体区分能力。AUC通常在0.5到1.0之间。0.5接近随机猜测,1.0表示完全区分。
从统计学角度看,AUC值更像是一个“排序能力”指标。它回答的是:模型是否能把真正阳性排在真正阴性前面,而不是直接回答“这个阈值下准确不准确”。
1.2 二分类模型里,AUC值和C-index的对应关系
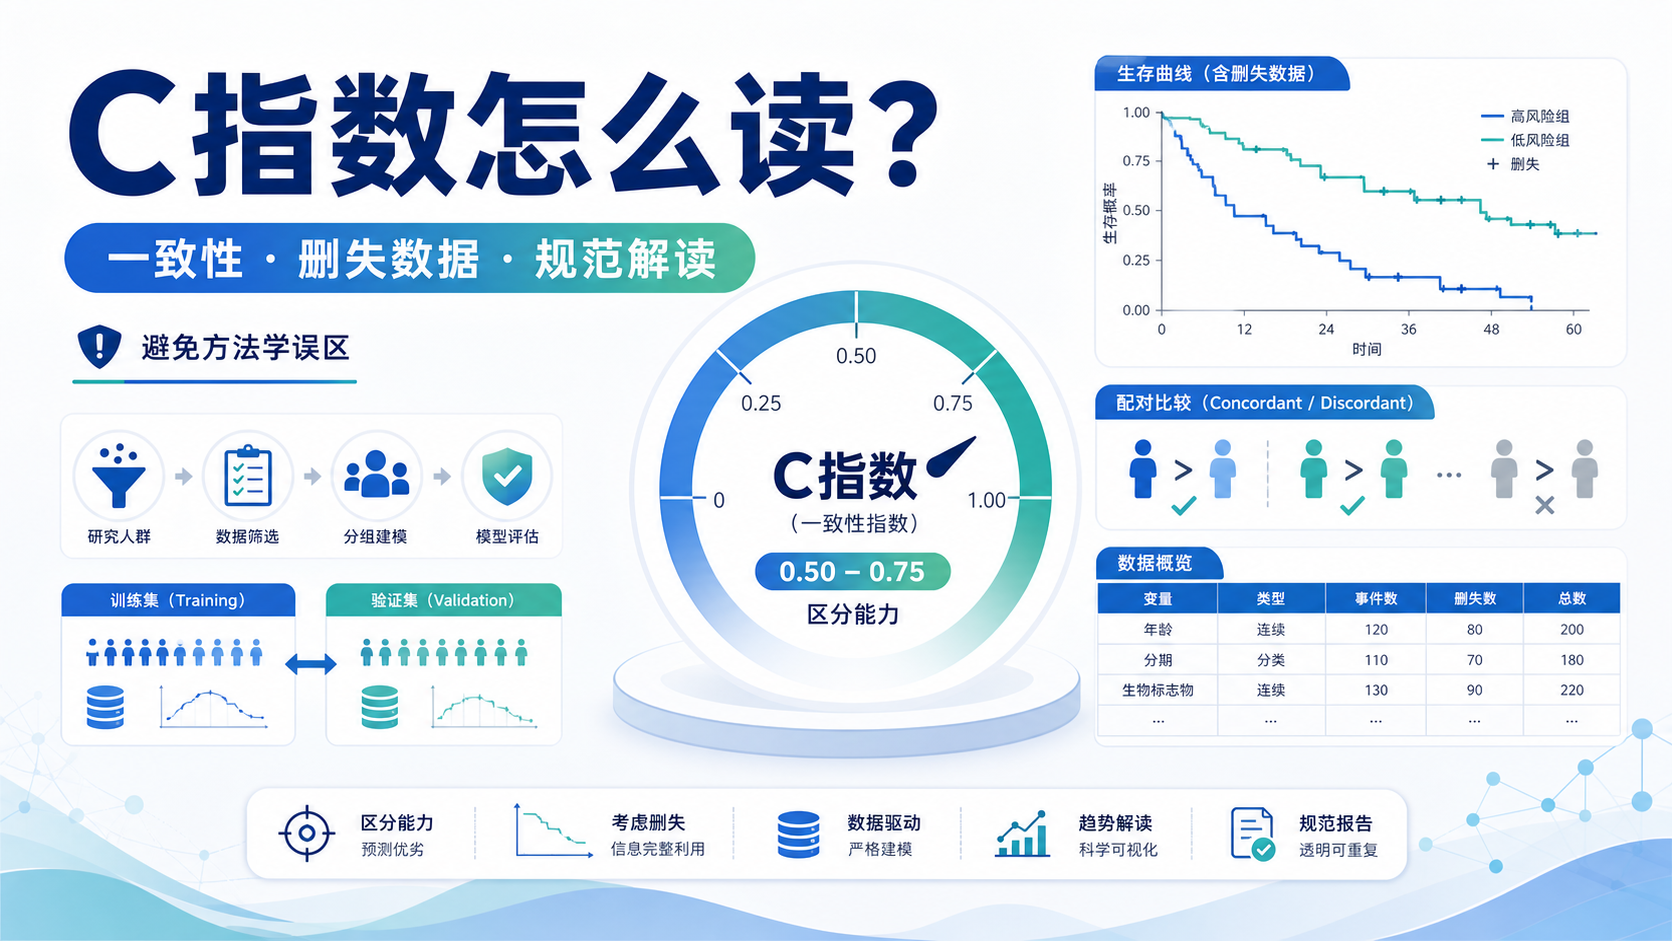
在二分类场景下,C-index与AUC值是等价的。 这也是为什么很多临床预测模型文章会同时出现ROC曲线和C-index。两者本质上都在评价模型的判别能力。
临床研究中常见的Logistic回归预测模型,最终输出的是某种事件发生概率。此时AUC值可以直观衡量模型是否能区分“发生事件”和“未发生事件”两组人群。
但要注意,AUC值评价的是整体区分度,不是某个固定阈值下的分类表现。 这一步很多初学者会混淆。
1.3 AUC值的临床解释边界
常见经验分层是:
- 0.50到0.70,区分能力较弱
- 0.71到0.90,中等区分能力
- 高于0.90,区分能力较强
但这个分层不能机械套用。不同疾病、不同结局、不同样本量,AUC值的临床意义并不一样。比如罕见病预测、危重症预警、术后并发症识别,临床容忍度都不同。
AUC值不是诊断金标准,它只是一个性能指标。 是否真的能用于临床,还要看校准度、临床净获益、可解释性和外部验证。
2. AUC值常见解读误区
2.1 误区一,高AUC就等于高临床价值
这是最常见的误区。AUC高,只能说明模型区分阳性和阴性的能力较好。 它不能说明模型是否适合临床落地。
例如,一个模型AUC值达到0.85,说明判别能力不错。但如果该模型需要10个难以获取的变量,或需要昂贵检测,实际应用价值仍可能有限。相反,一个AUC值只有0.72的模型,如果变量简单、可重复、成本低,反而更有实用性。
临床决策不是只看“分得开”,还要看“用得起、用得稳、用得准”。
2.2 误区二,AUC值低就意味着模型没用
这也不准确。AUC值偏低,不一定说明模型完全无价值。原因可能包括:
- 结局本身受多因素强烈影响
- 特征信息有限
- 样本异质性大
- 预测目标本就难以区分
在某些场景下,AUC值0.65左右的模型仍可能具有辅助决策意义。 尤其是在早筛、风险分层、预警系统中,只要能帮助识别高风险人群,就可能有临床价值。
更重要的是,不同任务对AUC值的要求不同。筛查工具与确诊工具,容忍的误差本来就不一样。
2.3 误区三,AUC值对阈值选择已经足够
AUC值是跨阈值的综合指标,但临床决策最终总要落到某个阈值上。AUC高不代表在你选定的阈值下,灵敏度和特异度都理想。
举个直观例子。一个模型的AUC值很高,但在临床最关心的高灵敏度区间,特异度可能很差。这样会带来过多假阳性,增加不必要检查。
所以,AUC值只能回答“整体上能不能区分”,不能替代阈值分析、校准曲线和决策曲线分析。
3. 为什么AUC值会被过度神化
3.1 AUC值对类别不平衡更稳,但不代表万能
ROC曲线的一个优势是,当正负样本分布变化时,曲线形状相对稳定。相比之下,P-R曲线在类别不平衡时往往更敏感。这也是AUC值在临床预测模型中被广泛使用的重要原因。
但“稳定”不等于“全面”。在极度不平衡的数据中,AUC值可能看起来不错,但模型对少数类的实际识别能力未必理想。此时需要结合召回率、精准率、F1值等指标一起判断。
临床上,少数类往往恰恰是最重要的部分,比如罕见并发症、死亡、复发、转移。只看AUC值,很容易高估模型效果。
3.2 AUC值忽略了概率校准
AUC值只评价排序,不评价概率是否准确。也就是说,模型把高风险人群排在前面,不代表它给出的0.8概率真的对应80%的发生率。
一个AUC值很高但校准很差的模型,在临床上仍可能误导决策。 例如,预测某并发症风险为70%,实际发生率却只有20%。这类模型即便判别能力不错,也会影响临床沟通和干预策略。
因此,预测模型论文通常还需要报告:
- 校准曲线
- Hosmer-Lemeshow检验
- Brier score
- 决策曲线分析
AUC值只是第一步,不是终点。
3.3 AUC值不能说明变量是否有因果关系
这是科研写作中的另一个误区。AUC值高,只说明模型能分辨结果,不代表这些变量是病因,也不代表存在因果关系。
预测模型和病因研究不是一回事。前者关注“能不能预测”,后者关注“为什么发生”。把AUC值和因果推断混为一谈,是临床研究里很常见的逻辑错误。
尤其在回归建模中,变量可能只是关联因素,未必是可干预因素。发表文章时必须区分预测价值和机制价值。
4. 如何更规范地解读AUC值
4.1 先看AUC值,再看置信区间
AUC值必须和95%置信区间一起报告。 单独报一个AUC值,信息是不完整的。置信区间越窄,说明估计越稳定。置信区间过宽,则提示样本量不足或波动较大。
例如,在一个680例数据集上,模型AUC值为0.8066,95%CI为0.7586到0.8547。这个结果说明模型具有较好的区分能力,同时估计也相对稳定。若只看0.8066,读者无法判断不确定性大小。
临床论文里,“AUC值+95%CI”比单个AUC值更有说服力。
4.2 与临床场景匹配,而不是只看数值
不同场景应使用不同判断逻辑:
- 筛查场景 :更关注灵敏度,避免漏诊
- 确诊场景 :更关注特异度,减少误诊
- 风险分层 :更关注整体排序能力
- 治疗决策 :更关注净获益和阈值合理性
所以,AUC值的意义必须放进真实场景里理解。脱离临床问题谈AUC值,往往只是在看一个抽象数字。
4.3 和其他指标联合解读
规范的模型评价,至少应把以下内容放在一起看:
- AUC值 ,看区分能力。
- 校准曲线 ,看预测概率是否靠谱。
- 决策曲线分析 ,看临床净获益。
- 外部验证 ,看泛化能力。
- 临床可行性 ,看变量获取是否方便。
只有AUC值高,不能说明模型已足够成熟。 模型评价应从统计性能走向临床可用性。
5. 临床研究中如何正确报告AUC值
5.1 报告方式要完整
建议至少写清楚以下内容:
- 模型来源和类型,如Logistic回归、Cox回归
- 训练集和验证集来源
- AUC值及95%置信区间
- 是否进行了外部验证
- 是否比较了多个模型
- 是否使用同一阈值进行分类分析
如果有多个模型,最好比较AUC值差异,并说明统计检验方法。这样才能避免“只挑最好看的结果”。
5.2 避免过拟合后的虚高AUC值
训练集AUC值高,不代表真实泛化能力高。 如果模型在建模时使用了过多变量,或者样本量不足,AUC值很容易虚高。这就是过拟合问题。
因此,文章中最好区分:
- 训练集AUC值
- 内部验证AUC值
- 外部验证AUC值
只有经过验证的AUC值,才更接近真实临床表现。
5.3 结论表述要克制
不要写“该模型具有极高诊断价值”,除非证据非常充分。更稳妥的写法是:
- 模型具有较好的区分能力
- AUC值提示模型有一定临床应用潜力
- 该模型在外部队列中仍需进一步验证
科研写作中,克制比夸张更可信。
6. 用实操思维看AUC值,才能真正解决问题
在实际分析中,先拟合模型,再预测概率,再计算ROC曲线和AUC值,是标准流程。随后还应结合置信区间、阈值、校准和外部验证一起判断。AUC值不是终点,而是模型评价的起点。
如果你在论文写作、数据分析或课程学习中,需要更系统地掌握ROC曲线、AUC值、C-index以及后续的模型评价流程,建议直接借助成熟工具和标准化课程。解螺旋提供的临床研究学习资源,可以帮助你把“会算AUC值”升级为“会正确解释AUC值、会规范报告AUC值、会在临床语境中使用AUC值”,这正是解决痛点的关键。
总结Conclusion
AUC值反映的是模型的区分能力,不是全部临床价值。 它适合用来比较模型、筛选候选模型、评估整体排序能力,但不能替代校准、阈值分析和外部验证。对于医学生、医生和科研人员来说,真正重要的不是把AUC值报出来,而是把它放回临床场景中正确解释。
如果你希望进一步系统掌握ROC曲线、AUC值和C-index的分析思路,并提升临床预测模型的写作与解读能力,欢迎关注并使用解螺旋 的专业内容与课程资源。
- 引言Introduction
- 1. AUC值到底代表什么
- 2. AUC值常见解读误区
- 3. 为什么AUC值会被过度神化
- 4. 如何更规范地解读AUC值
- 5. 临床研究中如何正确报告AUC值
- 6. 用实操思维看AUC值,才能真正解决问题
- 总结Conclusion