72
 分享
引言Introduction
通路富集分析不是“看热闹”。真正难点在于,结果一多就容易误判物种、误读ID,甚至把统计显著当成生物学结论。想让差异基因分析更可信,必须先读懂GO和KEGG的字段,再学会平行验证。
1. 为什么通路富集分析不能只看一个数据库
1.1 GO和KEGG的关系,本质是互补验证
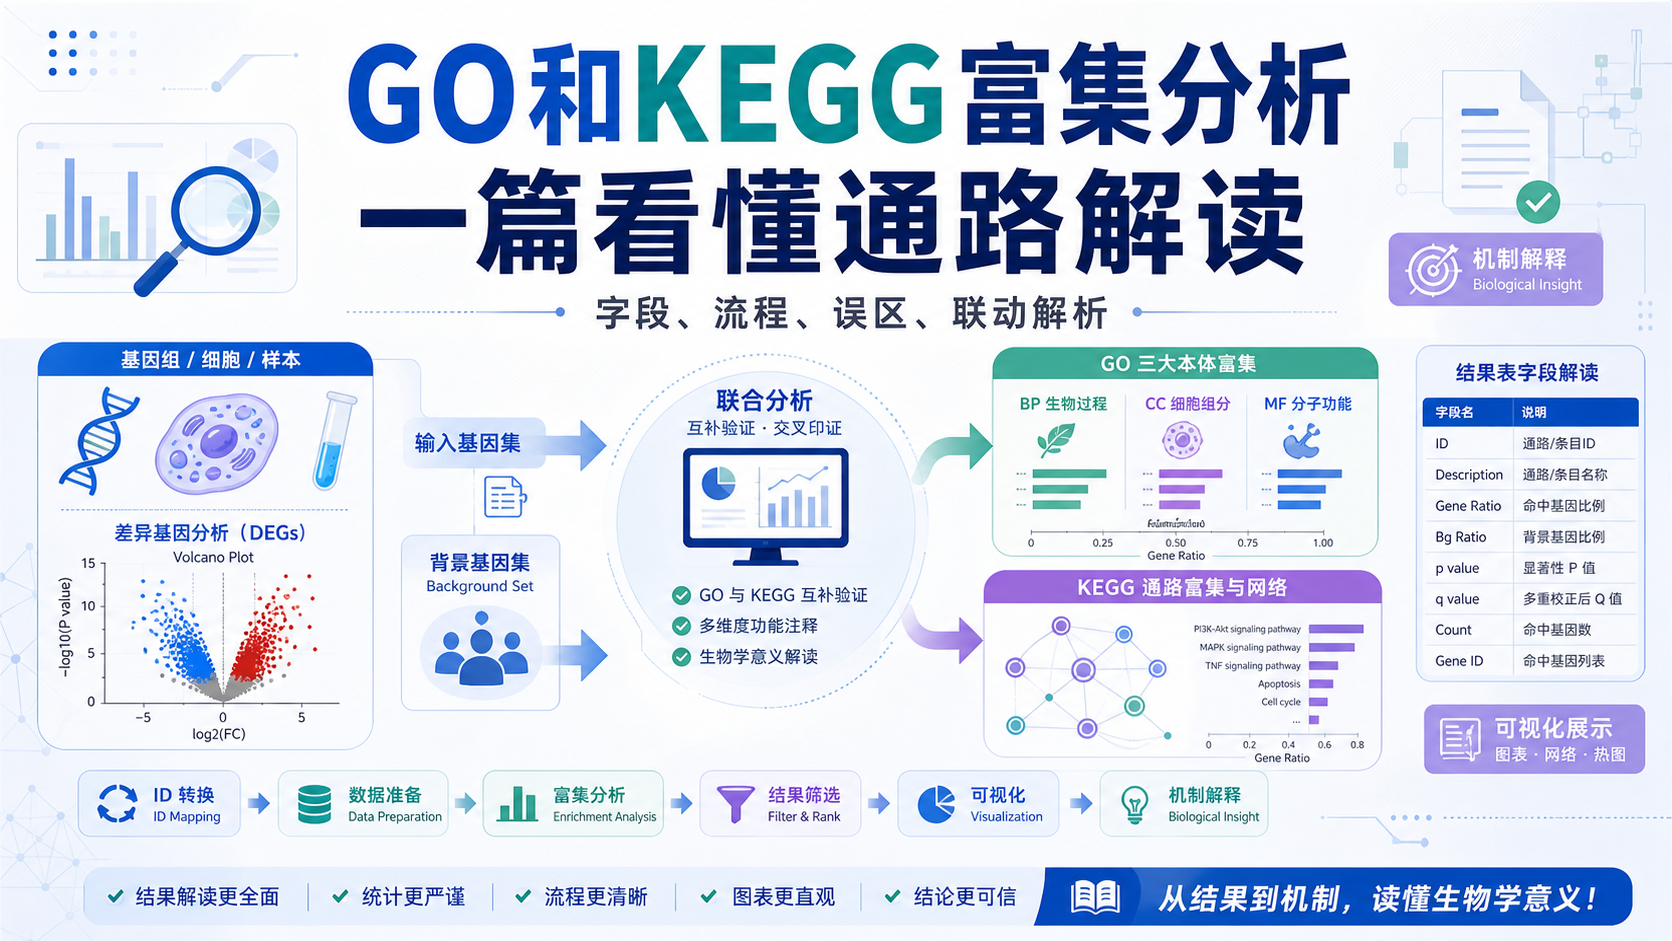
GO和KEGG都属于通路富集分析常用框架,但它们回答的问题不完全一样。GO更偏向功能注释,KEGG更偏向代谢和信号通路。两者放在一起看,相当于对同一批差异基因做两套独立验证。
这就是“平行验证”的价值。一个分析可能提示基因参与细胞周期,另一个分析又把它落到DNA复制或p53通路上。当两个系统指向同一生物学主题时,结论的可信度会明显提高。
对医学生、医生和科研人员来说,这一点尤其重要。临床样本异质性强,单一数据库的结果容易被背景噪音放大。GO加KEGG,不是重复劳动,而是降低解释偏差。
1.2 只做一个分析,常见风险有哪些
常见错误有三类。
- 只看显著性,不看生物学背景。
- 不核对物种,导致人和鼠注释混用。
- 把“富集到通路”直接等同于“通路被激活”。
尤其是物种问题。KEGG路径ID前缀会提示物种,例如人是HSA,小鼠是MMU,大鼠是RNO。如果是鼠的数据,却用成人类通路去解读,结论会失真。
此外,通路富集分析只说明“这批基因在某条通路中出现得更多”,并不自动证明方向性。要判断激活或抑制,还要结合表达量、log2FoldChange和后续实验验证。
2. 读懂KEGG结果表,先从字段开始
2.1 ID和description,决定你有没有看对通路
KEGG表里最先要看的是ID和description。ID是通路编号,description是通路名称。
ID前缀常见为HSA、MMU、RNO,分别对应人、小鼠、大鼠等物种。
description则直接告诉你通路内容。例如细胞骨架、糖酵解、DNA修复、PI3K-Akt信号通路等。读KEGG结果时,不能只扫一眼名称,要先确认物种,再确认通路是否和研究问题匹配。
很多初学者会直接盯着富集条目数量。其实更关键的是“这个条目属于哪类生物过程”。如果研究的是肿瘤转移,细胞黏附、ECM重塑、血管生成更值得优先关注;如果是代谢疾病,脂代谢和线粒体通路更重要。
2.2 Gene Ratio、BG Ratio和Count,怎么看才不误解
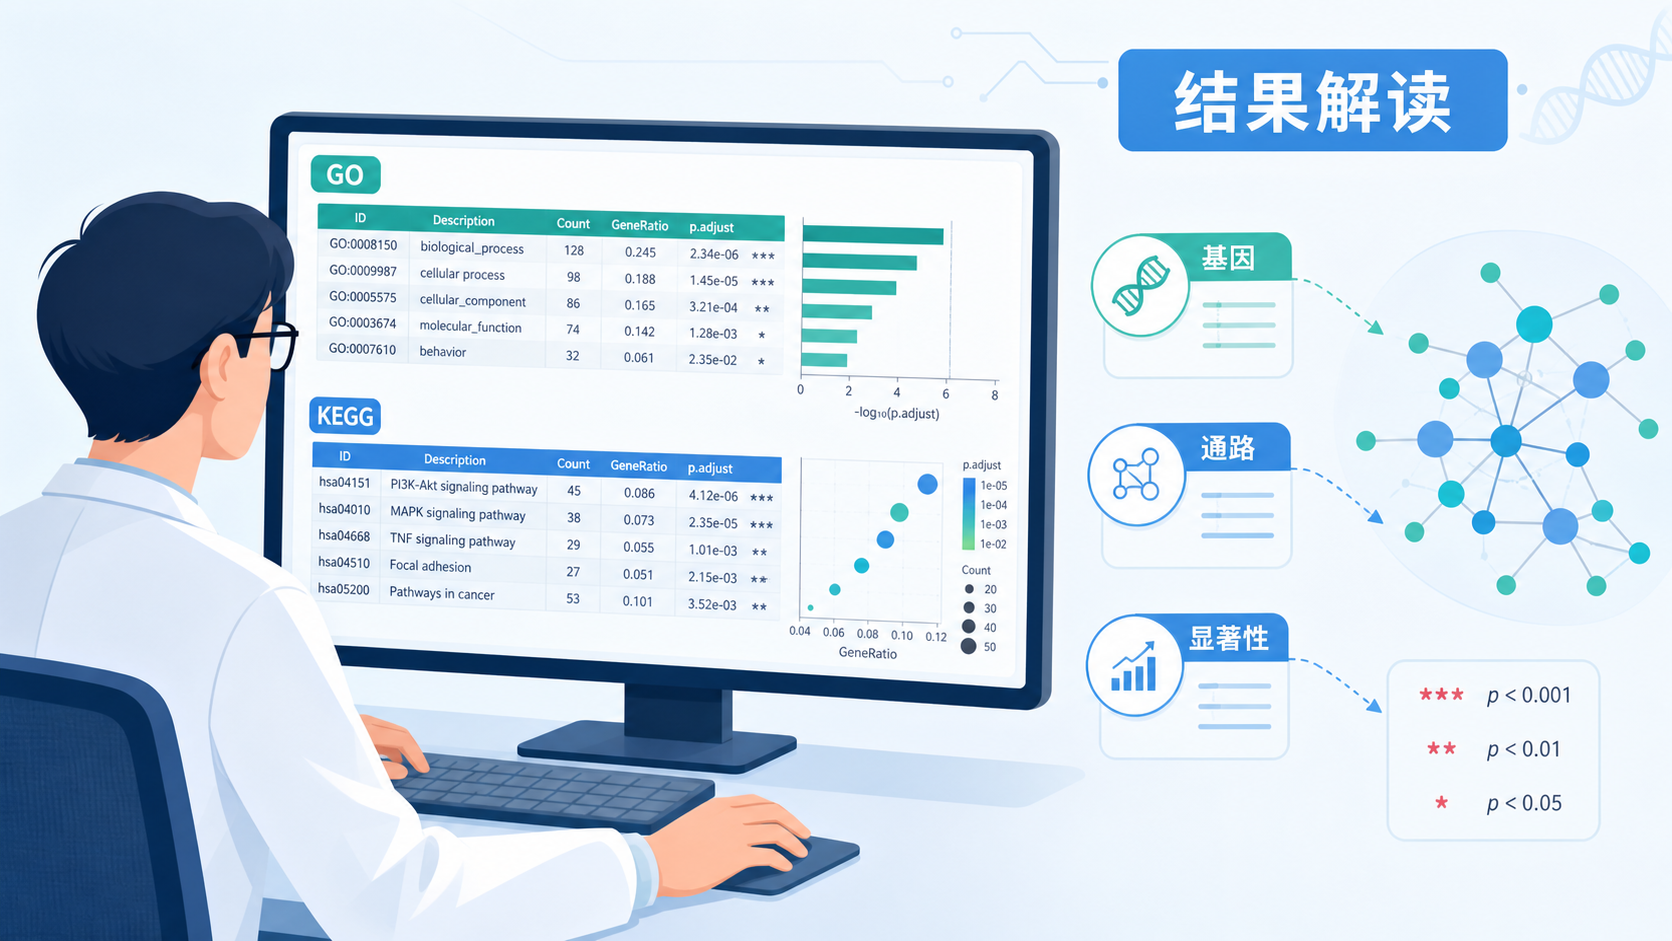
KEGG结果里常见Gene Ratio、BG Ratio、Count。它们分别回答不同层面的问题。
- Gene Ratio :你的差异基因中,有多少比例落到这条通路。
- BG Ratio :背景基因集中,这条通路占多少比例。
- Count :命中该通路的基因数。
举个例子。假设1270个差异基因里,有79个落在某条通路中,这说明该通路在你的差异基因集中出现得相对集中。若背景基因中该通路只有232个基因,则这种集中更值得关注。真正有意义的不是“Count大”,而是“相对于背景是否过度富集”。
这也是为什么要同时看Gene Ratio和p值。Count高不一定显著,Count低也可能显著。统计显著性永远要和比例一起看。
2.3 p值、adjust p和q value,优先级怎么排
在KEGG富集分析中,p值、adjust p和q value都用于控制假阳性。优先看adjust p,再看p值。
如果多重检验校正后仍显著,结果更稳健。q value在很多场景下与adjust p含义接近,可作为补充参考。
对科研写作来说,建议直接报告校正后的显著性水平。常见阈值包括adjust p < 0.05,或q value < 0.25,具体要结合分析流程和研究领域。不要只报原始p值。原始p值更容易高估结果。
3. GO富集分析的三大类,如何和KEGG联动
3.1 BP、CC、MF分别代表什么
GO富集分析通常分为三类。
- BP,Biological Process ,生物过程。
- CC,Cellular Component ,细胞组分。
- MF,Molecular Function ,分子功能。
这三类帮助你从不同层面理解差异基因。BP告诉你基因参与什么过程,CC告诉你位于哪里,MF告诉你做什么事。GO的价值在于把“基因列表”翻译成“功能图谱”。
如果一个课题只做KEGG,很容易漏掉细胞结构和分子功能层面的信息。反过来,只做GO也可能无法把关键过程映射到明确通路。所以GO和KEGG放在一起,信息更完整。
3.2 为什么说GO和KEGG像两次平行实验
GO和KEGG来自不同注释体系,术语结构也不同。GO偏层级化,KEGG偏路径化。这意味着同一批差异基因,可能在GO里落入“炎症反应”,在KEGG里落入“TNF信号通路”。
这种不完全一致并不是缺点,反而是优势。因为它能帮助你从不同数据库交叉确认同一现象。对结果解读来说,“两个系统都支持”比“单一数据库里很显著”更有说服力。
在论文中,这种写法也更符合E-E-A-T逻辑。你不是在堆结果,而是在用多来源证据支撑判断。
4. 从差异基因到富集结果,标准流程怎么做
4.1 先完成ID转换,再进入富集分析
通路富集分析里,ID转换是高频痛点。没有统一到正确的基因ID,后面的富集结果就不可靠。
常见流程是先把Ensembl ID转成Gene Symbol,再转成Entrez ID,因为很多工具包更稳定地识别Entrez ID。
如果ID映射过程中出现重复项或丢失项,要先清理再分析。不要把混乱ID直接送入富集函数。输入不干净,输出一定不干净。
对人类样本,常用org.Hs.eg.db;如果是小鼠或大鼠,要换成对应物种注释库。物种库必须和样本一致。
4.2 GO和KEGG可以一起跑,结果更完整
常见做法是用同一批Entrez ID同时跑GO和KEGG。这样能得到一组并行结果,再按BP、CC、MF和KEGG分类整理。这比单独跑一个数据库更适合后续筛选重点通路。
分析时建议统一阈值,例如pAdjustMethod设为BH,pvalueCutoff设为0.05,qvalueCutoff设为0.25。然后再按Description、GeneRatio、Count和p.adjust排序。排序逻辑要一致,避免人为偏差。
如果你要写文章,可以先提炼每类前5条结果,再结合研究主题挑重点展开。这样结构会更清晰,读者也更容易抓住核心信息。
4.3 可视化时,优先展示能解释机制的图
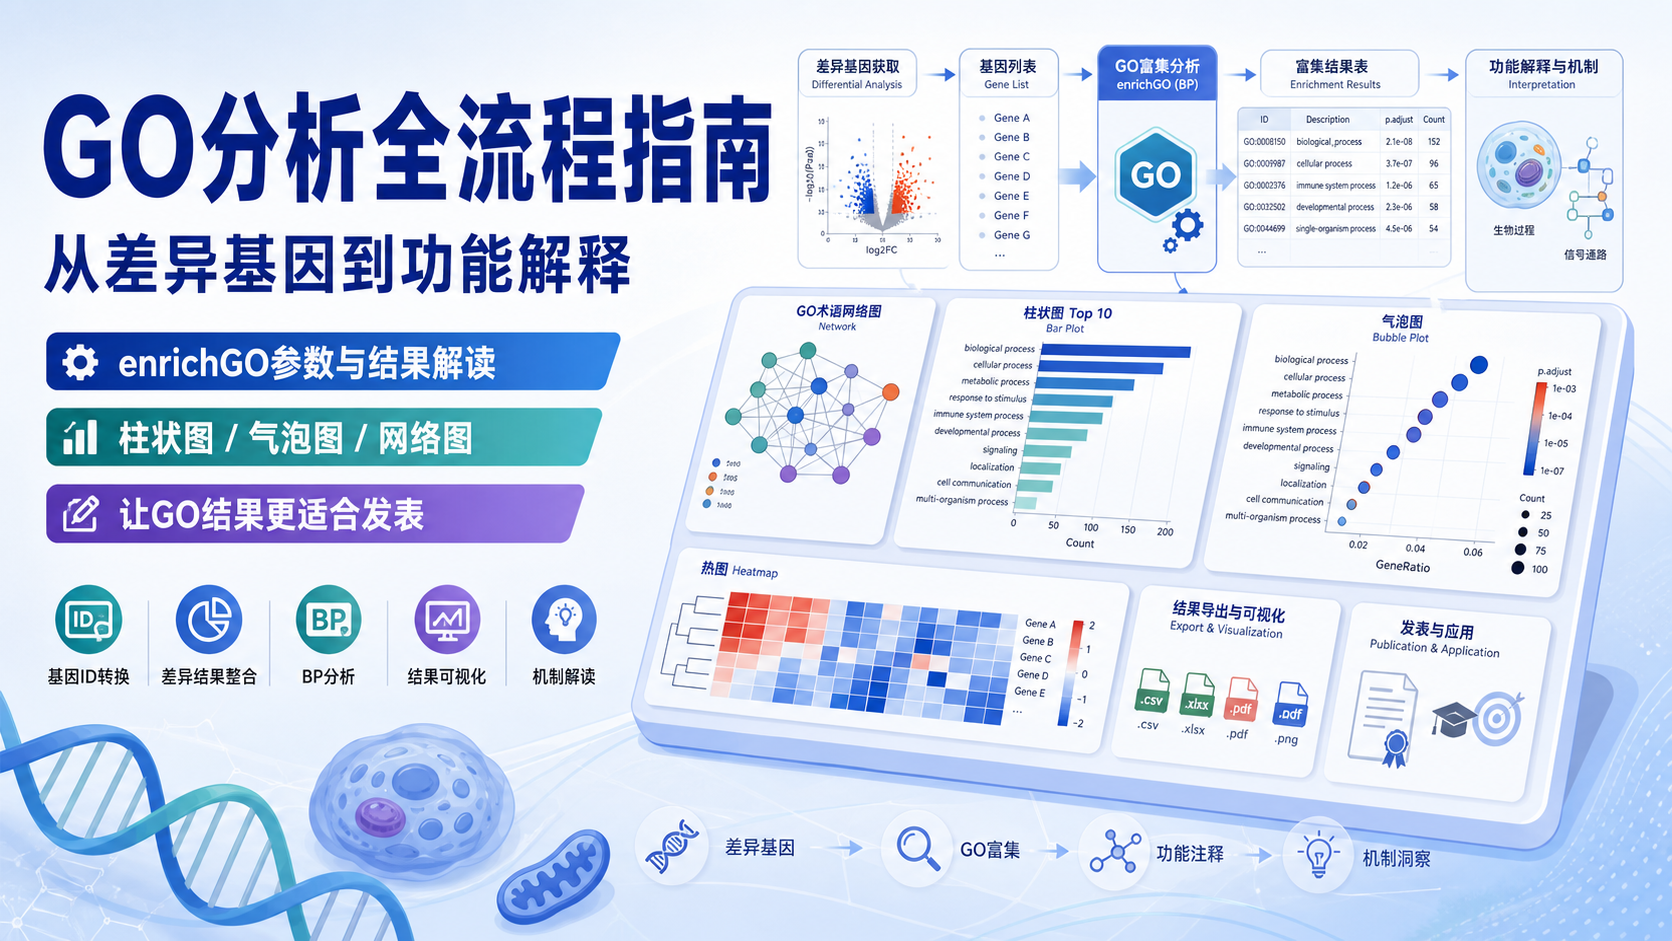
通路富集分析常用图包括柱状图、气泡图、网络图和通路图。
- 柱状图适合展示Gene Ratio和显著性。
- 气泡图适合同时看Count和p.adjust。
- 网络图适合看“基因-通路”连接关系。
- Pathview适合落到具体KEGG通路上看基因变化。
可视化的目的不是“图多”,而是“讲清机制”。
比如一个肿瘤课题,如果富集到细胞周期、DNA复制和p53通路,就可以进一步在Pathview里标出关键基因的表达方向,形成完整证据链。
5. 结果解读时,最容易踩的三个坑
5.1 把富集当成因果
富集分析是关联,不是因果。它告诉你“哪些通路被过度代表”,不是“哪个通路导致了表型”。
所以写结论时要克制,避免“证明了”“导致了”这类绝对化表达。
更稳妥的写法是:差异基因提示某通路可能参与疾病进程,后续需要实验验证。这样更符合科研规范。
5.2 忽略背景基因集
背景集选错,会直接影响富集结果。背景通常应与实验平台、物种和过滤后的可检测基因一致。背景不是越大越好,而是越匹配越好。
如果背景设置不合理,某些通路会被夸大,或者被错误过滤掉。尤其在RNA-seq和芯片数据混用时,这个问题更常见。
5.3 只盯显著性,忽略生物学一致性
有些通路p.adjust很漂亮,但和研究主题关系不大。真正值得写进正文的结果,应该同时满足统计显著、方向合理、机制可解释。
例如免疫炎症课题中,看到趋化因子、细胞因子相互作用、NF-kB信号通路,比看到与主题无关的稀有代谢通路更有解释价值。富集结果要服务于假设,不是替代假设。
6. 从分析到落地,解螺旋如何帮助你少走弯路
6.1 把复杂流程拆成可执行步骤
如果你在通路富集分析中经常卡在ID转换、物种匹配、结果筛选和作图环节,说明流程还需要标准化。一套稳定的分析模板,能显著减少返工。
解螺旋提供从ID整理、GO/KEGG分析到结果可视化的系统化支持,适合医学生、医生和科研人员直接套用到课题中。你可以把时间更多放在生物学解释,而不是反复调参数和修正格式。
6.2 让结果更容易写进论文和汇报
一个好的通路富集分析,不只是跑出表格。它还应该能快速形成图、表和机制叙述。这正是解螺旋这类工具和课程的价值所在。
当你把GO和KEGG作为平行验证策略来使用,结果会更完整,论文表达也会更稳。
总结Conclusion
通路富集分析的核心,不是“找到最多的通路”,而是“找到最可信的机制线索”。 GO和KEGG分别从功能和路径两个维度补充证据,结合ID转换、物种匹配、背景集设置和多重校正,才能得到更可靠的结论。
如果你想把通路富集分析做得更规范、更高效,可以进一步结合解螺旋的实操资源,把分析流程标准化,减少误判,提高科研输出质量。
- 引言Introduction
- 1. 为什么通路富集分析不能只看一个数据库
- 2. 读懂KEGG结果表,先从字段开始
- 3. GO富集分析的三大类,如何和KEGG联动
- 4. 从差异基因到富集结果,标准流程怎么做
- 5. 结果解读时,最容易踩的三个坑
- 6. 从分析到落地,解螺旋如何帮助你少走弯路
- 总结Conclusion