56
 分享

引言Introduction
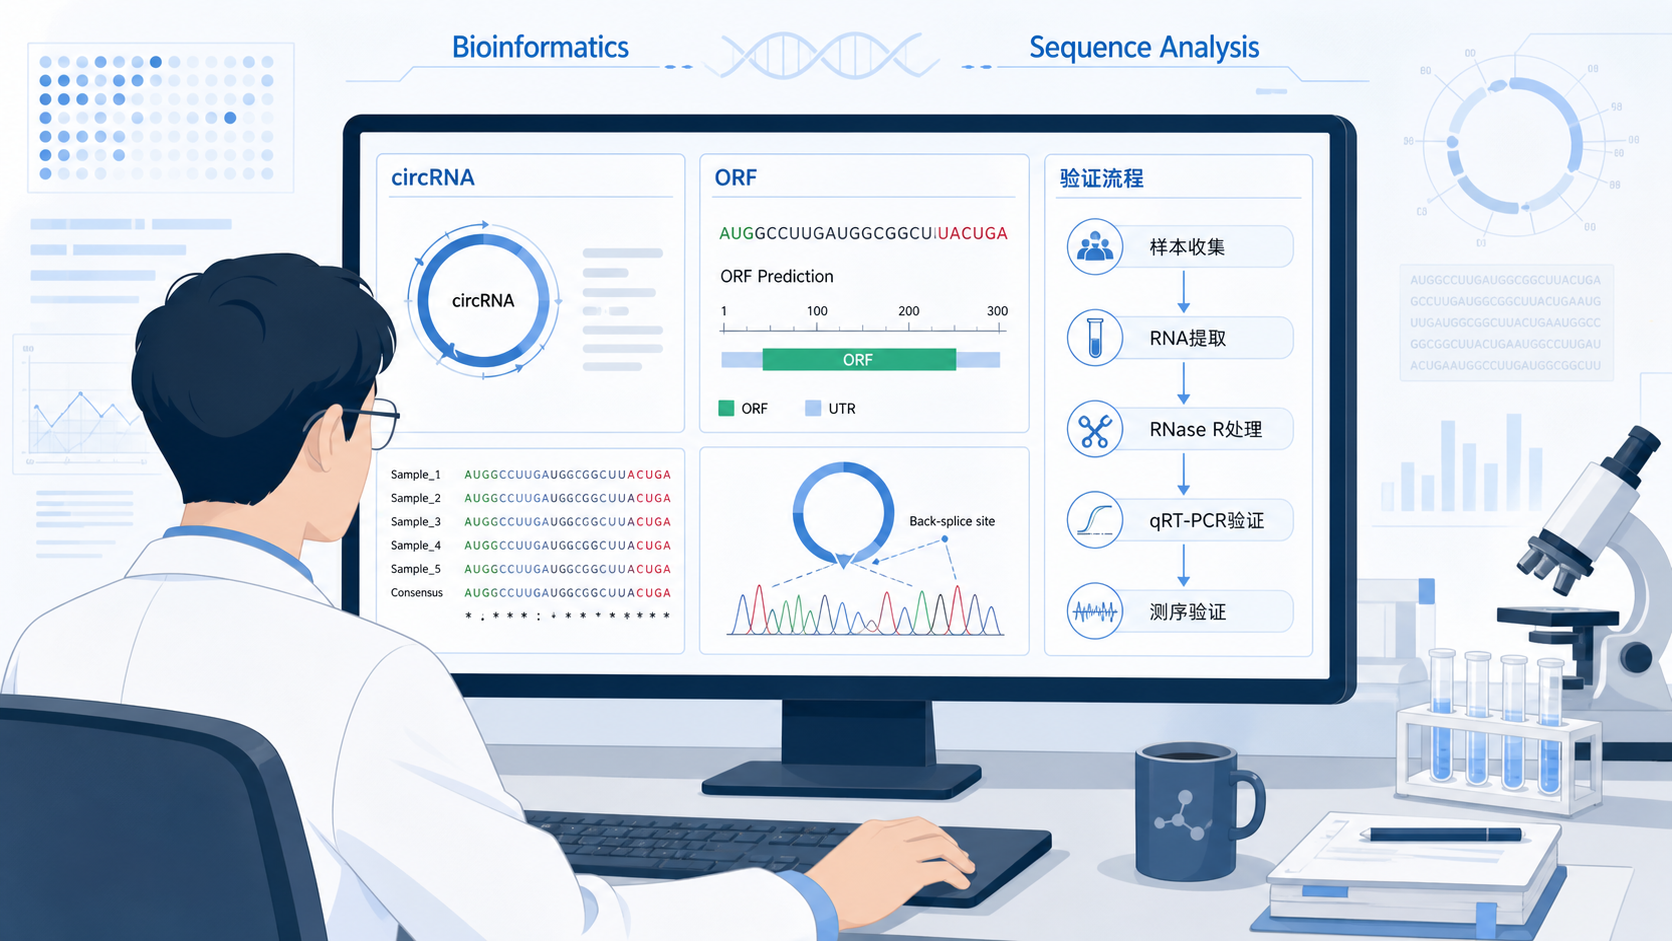
circRNA不再只是“非编码RNA”。越来越多研究提示,它可能通过ORF编码短肽,参与肿瘤、代谢和信号调控。但从预测到验证,很多人卡在第一步:ORF怎么找,怎么判断是否真的能翻译,怎么把证据链做完整。
1. 先理解circRNA为什么值得做ORF预测
circRNA是环状RNA,结构上没有5’帽和3’poly(A)尾,但并不意味着它一定不能编码。2012年后,高通量测序推动circRNA研究快速增长。随后,研究者陆续发现,部分circRNA可以借助内部核糖体进入位点,或其他非经典翻译机制,产生短肽。
这类研究的核心,不是“circRNA能不能编码”,而是“哪些circRNA具备编码潜力,编码产物是否有功能”。
对医学生和科研人员来说,这一步很关键。因为它决定了后续研究路线,是继续做经典的ceRNA机制,还是转向“RNA兼具编码功能”的新范式。
1.1 circRNA编码短肽的常见逻辑
从机制上看,circRNA编码短肽通常要同时满足几类条件。
- 存在可识别的开放阅读框,且长度足以形成候选肽段。
- 具备翻译起始相关元件,例如IRES样序列或m6A相关翻译启动线索。
- 预测的肽段在生物学上有解释空间,例如与代谢、增殖、迁移或免疫调控相关。
没有ORF,不等于没有功能。有ORF,也不等于一定能翻译。
所以,ORF预测只是起点,不是结论。
1.2 为什么短肽研究更适合做“证据链”
编码短肽的研究比普通非编码RNA研究更难。原因很直接。
- 候选产物更小,检测难度更高。
- 抗体制备和特异性验证要求更严。
- 需要同时证明“有翻译”和“有功能”。
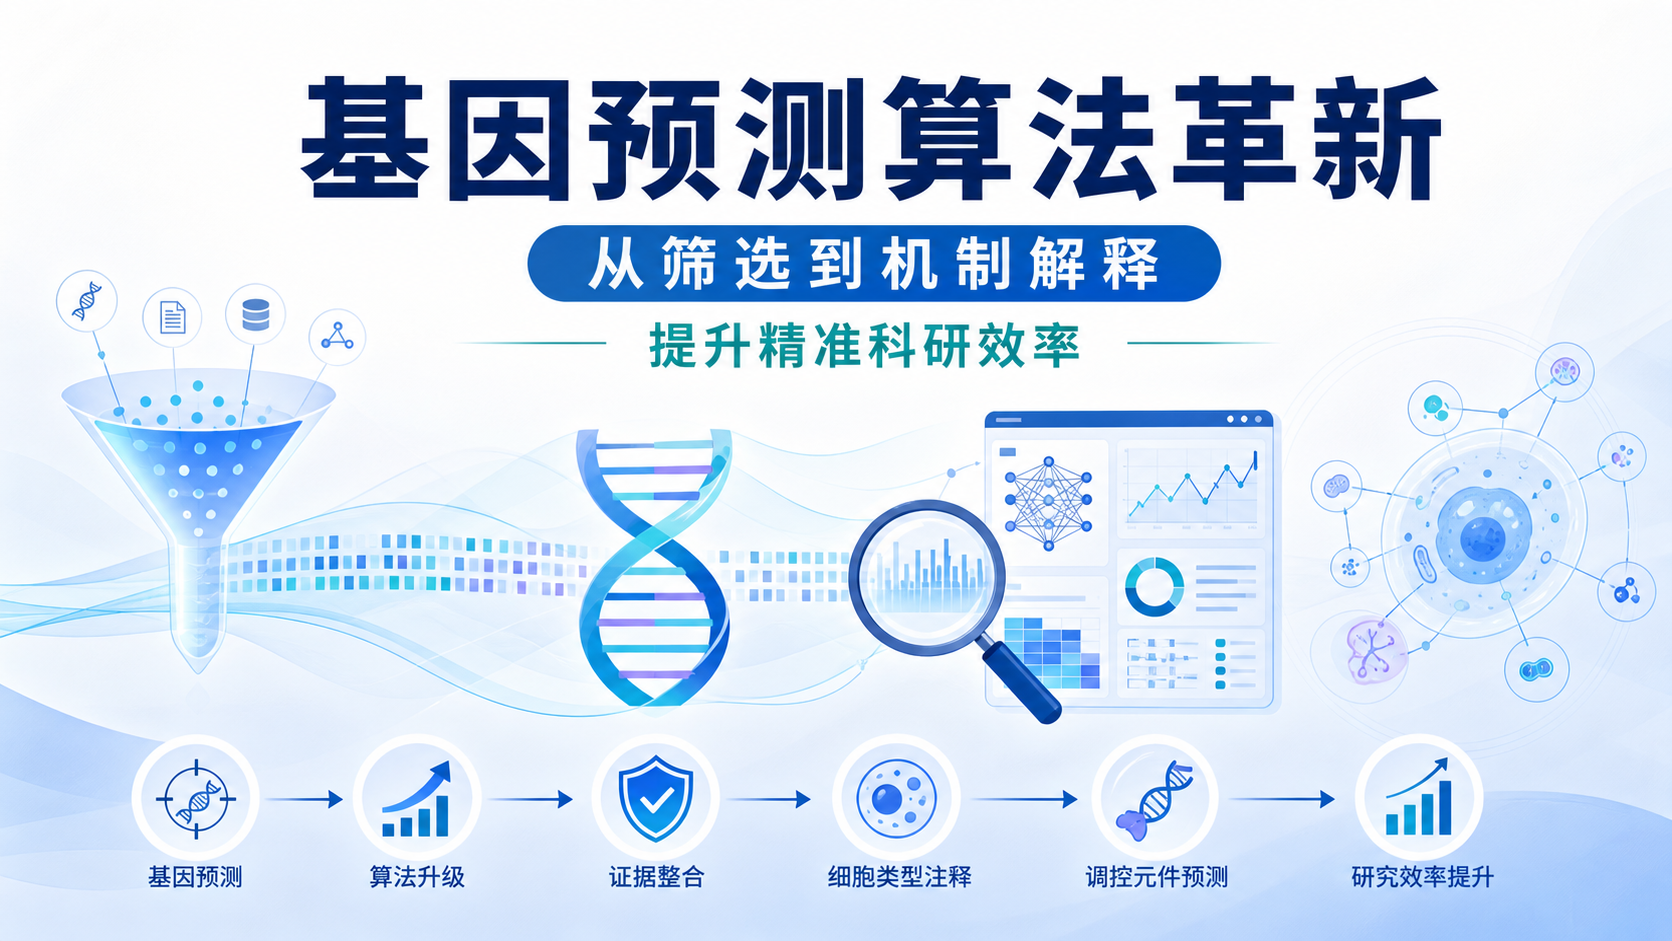
因此,真正可靠的研究流程必须是:生信预测,翻译验证,表达验证,功能验证,位点或机制验证。
只做一步,文章说服力不够。
只靠预测,更不能下结论。
2. ORF预测应该怎么做才算规范
ORF预测不是简单点一下软件。它要求研究者先明确输入序列来源,再判断预测结果是否可用于实验设计。对于circRNA来说,最容易出问题的地方,是把线性RNA的思路直接套到环状分子上。
2.1 第一步,确认circRNA序列来源
先拿到目标circRNA的完整环化序列,而不是只看宿主基因外显子信息。因为circRNA是头尾相连的结构,真正用于ORF预测的应该是环化后序列。
这一步常见错误有两个。
- 只取宿主基因片段,不考虑back-splice连接位点。
- 忽略不同数据库注释差异,导致序列版本不一致。
如果序列错了,后面的ORF、引物、抗体设计都会偏。
2.2 第二步,识别候选ORF并筛选可翻译片段
ORF预测的重点不是“找到最长片段”,而是筛出“最有可能被翻译的片段”。通常需要综合看以下指标。
- 起始密码子位置。
- 终止密码子位置。
- 是否跨越反向剪接连接位点。
- 是否存在连续、完整的编码框。
- 预测肽段长度是否具备检测可行性。
对circRNA编码短肽研究来说,跨越连接位点的ORF往往更有特色,也更适合作为验证对象。
因为它能更好地区分circRNA来源,而不是线性转录本污染。
2.3 第三步,结合保守性和功能线索筛选
很多研究者会问,候选ORF那么多,先做哪一个。答案是,优先做同时满足“预测强”和“生物学合理”的对象。
可以重点参考:
- 该circRNA在肿瘤或疾病样本中是否稳定上调或下调。
- 候选ORF是否在人类或其他物种中保守。
- 编码短肽是否与已知通路相关。
- 是否能在既往文献中找到类似机制。
一个好的候选ORF,应该同时满足“有预测依据”和“有研究价值”。
这会显著提高后续实验成功率。
3. 从预测到验证,证据链应该怎么搭
ORF预测本身只能说明“可能编码”。真正决定文章质量的是验证链是否完整。尤其是短肽研究,很多稿件被拒,不是因为假设差,而是因为证据不够硬。
3.1 先证明它真的被翻译
常规思路包括以下几类。
- 双荧光素酶报告,验证翻译相关元件活性。
- 质谱,确认肽段存在。
- 特异性抗体或标签系统,检测短肽表达。
- 过表达和敲低后,观察短肽水平是否随之变化。
双荧光素酶常用于验证翻译活性,但不能单独证明内源性短肽真实存在。
如果条件允许,质谱和抗体验证更能提升可信度。
3.2 再证明它确实来自circRNA
这是最容易被忽视的一步。因为很多时候,检测到的“蛋白信号”未必来自circRNA本身,可能来自线性同源转录本。
建议至少完成以下控制。
- 设计跨越back-splice junction的特异性引物。
- 使用RNase R处理,验证环状特征。
- 通过siRNA或shRNA特异性干预circRNA,观察短肽是否同步下降。
- 排除宿主基因线性转录本干扰。
只有证明翻译产物和circRNA来源一一对应,编码结论才站得住。
3.3 最后证明它有生物学功能
编码短肽不是为了“多一个发现”,而是为了回答“它在病理过程中做什么”。
功能验证通常要围绕表型展开。
- 增殖。
- 凋亡。
- 迁移和侵袭。
- 代谢重编程。
- 免疫微环境调控。
如果研究对象是肿瘤,最好把短肽功能和通路变化放在同一条逻辑线上。
例如,短肽影响某个代谢酶、转录因子或修饰酶,再进一步改变细胞表型。这样故事更完整,证据也更强。
4. 编码短肽研究的新范式:从“找ORF”到“建机制”
过去的circRNA研究,很多停留在miRNA海绵模型。现在更前沿的方向,是把circRNA当作“多功能分子”来看待。它既可能参与RNA-RNA互作,也可能通过ORF产生短肽。
4.1 研究设计要兼顾两条主线
一个成熟的课题,通常至少要回答两个问题。
- 这个circRNA是否编码短肽。
- 这个短肽是否承担独立功能。
如果只证明circRNA有翻译潜力,但没有功能证据,研究会停在半路。
如果只看到表型,却不能解释是RNA本体还是短肽起作用,结论也不完整。
新范式的关键,是把“RNA功能”和“编码功能”拆开分析。
这比单纯做一个ceRNA故事更有学术增量。
4.2 设计实验时要注意的几个细节
为了避免证据混淆,建议在实验设计中区分以下变量。
- 破坏ORF起始位点,看短肽是否消失。
- 保持circRNA环化不变,只改变编码能力。
- 单独表达短肽,观察是否能复现表型。
- 反向操作,确认表型是否依赖短肽而非RNA骨架。
这类“拆分式验证”非常重要。
它能帮助研究者明确,表型到底来自circRNA本体,还是来自其编码产物。
4.3 研究写作中如何提高说服力
写文章时,建议把逻辑顺序写清楚。
- 数据库或文献提示目标circRNA值得关注。
- ORF预测显示其具备编码潜力。
- 实验证明该circRNA可被翻译。
- 短肽具有明确生物学功能。
- 机制链条闭环,形成可重复的证据。
这种写法比单纯描述“发现了一个新短肽”更容易被期刊接受。
因为它回答的是机制问题,不只是现象问题。
5. 适合医学生、医生和科研人员的实操建议
如果你正准备做一个circRNA编码短肽课题,可以按这个顺序推进。
5.1 选题阶段
优先挑选这三类circRNA。
- 疾病相关性强。
- 表达量适中且稳定。
- 生信预测提示存在明确ORF。
5.2 验证阶段
至少完成这四步。
- 环状特征验证。
- ORF翻译潜力验证。
- 短肽表达验证。
- 功能和机制验证。
5.3 写作阶段
重点突出三个关键词。
- 预测依据清楚。
- 验证链条完整。
- 功能结论可重复。
这样文章更符合E-E-A-T要求,也更容易通过审稿人的机制审查。
最后,如果你希望把ORF预测、文献检索、实验设计和结果组织成一条清晰的研究路径,可以借助解螺旋的系统化内容与工具支持,把零散信息快速整合为可执行方案,减少试错成本,提高课题推进效率。
总结Conclusion
circRNA编码短肽已经不再是边缘话题。ORF预测是切入点,但真正决定研究质量的,是从预测到翻译,再到功能验证的完整证据链。
对于医学生、医生和科研人员来说,最有价值的不是找到一个“看起来能编码”的circRNA,而是把它做成一个能被验证、能被解释、能写成高质量论文的机制课题。
如果你正在规划相关研究,建议直接从ORF预测入手,结合实验验证和机制拆分,系统推进。需要更高效的研究支持时,也可以关注解螺旋,帮助你把思路快速落到可执行方案上。
- 引言Introduction
- 1. 先理解circRNA为什么值得做ORF预测
- 2. ORF预测应该怎么做才算规范
- 3. 从预测到验证,证据链应该怎么搭
- 4. 编码短肽研究的新范式:从“找ORF”到“建机制”
- 5. 适合医学生、医生和科研人员的实操建议
- 总结Conclusion