52
 分享
引言Introduction
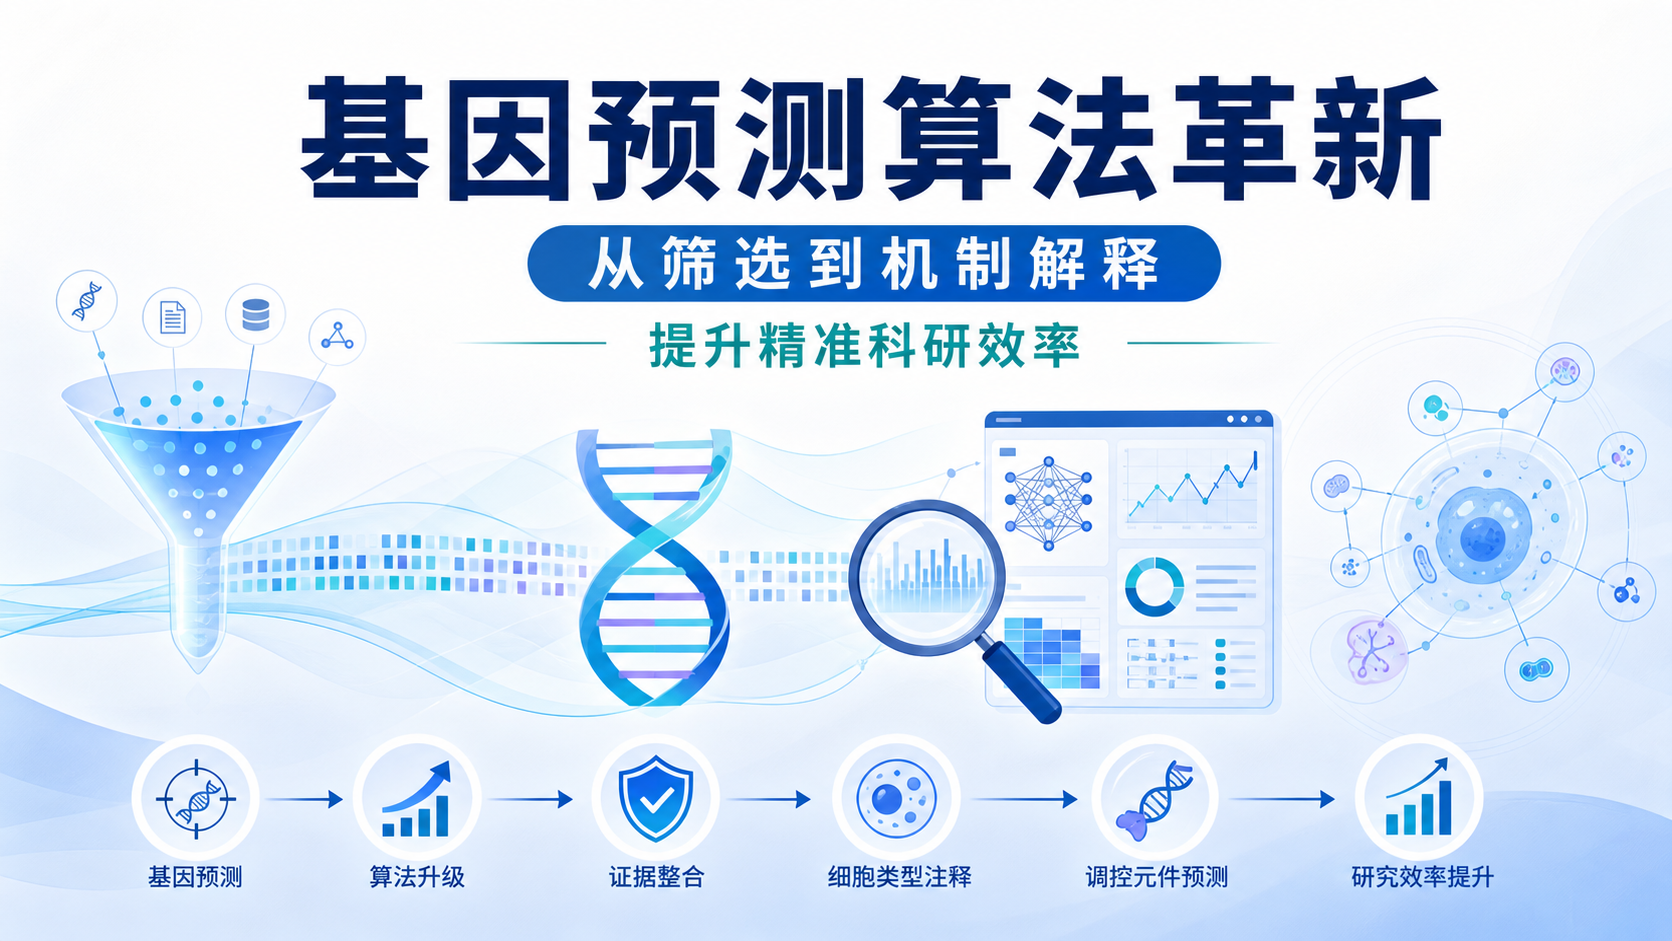
基因组数据越来越多,但真正的难点不是“有数据”,而是如何把海量表达变化转化为可验证的生物学结论 。传统单基因分析容易漏掉通路层面的信号,也难解释复杂调控。基因预测算法的进步,正在改变这一局面。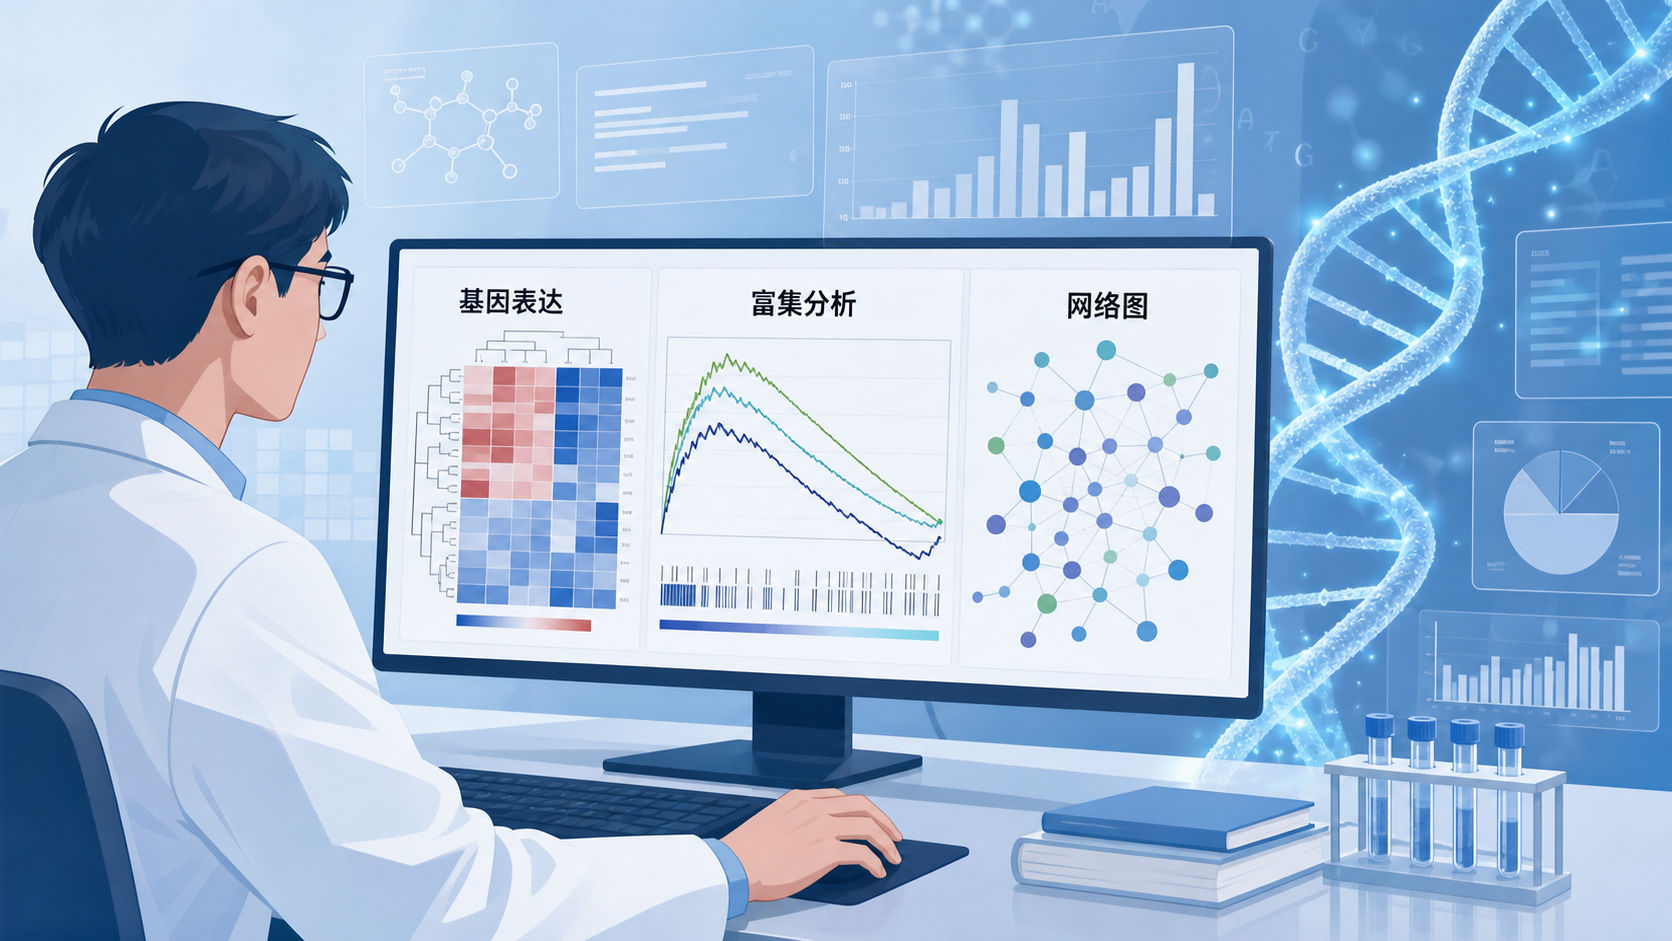
1. 基因预测为何成为基因组学研究的核心环节
1.1 从“找差异基因”走向“解释生物机制”
在转录组、芯片和单细胞数据中,研究者常面对成千上万个基因的排序列表。如果只看显著性最高的少数基因,往往会忽略真正驱动表型变化的调控网络。
这也是基因预测越来越重要的原因。它不再只关注单个基因是否显著,而是尝试回答:
- 哪些基因集在同一生物状态下共同变化。
- 哪些转录因子或microRNA可能是上游调控者。
- 哪些通路、细胞类型或表型模块更能解释实验结果。
1.2 传统分析的局限
经典差异分析能筛出候选基因,但存在几个明显短板。
- 多重检验后,很多真实但弱效应的基因会被噪音掩盖。
- 显著基因之间常常缺乏共同功能。
- 单基因结果难以直接对应机制。
- 不同队列之间的交集基因可能很少,重复性有限。
因此,基因预测的价值不只是“预测一个候选”,而是帮助研究者从统计结果走向机制假设。
2. 基因预测算法的主要升级方向
2.1 从阈值筛选转向基因集层面的判断
GSEA是这一思路的代表。它不要求先设定严格阈值,而是直接对排序后的基因列表进行分析,判断某个预定义基因集是否在顶部或底部一致富集。
其核心优势很明确:
- 不依赖“先筛显著基因再做分析”的流程。
- 能保留弱但一致的生物学信号。
- 更适合解释通路、调控元件和表型差异。
对科研人员来说,这意味着分析结果更接近真实生物过程,而不是被单个P值主导。
2.2 从通路富集扩展到调控元件预测
MSigDB中的M3集合就体现了这一趋势。它主要包含两类基因集:
- microRNA靶点。
- 转录因子靶点。
其中,miRDB microRNA targets基于MirTarget算法预测小鼠miRNA靶标,采用miRDB v6.0数据,且只保留MirTarget评分大于80的高置信度结果。
GTRD transcription factor targets则基于启动子区域预测转录因子结合位点,覆盖TSS周围-1000到+100 bp范围。
这类设计说明,现代基因预测已经从“结果解释”进一步走向“上游机制推断”。
2.3 从单一基因扩展到细胞类型与表型注释
MSigDB的M5和M8集合也很有代表性。
- M5包含GO、本体注释和肿瘤表型相关基因集。
- M8包含单细胞测序中识别到的细胞类型簇标记基因。
这类集合让研究者可以把转录变化映射到:
- 分子功能。
- 生物过程。
- 细胞组成。
- 组织或肿瘤表型。
基因预测因此不再局限于“某个基因是否上调”,而是能够回答“变化属于哪类生物系统”。
3. 预测精度提升的关键:算法、数据库和证据整合
3.1 只靠序列匹配远远不够
转录因子结合位点和miRNA靶点预测,理论上都基于既有数据库和序列特征,但这类方法天然存在假阳性。
原因很明确:
- 预测依据是结合偏好,不等于真实细胞内结合。
- 允许错配会提高覆盖率,也会引入噪音。
- 转录因子常与辅助因子形成复合物,数据库不一定完整反映。
- 染色质状态、组蛋白修饰和空间构象都会影响实际结合。
所以,基因预测的“准”,不是单靠模型更复杂,而是靠证据整合更充分。
3.2 结合表达相关性,是提高可信度的实用策略
在实际研究中,最值得优先采用的优化方式之一,是把预测结果与表达数据联合分析。
可操作的思路包括:
- 先做差异表达分析,得到排序列表。
- 再做GSEA或基因集富集分析,找出显著模块。
- 结合TF靶点或miRNA靶点基因集,寻找上游调控者。
- 用相关性分析验证“调控因子-靶基因”是否同向或反向变化。
- 最后用实验验证,如qPCR、WB或ChIP相关实验。
这类流程能显著降低“只是在数据库里匹配到了”的假阳性风险。
3.3 证据链越完整,研究结论越稳
高质量的基因预测,通常不是单一工具的输出,而是多层证据叠加的结果。
常见证据链包括:
- 差异表达。
- 富集分析。
- 启动子或motif预测。
- 表达相关性。
- 保守性分析。
- 蛋白互作网络。
- 文献回溯。
- 实验验证。
对于医学生、医生和科研人员来说,真正有价值的不是“预测到了什么”,而是“能否形成可重复、可验证的机制链条”。
4. 研究中如何正确使用基因预测结果
4.1 先明确问题,再选择工具
不同问题对应不同层级的预测。
- 想看整体机制,优先用GSEA和本体富集。
- 想找上游调控,优先看TF和miRNA靶点集合。
- 想定位细胞来源,可用单细胞签名基因集。
- 想找表型关联,可用GO或MPT类本体集合。
工具不是越多越好,而是越贴近研究问题越好。
4.2 不要把预测结果直接当结论
这一点在发表和基金申请中都很关键。预测结果只能说明“可能存在某种调控关系”,不能替代实验。
建议至少完成以下步骤:
- 在独立数据集复核。
- 检查方向是否一致。
- 分析统计稳健性。
- 结合已知文献判断生物学合理性。
- 用实验做最终验证。
这也是为什么很多高质量研究都强调“预测+验证”双轨并行。单纯的算法结果,不能直接等同于真实生物机制。
5. 基因预测算法革新带来的研究效率提升
5.1 从“大海捞针”变成“分层筛选”
过去做组学分析,常常是先拿到一长串差异基因,再人工逐个筛选。现在,基因预测算法可以先把候选范围缩小到更有生物学意义的模块。
效率提升体现在三个方面:
- 更快锁定机制方向。
- 更少无效实验。
- 更容易形成论文主线。
5.2 从“结果堆积”变成“问题导向”
算法升级后,研究设计也更清晰。不是先收集很多图再拼文章,而是先定义问题,再用不同层级的预测去回答它。
比如一个肿瘤项目可以这样推进:
- 找到差异表达基因。
- 用GSEA确认异常通路。
- 用TF或miRNA靶点集合定位上游调控。
- 用网络分析筛选核心节点。
- 用实验验证关键分子。
这样的路径更符合E-E-A-T要求,也更符合真实科研逻辑。
6. 结论与实践建议
基因预测算法的革新,本质上是在提升两件事:解释能力和验证效率 。从GSEA到TF、miRNA靶点集合,再到GO、表型和单细胞签名,现代分析框架已经不再局限于“找显著基因”,而是进一步帮助研究者建立机制假设。
对基因组学研究者而言,最重要的是把预测结果放回证据链中看待。能被独立数据支持、能与表达变化一致、最终还能被实验验证的预测,才是真正有价值的结果。
如果你希望更高效地完成基因集分析、调控因子筛选和结果整合,可以借助解螺旋 的专业工具与方法支持,把复杂流程压缩为更清晰的研究路径,尽快把预测结果转化为可发表、可验证的科研结论。
- 引言Introduction
- 1. 基因预测为何成为基因组学研究的核心环节
- 2. 基因预测算法的主要升级方向
- 3. 预测精度提升的关键:算法、数据库和证据整合
- 4. 研究中如何正确使用基因预测结果
- 5. 基因预测算法革新带来的研究效率提升
- 6. 结论与实践建议