9
 分享
引言Introduction
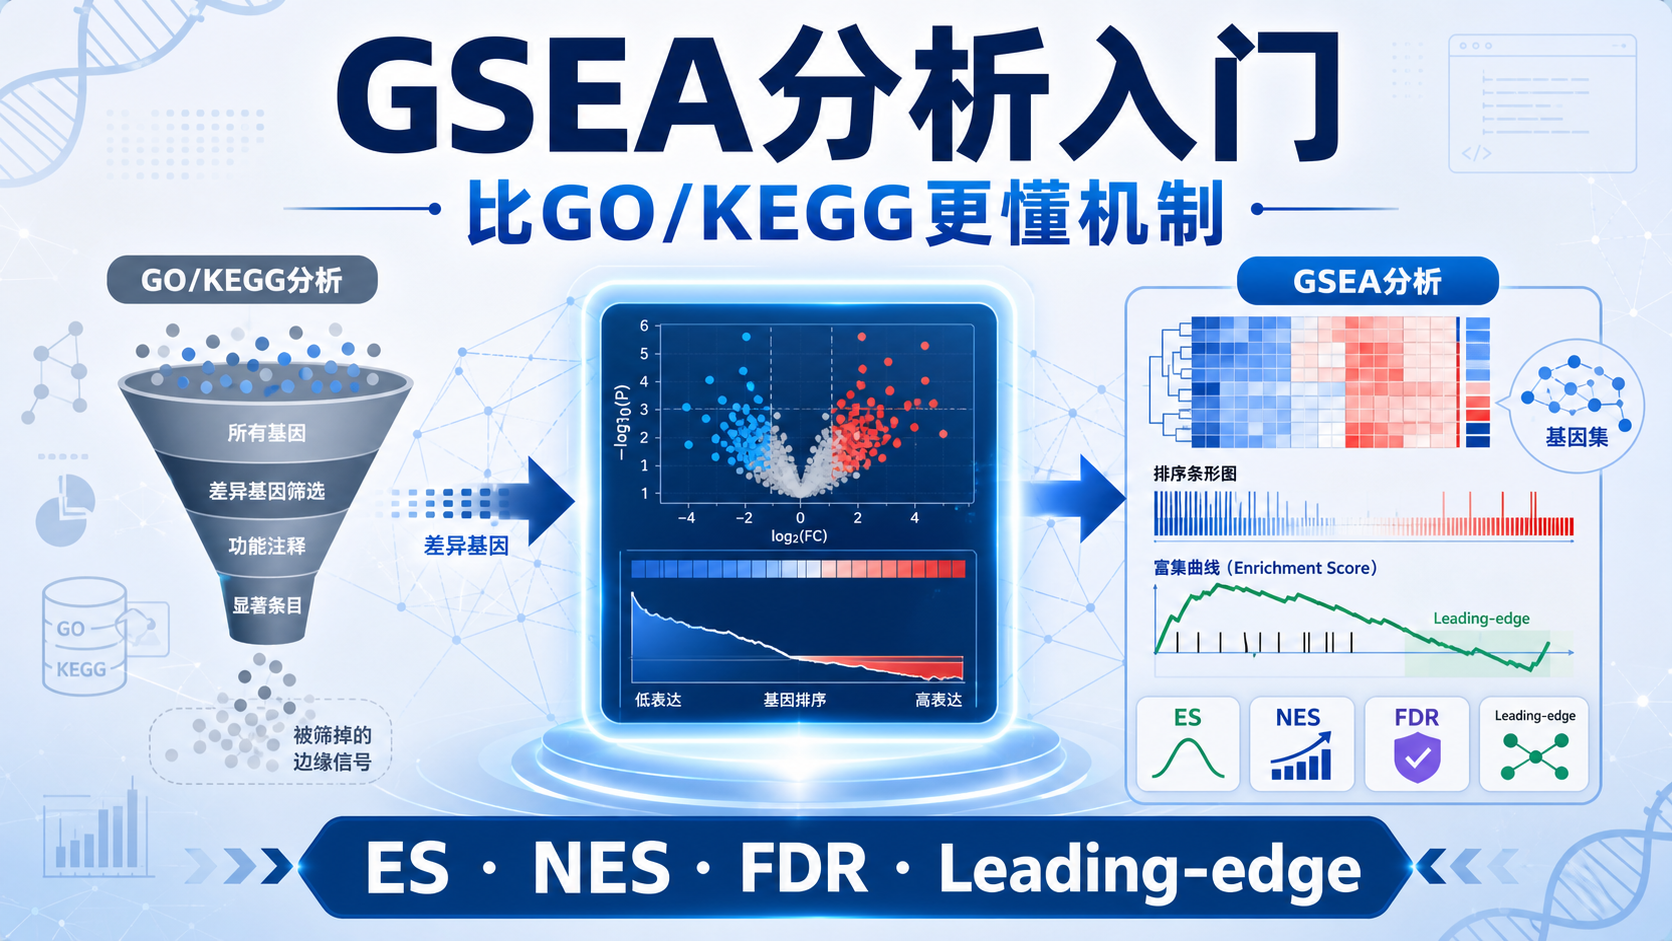
传统GO/KEGG分析依赖阈值,容易漏掉“有生物学意义但未显著”的基因。对于肿瘤、免疫和耐药研究,这种偏差会直接影响结论。GSEA把所有基因纳入排序,能更完整地捕捉通路层面的变化。 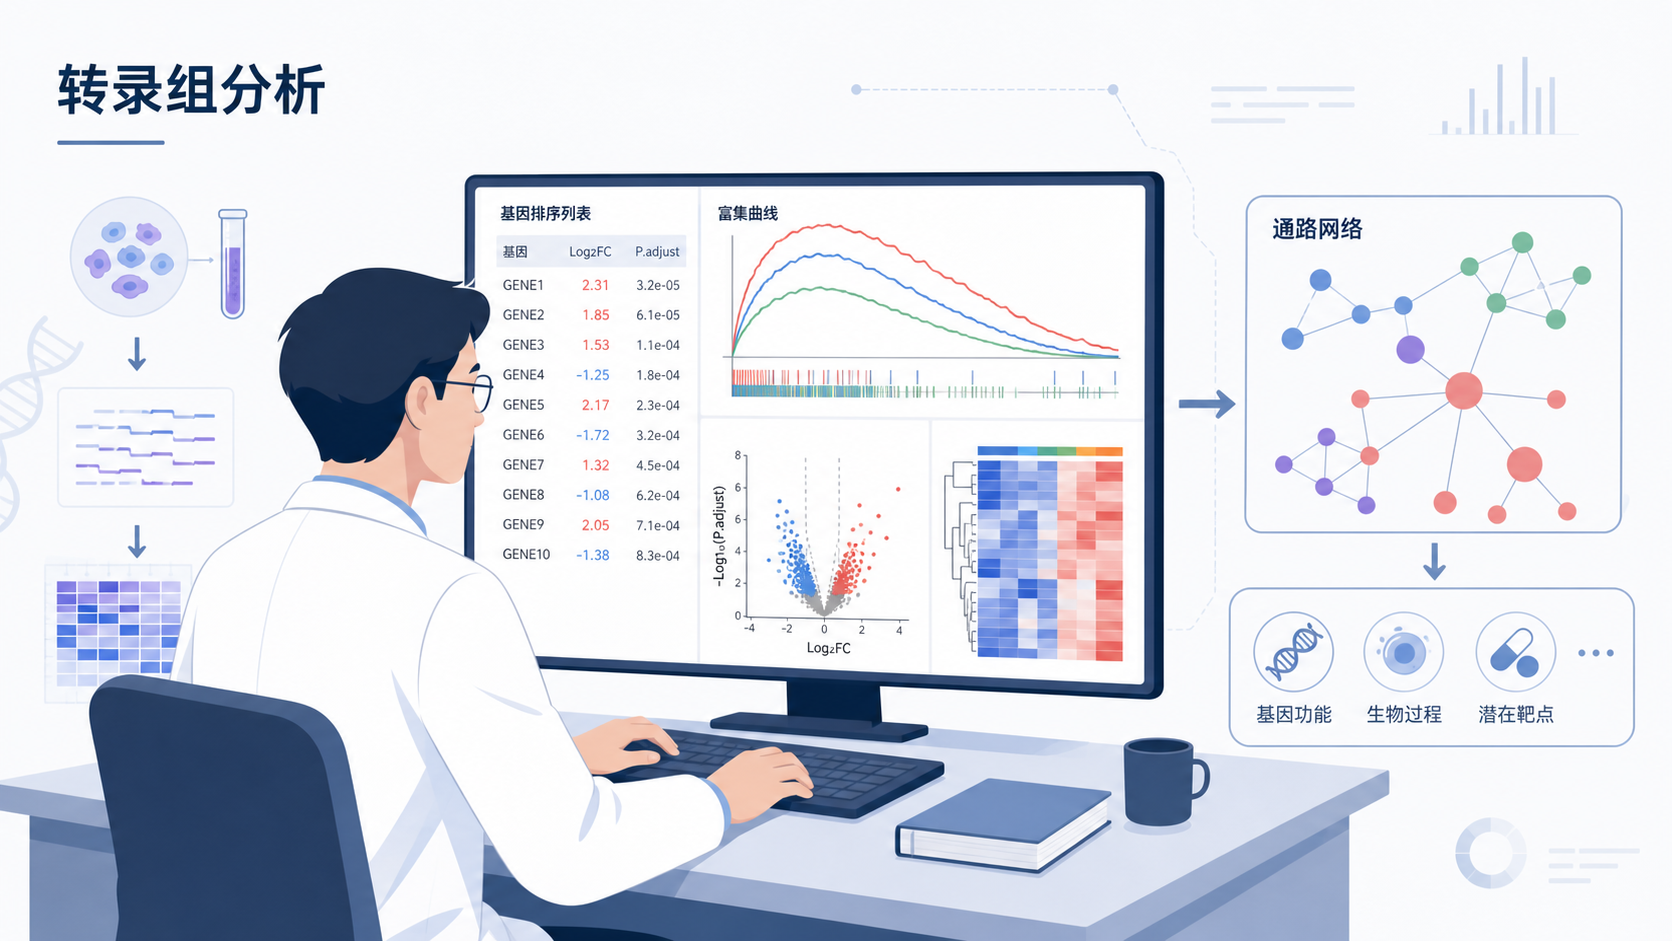
1. 为什么传统GO/KEGG分析容易失真
1.1 阈值筛选会丢失边缘信号
GO/KEGG常先筛差异基因,再做富集。问题在于,很多真实信号会被p值、fold change阈值挡在外面。尤其在样本量小、噪声大的转录组数据中,单个基因未达显著,不代表通路不变。
更关键的是,生物学变化往往是“成组发生”的。一个通路里只有20%到30%的基因轻度变化,可能比1个强差异基因更有机制意义。传统方法只看“显著基因列表”,容易把这种协同变化忽略掉。
1.2 只看差异基因,不等于理解机制
差异基因列表能告诉你“哪些变了”,但不能直接回答“为什么变”。当基因分散在不同功能模块时,结果往往难以解释。GSEA的核心价值,就是把问题从单基因层面提升到基因集层面。
对医学生和科研人员来说,这一点尤其重要。比如肿瘤耐药、炎症激活、细胞周期异常,往往不是某个基因单独驱动,而是整条信号轴共同偏移。
2. GSEA的核心原理是什么
2.1 从“基因列表”到“基因集”
GSEA的输入不是差异基因表,而是一个按某种统计量排序的全基因列表。这个排序可以基于log2FC、t值、signal-to-noise ratio或相关系数。
然后,GSEA检查某个预定义基因集中的成员,是否在排序列表的顶部或底部集中出现。如果这些基因集中分布在前端或末端,就说明该通路在两组表型之间存在一致偏移。
这也是它与传统富集分析的本质区别。前者问“整套基因是否偏向同一方向”,后者问“显著基因里是否过度出现某类功能”。
2.2 ES、NES和FDR分别代表什么
GSEA输出里最重要的三个指标是ES、NES和FDR。
- ES(Enrichment Score) ,表示富集曲线的峰值。
- NES(Normalized Enrichment Score) ,对基因集大小进行标准化,便于不同通路之间比较。
- FDR q-value ,用于控制多重检验后的假阳性比例。
简单理解,ES看“有没有富集”,NES看“富集强不强”,FDR看“靠不靠谱”。通常研究中更关注NES和FDR 。如果FDR较低,且leading-edge基因具有一致生物学方向,结果通常更值得深入验证。
2.3 Leading-edge子集最值得看
Leading-edge是对ES贡献最大的那部分基因。它不是全部成员,而是“真正推动富集信号”的核心子集。做机制分析时,leading-edge往往比整个gene set更有价值。
例如某个炎症相关基因集显著富集后,进一步提取leading-edge基因,可用于后续qPCR验证、蛋白检测或网络分析。这一步能把GSEA结果从“统计学显著”推进到“实验可验证”。
3. GSEA常用数据库和基因集分类
3.1 MSigDB里的基因集更适合做GSEA
GSEA通常配合MSigDB使用。它提供了多类预定义基因集,常见包括:
- M3调控基因集 ,包括microRNA靶点和转录因子靶点。
- M5本体基因集 ,来自GO等本体资源。
- M8细胞类型标记基因集 ,可用于单细胞或类器官模型的细胞注释。
其中,M3里microRNA靶点和转录因子靶点,适合从调控层面解释表达变化。M5中的GO基因集则适合从分子功能、细胞组分和生物过程三层面进行分析。对于转录组研究,选择合适的基因集类别,往往比盲目跑分析更重要。
3.2 不同研究场景要选不同基因集
如果你研究肿瘤免疫微环境,优先考虑免疫相关通路和细胞类型标记。
如果你研究药物处理后的转录变化,TF靶点和GO生物过程更有解释力。
如果你研究发育、分化或器官类模型,细胞类型签名集更合适。
这意味着,GSEA不是“跑一次就够”,而是要结合问题设计。基因集选择直接决定结果的生物学解释质量。
4. GSEA富集分析代码怎么实现
4.1 R语言中最常见的实现思路
实际分析中,R包是最常用方案。典型流程包括:
- 准备表达矩阵和分组信息。
- 用差异分析方法得到全基因排序指标。
- 构建ranked gene list。
- 调用GSEA函数运行富集。
- 导出结果并绘制富集曲线。
如果你使用的是clusterProfiler或fgsea,逻辑基本一致。核心不是函数名,而是排序列表是否合理、基因ID是否统一、基因集是否匹配 。
4.2 一个标准化的代码框架
下面是常见的GSEA分析思路,便于你在真实项目中改写。
# 1. 差异分析后生成排序向量
gene_list <- deg$log2FC
names(gene_list) <- deg$gene_id
gene_list <- sort(gene_list, decreasing = TRUE)

# 2. 运行GSEA
library(clusterProfiler)
gsea_res <- GSEA(
  geneList = gene_list,
  TERM2GENE = term2gene,
  pvalueCutoff = 0.05,
  minGSSize = 10,
  maxGSSize = 500
)

# 3. 查看结果
head(as.data.frame(gsea_res))

# 4. 绘制富集曲线
gseaplot2(gsea_res, geneSetID = "HALLMARK_TNFA_SIGNALING_VIA_NFKB")
这段代码的关键在于geneList。它必须是全基因排序结果,而不是筛选后的差异基因子集。 如果输入错了,GSEA就失去意义。
4.3 fgsea适合大规模数据
如果样本量大、基因集多,fgsea通常更快。它的优势是计算效率高,适合批量分析多个基因集。
library(fgsea)

fgsea_res <- fgsea(
  pathways = pathways_list,
  stats = gene_list,
  minSize = 10,
  maxSize = 500,
  nperm = 10000
)
这里要注意,nperm越大,结果越稳定,但计算时间也更长。对于正式文章,建议提高置换次数,以获得更稳健的P值和FDR。
5. 结果解读时最容易踩的坑
5.1 不要只看P值
GSEA结果里,很多人只盯着P值。但实际判断应结合NES、FDR、基因集大小和leading-edge。一个P值很小但基因集过小的结果,未必适合下结论。
建议按以下顺序判断:
- NES方向是否与实验设计一致。
- FDR是否足够低。
- leading-edge是否包含已知关键基因。
- 通路是否与表型机制匹配。
5.2 ID映射错误会直接毁掉结果
基因ID不统一是最常见问题之一。Entrez、Symbol、Ensembl混用,都会导致匹配失败。最后常见后果是:通路看起来“不富集”,其实是映射丢失。
因此,分析前要先做ID标准化,并检查映射率。这一步看似基础,却决定结果是否可信。
6. GSEA比GO/KEGG更适合哪些研究
6.1 有明显异质性的数据
当样本异质性较高时,单基因差异很难稳定出现。GSEA能利用全局排序信息,更适合以下场景:
- 肿瘤分型研究。
- 药物敏感性与耐药比较。
- 免疫激活状态分析。
- 低丰度、边缘差异明显的转录组项目。
6.2 适合做机制验证的第一步
如果你已经有差异基因结果,GSEA可以作为下一步验证。它能帮助你判断,差异基因是否集中于某些关键通路。当GO/KEGG和GSEA得到一致方向时,结论通常更稳。
对于论文写作来说,这也更容易形成“差异基因-通路-机制”闭环。
总结Conclusion
GSEA的优势不在于“替代”GO/KEGG,而在于补足其阈值依赖和信息丢失的局限。它以全基因为基础,通过排序、富集分数、标准化评分和leading-edge,帮助研究者更准确地识别通路层面的生物学变化。如果你希望把转录组结果从“基因列表”升级为“机制证据”,GSEA是必须掌握的方法。
如果你正在整理转录组结果、想快速搭建可复现的GSEA流程,或需要规范的图表与代码模板,可以进一步了解解螺旋 。它能帮助你更高效地完成分析、解释和写作。
- 引言Introduction
- 1. 为什么传统GO/KEGG分析容易失真
- 2. GSEA的核心原理是什么
- 3. GSEA常用数据库和基因集分类
- 4. GSEA富集分析代码怎么实现
- 5. 结果解读时最容易踩的坑
- 6. GSEA比GO/KEGG更适合哪些研究
- 总结Conclusion